[Zero to ML Master #25] 편미분·그래디언트 쉽게 이해하기 — ∇f가 가장 가파른 오르막인 이유와 경사하강법 구현 (1부, 파이썬 NumPy)
Zero to 머신러닝 딥러닝 Master
안개가 자욱한 산속, 시야는 1미터, 지도도 GPS도 없습니다. 🌫️ 느낄 수 있는 건 발밑의 경사뿐인데, 산은 동서로도 남북으로도 기울어 있어요. 지난 글의 미분은 변수가 하나였지만, 실제 모델은 조절할 손잡이(가중치)가 수백만 개입니다.
이번 글에서는 고차원을 "상상하지 않고" 한 방향씩 쪼개어 재는 편미분, 그 기울기들을 화살표 하나로 묶은 그래디언트 , 그 화살표가 왜 하필 가장 가파른 오르막을 가리키는지(방향도함수와 ), 그리고 그 반대로 한 걸음씩 걷는 경사하강법을 파이썬 NumPy로 직접 구현합니다. 01-10장의 벽 7개 중 ①~⑤를 부수는 1부입니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 01-10 편미분·그래디언트·경사하강법 (1부) 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
01-10-partial-derivative-gradient-descent· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #24 미분 기초 — 계단 기울기에서 순간 변화율·거듭제곱 미분 규칙·경사하강법까지 (파이썬 실습) \
➡️ 다음 글: #26 학습률·지역 최솟값·안장점 — 경사하강법의 함정과 신경망 학습 (편미분·그래디언트 2부, 파이썬 NumPy)
TL;DR — 3줄 요약
- 편미분 는 다른 변수를 잠시 고정(통제 변인)하고 한 변수 방향의 기울기만 재는 미분입니다. 계산은 1변수 미분과 똑같아서, 이면 , 입니다.
- 그래디언트 는 편미분을 순서대로 묶은 벡터입니다. 방향도함수 가 에서 최대이므로 는 가장 가파른 오르막, 는 가장 가파른 내리막입니다. 점 에서는 , 크기 입니다.
- 경사하강법 는 발밑 경사만 보고 반대로 한 걸음씩 내려갑니다. 에서 학습률 0.1로 15걸음이면 손실이 34 → 0.0198로 줄고, 는 매번 0.8배, 는 0.6배가 되어 에 도착합니다.
🔗 지난 글 복습: #24 미분 기초에서 기울기 = 세로 ÷ 가로, 간격을 0으로 좁힌 순간 변화율, 거듭제곱 미분 규칙 , 그리고 1변수 경사하강법 를 배웠습니다. 이번 글은 그 미분을 변수가 여러 개인 함수로 넓힙니다.
✏️ 꼭 알아야 할 TIP
미분 = 접선의 기울기 | 그래디언트 = 여러 방향의 기울기를 모은 화살표 🏹 | 경사하강법 = 그 화살표의 반대로 한 걸음\
🌫️ 안개 낀 산을 내려갈 때, 우리는 지도를 볼 수 없습니다. 볼 수 있는 것은 발 아래 경사뿐입니다. 산이 2차원이면 "동서 기울기"와 "남북 기울기"를 각각 구해(편미분) 하나의 화살표(그래디언트)로 합칩니다. 경사하강법은 이 화살표의 반대 방향으로 한 걸음씩 이동하는 것이 전부입니다.\
\
💼 실무에서 이 원리가 중요한 이유: 신경망의 파라미터가 수백만 개여도, 결국은 "각 파라미터 방향으로의 기울기를 모아 반대 방향으로 이동"하는 이 원리 그대로 학습이 진행되기 때문입니다. 여러분이loss.backward()와optimizer.step()두 줄을 쓸 때, 그 안에서 벌어지는 일이 정확히 이 장의 내용입니다.
🚧 이 장이 유독 어렵게 느껴지는 7가지 이유
많은 사람이 이 장에서 "수학을 포기"합니다. 그런데 어려움의 정체를 먼저 이름 붙여두면, 그 다음부터는 그냥 하나씩 처리하면 되는 목록이 됩니다. 아래 7가지가 이 장에서 우리가 정면으로 부술 벽입니다. 각 벽에는 그것을 부수는 단계가 1:1로 짝지어져 있습니다. 🔨
① 편미분 — 🌀 다변수 상상력의 한계
변수가 하나일 땐 "선의 기울기"면 충분했습니다. 그런데 변수가 여러 개가 되는 순간, 3차원 이상의 입체 공간을 머릿속에 그려야 합니다. 그리고 사람의 머리는 4차원부터는 그냥 안 그려집니다. → 1단계에서 해결
② 편미분 — 🔒 "고정"이라는 개념의 낯섦
"는 상수로 취급한다"는 말이 처음엔 반칙처럼 느껴집니다. 분명히 변수라고 배웠는데 왜 갑자기 숫자 취급을 하지? 이 찜찜함이 계산 실수의 90%를 만듭니다. → 2단계에서 해결
③ 그래디언트 — 🧩 미분 + 벡터의 동시 등장
그래디언트는 미분(해석학)과 벡터(선형대수)라는 서로 다른 두 과목이 한 기호 안에서 만나는 지점입니다. 둘 중 하나라도 흔들리면 여기서 무너집니다. → 3단계에서 해결
④ 그래디언트 — 🔄 "최대 증가 방향"의 역설
우리는 내려가고 싶은데, 그래디언트는 굳이 올라가는 방향을 알려줍니다. 그래서 매번 머릿속에서 방향을 한 번 뒤집어야 하고, 이 "한 번 더 뒤집기"가 부호 실수의 주범입니다. → 4단계에서 해결
⑤ 경사하강법 — 🙈 눈을 가린 채 하는 하이킹
실제 손실 함수는 수억 차원의 울퉁불퉁한 산맥입니다. 전체 지도를 볼 수 있는 방법이 원리적으로 없습니다. 오직 지금 서 있는 자리의 발밑 경사 하나로 최저점을 찾아야 합니다. → 5단계에서 해결
⑥ 경사하강법 — 👣 학습률(보폭)의 딜레마
보폭이 크면 골짜기를 뛰어넘어 발산하고, 작으면 영원히 도착하지 못합니다. 게다가 "적당한 값"이 함수마다 다릅니다. → 6단계에서 해결
⑦ 경사하강법 — 🕳️ 지역 최솟값·안장점의 함정
발밑이 평평하다고 해서 그곳이 진짜 바닥이라는 보장이 없습니다. 살짝 파인 웅덩이에 갇혀 하산을 멈춰버립니다. → 7단계에서 해결
💡 이 장의 약속: 위 7개를 순서대로 하나씩 부숩니다. 다 부수고 나면 마지막 8단계에서, 이 모든 것이 100만 차원에서도 글자 하나 바뀌지 않고 그대로 작동한다는 사실을 확인하게 됩니다.
📌 1부(이 글)에서는 벽 ①~⑤(1~5단계: 편미분 → 그래디언트 → 최대 증가 방향 → 경사하강법 구현)를, 2부에서는 벽 ⑥·⑦과 8단계(학습률 · 지역 최솟값·안장점 · 신경망 학습), 실습·연습문제를 다룹니다.
📚 선행지식
· 🔗 01-09 미분 기초: 기울기 = 세로÷가로, 순간 변화율(속도계 비유), 거듭제곱 미분 규칙("지수 앞으로, 1 줄이기"), 1변수 경사하강법(안개산 비유)\
· 🔗 01-03 벡터: 벡터는 "숫자를 순서대로 묶은 것"이자 "방향과 크기를 가진 화살표", 노름 , 스칼라곱\
· 🔗 01-08 함수와 합성함수: 연쇄법칙 (8단계 역전파에서 사용)\
· 함수 , 미분 의 의미 (접선의 기울기)
🎯 학습 목표
☐ 고차원을 "상상하지 않고" 한 방향씩 쪼개어 다루는 방법을 설명할 수 있다\
☐ 편미분에서 다른 변수를 상수로 고정하는 것이 왜 정당한지 설명할 수 있다\
☐ 여러 편미분을 모은 벡터가 그래디언트 임을 설명할 수 있다\
☐ 같은 함수의 그래디언트를 손으로 계산할 수 있다\
☐ 그래디언트가 최대 증가 방향인 이유와, 그래서 마이너스를 붙이는 이유를 설명할 수 있다\
☐ 경사하강법을 코드로 구현하고, 학습률에 따른 수렴·진동·발산을 재현할 수 있다\
☐ 지역 최솟값과 안장점이 무엇이며 왜 고차원에서 성격이 달라지는지 설명할 수 있다\
☐ 신경망 학습이 수백만 차원 경사하강법과 같은 원리임을 설명할 수 있다
🎯 ⚙ 핵심 학습 내용
편미분(Partial Derivative) ✂️: 여러 변수 중 하나만 변화시켜서 구하는 미분. 는 " 방향으로만의 기울기".
⛰️ 3D 지형에서: "동쪽 기울기()"와 "북쪽 기울기()"를 각각 구해서, 두 기울기를 합친 벡터 = 그래디언트 ∇f[1] = 가장 가파른 상승 방향 ⬆️
그래디언트(Gradient) ∇f 🏹: 각 변수에 대한 편미분들을 모은 벡터. -∇f는 가장 가파른 하강 방향 ⬇️ → 경사하강법↗의 이동 방향!
[1] 그래디언트 보충 설명 — ∇(나블라, nabla)는 "각 방향으로의 기울기를 모두 모은 화살표"입니다. 이름은 고대 하프처럼 생긴 악기 이름에서 왔고, 삼각형을 뒤집은 모양(∆ → ∇)입니다. 변수가 2개면 2차원 벡터, 100만 개면 100만 차원 벡터가 되지만 의미는 항상 동일합니다: "이 지점에서 함수값이 가장 빠르게 커지는 방향과, 그 방향이 얼마나 가파른가". 딥러닝에서는 이 벡터의 반대 방향으로 파라미터를 이동시켜 손실을 줄입니다.
| 단계 | 부수는 벽 🧱 | 학습 내용 | 도달점 |
|---|---|---|---|
| 1️⃣ | 🌀 다변수 상상력 | 차원을 쪼개어 보는 기술 | 고차원을 "상상하지 않고" 다룬다 |
| 2️⃣ | 🔒 "고정"의 낯섦 | 편미분 계산 규칙과 근거 | 를 손으로 계산 |
| 3️⃣ | 🧩 미분+벡터 | 그래디언트로 묶기 · 코드 구현 | 의 방향과 크기를 읽는다 |
| 4️⃣ | 🔄 상승 방향의 역설 | 방향도함수 · 왜 마이너스인가 | 부호를 절대 틀리지 않는다 |
| 5️⃣ | 🙈 눈 가린 하이킹 | 경사하강법 구현과 수렴 관찰 | 국소 정보만으로 최저점 도달 |
| 6️⃣ | 👣 학습률 딜레마 | 수렴·진동·발산의 경계 조건 | 학습률을 근거 있게 고른다 |
| 7️⃣ | 🕳️ 지역 최솟값·안장점 | 함정의 정체와 탈출 전략 | 모멘텀·Adam의 존재 이유 이해 |
| 8️⃣ | 🚀 확장 | 신경망 학습과의 연결 | 역전파 학습에 응용 가능 |
🔗 다변수 미분 백과사전 ↗ · 경사하강법 백과사전 ↗ · Adam 옵티마이저 백과사전 ↗
📖 처음부터 끝까지 상세 풀이 — 벽 7개를 순서대로 부숩니다 🔨
01-10-A 1단계 — 🌀 벽 ①: "다차원이 상상이 안 돼요"
🍀 먼저 안심하세요
결론부터 말씀드립니다. 4차원 이상은 아무도 상상하지 못합니다. 수학자도, AI 연구자도, 이 글을 쓰는 저도 못 합니다. 그런데도 100만 차원을 다룹니다. 어떻게? 상상하기를 포기하고, 대신 한 방향씩 쪼개서 봅니다. 이 장 전체가 그 "쪼개는 기술"에 관한 이야기입니다. 상상이 안 되는 건 여러분의 문제가 아니라, 원래 그런 것입니다. 😌
① 핵심 정의 — 변수가 여러 개인 함수 은 "차원 공간의 각 점마다 높이가 하나씩 정해진 지형"입니다. 우리는 이 지형 전체를 볼 수 없습니다. 그래서 한 번에 한 방향씩만 잘라서 봅니다. 이렇게 한 방향으로 자른 단면의 기울기가 바로 편미분입니다.
💜 더 쉽게 이해하기 ① — 🍞 식빵 자르기
덩어리 식빵 하나가 통째로 놓여 있습니다. 이 빵 속이 어떻게 생겼는지 겉만 봐서는 알 수 없습니다. 그런데 칼로 한 장씩 썰면 어떻게 될까요? 단면 하나하나는 그냥 평평한 2D 그림이라 누구나 볼 수 있습니다. 여러 장을 순서대로 넘겨보면 빵 전체의 구조를 파악할 수 있죠.\
\
고차원 함수도 똑같습니다. 전체는 못 보지만, "만 빼고 전부 고정"하고 자르면 그냥 1변수 함수가 됩니다. 우리가 이미 01-09에서 배운 그 익숙한 곡선이요. 편미분은 고차원 빵을 1차원 조각으로 써는 칼입니다. 🔪
💜 더 쉽게 이해하기 ② — 🎚️ 오디오 믹서의 페이더
녹음실 믹서에는 슬라이더(페이더)가 수십 개 있습니다. 보컬, 드럼, 베이스, 기타… 이 수십 개 손잡이의 조합이 만들어내는 "전체 소리 공간"은 수십 차원입니다. 엔지니어가 이 공간을 머릿속에 그릴까요? 아니요. 그는 이렇게 합니다:\
\
🎧 "다른 건 다 그대로 두고, 보컬 하나만 조금 올려보자. 좋아졌나? → 좋아졌네. 그럼 조금 더."\
\
이것이 정확히 편미분이고, 정확히 경사하강법입니다. 엔지니어는 수십 차원을 상상하지 않습니다. 손잡이 하나씩 만져보고, 좋아지는 방향으로 조금씩 움직일 뿐입니다. 신경망 학습도 문자 그대로 이것입니다 — 손잡이가 100만 개일 뿐이죠. 🎛️
💜 더 쉽게 이해하기 ③ — 🏢 아파트 동·호수와 온도
"3동 7층의 실내 온도"를 생각해 봅시다. 위치를 정하는 정보가 두 개(동, 층)이고 결과가 하나(온도)이니, 이건 인 2변수 함수입니다.\
\
· "같은 3동에서 한 층 위로 가면 온도가 얼마나 오르나?" → 층 방향 편미분 (뜨거운 공기는 위로 뜨니 아마 +)\
· "같은 7층에서 옆 동으로 가면?" → 동 방향 편미분 (햇빛 방향에 따라 +일 수도 −일 수도)\
\
두 질문은 따로따로 물어봐야 답이 나옵니다. 동시에 대각선으로 움직이면 "무엇 때문에 온도가 변했는지" 알 수 없기 때문입니다. 🌡️ 편미분이 한 번에 한 변수만 건드리는 이유가 바로 이것입니다 — 원인을 분리하기 위해서.
진행 과정 — 고차원을 다루는 5단 전략
- 🚫 포기한다: 전체 모양을 한눈에 보려는 시도를 버린다
- ✂️ 쪼갠다: 한 변수만 남기고 나머지를 전부 고정해 1차원 문제로 만든다
- 🔁 반복한다: 모든 변수에 대해 같은 일을 반복한다
- 📦 모은다: 결과들을 하나의 벡터(그래디언트)로 묶는다
- 👣 움직인다: 그 벡터가 알려주는 반대 방향으로 한 걸음 옮긴다
직관적 의미
고차원이 무서운 이유는 "봐야 한다"고 착각하기 때문입니다. 하지만 실제로 필요한 것은 보는 능력이 아니라 계산하는 능력입니다. 컴퓨터는 100만 차원을 상상하지 않습니다. 그냥 100만 개의 숫자를 계산할 뿐입니다. 🖥️ "계산은 컴퓨터가, 뜻은 사람이" — 사람이 할 일은 2차원 그림으로 뜻을 이해하는 것까지입니다.
🖼️ 시각화 ① — 차원이 늘어날 때 벌어지는 일
| 📏 1변수 | ⛰️ 2변수 | 🌌 변수 | |
|---|---|---|---|
| 모습 | 곡선 위의 점 | 지형의 한 지점 | ??? |
| 기울기 | 숫자 1개 | 숫자 2개 | 숫자 개 |
| 선택지 | 좌 ⬅️ / 우 ➡️ | 360° 전 방향 | 무한 방향 |
| 상상 | 👁️ 상상 가능 | 👁️ 아직 상상 가능 | 🙈 상상 불가 — 그래도 계산은 가능! |
달라지는 것은 숫자의 개수뿐, 하는 일은 언제나 같습니다: "각 방향으로 얼마나 가파른가?"
🖼️ 시각화 ② — 2차원 산에서의 동서·남북 편미분
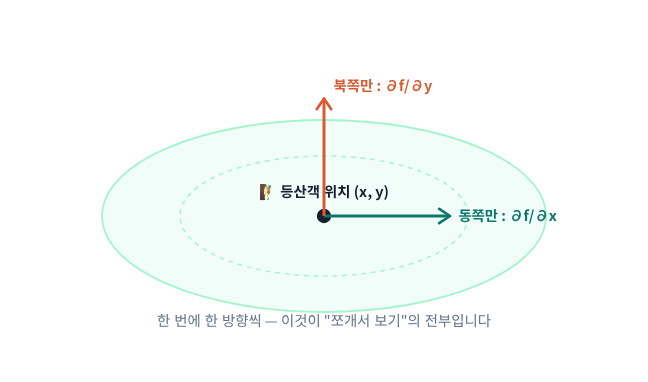
🧠 한 줄 정리 — 고차원은 보는 것이 아니라 쪼개는 것입니다. 벽 ① 격파! ✅
01-10-B 2단계 — 🔒 벽 ②: "왜 를 갑자기 숫자 취급하죠?"
① 핵심 정의 — 편미분(Partial Derivative)은 여러 변수 중 다른 변수는 모두 고정한 채 하나의 변수만 변화시켜서 구하는 미분입니다. 는 "는 그대로 두고 방향으로만 움직였을 때의 기울기"를 뜻합니다.
💜 더 쉽게 이해하기 — 🔬 과학 실험의 "통제 변인"
초등학교 과학 시간을 떠올려 보세요. "식물의 성장에 물이 미치는 영향"을 알아보려면 어떻게 하나요? 햇빛, 온도, 흙, 화분 크기를 전부 똑같이 맞춰놓고 물의 양만 다르게 줍니다. 만약 물도 바꾸고 햇빛도 동시에 바꾸면? 키가 자란 것이 물 때문인지 햇빛 때문인지 영원히 알 수 없습니다. 🌱\
\
편미분은 수학판 "통제 변인 실험"입니다. 를 고정하는 것은 반칙이 아니라, 의 효과만 순수하게 뽑아내기 위한 유일한 방법입니다. "가 변수가 아니게 된 것"이 아니라, "이번 실험에서만 잠시 붙잡아 둔 것"입니다. 실험이 끝나면(= 편미분을 다 구하면) 풀어주고, 다음엔 를 움직이며 를 붙잡습니다. 🤝
😵 여기서 가장 흔한 오해
❌ "를 상수로 본다 = 는 이제 변수가 아니다"\
✅ "를 상수로 본다 = 이 계산이 진행되는 동안만 가 움직이지 않는다고 가정한다"\
\
비유하자면 사진 📸 입니다. 달리는 자동차를 찍은 사진 속에서 차는 멈춰 있습니다. 그렇다고 차가 못 달리는 건 아니죠. 편미분은 "를 멈춘 순간의 스냅샷에서 방향 기울기를 잰 것"입니다.
진행 과정 — 편미분 계산 5단계 레시피 🍳
- 🎯 구하려는 방향의 변수를 하나 정한다 (예: )
- 🔒 나머지 변수()에 동그라미를 치고 "얘는 숫자다"라고 소리 내어 말한다
- ✏️ 그 상태에서 에 대해서만 평소대로 1변수 미분한다 (01-09에서 배운 그대로!)
- 📝 결과를 로 표기한다 (가 아니라 사용)
- 🔁 같은 방식으로 나머지 모든 변수에 대해 반복한다
🔤 기호 읽는 법 — vs
· → "디에프 디엑스". 변수가 하나뿐일 때 씁니다.\
· → "라운드 에프 라운드 엑스" 또는 "파셜 에프 파셜 엑스". 변수가 여럿일 때 씁니다.\
\
는 둥근 일 뿐이고, 의미는 "이 함수엔 다른 변수도 있는데, 지금은 이것만 본다"는 주의 표시입니다. 기호가 다른 이유는 계산법이 달라서가 아니라, 맥락을 알려주기 위해서입니다. 계산 자체는 1변수 미분과 100% 동일합니다. 😌
수학적 의미 — 한 줄씩 따라가는 유도
공식 대상 함수는 입니다. 밥그릇을 한쪽으로 눌러 늘린 모양의 지형이라고 생각하세요 🥣.
변수 정의 — : 동서 좌표, : 남북 좌표, : 그 지점의 높이(=손실값), : 동서 방향 기울기.
유도 ① — 에 대한 편미분. 를 상수로 취급하므로 는 그냥 숫자이고, 숫자를 미분하면 0입니다.
유도 ② — 에 대한 편미분. 이번엔 반대로 이 상수가 됩니다.
🧪 못 믿겠다면 이렇게 검산하세요
를 구할 때 가 상수라는 게 여전히 찜찜하다면, 진짜 숫자를 넣어보세요. 으로 못 박으면\
이제 이건 그냥 1변수 함수입니다! 미분하면 . 상수 18은 사라집니다. 로 해도 , 미분하면 역시 . 에 무엇을 넣든 답은 — 그래서 "는 상수 취급"이 정당한 것입니다. ✅
🖼️ 시각화 ③ — "를 고정한다"는 것의 진짜 그림
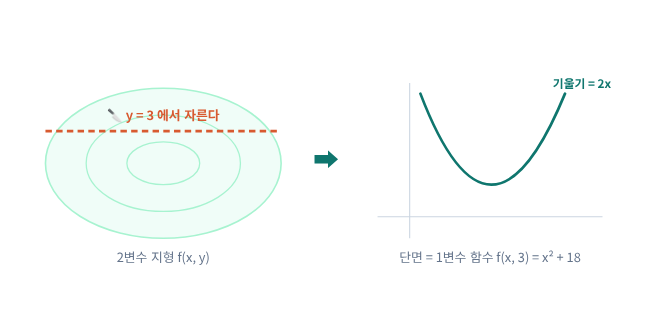
👀 오른쪽 그림을 보세요. 우리가 이미 아는 익숙한 포물선입니다. 편미분은 새로운 미분이 아니라, 익숙한 미분을 쓸 수 있게 만들기 위한 준비 작업일 뿐입니다.
직관적 의미
편미분은 "다른 모든 것을 잠깐 무시하고, 이 방향만 살펴보면 얼마나 가파른가?"에 대한 답입니다. 방향이 여러 개면 이 질문을 방향 수만큼 반복합니다. 그것이 전부입니다.
구현 관점
코드에서는 각 변수의 편미분 공식을 그대로 한 줄씩 옮겨 적습니다. 다음 3단계 코드의 2*x, 4*y가 방금 손으로 유도한 , 바로 그것입니다. 수식 → 코드가 1:1로 대응되므로, 코드가 틀렸다면 대개 수식 유도에서 이미 틀린 것입니다. 🔍
프레임워크 관점
| NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|
| 직접 수식으로 계산 | Variable.backward() | tensor.backward() | GradientTape | jax.grad(f) |
🧠 한 줄 정리 — "고정"은 반칙이 아니라 통제 변인입니다. 벽 ② 격파! ✅
01-10-C 3단계 — 🧩 벽 ③: 미분과 벡터가 한꺼번에 나온다
① 핵심 정의 — 그래디언트(Gradient) 는 모든 변수에 대한 편미분을 하나의 벡터로 묶은 것입니다. 그냥 묶기만 한 것인데, 묶는 순간 놀라운 성질이 생깁니다: 그 벡터가 가리키는 방향이 정확히 "가장 가파른 오르막"이 됩니다. 🏹
🧩 여기서 사람들이 무너지는 이유
그래디언트는 미분(변화율)과 벡터(방향과 크기)라는 서로 다른 두 언어가 처음으로 합쳐지는 지점입니다. "숫자인 줄 알았던 기울기가 갑자기 화살표가 되었다"는 이 도약이 어렵게 느껴지는 것은 자연스럽습니다. 하지만 벡터는 이미 🔗 01-03에서 배웠습니다. 그래디언트는 새로운 것이 아니라 두 개의 아는 것을 겹쳐 놓은 것일 뿐입니다. 겁먹지 마세요. 🙂
💜 더 쉽게 이해하기 ① — 🧭 내비게이션의 화살표
내비게이션은 "동쪽으로 300m, 북쪽으로 400m"라고 두 개로 나눠 말하지 않습니다. 화면에는 "이 방향으로 500m"라는 화살표 하나가 뜹니다. 두 정보를 합치면 방향 하나 + 거리 하나가 되고, 그게 훨씬 쓸모 있기 때문입니다.\
\
그래디언트도 똑같습니다. , 라는 두 숫자를 로 묶으면,\
· 방향 🧭 = "어느 쪽이 가장 가파른 오르막인가"\
· 길이 📏 = = "얼마나 가파른가"\
두 가지 정보가 화살표 하나에 동시에 담깁니다.
💜 더 쉽게 이해하기 ② — 💧 지붕 위에 물 한 방울
경사진 지붕에 물 한 방울을 떨어뜨리면, 물은 망설임 없이 한 방향으로 굴러갑니다. 물방울은 미분도 벡터도 모르는데 어떻게 가장 가파른 방향을 즉시 아는 걸까요? 답: 중력이 대신 계산해 주기 때문입니다.\
\
는 수학판 중력입니다. 💧 물방울이 흘러가는 그 방향, 그것이 마이너스 그래디언트 방향입니다. 그래서 이 알고리즘의 이름이 "하강(descent)"인 것이고요.
진행 과정
- 📋 함수의 모든 변수를 나열한다 (, , …)
- ✂️ 각 변수에 대한 편미분을 하나씩 구한다 (2단계 레시피 그대로)
- 📦 구한 편미분들을 순서대로 벡터에 담는다:
- 🏹 이 벡터가 그래디언트 이다
- 📍 특정 지점의 좌표를 대입해 그 지점에서의 그래디언트 값을 구한다
⚠️ 순서가 생명입니다
와 는 완전히 다른 방향입니다. 그래디언트를 만들 때 변수 순서와 벡터 순서는 반드시 같아야 합니다. 코드에서 파라미터 순서가 뒤바뀌어 학습이 망가지는 사고가 실제로 자주 일어납니다. 🚨 이 장 끝의 디버깅 팁(2부에서 다룹니다)에서 shape 확인을 강조하는 이유입니다.
수학적 의미 — 예제로 그래디언트 계산하기
공식
변수 정의 — : 입력 좌표, : 함수값(지형의 높이), : 그래디언트 벡터(가장 가파른 상승 방향과 그 가파름).
유도 — 2단계에서 이미 다 했습니다. 결과만 모읍니다.
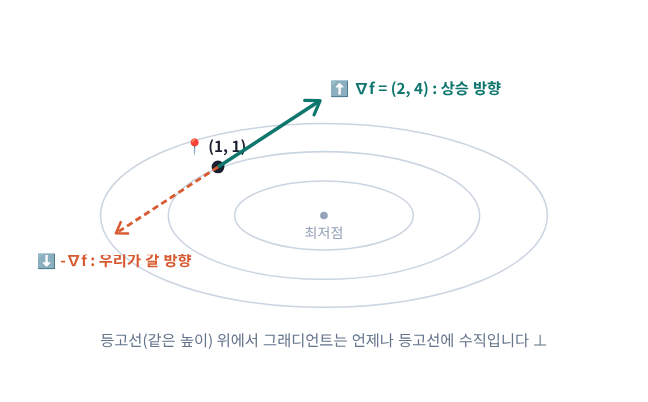
직관 — 점 을 대입하면 입니다. 두 숫자를 비교해 읽는 것이 핵심입니다: 쪽 값이 2배 크므로, 이 지점에서는 방향이 방향보다 2배 가파릅니다. 밥그릇이 남북으로 더 좁고 깊게 눌린 모양이라는 뜻이죠 🥣. 경사하강법은 그래서 방향으로 더 크게 움직이게 됩니다 — 뒤의 실행 결과에서 실제로 그렇게 되는지 확인해 보세요!
📐 그래디언트의 "길이"도 의미가 있습니다
📊 길이가 크다 = 절벽처럼 가파르다 = 아직 최저점에서 멀다 → 성큼성큼 움직인다\
📊 길이가 0에 가깝다 = 평평하다 = 최저점(또는 함정!)에 도착했을 가능성 → 학습 종료 신호\
그래서 학습 로그에 grad_norm을 찍어보는 것이 딥러닝 디버깅의 기본입니다. 이 값이 폭발하면 gradient exploding 💥, 0으로 사라지면 gradient vanishing 🫥 입니다.
구현 관점 — 코드로 옮기기
import numpy as np

def compute_loss(position):
    """
    지형의 높이(손실값)를 계산합니다.

    비유:
    등산객이 현재 서 있는 (x, y) 좌표에서
    고도계를 읽는 것과 같습니다.
    """
    x, y = position
    return x ** 2 + 2 * y ** 2

def compute_gradient(position):
    """
    현재 위치에서의 그래디언트 ∇f = (∂f/∂x, ∂f/∂y)를 계산합니다.

    비유:
    "동쪽으로 한 발짝, 북쪽으로 한 발짝" 갔을 때
    고도가 각각 얼마나 변하는지 재는 것과 같습니다.
    """
    x, y = position
    df_dx = 2 * x   # x 방향 편미분 ∂f/∂x = 2x
    df_dy = 4 * y   # y 방향 편미분 ∂f/∂y = 4y
    return np.array([df_dx, df_dy])

position = np.array([1.0, 1.0])
grad = compute_gradient(position)

print("그래디언트 ∇f =", grad)
print("크기 |∇f|   =", np.linalg.norm(grad))
🔗 GitHub에서 코드 보기 — 01_10_partial_derivative_gradient_descent.py L12–L42
🔍 코드 상세 분석 — 한 줄씩
x, y = position — 좌표 벡터 position을 , 두 숫자로 풀어냅니다 (튜플 언패킹).\
df_dx = 2 * x — 위에서 손으로 유도한 를 글자 그대로 옮긴 줄입니다. 수식과 코드가 1:1로 대응하는지 항상 눈으로 확인하세요. 👀\
df_dy = 4 * y — 마찬가지로 입니다. 계수 4를 2로 잘못 쓰는 실수가 매우 흔합니다.\
np.array([df_dx, df_dy]) — 두 편미분을 순서대로 묶어 그래디언트 벡터 를 만듭니다. 이 한 줄이 "미분 + 벡터"가 합쳐지는 순간입니다. 🧩\
np.linalg.norm(grad) — 벡터의 길이(노름) 를 구합니다. 🔗 01-03에서 배운 계산을 대신해 주는 함수입니다.
🐍 Python 기초 설명
x, y = position— 튜플 언패킹:position이[1.0, 1.0]처럼 값 2개를 담고 있으면, 순서대로x,y에 나눠 담아줍니다.x = position[0],y = position[1]두 줄을 한 줄로 줄인 것입니다.\
"""..."""— docstring(문서화 주석): 함수 바로 아래 삼중따옴표로 감싼 설명입니다.help(함수이름)으로 꺼내볼 수 있어, 미래의 나에게 남기는 쪽지 역할을 합니다. 📮\
np.array([...])— 파이썬 리스트를 NumPy 배열로 바꿉니다. 배열이어야배열 - 0.1 * 배열처럼 벡터 단위 연산이 한 번에 됩니다.
실행 결과 ▶️
그래디언트 ∇f = [2. 4.]
크기 |∇f|   = 4.47213595499958
✅ 손으로 구한 , 와 정확히 일치합니다. 손 계산과 코드 결과를 대조하는 습관이 이후 복잡한 모델에서 여러분을 구해줍니다.
프레임워크 관점
| NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|
| 공식을 손으로 유도해 직접 구현 | x.grad 자동 계산 | x.grad (Autograd) | tape.gradient(f, x) | jax.grad(f)(x) |
🖼️ 시각화 ④ — 그래디언트 벡터 화살표
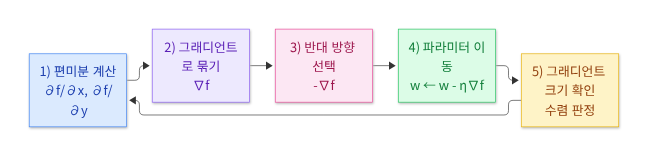
🖼️ 시각화 ⑤ — 전체 흐름도
🧠 한 줄 정리 — 그래디언트는 새 개념이 아니라 편미분들을 담은 상자입니다. 벽 ③ 격파! ✅
01-10-D 4단계 — 🔄 벽 ④: 내려가고 싶은데 왜 올라가는 방향을 알려주죠?
① 핵심 정의 — 그래디언트 는 함수값이 가장 빠르게 증가하는 방향을 가리킵니다. 우리가 원하는 것은 반대인데 말이죠. 그래서 경사하강법 공식에는 항상 마이너스 부호가 붙습니다. 이 "한 번 뒤집기"가 초보자 부호 실수의 1순위 원인입니다. 🔁
🤔 그런데 왜 하필 "증가" 방향으로 정의했을까요?
불편하게 왜 이렇게 정의했을까요? 답은 수학의 다른 분야에서는 증가 방향이 더 자연스럽기 때문입니다. 온도장에서 열이 흐르는 방향, 전위에서 힘의 방향, 지형에서 물이 흐르는 방향 — 이 모든 물리 법칙이 를 기준으로 서술됩니다. 머신러닝만 "줄이는" 문제라서 마이너스를 붙일 뿐입니다.\
\
💡 그래서 이렇게 기억하세요: "∇는 오르막을 가리키는 나침반. 우리는 그 나침반을 들고 정반대로 걷는다." 🧭↩️
💜 더 쉽게 이해하기 ① — 🌡️ "가장 뜨거운 쪽" 감지기
여러분이 어두운 방에서 열 감지기를 들고 있다고 해봅시다. 이 감지기는 "가장 뜨거운 쪽"으로 바늘이 움직입니다. 그런데 여러분의 목표는 가장 시원한 자리를 찾는 것입니다.\
\
그럼 어떻게 하나요? 감지기를 버리나요? 아니요! 바늘이 가리키는 정반대로 걸어가면 됩니다. 🚶♂️ 감지기는 여전히 완벽하게 유용합니다. 방향만 뒤집으면 되니까요. 그래디언트도 똑같습니다 — 버리는 게 아니라 뒤집는 것입니다.
💜 더 쉽게 이해하기 ② — 🎮 게임 컨트롤러가 뒤집힌 느낌
비행 시뮬레이션 게임에서 스틱을 앞으로 밀면 기수가 아래로 내려갑니다. 처음엔 헷갈리지만, 몇 번 하면 손이 저절로 기억하죠. 부호도 그렇습니다. 지금은 "왜 마이너스지?" 하고 매번 생각해야 하지만, 코드를 다섯 번만 써보면
w - lr * grad가 손에 붙습니다. ✋\
\
🚨 그때까지의 안전장치: 학습 중 손실(loss)이 커지고 있다면, 십중팔구 부호를 반대로 썼거나 학습률이 너무 큰 것입니다. 손실 그래프가 여러분의 부호 검사기입니다. 📉
수학적 의미 — "왜 하필 그 방향이 가장 가파른가"의 증명 🧾
이 부분은 이 장에서 유일하게 조금 어려운 수학입니다. 결론만 챙겨도 괜찮습니다. 다만 한 번 보고 나면 "그래디언트가 최대 증가 방향"이라는 말이 주문이 아니라 계산 결과였음을 알게 됩니다.
① 문제 설정 — 현재 위치에서 길이가 1인 방향 벡터 로 조금 움직였을 때 함수값이 얼마나 변할까요? 이 변화율을 방향도함수(directional derivative)라 하고, 다음이 성립합니다.
② 내적의 성질 적용 — 🔗 01-05에서 배운 내적의 정의를 그대로 씁니다.
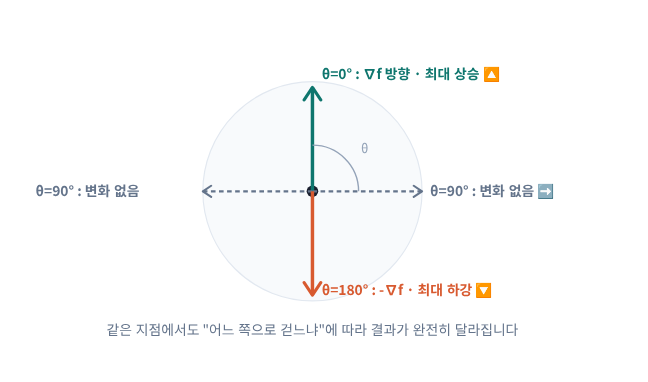
③ 최댓값 찾기 — 는 우리가 고른 방향과 무관한 고정된 값입니다. 그러므로 이 식이 가장 커지는 때는 오직 가 최대일 때, 즉 ()일 때입니다.
🔼 → → 변화율 가장 빠른 증가 (그래디언트와 같은 방향)\
➡️ → → 변화율 높이 그대로 (등고선을 따라 걷는 방향! 그래서 ∇f ⊥ 등고선)\
🔽 → → 변화율 가장 빠른 감소 (그래디언트의 정반대 방향)
④ 결론 — "가장 빨리 내려가는 방향"은 계산해 보니 정확히 였습니다. 이것은 누가 정한 규칙이 아니라 코사인의 최댓값이 1이라는 사실에서 자동으로 따라나온 결과입니다. 그래서 갱신식에 마이너스가 붙습니다. ✅
🖼️ 시각화 ⑥ — 방향에 따라 변화율이 달라진다 (코사인의 힘)
직관적 의미
는 "오르막 나침반"입니다. 우리는 그 나침반을 신뢰하되, 항상 반대로 걷습니다. 그리고 각도 90°인 방향(등고선 방향)으로 걸으면 아무리 걸어도 높이가 안 변한다는 점도 기억해 두세요 — 나중에 "학습이 진행되는 것 같은데 손실이 안 줄어드는" 현상을 이해하는 열쇠가 됩니다. 🔑
구현 관점
✅ 올바름: position = position - lr * grad (손실이 줄어든다 📉)\
❌ 흔한 실수: position = position + lr * grad (손실이 폭발한다 📈💥 — 이것은 "경사상승법")\
💡 참고: GAN이나 강화학습의 정책 경사(policy gradient)처럼 일부러 값을 최대화하고 싶을 때는 진짜로 플러스를 씁니다. 부호는 목적에 따라 정하는 것이지, 무조건 마이너스인 것은 아닙니다.
프레임워크 관점
| NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|
| 부호를 직접 관리 | SGD가 마이너스 처리 | optim.SGD가 처리 (최대화는 maximize=True) | minimize()가 처리 | optax.sgd()가 처리 |
🧠 한 줄 정리 — 마이너스는 규칙이 아니라 의 결과입니다. 벽 ④ 격파! ✅
01-10-E 5단계 — 🙈 벽 ⑤: 지도를 볼 수 없다는 사실
① 핵심 정의 — 경사하강법(Gradient Descent)↗은 현재 위치의 그래디언트를 구한 뒤 그 반대 방향으로 조금씩 이동하는 과정을 반복해 최솟값을 찾는 알고리즘입니다. 이동 폭을 정하는 값이 학습률(learning rate) (에타)입니다.
🙈 왜 그냥 "최솟값 공식"을 풀지 않나요?
아주 좋은 질문입니다. 처럼 간단한 함수는 을 연립방정식으로 풀면 최솟값이 이라고 즉시 나옵니다(🔗 01-06). 그런데 왜 굳이 한 걸음씩 기어갈까요?\
\
😱 이유: 신경망의 손실 함수는 풀 수 있는 식이 아니기 때문입니다.\
· 변수가 수억 개 → 연립방정식 크기가 수억 × 수억\
· 식이 ReLU·softmax 등으로 층층이 얽혀 있어 닫힌 해(공식)가 존재하지 않음\
· 데이터가 바뀔 때마다 지형도 바뀜\
\
그래서 우리는 "전체 지도를 보고 최저점을 짚는" 방법을 영구히 포기하고, "발밑만 보고 한 걸음씩 내려가는" 방법을 택합니다. 답답해 보이지만, 이것이 유일하게 확장 가능한(scalable) 방법입니다. 🐢
💜 더 쉽게 이해하기 ① — 🌫️ 안개 낀 산 (이 장의 대표 비유)
안개가 자욱한 산속에 서 있습니다. 시야는 1미터. 지도도 GPS도 없습니다. 하지만 발바닥으로 "어느 쪽이 오르막인지"는 느낄 수 있습니다(그래디언트). 목표는 산 아래 마을(최솟값)입니다.\
\
전략은 딱 하나뿐입니다:\
1️⃣ 발밑 경사를 느낀다 → 2️⃣ 가장 가파른 내리막 쪽으로 몸을 돌린다 → 3️⃣ 한 걸음 내딛는다 → 4️⃣ 다시 1번으로\
\
놀랍게도 이 단순한 규칙만으로 대부분 골짜기에 도착합니다. 전체를 몰라도, 국소 정보만으로 전역적인 목표에 접근할 수 있다 — 이것이 경사하강법의 마법이자, 현대 AI 전체를 지탱하는 아이디어입니다. ✨
💜 더 쉽게 이해하기 ② — 🚿 샤워기 온도 맞추기
낯선 호텔의 샤워기. 손잡이를 어느 각도로 놔야 딱 좋은 온도인지 미리 알 방법이 없습니다. 그래서 우리는 이렇게 합니다: 살짝 돌린다 → 너무 뜨겁다 → 반대로 조금 돌린다 → 너무 차다 → 다시 조금… 🔁\
\
· "너무 뜨겁다/차다"라는 피드백 = 그래디언트\
· 손잡이를 돌리는 각도 = 학습률\
· 몇 번 반복 후 딱 맞는 온도 = 수렴\
\
여러분은 이미 평생 경사하강법을 실행해 온 셈입니다. 🚿 수학은 이 상식에 이름을 붙였을 뿐입니다.
진행 과정
- 📍 시작 위치를 정한다 (예: — 실제 신경망에서는 무작위 초기화)
- 🏹 현재 위치에서 그래디언트 를 계산한다
- 👣 반대 방향으로 학습률만큼 이동한다:
- 🔁 새 위치에서 2~3번을 반복한다
- 🛑 그래디언트의 크기가 충분히 작아지면(=거의 평평해지면) 멈춘다
수학적 의미 — 갱신 공식 다시 보기
변수 정의 — : 현재 위치(파라미터), : 학습률(보폭), : 지금 그 자리에서 다시 계산한 그래디언트.
🔍 화살표 ← 의 의미: 이것은 등호(=)가 아니라 "덮어쓰기"입니다. "왼쪽 값을 오른쪽 계산 결과로 교체하라"는 명령이며, 파이썬의 w = w - lr * grad와 정확히 같습니다. 수학의 처럼 "양변이 같다"로 읽으면 라는 이상한 결론이 나오니 주의하세요! ⚠️\
\
🔍 매 걸음 새로 계산합니다: 그래디언트는 위치마다 다릅니다. 한 번 구한 방향으로 쭉 가는 것이 아니라, 한 걸음마다 멈춰 서서 발밑을 다시 확인합니다. 안개 속이니 당연하죠. 🌫️
구현 관점
import numpy as np

def compute_loss(position):
    """지형의 높이(손실값)를 계산합니다."""
    x, y = position
    return x ** 2 + 2 * y ** 2

def compute_gradient(position):
    """∇f = (∂f/∂x, ∂f/∂y) = (2x, 4y)"""
    x, y = position
    return np.array([2 * x, 4 * y])

def gradient_descent(start, learning_rate=0.1, num_steps=15):
    """
    경사하강법을 실행해 최솟값을 찾아갑니다.

    비유:
    안개 속에서 발바닥 감각(그래디언트)만으로
    한 걸음씩(학습률) 내리막을 내려가는 과정입니다.
    """
    position = np.array(start, dtype=float)
    path = [position.copy()]                      # 지나온 발자국 기록

    print(f"{'단계':>4} | {'x':>7} | {'y':>7} | {'f(x,y)':>8} | {'|grad|':>7}")
    for step in range(num_steps):
        grad = compute_gradient(position)     # 1) 발밑 경사 확인
        if step % 3 == 0:                       # 3걸음마다 기록 출력
            print(f"{step:>4} | {position[0]:>7.3f} | {position[1]:>7.3f} "
                  f"| {compute_loss(position):>8.4f} | {np.linalg.norm(grad):>7.4f}")
        position = position - learning_rate * grad # 2) 반대 방향으로 한 걸음 ★핵심
        path.append(position.copy())

    return position, np.array(path)

final_position, path = gradient_descent(start=[4.0, 3.0])
print(f"\n최종 위치: ({final_position[0]:.6f}, {final_position[1]:.6f})")
print(f"최종 손실: {compute_loss(final_position):.6f}")
🔗 GitHub에서 코드 보기 — 01_10_partial_derivative_gradient_descent.py L46–L82
🔍 코드 상세 분석
position = np.array(start, dtype=float) — 시작 좌표를 실수형 배열로 변환합니다. [4, 3]처럼 정수로 넣으면 이후 소수 계산이 잘려나가는 사고가 납니다. 🐛\
path = [position.copy()] — 발자국을 기록할 리스트. .copy()가 없으면 같은 메모리를 가리켜 기록이 전부 마지막 값으로 덮어써집니다. NumPy 초보자의 대표적 함정입니다.\
grad = compute_gradient(position) — 3단계 함수를 그대로 재사용합니다. 매 반복마다 새로 계산한다는 점이 핵심입니다.\
position = position - learning_rate * grad — 🌟 이 책 전체에서 가장 중요한 한 줄. 수식 를 코드로 옮긴 것입니다. 마이너스(4단계), 학습률(6단계)이 여기 다 들어 있습니다.\
np.linalg.norm(grad) — 남은 경사의 크기. 이 값이 0에 가까워지는지가 학습이 잘 되는지의 척도입니다.
🐍 Python 기초 설명
learning_rate=0.1— 기본값 인자: 호출 시 생략하면 자동으로 0.1이 쓰입니다. 그래서gradient_descent([4.0, 3.0])만 써도 동작합니다.\
f"{x:>7.3f}"— f-string 서식:>7은 "폭 7칸에 오른쪽 정렬",.3f는 "소수점 셋째 자리까지". 표처럼 줄을 맞춰 출력할 때 씁니다. 📊\
step % 3 == 0— 나머지 연산: 3으로 나눈 나머지가 0, 즉 0·3·6·9…번째에만 참이 됩니다. 로그를 솎아낼 때 자주 쓰는 패턴입니다.\
position.copy()— 얕은 복사: 값을 새 메모리에 복제합니다. NumPy 배열은 대입만으로는 복사되지 않고 같은 것을 가리키기만 합니다. 📎
실행 결과 ▶️ (실제 실행해 검증한 값입니다)
  단계 |       x |       y |   f(x,y) |  |grad|
   0 |   4.000 |   3.000 |  34.0000 | 14.4222
   3 |   2.048 |   0.648 |   5.0341 |  4.8472
   6 |   1.049 |   0.140 |   1.1387 |  2.1706
   9 |   0.537 |   0.030 |   0.2901 |  1.0805
  12 |   0.275 |   0.007 |   0.0756 |  0.5504

최종 위치: (0.140737, 0.001411)
최종 손실: 0.019811
📖 결과 읽는 법 — 숫자 3개만 보세요
1️⃣ 손실 가 34 → 0.02: 약 1,700배 줄었습니다. 하산 성공! 📉\
2️⃣ 가 보다 훨씬 빨리 줄어듭니다 (3.000 → 0.007 vs 4.000 → 0.275). 왜일까요? 방향 기울기 가 방향 보다 2배 가파르기 때문입니다. 3단계에서 를 보고 예측했던 그대로입니다. 수식이 예언한 것을 숫자가 확인해 주었습니다. 🎯\
3️⃣ 가 14.4 → 0.55: 경사가 완만해지고 있습니다. 즉 골짜기에 가까워졌다는 신호입니다.\
\
🧮 손으로 검산해 보기: 이 함수에서는 갱신식이 가 됩니다. 즉 매 걸음 가 0.8배! 15걸음이면 ✅ 출력값과 정확히 일치합니다. 는 이니 ✅. 이렇게 "왜 이 숫자가 나왔는지"까지 확인하면 경사하강법이 더 이상 블랙박스가 아닙니다. 🔓
💜 클래스로 다시 만들어보기 (선택 심화 🚀)
지금은 함수 하나로 충분하지만, 이후 권에서 만들 미니 딥러닝 프레임워크에서는 옵티마이저를 클래스로 만듭니다. 클래스 이름은 PascalCase(
GradientDescentOptimizer), 메서드는 snake_case(step)가 이 책의 규칙입니다. 미리 감을 잡아볼까요?
class GradientDescentOptimizer:
    """
    규칙 하나만 아는 아주 작은 옵티마이저.

    비유:
    "그래디언트의 반대 방향으로, 정해진 보폭만큼만 이동한다"는
    규칙 하나만 기억하는 작은 로봇 🤖 이라고 생각하세요.
    """

    def __init__(self, learning_rate=0.1):
        self.learning_rate = learning_rate    # 보폭 η 저장

    def step(self, position, grad):
        """한 걸음 이동시킵니다: w ← w - η∇f"""
        return position - self.learning_rate * grad

optimizer = GradientDescentOptimizer(learning_rate=0.1)
position = np.array([4.0, 3.0])
for _ in range(15):
    grad = compute_gradient(position)
    position = optimizer.step(position, grad)   # PyTorch의 optimizer.step()과 같은 이름!
🔗 GitHub에서 코드 보기 — 01_10_partial_derivative_gradient_descent.py L86–L106
👀 마지막 줄의 optimizer.step()을 잘 보세요. PyTorch에서 매일 쓰게 될 바로 그 이름입니다. 여러분은 방금 PyTorch 옵티마이저의 축소판을 직접 만든 것입니다. 🎉
🖼️ 시각화 ⑦ — 곡선 위에서 기울기가 알려주는 것
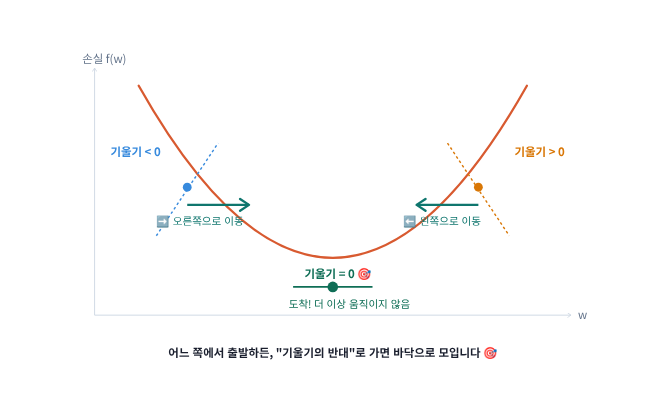
✨ 이 그림의 아름다움은 "어느 쪽에서 시작하든 규칙이 하나뿐"이라는 점입니다. 왼쪽이면 오른쪽으로, 오른쪽이면 왼쪽으로 — 별도 조건문이 필요 없습니다. 부호가 알아서 처리해 주니까요. w = w - lr * grad 이 한 줄이 두 경우를 모두 담습니다. 👏
🧠 한 줄 정리 — 지도를 못 봐도 괜찮습니다. 발밑 경사 하나면 충분합니다. 벽 ⑤ 격파! ✅
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/01-ml-math-basics-python/01-10-partial-derivative-gradient-descent
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
01_10_partial_derivative_gradient_descent.py | 책의 코드 블록 8개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
01_10_partial_derivative_gradient_descent.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🧪 저장소 검증 상태: 🧩 문맥 필요(조각) — Block 6 은 PyTorch 학습 루프 3줄 요약(
optimizer.zero_grad()등)으로, 앞 블록에서 만든 직접 구현 옵티마이저에는 해당 메서드가 없어 오류가 납니다 (설명용 조각).
🔑 핵심 코드 1 — 그래디언트 ∇f = (2x, 4y) — 편미분 두 개를 벡터 하나로
📄 01_10_partial_derivative_gradient_descent.py L25–L42 · Block 1 (01-10-C 3단계 — 🧩 벽 ③: 미분과 벡터가 한꺼번에 나온다)
def compute_gradient(position):
    """
    현재 위치에서의 그래디언트 ∇f = (∂f/∂x, ∂f/∂y)를 계산합니다.

    비유:
    "동쪽으로 한 발짝, 북쪽으로 한 발짝" 갔을 때
    고도가 각각 얼마나 변하는지 재는 것과 같습니다.
    """
    x, y = position
    df_dx = 2 * x   # x 방향 편미분 ∂f/∂x = 2x
    df_dy = 4 * y   # y 방향 편미분 ∂f/∂y = 4y
    return np.array([df_dx, df_dy])

position = np.array([1.0, 1.0])
grad = compute_gradient(position)

print("그래디언트 ∇f =", grad)
print("크기 |∇f|   =", np.linalg.norm(grad))
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
그래디언트 ∇f = [2. 4.]
크기 |∇f|   = 4.47213595499958
🔑 핵심 코드 2 — 경사하강법 w ← w − η∇f — 발밑 경사만 보고 15걸음
📄 01_10_partial_derivative_gradient_descent.py L58–L82 · Block 2 (01-10-E 5단계 — 🙈 벽 ⑤: 지도를 볼 수 없다는 사실)
def gradient_descent(start, learning_rate=0.1, num_steps=15):
    """
    경사하강법을 실행해 최솟값을 찾아갑니다.

    비유:
    안개 속에서 발바닥 감각(그래디언트)만으로
    한 걸음씩(학습률) 내리막을 내려가는 과정입니다.
    """
    position = np.array(start, dtype=float)
    path = [position.copy()]                      # 지나온 발자국 기록

    print(f"{'단계':>4} | {'x':>7} | {'y':>7} | {'f(x,y)':>8} | {'|grad|':>7}")
    for step in range(num_steps):
        grad = compute_gradient(position)     # 1) 발밑 경사 확인
        if step % 3 == 0:                       # 3걸음마다 기록 출력
            print(f"{step:>4} | {position[0]:>7.3f} | {position[1]:>7.3f} "
                  f"| {compute_loss(position):>8.4f} | {np.linalg.norm(grad):>7.4f}")
        position = position - learning_rate * grad # 2) 반대 방향으로 한 걸음 ★핵심
        path.append(position.copy())

    return position, np.array(path)

final_position, path = gradient_descent(start=[4.0, 3.0])
print(f"\n최종 위치: ({final_position[0]:.6f}, {final_position[1]:.6f})")
print(f"최종 손실: {compute_loss(final_position):.6f}")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
  단계 |       x |       y |   f(x,y) |  |grad|
   0 |   4.000 |   3.000 |  34.0000 | 14.4222
   3 |   2.048 |   0.648 |   5.0341 |  4.8472
   6 |   1.049 |   0.140 |   1.1387 |  2.1706
   9 |   0.537 |   0.030 |   0.2901 |  1.0805
  12 |   0.275 |   0.007 |   0.0756 |  0.5504

최종 위치: (0.140737, 0.001411)
최종 손실: 0.019811
📝 실행 메모
- Block 6 은(는) 단독 실행되지 않습니다:
AttributeError: 'GradientDescentOptimizer' object has no attribute 'zero_grad'— 2부(8단계)에서 다루는 PyTorch 학습 루프 3줄 요약으로,loss와 진짜 PyTorch 옵티마이저가 있어야 하는 설명용 조각입니다.
☁️ Colab에서 바로 실행
👉 Open in Colab — 01_10_partial_derivative_gradient_descent.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/01-ml-math-basics-python/01-10-partial-derivative-gradient-descent
python 01_10_partial_derivative_gradient_descent.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 01-10 편미분·그래디언트·경사하강법 (2부) 👣 입니다. 이번 글에서 만든 경사하강법의 보폭 를 0.01부터 0.9까지 바꿔 수렴·진동·발산을 재현하고, 발밑이 평평해도 바닥이 아닐 수 있는 지역 최솟값·안장점의 함정, 그리고 같은 원리가 100만 차원 신경망 학습에서 그대로 작동하는 모습을 본 뒤 실습·연습문제로 장을 마무리합니다.
⬅️ 이전 글: #24 미분 기초 — 계단 기울기에서 순간 변화율·거듭제곱 미분 규칙·경사하강법까지 (파이썬 실습) \
➡️ 다음 글: #26 학습률·지역 최솟값·안장점 — 경사하강법의 함정과 신경망 학습 (편미분·그래디언트 2부, 파이썬 NumPy)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 01-10 편미분·그래디언트·경사하강법 (1부) | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌