1. 인덱스란?
인덱스는 "데이터를 빨리 찾기 위한 목차"이다.
만약 어떤 책에서 목차가 없다면 처음부터 끝까지 읽어서 내가 원하는 부분을 찾아야한다.
반대로 목차가 있는 책이라면?
목차를 보고 바로 내가 원하는 페이지로 이동할 수 있다.
IF 인덱스 ❌
SELECT * FROM USER WHERE NAME = "SONG"DB가 하는일❕
1. 첫 번째 행 뒤짐
2. 두 번째 행 뒤짐
.
.
.
3. 마지막 행 뒤짐!
➡️ 풀스캔을 한다
IF 인덱스 ⭕️
CREATE INDEX IDX_USER_NAME ON USER(NAME);DB가 하는일❕
1. NAME 인덱스에서 SONG을 찾는다
2. 바로 해당 행의 데이터 접근
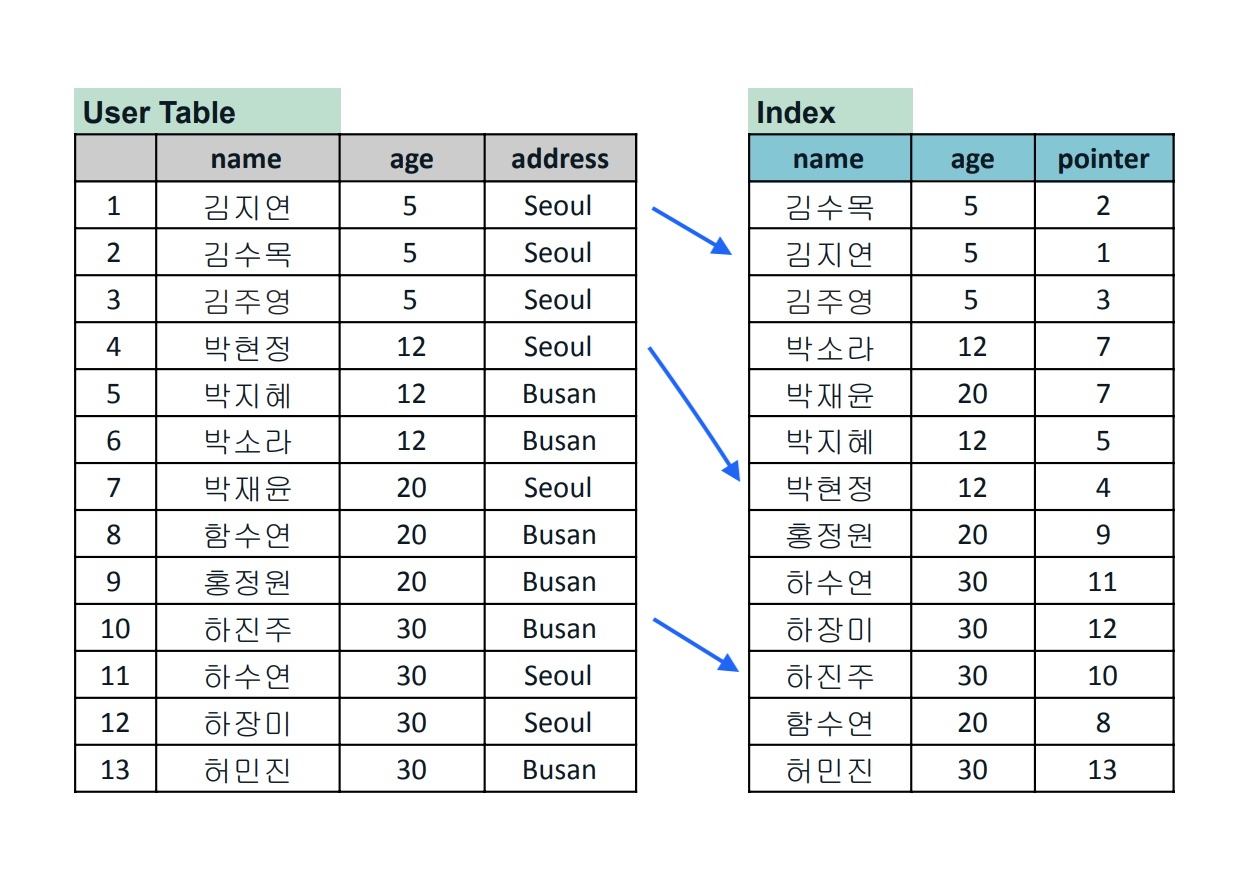
출처 : https://velog.io/@anrun/efficient-index
2. B+Tree 구조
별도의 저장공간이 생성되며 B-Tree, Hash, Bitmap과 같은 구조로 컬럼의 값과 물리적 주소를 한쌍으로 저장한다.
인덱스 유형 중 가장 많이 사용하는 것은 B-Tree(균형트리, Balance Tree) 구조이다.
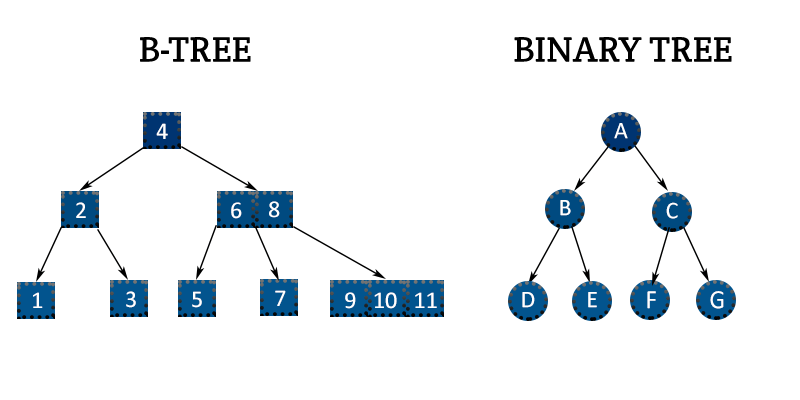
B-Tree 구조는 위와 같이 아무렇게나 나열한 것이 아니라 트리형태로 되어있다.
B-Tree 구조는 중간값을 기준으로 반씩 줄여가면서 찾을 수 있기 때문에 훨씬 빨라진다.
자식이 두개씩 존재하는 이진트리와 달리 B-Tree는 한 노드에 여러 값을 가지기 때문에 성능에 유리하다.
예를 들어 아래와 같은 인덱스가 있다고 하자.
                     [20 | 40 | 60]
               /      |      |      \
      [5 | 10]   [25 | 30] [45 | 50] [70 | 80]
여기에서 50을 찾고싶다!
1. 루트 [20 | 40 | 60]을 본다.
2. 50은 40보다 크고 60보다 작음
3. 세 번째 자식으로 이동
4. [45 | 50]에서 찾음
➡️ 한번에 여러 범위를 확확 줄여나갈 수 있음
여기에서 B-Tree는 "균형"트리이다.
따라서 각 노드가 비슷한 밀도를 유지한다.
B-Tree는 “노드 크기 제한 + 절반 유지 규칙”으로 자동 균형을 맞춘다
3. 인덱스 타는 경우 vs 안 타는 경우
1) 인덱스 타는 경우
- = 조건
가장 기본적인 케이스이다.
만약 user가 인덱스라면,
SELECT *
FROM USER
WHERE USER_ID = 'A123'- 범위검색
SELECT *
FROM ORDER
WHERE ORDER_DATE >= '2026-01-01'
< > <= => BETWEEN 사용 가능
- ORDER BY
SELECT *
FROM USER
ORDER BY USER_ID
이미 인덱스가 정렬된 상태이기 때문에
DB가 따로 정렬을 하지 않고 읽을 수 있음
정렬 비용 절감 효과 있음!
- JOIN
SELECT *
FROM ORDER A
JOIN USER B
ON A.USER_ID = B.USER_ID
JOIN키에 인덱스가 있다면
JOIN이 엄청 빨라진다.
2) 인덱스 타지 않는 경우
- 함수사용하는 경우
SELECT *
FROM USER
WHERE UPPER(NAME) = 'SONG'
인덱스는 기본값('SONG')으로 저장되어 있기 때문에
함수를 사용하면 인덱스를 타지 않는다.
- 계산식
WHERE SALARY * 12 > 50000계산식이 포함되어 있는 인덱스는 인덱스를 타지 못한다!
- LIKE '%단어'
WHERE NAME LIKE '%ONG'B-Tree 는 루트->범위찾기 순서로 기능하는데,
앞쪽에 %가 있으면 범위를 찾지 못해 인덱스로 찾지 못한다.
WHERE NAME LIKE 'SON%'이것은 인덱스를 탈 수 있음
3. 실무에서 제일 많이 보는 문제
WHERE TO_CHAR(ORDER_DATE,'YYYY') = '2026'인덱스 못 탐.
좋은 쿼리
WHERE ORDER_DATE >= DATE '2026-01-01'
AND ORDER_DATE < DATE '2027-01-01'
👉 인덱스 사용 가능.
4. 인덱스가 오히려 느려지는 경우
인덱스의 핵심은
1. 인덱스의 위치 찾는다.
2. 실제 테이블 접근
즉 두번 읽는 것이 핵심이다.
- 조회건수가 너무 많을 때
SELECT *
FROM USER
WHERE GENDER = 'F';
전체 50% 이상 조회하기 때문에 인덱스 찾고 -> 테이블 왔다갔다 하면서
인덱스를 사용하는 것이 더 느려진다.
- 컬럼이 많을 수록 더 느려진다!
SELECT *
FROM ORDER_INFO
WHERE ORDER_ID = '100';
컬럼 많으면 많을수록
-> 테이블 접근 비용 증가
- 인덱스가 너무 많을 때 (INSERT/UPDATE 느림)
인덱스가 많을 수록
INSERT를 하게되면
인덱스1 수정
인덱스2 수정
.
.
.
모든 인덱스를 수정하게 된다.
쓰기 성능 급격히 저하
