(2024-06-09)
ETL을 하는 이유는 결국 ELT를 하기 위함이며 이 때 데이터 품질 검증이 중요해짐
데이터 품질의 중요성 증대
- 입출력 체크
- 더 다양한 품질 검사
- 리니지 체크
- 데이터 히스토리 파악
- 데이터 품질 유지 -> 비용/노력 감소와 생산성 증대의 지름길
Database Normalization (정규화)
- 데이터베이스를 좀더 조직적이고 일관된 방법으로 디자인하려는 방법
- 데이터베이스 정합성을 쉽게 유지하고 레코드들을 수정/적재/삭제를 용이하게 하는 것
- Normalization에 사용되는 개념
- Primary Key
- Composite Key
- Foreign Key
1NF (First Normal Form)
- 한 셀에는 하나의 값만 있어야함
- Primary Key가 있어야함중복된 키나 레코드들이 없어야함
-> 목표는 중복을 제거하고 atomicity를 갖는 것
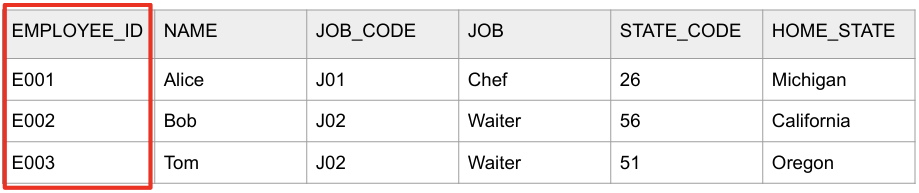
2NF (First Normal Form)
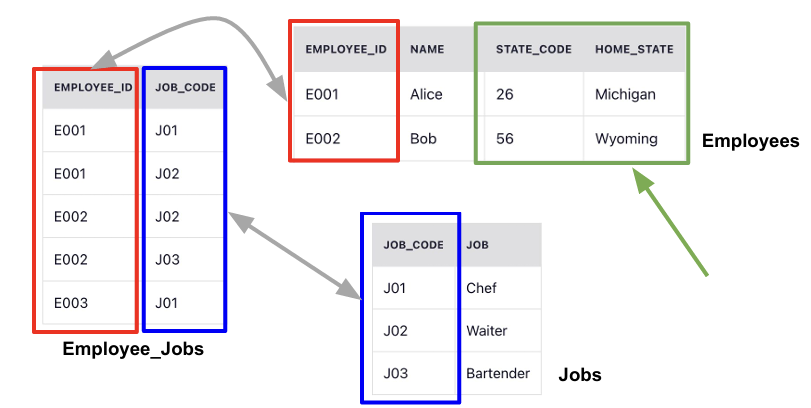
- 일단 1NF를 만족해야함
- 다음으로Primary Key를 중심으로 의존결과를 알 수 있어야함
- 부분적인 의존도가 없어야함
- 즉 모든 부가 속성들은 Primary key를 가지고 찾을 수 있어야함
- That is, all non-key attributes are fully dependent on a primary key
3NF (Third Normal Form)
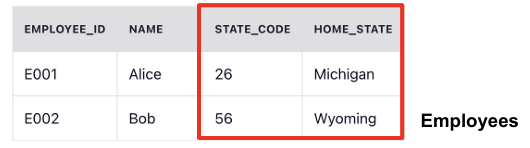
- 일단 2NF를 만족해야함
- 전이적 부분 종속성을 없어야함
- 2NF의 예에서 state_code과 home_state가 같이 Employees 테이블에 존재
Slowly Changing Dimensions (SCD)
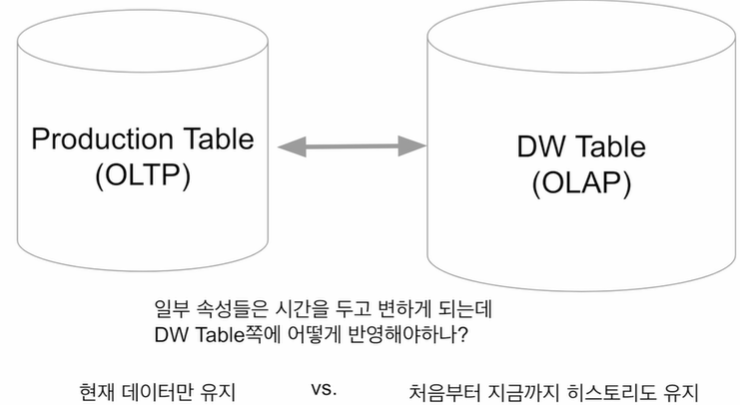
- DW나 DL에서는 모든 테이블들의 히스토리를 유지하는 것이 중요함
- 보통 두 개의 timestamp 필드를 갖는 것이 좋음
- created_at (생성시간으로 한번 만들어지면 고정됨)
- updated_at (꼭 필요 마지막 수정 시간을 나타냄)
- 보통 두 개의 timestamp 필드를 갖는 것이 좋음
- 이 경우 컬럼의 성격에 따라 어떻게 유지할지 방법이 달라짐
SCD Type 0
- 한번 쓰고 나면 바꿀 이유가 없는 경우들
- 한번 정해지면 갱신되지 않고 고정되는 필드들
- 예) 고객 테이블이라면 회원 등록일, 제품 첫 구매일
SCD Type 1
- 데이터가 새로 생기면 덮어쓰면 되는 컬럼들
- 처음 레코드 생성시에는 존재하지 않았지만 나중에 생기면서 채우는 경우
- 예) 고객 테이블이라면 연간소득 필드
SCD Type 2
- 특정 entity에 대한 데이터가 새로운 레코드로 추가되어야 하는 경우
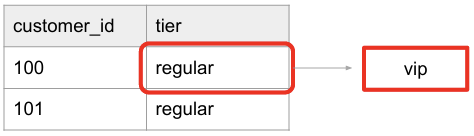
- 예) 고객 테이블에서 고객의 등급 변화
- tier라는 컬럼의 값이 “regular”에서 “vip”로 변화하는 경우
- 변경시간도 같이 추가되어야함
SCD Type 3
- SCD Type 2의 대안으로 특정 entity 데이터가 새로운 컬럼으로 추가되는 경우
- 예) 고객 테이블에서 tier라는 컬럼의 값이 “regular”에서 “vip”로 변화하는 경우
- previous_tier라는 컬럼 생성
- 변경시간도 별도 컬럼으로 존재해야함
SCD Type 4
- 특정 entity에 대한 데이터를 새로운 Dimension 테이블에 저장하는 경우
- SCD Type 2의 변종
- 예) 별도의 테이블로 저장하고 이 경우 아예 일반화할 수도 있음
dbt란 무엇인가?
- Data Build Tool (https://www.getdbt.com/)
- ELT용 오픈소스: In-warehouse data transformation (이미 웨어하우스에 들어옴)
- dbt Labs라는 회사가 상용화 ($4.2B valuation)
- Analytics Engineer라는 말을 만들어냄
- 다양한 데이터 웨어하우스를 지원
- Redshift, Snowflake, Bigquery, Spark
- 클라우드 버전도 존재
- dbt Cloud
dbt 구성 컴포넌트
- 데이터 모델 (models)
- 테이블들을 몇개의 티어로 관리
- 일종의 CTAS (SELECT 문들), Lineage 트래킹
- 테이블들을 몇개의 티어로 관리
- Table, View, CTE 등등
- 데이터 품질 검증 (tests)
- 스냅샷 (snapshots)
다음과 같은 요구조건을 달성해야한다면?
- 데이터 변경 사항을 이해하기 쉽고 필요하다면 롤백 가능
- 데이터간 리니지 확인 가능
- 데이터 품질 테스트 및 에러 보고
- Fact 테이블의 증분 로드 (Incremental Update)
- Dimension 테이블 변경 추적 (히스토리 테이블)
- 용이한 문서 작성
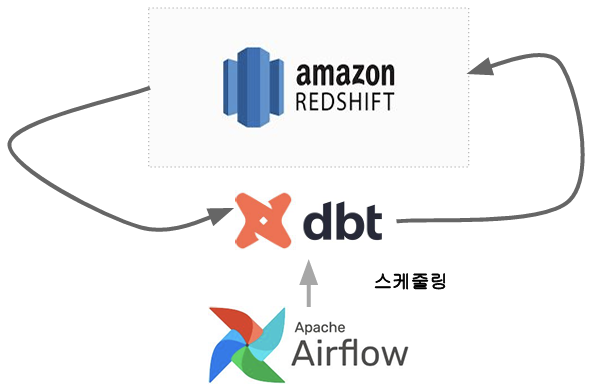
무슨 ELT 작업을 해볼까요?
- Redshift 사용
- AB 테스트 분석을 쉽게 하기 위한 ELT 테이블을 만들어보자
- 입력 테이블:
- user_event, user_variant, user_metadata
- 생성 테이블: Variant별 사용자별 일별 요약 테이블
- variant_id, user_id, datestamp, age, gender,
- 총 impression, 총 click, 총 purchase, 총 revenue
입력 데이터들
- Production DB에 저장되는 정보들을 Data Warehouse로 적재했다고 가정
- raw_data.user_event
- 사용자/날짜/아이템별로 impression이 있는 경우 그 정보를 기록하고 impression으로부터 클릭, 구매, 구매시 금액을 기록. 실제 환경에서는 이런 aggregate 정보를 로그 파일등의 소스(하나 이상의 소스가 될 수도 있음)로부터 만들어내는 프로세스가 필요함
- raw_data.user_variant
- 사용자가 소속한 AB test variant를 기록한 파일 (control vs. test)
- raw_data.user_metadata
- 사용자에 관한 메타 정보가 기록된 파일 (성별, 나이 등등)
입력데이터: raw_data.user_event
 CREATE TABLE raw_data.user_event (
    user_id int,
    datestamp timestamp,
    item_id int,
    clicked int,
    purchased int,
    paidamount int
 );
입력데이터: raw_data.user_variant
 CREATE TABLE raw_data.user_variant (
    user_id int,
    variant_id varchar(32)   -- control vs. test
);- 보통은 experiment와 variant 테이블이 별도로 존재함
- 그리고 위의 테이블에도 언제 variant_id로 소속되었는지 타임스탬프 필드가 존재하는 것이 일반적
입력데이터: raw_data.user_metadata
 CREATE TABLE raw_data.user_metadata (
    user_id int,
    age varchar(16),
    gender varchar(16)
);- 사용자별 메타정보: 이를 이용해 다양한 각도에서 AB 테스트 결과를 분석해볼 수 있음
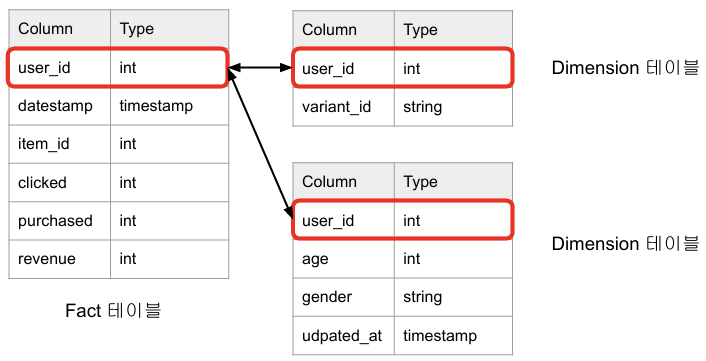
Fact 테이블과 Dimension 테이블
- Fact 테이블: 분석의 초점이 되는 양적 정보를 포함하는 중앙 테이블
- 일반적으로 매출 수익, 판매량, 이익과 같은 측정 항목 포함. 비즈니스 결정에 사용
- Fact 테이블은 일반적으로 외래 키를 통해 여러 Dimension 테이블과 연결됨
- 보통 Fact 테이블의 크기가 훨씬 더 큼
- Dimension 테이블: Fact 테이블에 대한 상세 정보를 제공하는 테이블
- 고객, 제품과 같은 테이블로 Fact 테이블에 대한 상세 정보 제공
- Fact 테이블의 데이터에 맥락을 제공하여 다양한 방식으로 분석 가능하게 해
- Dimension 테이블은 primary key를 가지며, fact 테이블에서 참조 (foreign key)
- 보통 Dimension 테이블의 크기는 훨씬 더 작음
입력 데이터 요약
- user_event, user_variant, user_metadata
최종 생성 데이터 (ELT 테이블)
- SELECT로 표현하면 아래와 같음
SELECT
	variant_id,
    ue.user_id,
    datestamp,
    age,
    gender,
    COUNT(DISTINCT item_id) num_of_items, -- 총 impression
    COUNT(DISTINCT CASE WHEN clicked THEN item_id END) num_of_clicks, -- 총 click
    SUM(purchased) num_of_purchases,  -- 총 purchase
    SUM(paidamount) revenue                   -- 총 revenue
FROM raw_data.user_event ue
JOIN raw_data.user_variant uv ON ue.user_id = uv.user_id
JOIN raw_data.user_metadata um ON uv.user_id = um.user_id
GROUP by 1, 2, 3, 4, 5;
DBT 설치와 환경 설정
- dbt 사용절차
- dbt 설치
- dbt Cloud vs. dbt Core
- git을 보통 사용함
- dbt 환경설정
- Connector 설정
- Connector가 바로 바탕이 되는 데이터 시스템 (Redshift, Spark, …)
- 데이터 모델링 (tier)
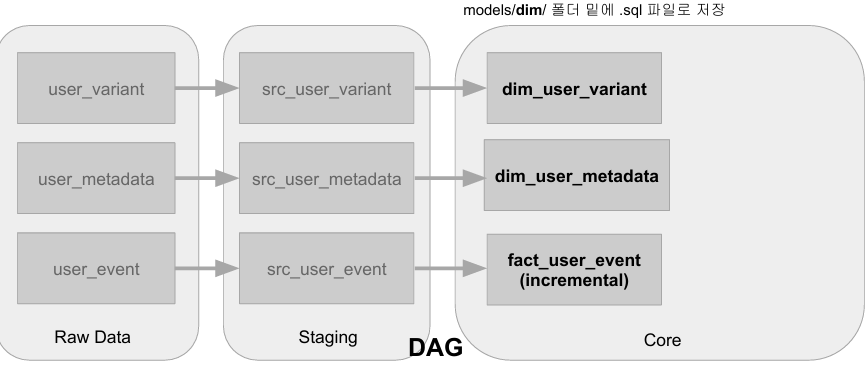
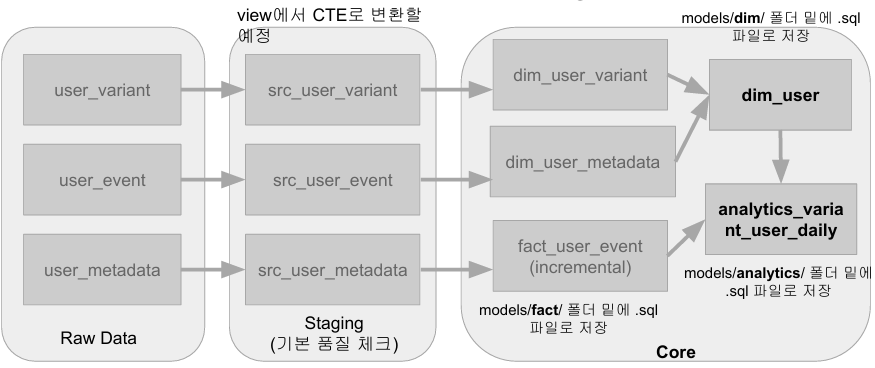
- Raw Data -> Staging -> Core
- 테스트 코드 작성
- (필요하다면) Snapshot 설정
dbt Models: Input
Model이란?
- ELT 테이블을 만듬에 있어 기본이 되는 빌딩블록
- 테이블이나 뷰나 CTE의 형태로 존재
- 입력,중간,최종 테이블을 정의하는 곳
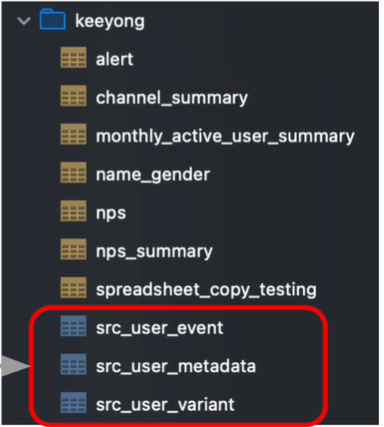
- 티어 (raw, staging, core, …)
- raw => staging (src) => core
잠깐: View란 무엇인가?
- SELECT 결과를 기반으로 만들어진 가상 테이블
- 기존 테이블의 일부 혹은 여러 테이블들을 조인한 결과를 제공함
- CREATE VIEW 이름 AS SELECT …
- View의 장점
- 데이터의 추상화: 사용자는 View를 통해 필요 데이터에 직접 접근. 원본 데이터를 알 필요가 없음
- 데이터 보안: View를 통해 사용자에게 필요한 데이터만 제공. 원본 데이터 접근 불필요
- 복잡한 쿼리의 간소화: SQL(View)를 사용하면 복잡한 쿼리를 단순화.
- View의 단점
- 매번 쿼리가 실행되므로 시간이 걸릴 수 있음
- 원본 데이터의 변경을 모르면 실행이 실패함
잠깐: CTE (Common Table Expression)
 WITH src_user_event AS (
    SELECT * FROM raw_data.user_event
 )
 SELECT
    user_id,
    datestamp,
    item_id,
    clicked,
    purchased,
    paidamount
 FROM
    src_user_event
Model 구성 요소
- Input
- 입력(raw)과 중간(staging, src) 데이터 정의
- raw는 CTE로 정의
- staging은 View로 정의
- Output
- 최종(core) 데이터 정의
- core는 Table로 정의
- 이 모두는 models 폴더 밑에 sql 파일로 존재
- 기본적으로는 SELECT + Jinja 템플릿과 매크로
- 다른 테이블들을 사용 가능 (reference)
- 이를 통해 리니지 파악
데이터 빌딩 프로세스

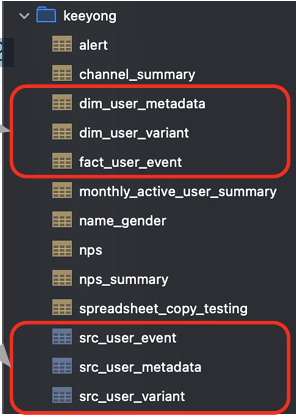
Model 빌딩 확인
- 해당 스키마 밑에 테이블 생성 여부 확인
- dbt run은 프로젝트 구성 다양한 SQL 실행
- 이 SQL들은 DAG로 구성됨
- dbt run은 보통 다른 더 큰 명령의 일부로 실행
- dbt test
- dbt docs generate
dbt Models: Output
Materialization이란?
- 입력 데이터(테이블)들을 연결해서 새로운 데이터(테이블) 생성하는 것
- 보통 여기서 추가 transformation이나 데이터 클린업 수행
- 4가지의 내장 materialization이 제공됨
- 파일이나 프로젝트 레벨에서 가능
- 역시 dbt run을 기타 파라미터를 가지고 실행
4가지의 Materialization 종류
- View
- 데이터를 자주 사용하지 않는 경우
- Table
- 데이터를 반복해서 자주 사용하는 경우
- Incremental (Table Appends)
- Fact 테이블
- 과거 레코드를 수정할 필요가 없는 경우
- Ephemeral (CTE)
- 한 SELECT에서 자주 사용되는 데이터를 모듈화하는데 사용
잠깐 Jinja 템플릿이란?
- 파이썬이 제공해주는 템플릿 엔진으로 Flask에서 많이 사용
- Airflow에서도 사용함
- 입력 파라미터 기준으로 HTML 페이지(마크업)를 동적으로 생성
- 조건문, 루프, 필터등을 제공
dbt compile vs. dbt run
- dbt compile은 SQL 코드까지만 생성하고 실행하지는 않음
- dbt run은 생성된 코드를 실제 실행함
Model 빌딩 확인
- 해당 스키마 밑에 테이블 생성 여부 확인
- Core 테이블들은 Table
- Staging 테이블들은 View
데이터 빌딩 프로세스
Seeds 소개
- 많은 dimension 테이블들은 크기가 작고 많이 변하지 않음
- Seeds는 이를 파일 형태로 데이터웨어하우스로 로드하는 방법
- Seeds는 작은 파일 데이터를 지칭 (보통 csv 파일)
- dbt seed를 실행해서 빌드
Sources 소개
- 기본적으로 처음 입력이 되는 ETL 테이블을 대상으로 함
- 별칭 제공
- 최신 레코드 체크 기능 제공
- 테이블 이름들에 별명(alias)을 주는 것
- 이를 통해 ETL단의 소스 테이블이 바뀌어도 뒤에 영향을 주지 않음
- 추상화를 통한 변경처리를 용이하게 하는 것
- 이 별명은 source 이름과 새 테이블 이름의 두 가지로 구성됨
- 예) raw_data.user_metadata -> keeyong, metadata
- Source 테이블들에 새 레코드가 있는지 체크해주는 기능도 제공
Sources 최신성 (Freshness)
- 특정 데이터가 소스와 비교해서 얼마나 최신성이 떨어지는지 체크하는 기능
- dbt source freshness 명령으로 수행
- 이를 하려면 models/sources.yml의 해당 테이블 밑에 아래 추가
 sources:
  - name: keeyong
    schema: raw_data
    tables:
      - name: event
        identifier: user_event
        loaded_at_field: datestamp
        freshness:
          warn_after: { count: 1, period: hour }
          error_after: { count: 24, period: hour }
DBT Snapshots
- Dimension 테이블은 성격에 따라 변경이 자주 생길 수 있음
- dbt에서는 테이블의 변화를 계속적으로 기록함으로써 과거 어느 시점이건 다시 돌아가서 테이블의 내용을 볼 수 있는 기능을 이야기함
- 이를 통해 테이블에 문제가 있을 경우 과거 데이터로 롤백 가능
- 다양한 데이터 관련 문제 디버깅도 쉬워짐
dbt의 스냅샷 처리 방법
- 먼저 snapshots 폴더에 환경설정이 됨
- snapshots을 하려면 데이터 소스가 일정 조건을 만족해야함
- Primary key가 존재해야함
- 레코드의 변경시간을 나타내는 타임스탬프 필요 (updated_at, modified_at 등등)
- 변경 감지 기준
- Primary key 기준으로 변경시간이 현재 DW에 있는 시간보다 미래인 경우
- Snapshots 테이블에는 총 4개의 타임스탬프가 존재
- dbt_scd_id, dbt_updated_at
- valid_from, valid_to
DBT Tests 소개
- 데이터 품질을 테스트하는 방법
- 두 가지가 존재
- 내장 일반 테스트 (“Generic”)
- unique, not_null, accepted_values, relationships 등의 테스트 지원
- models 폴더
- 커스텀 테스트 (“Singular”)
- 기본적으로 SELECT로 간단하며 결과가 리턴되면 “실패”로 간주
- tests 폴더
- 내장 일반 테스트 (“Generic”)
Generic Tests 구현
- models/schema.yml 파일 생성
version: 2
 models:
  - name: dim_user_metadata
    columns:
    - name: user_id
      tests:
      - unique
      - not_null
Singular Tests 구현
- tests/dim_user_metadata.sql 파일 생성
- Primary Key Uniqueness 테스트
SELECT
    *
 FROM (
  SELECT
    user_id, COUNT(1) cnt
  FROM
    {{ ref("dim_user_metadata") }}
  GROUP BY 1
  ORDER BY 2 DESC
  LIMIT 1
 )
 WHERE cnt > 1
DBT Documentation 소개
- 기본 철학은 문서와 소스 코드를 최대한 가깝게 배치하자는 것
- 문서화 자체는 두 가지 방법이 존재
- 기존 .yml 파일에 문서화 추가 (선호되는 방식)
- 독립적인 markdown 파일 생성
- 이를 경량 웹서버로 서빙
- overview.md가 기본 홈페이지가 됨
- 이미지등의 asset 추가도 가능
models 문서화 하기
- description 키를 추가: models/schema.yml, models/sources.yml
 version: 2
 models:
  - name: dim_user_metadata
 description: A dimension table with user metadata
    columns:
    - name: user_id
 description: The primary key of the table
      tests:
      - unique
- not_null- dbt docs generate
- 사용자 권한이 더 있다면 Redshift로부터 더 많은 정보를 가져다가 보여줌
- 결과 파일은 target/catalog.json 파일이 됨
DBT Expectations 소개
- Great Expectations에서 영감을 받아 dbt용으로 만든 dbt 확장판
- 설치 후 packages.yml에 등록
packages:
 - package: calogica/dbt_expectations
version: [">=0.7.0", "<0.8.0"]- 보통은 앞서 dbt 제공 테스트들과 같이 사용
- models/schema.yml

새싹 개발자