데이터 엔지니어링 TIL
1.자료구조/알고리즘 (1)
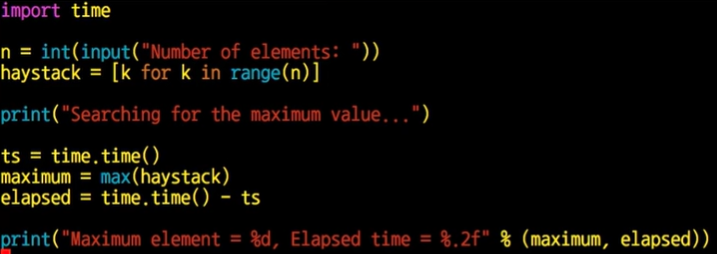
자료형 (Data Type) : 문자열(str), 리스트 (list), 사전 (dict), 순서쌍(tuple), 집합(set), ...Python에서 제공하는 데이터 타입으로 다 해결할 수 있을 것 같은데 "자료구조" 라는 것은, 도대체 왜 알아야 하는 거지?효과적으로
2.자료구조/알고리즘 (2)
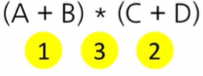
7강 연결 리스트 (Linked Lists)(1) 추상적 자료구조 (Abstract Data structures) 자료구조의 내부구현은 숨겨두고 보여지는 것들 두가지를 제공하는 것 > Data : 정수, 문자열, 레코드, ... A set of operations (연
3.자료구조/알고리즘 (3)
14강 큐 (Queues) >자료(data element)를 보관할 수 있는 선형 구조 단, 넣을 때에는 한 쪽 끝에서 밀어 넣어야 하고 -> 인큐 (enqueue) 연산 꺼낼 때에는 반대 쪽에서 뽑아 꺼내야 하는 제약이 있음 -> 디큐 (dequeue) 연산 선입선출
4.자료구조/알고리즘 (4)

해시(Hash) 대표 문제 풀이 : 완주하지 못한 선수 자료구조와 알고리즘의 선택 만약 이름 대신 번호가 주어졌다면? -> 선형 배열 번호 말고 다른 것 (예: 문자열)로 접근할 수 있는 좋은 자료구조는 없나요? 해시(Hash)
5.자료구조/알고리즘 (5)
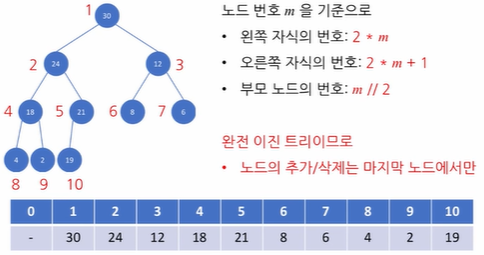
힙 (Heap) 대표 문제 풀이: 더 맵게 알고리즘의 복잡도 최악의 경우 : 수가 하나 남을 때까지 섞어야 하는 경우 (n-1회) 각 단계(섞는 일)에서 요구되는 계산량 : 정렬된 리스트에 순서 맞추어 원소 삽입, O(n) 전체 문제 풀이의 복잡도: O(n^2), 지
6.파이썬으로 웹 다루기 (1)
파이썬으로 웹 데이터를 크롤하고 분석하기 (1) HTML/CSS/JavaScript >HTML (Hypertext Markup Language) : 웹 브라우저가 이해할 수 있는 언어 CSS (Cascading Style Sheet) : 문서를 예쁘게 꾸미는 언어 J
7.파이썬으로 웹 다루기 (2)
파이썬으로 웹 데이터를 크롤하고 분석하기 (2) Web Scrapping 기초 - 인터넷 사용자간의 약속, HTTP 인터넷과 웹
8.파이썬으로 웹 다루기 (3)
원하는 요소만을 가져오도록 HTML코드를 분석해주는 HTML Parser를 사용할 수 있다.그 중 가장 유명한 것이 BeautifulSoup4입니다.tagname : 태그의 이름id : 하나의 고유 태그를 가리키는 레벨class : 여러 태그를 묶는 라벨과도한 요청을
9.파이썬으로 웹 다루기 (4)
브라우저 자동화하기, Selenium selenium은 Python을 이용해서 웹 브라우저를 조작할 수 있는 자동화 프레임워크 Web Driver WebDriver는 웹 브라우저를 제어할 수 있는 자동화 프레임워크 Selenium 시작하기 Driver에서 특정요소
10.파이썬으로 웹 다루기 (5)
시각화 라이브러리, Seaborn
11.파이썬 장고 프레임워크를 사용해서 API 서버 만들기 (1)
CRUD는 대부분의 컴퓨터 소프트웨어가 가지는 기본적인 데이터 처리 기능인 Create(생성), Read(읽기), Update(갱신), Delete(삭제)를 묶어서 일컫는 말이다.
12.파이썬 장고 프레임워크를 사용해서 API 서버 만들기 (2)
get은 찾을 수 없으면 500 에러가 발생함 -> 404로 바꿔야함브라우저의 오류를 대비해야한다 -> 브라우저에서 올라가는 데이터가 삭제되거나 바뀔수 있기 때문A서버와 B서버에서 동시에 명령을 주었을 경우 하나만 실행될 수 있음, 이를 방어302 Redirectmod
13.파이썬 장고 프레임워크를 사용해서 API 서버 만들기 (3)
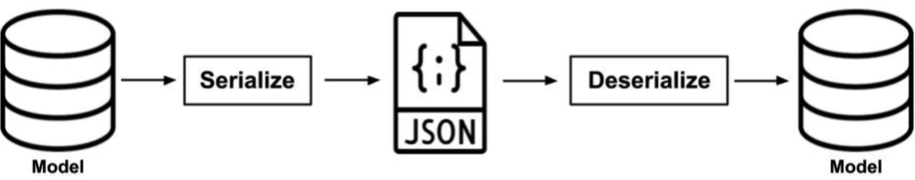
모델 인스턴스나 QuerySet과 같은 데이터를 Jason 형식의 파일로 변환하는 작업Deserialize : Jason 형식의 데이터를 정의된 포맷에 맞추어 다시 모델 인스턴스로 변환하는 작업정보를 서버에서 획득할 때 사용HTTP는 요청 메서드를 정의하여, 주어진 리
14.파이썬 장고 프레임워크를 사용해서 API 서버 만들기 (4)
RESTful API 테스트를 위한 플랫폼으로, 다양한 HTTP 요청을 보내고 응답 결과를 쉽게 확인할 수 있도록 도와줍니다. 또한, API 요청과 응답 결과를 저장하고 공유할 수 있는 기능도 제공합니다.여러가지 요청을 저장해 놓았다가 쉽게 사용할 수 있어서 서버개발에
15.파이썬 장고 프레임워크를 사용해서 API 서버 만들기 (5)
자동화된 테스트
16.데이터 웨어하우스와 SQL과 데이터분석 (1)
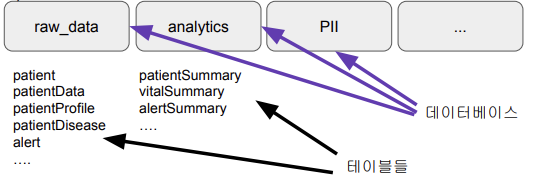
파이썬, 자바/스칼라SQL, 데이터베이스ETL/ELT (Airflow, DBT)Spark, HadoopSQL, 비즈니스 도메인에 대한 지식통계 (AB 테스트 분석)머신러닝SQL, 파이썬통계\-> 데이터 직군에서 일을 하는 한 SQL은 필수배움에는 시간과 노력이 걸림 (
17.데이터 웨어하우스와 SQL과 데이터분석 (2)
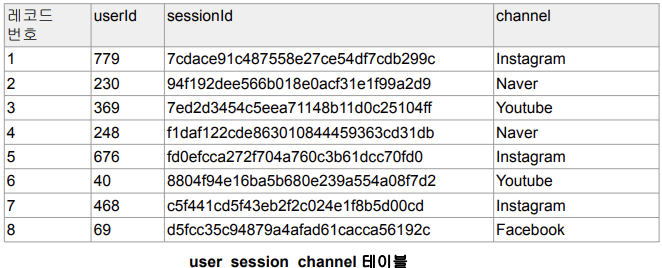
사용자 ID : 보통 웹서비스에서는 등록된 사용자마다 부여하는 유일한 ID세션 ID : 세션마다 부여되는 ID세션: 사용자의 방문을 논리적인 단위로 나눈 것 \- 사용자가 외부 링크(보통 광고)를 타고 오거나 직접 방문해서 올 경우 세션을 생성 \- 사용자가 방문
18.데이터 웨어하우스와 SQL과 데이터분석 (3)
GROUP BY & Aggregate 함수 테이블의 레코드를 그룹핑하여 그룹별로 다양한 정보를 계산 이는 두 단계로 이뤄짐 먼저 그룹핑을 할 필드를 결정 (하나 이상의 필드가 될 수 있음) GROUP BY로 지정 (필드 이름을 사용하거나 필드 일련번호를 사용) 다음
19.데이터 웨어하우스와 SQL과 데이터분석 (4)
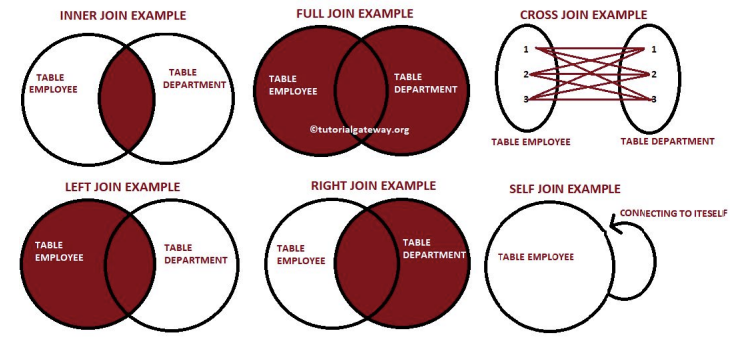
SQL 조인은 두 개 혹은 그 이상의 테이블들을 공통 필드를 가지고 머지하는데사용된다. 이는 스타 스키마로 구성된 테이블들로 분산되어 있던 정보를 통합하는데사용된다.왼쪽 테이블을 LEFT라고 하고 오른쪽 테이블을 RIGHT이라고 하자. JOIN의 결과는 방식에 상관없이
20.데이터 웨어하우스와 SQL과 데이터분석 (5)
user_session_channel과 session_transaction과 session_timestamp 테이블을 사용Gross revenue: Refund 포함한 매출고객들이 0 (의향 없음) 에서 10 (의향 아주 높음) \- detractor (비추천자) :
21. AWS 클라우드 실습 (1)
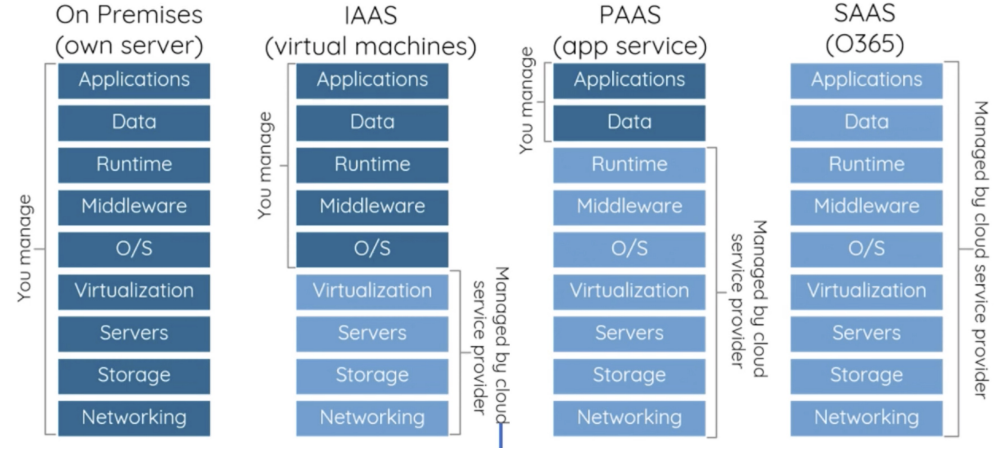
전 세계적으로 분포한 데이터 센터에서 200개가 넘는 완벽한 기능의 서비스를 제공하는, 세계적으로 가장 포괄적이며, 널리 채택되고 있는 클라우드 플랫폼.빠르게 성장하는 스타트업, 가장 큰 규모의 엔터프라이즈, 주요 정부 기관을 포함하여 수백만명의 고객이 AWS를 사용하
22.AWS 클라우드 실습 (2)
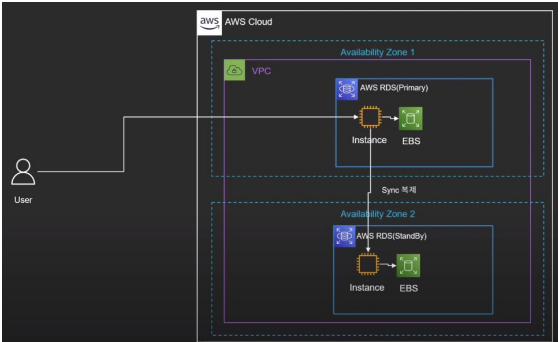
DB 인스턴스는 클라우드에서 실행하는 격리된 데이터베이스 환경DB 인스턴스에는 여러 사용자가 만든 데이터베이스가 포함될 수 있으며, 독립 실행형 데이터베이스 인스턴스에 액세스할 때 사용하는 도구 및 애플리케이션을 사용해 액세스할 수 있다. AWS 명령줄 도구, Amaz
23.AWS 클라우드 실습 (3)
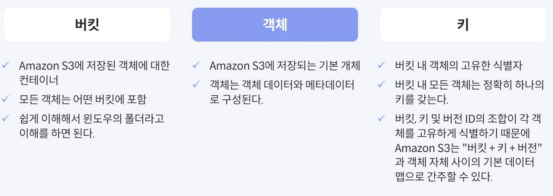
IAM
24. 다양한 데이터 웨어하우스 옵션
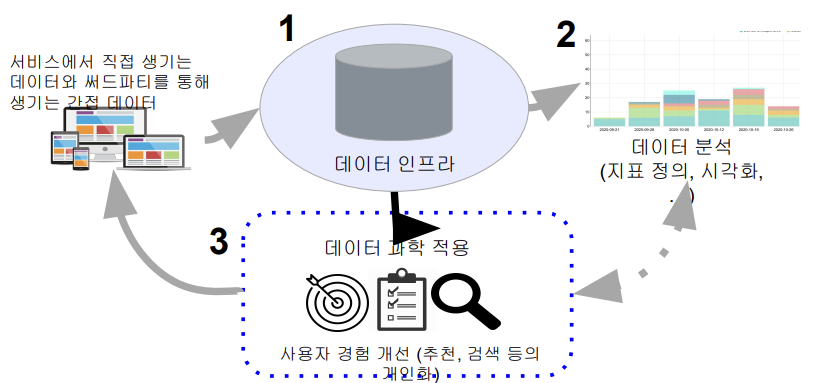
신뢰할 수 있는 데이터를 바탕으로 부가 가치 생성 \- Data is the new oil? (데이터가 새로운 석유다) \- 데이터의 중요성을 강조하니 데이터 팀도 회사에서 인정을 받는다? (매출에 기여를 해야 인정을 받음) 고품질 데이터를 기반으로 의사 결정권자
25.Redshift 소개
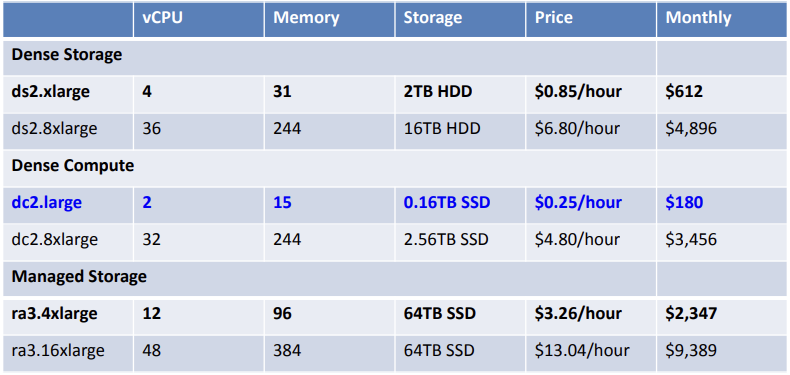
AWS에서 지원하는 데이터 웨어하우스 서비스2 PB의 데이타까지 처리 가능 \- 최소 160GB로 시작해서 점진적으로 용량 증감 가능Still OLAP \- 응답속도가 빠르지 않기 때문에 프로덕션 데이터베이스로 사용불가컬럼 기반 스토리지 \- 레코드 별로 저장하는
26.Redshift 고급 기능
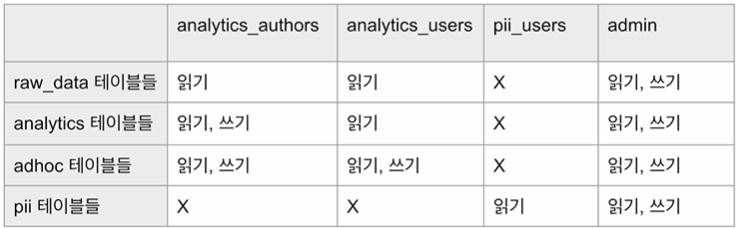
일반적으로 사용자별 테이블별 권한 설정은 하지 않음 \- 너무 복잡하고 실수의 가능성이 높음역할 (Role) 혹은 그룹(Group) 별로 스키마별 접근 권한을 주는 것이 일반적 \- RBAC(Role Based Access Control)가 새로운 트렌드: 그룹 보
27.Snowflake 운영과 관리
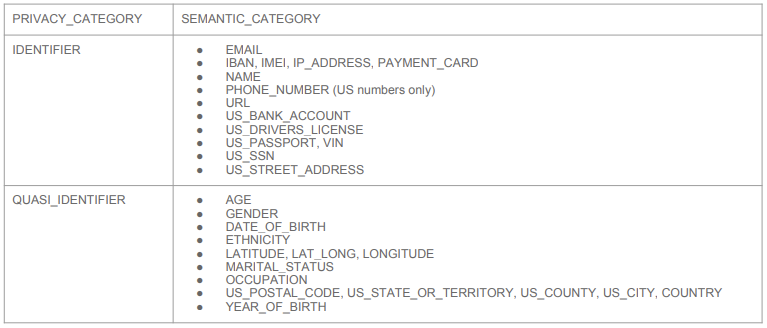
Snowflake 특징 소개 Snowflake 소개 2014년에 클라우드 기반 데이터웨어하우스로 시작됨 (2020년 상장) 지금은 데이터 클라우드라고 부를 수 있을 정도로 발전 글로벌 클라우드위에서 모두 동작 (AWS, GCP, Azure) - 멀티클라우드 데이터
28.데이터 파이프라인, Airflow
데이터 파이프라인 소개 데이터 파이프라인 = ETL = DAG 데이터 웨어하우스의 구성 예 데이터 파이프라인이란? ETL: Extract, Transform and Load Data Pipeline, ETL, Data Workflow, DAG ETL (Extrac
29.Airflow DAG 작성
airflow.cfg 1. DAGs 폴더는 어디에 지정되는가? a. 기본적으로는 Airflow가 설치된 디렉토리 밑의 dags 폴더가 되며 dags_folder 키에 저장됨 2. DAGs 폴더에 새로운 Dag를 만들면 언제 실제로 Airflow 시스템에서 이를 알게되
30.Airflow 고급
2024-06-04 Docker 기반 Airflow 설정 docker-compose.yaml 수정 PIPADDITIONAL_REQUIREMENTS 수정 data 폴더를 호스트 폴더에서 만들고 볼륨으로 공유: 임시 데이터를 저장할 폴더 이를 docker volume으로
31.Airflow의 기타 기능
2024-06-05 Dag를 실행하는 방법 주기적 실행: schedule로 지정 다른 Dag에 의해 트리거 Explicit Trigger: Dag A가 분명하게 Dag B를 트리거 (TriggerDagRunOperator) Reactive Trigger:
32.Airflow 로그 파일 삭제하기
프로덕션 사용을 위한 Airflow 환경 설정 airflow.cfg is in /var/lib/airflow/airflow.cfg Airflow Database upgrade (Airflow 설치때 설명) SequentialExecutor 사용 (Airflow 설치때
33.DBT

(2024-06-09) ETL을 하는 이유는 결국 ELT를 하기 위함이며 이 때 데이터 품질 검증이 중요해짐 데이터 품질의 중요성 증대 입출력 체크 더 다양한 품질 검사 리니지 체크 데이터 히스토리 파악 데이터 품질 유지 -> 비용/노력 감소와 생산성 증대의 지름
34.데이터 카탈로그
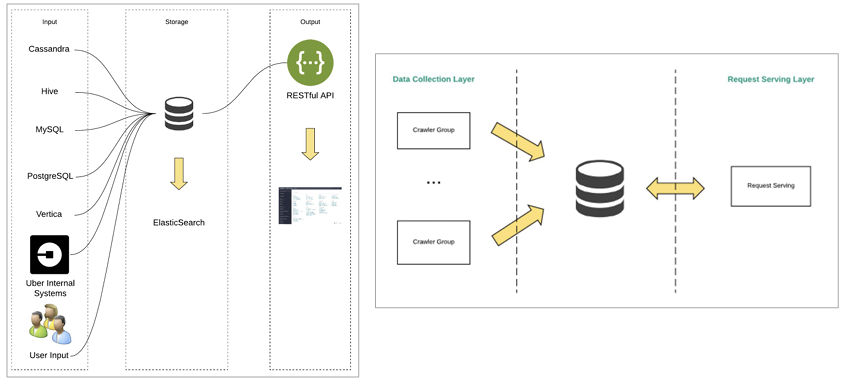
데이터 자산 메타 정보 중앙 저장소데이터 거버넌스의 첫 걸음많은 회사에서 데이터 카탈로그를 데이터 거버넌스 툴로 사용하거나 데이터 카탈로그 위에 커스텀 기능을 구현데이터 카탈로그의 중요한 기능(반)자동화된 메타 데이터 수집! 데이터 보안! 보통 메타 데이터만 읽어옴테이
35.빅데이터 처리와 Spark
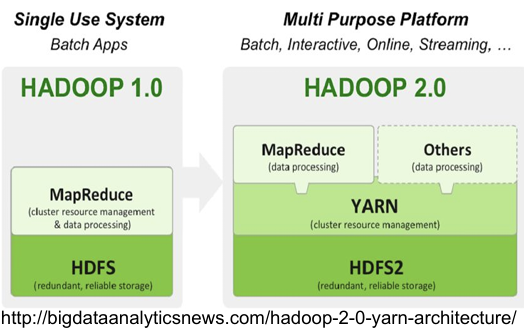
빅데이터 정의 “서버 한대로 처리할 수 없는 규모의 데이터” 2012년 4월 아마존 클라우드 컨퍼런스에서 아마존의 data scientist인 존 라우저(John Rauser)가 내린 정의 분산 환경이 필요하느냐에 포커스 “기존의 소프트웨어로는 처리할 수 없는 규모의
36.Spark 프로그래밍: SQL
SQL은 빅데이터 세상에서도 중요! 데이터 분야에서 일하고자 하면 반드시 익혀야할 기본 기술 구조화된 데이터를 다루는한 SQL은 데이터 규모와 상관없이 쓰임 모든 대용량 데이터 웨어하우스는 SQL 기반 Redshift, Snowflake, BigQuery