Snowflake 특징 소개
Snowflake 소개
- 2014년에 클라우드 기반 데이터웨어하우스로 시작됨 (2020년 상장)
- 지금은 데이터 클라우드라고 부를 수 있을 정도로 발전
- 글로벌 클라우드위에서 모두 동작 (AWS, GCP, Azure) - 멀티클라우드
- 데이터 판매를 통한 매출을 가능하게 해주는 Data Sharing/Marketplace 제공
- ETL과 다양한 데이터 통합 기능 제공
Snowflake 특징
- 스토리지와 컴퓨팅 인프라가 별도로 설정되는 가변 비용 모델
- Redshift 고정비용처럼 노드 수를 조정할 필요가 없고 distkey등의 최적화 불필요 - SQL 기반으로 빅데이터 저장, 처리, 분석을 가능하게 해줌
- 비구조화된 데이터 처리와 머신러닝 기능도 제공 - CSV, JSON, Avro, Parquet 등과 같은 다양한 데이터 포맷을 지원
- S3, GC 클라우드 스토리지, Azure Blog Storage도 지원 - 배치 데이터 중심이지만 실시간 데이터 처리 지원
- Time Travel: 과거 데이터 쿼리 기능으로 트렌드를 분석하기 쉽게 해줌
- 웹 콘솔 이외에도 Python API를 통한 관리/제어 가능
- ODBC/JDBC 연결도 지원 - 자체 스토리지 이외에도 클라우드 스토리지를 외부 테이블로 사용 가능
- 대표 고객: Siemens, Flexport, Iterable, Affirm, PepsiCo, …
- 멀티클라우드와 다른 지역에 있는 데이터 공유(Cross-Region Replication) 기능 지원
- Snowflake의 계정 구성도: Organization -> 1+ Account -> 1+ Databases
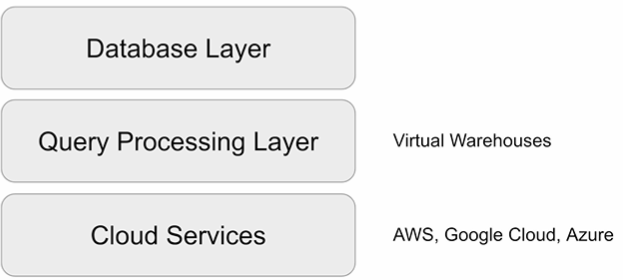
- Organizations:
- 한 고객이 사용하는 모든 Snowflake 자원들을 통합하는 최상위 레벨 컨테이너
- 하나 혹은 그 이상의 Account들로 구성되며 이 모든 Account들의 접근권한, 사용트래킹, 비용들을 관리하는데 사용됨 - Accounts:
- 하나의 Account는 자체 사용자, 데이터, 접근권한을 독립적으로 가짐
- 한 Account는 하나 혹은 그 이상의 Database로 구성됨 - Databases:
- 하나의 Database는 한 Account에 속한 데이터를 다루는 논리적인 컨테이너
- 한 Database는 다수의 스키마와 거기에 속한 테이블과 뷰등으로 구성되어 있음
- 하나의 Database는 PB단위까지 스케일 가능하고 독립적인 컴퓨팅 리소스를 갖게 됨
컴퓨팅 리소스를 Warehouses라고 부름. Warehouses와 Databases는 일대일 관계가 아님 - Data Marketplace
- 데이터 메시 용어가 생기기 전부터 “데이터 마켓플레이스"라는 서비스 제공 - Data Sharing (“Share, Don’t Move”)
- “Data Sharing”: 데이터 셋을 사내 혹은 파트너에게 스토리지 레벨에서 공유하는 방식
Snowflake의 기본 데이터 타입
Redshift보다 강력한 타입들이 많다 googlecloud의 Bigquery와 비슷
- Numeric: TINYINT, SMALLINT, INTEGER, BIGINT, NUMBER, NUMERIC, DECIMAL, FLOAT, DOUBLE, REAL.
- Boolean: BOOLEAN.
- String: CHAR, VARCHAR, TEXT, BINARY, VARBINARY.
- Date and Time: DATE, TIME, TIMESTAMP, TIMESTAMP_LTZ, TIMESTAMP_TZ.
- Semi-structured data: VARIANT (JSON, OBJECT.
- Binary: BINARY, VARBINARY
- Geospatial: GEOGRAPHY, GEOMETRY.
- Array: ARRAY
- Object: OBJECT
Snowflake Warehouse에서 Credit이란?
- 쿼리 실행과 데이터 로드와 기타 작업 수행에 소비되는 계산 리소스를 측정하는 단위
- 1 credit는 상황에 따라 다르지만 대략 $2-$4의 비용을 발생시킴
Snowflake 비용 구조
- 크게 아래 3 가지 컴포넌트로 구성됨
- 컴퓨팅 비용: 앞서 크레딧으로 결정됨
- 스토리지 비용: TB 당으로 계산
- 네트워크 비용: 지역간 데이터 전송 혹은 다른 클라우드간 데이터 전송시 TB 당 계산
Snowflake Schema
데이터베이스 밑에 3개의 스키마를 생성
- raw_data
- analytics
- adhoc
Snowflake 사용자 권한 설정
컬럼 레벨 보안 (Column Level Security)
- 테이블내의 특정 컬럼(들)을 특정 사용자나 특정 역할(Role)에만 접근 가능하게 하는 것
- 보통 개인정보 등에 해당하는 컬럼을 권한이 없는 사용자들에게 감추는 목적으로 사용됨
- 사실 가장 좋은 방법은 아예 그런 컬럼을 별도 테이블로 구성하는 것임
- 더 좋은 방법은 보안이 필요한 정보를 아예 데이터 시스템으로 로딩하지 않는 것임
레코드 레벨 보안 (Row Level Security)
- 테이블내의 특정 레코드(들)을 특정 사용자나 특정 역할에만 접근 가능하게 하는 것
- 특정 사용자/그룹의 특정 테이블 대상 SELECT, UPDATE, DELETE 작업에 추가 조건을 다는 형태로 동작
- 일반적으로 더 좋은 방법은 아예 별도의 테이블로 관리하는 것임
- 다시 한번 더 좋은 방법은 보안이 필요한 정보를 아예 데이터 시스템으로 로딩하지 않는 것임
Data Governance 관련 기능
- Object Tagging
- Data Classification
- Tag based Masking Policies
- Access History
- Object Dependencies
잠깐! Data Governance란 무엇인가?
- 필요한 데이터가 적재적소에 올바르게 사용됨을 보장하기 위한 데이터 관리 프로세스
- 품질 보장과 데이터 관련 법규 준수를 주 목적으로 함 - 다음을 이룩하기 위함이 기본 목적
- 데이터 기반 결정에서 일관성
예: KPI등의 지표 정의와 계산에 있어 일관성
- 데이터를 이용한 가치 만들기
Citizen data scientist가 더 효율적으로 일할 수 있게 도와주기
Data silos를 없애기
- 데이터 관련 법규 준수
개인 정보 보호 -> 적절한 권한 설정과 보안 프로세스 필수!
Data Governance 관련 기능 - Object Tagging
- Enterprise 레벨에서만 가능한 기능. CREATE TAG로 생성
- 문자열을 Snowflake object에 지정 가능 (계정, 스키마, 테이블, 컬럼, 뷰 등등)
- 시스템 태그도 있음 (뒤의 Data Classification에서 다시 이야기) - 이렇게 지정된 tag는 구조를 따라 계승됨
Data Governance 관련 기능 - Data Classification
- Enterprise 레벨에서만 가능한 기능
- 앞서 Object Tagging은 개인 정보 관리가 주요 용도 중의 하나
- 하지만 이를 매뉴얼하게 관리하기는 쉽지 않음. 그래서 나온 기능이 Data Classification - 3가지 스텝으로 구성됨
- Analyze: 테이블에 적용하면 개인정보나 민감정보가 있는 컬럼들을 분류해냄
- Review: 이를 사람(보통 데이터 엔지니어)이 보고 최종 리뷰 (결과 수정도 가능)
- Apply: 이 최종 결과를 System Tag로 적용
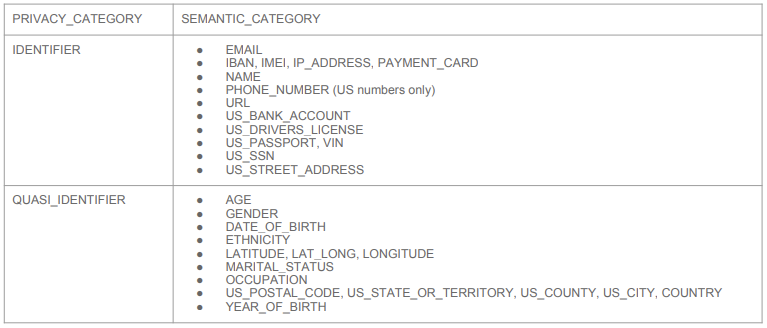
SNOWFLAKE.CORE.PRIVACY_CATEGORY (상위레벨)
-> IDENTIFIER, QUASI_IDENTIFIER, SENSITIVE
SNOWFLAKE.CORE.SEMANTIC_CATEGORY (하위레벨 - 더 세부정보)
Data Governance 관련 기능 - 식별자와 준식별자
- 개인을 바로 지칭하는 식별자 (Identifier)
- 몇 개의 조합으로 지칭가능한 준식별자 (Quasi Identifier)
Data Governance 관련 기능 - Tag based Masking Policies
- Enterprise 레벨에서만 가능한 기능
- 먼저 Tag에 액세스 권한을 지정 - 해당 Tag가 지정된 Snowflake Object의 액세스 권한을 그에 맞춰 제한하는 방식
- 보통 앞서 본 개인정보와 같은 Tag에 부여하는 것이 가장 많이 사용되는 패턴 - Tag Lineage가 여기에도 적용됨.
Data Governance 관련 기능 - Access History
- Enterprise 레벨에서만 가능한 기능
- 목적은 데이터 액세스에 대한 감사 추적을 제공하여 보안과 규정 준수
- 잠재적인 보안 위반이나 무단 액세스 시도의 조사를 가능하게 해줌
- 캡처된 정보에는 사용자 신원, IP 주소, 타임스탬프 및 기타 관련 세부 정보 포함 - 'Access History'를 통해 다음 활동의 추적이 가능
- 데이터베이스 로그인, 실행된 쿼리, 테이블 및 뷰 액세스, 데이터 조작 작업 - 이 기능은 사실 다른 모든 클라우드 데이터 웨어하우스에서도 제공됨
Data Governance 관련 기능 - Object Dependencies
- 데이터 거버넌스와 시스템 무결성 유지를 목적으로 함
- 테이블이나 뷰를 수정하는 경우 이로 인한 영향을 자동으로 식별
- 예를 들어 테이블 이름이나 컬럼 이름을 변경하거나 삭제하는 경우
- 즉 데이터 리니지 분석을 자동으로 수행해줌 - 계승 관계 분석을 통한 더 세밀한 보안 및 액세스 제어
- 어떤 테이블의 개인정보 컬럼이 새로운 테이블을 만들때 사용된다면?
원본 테이블에서의 권한 설정이 그대로 전파됨 (Tag 포함)

새싹 개발자