데이터 관련 3개의 직군
데이터 엔지니어
- 파이썬, 자바/스칼라
- SQL, 데이터베이스
- ETL/ELT (Airflow, DBT)
- Spark, Hadoop
데이터 분석가
- SQL, 비즈니스 도메인에 대한 지식
- 통계 (AB 테스트 분석)
데이터 과학자
- 머신러닝
- SQL, 파이썬
- 통계
-> 데이터 직군에서 일을 하는 한 SQL은 필수
배움이란?
배움에는 시간과 노력이 걸림 (하루에 8시간 3개월은 해보고 포기해야한다)
1. 가장 중요한 것은 버티는 힘 - 이걸 즐겨야함
2. 내가 뭘 모르는지 생각해봐야함 - 내가 어디서 막혔는지 구체적으로 질문할 수 있나?
3. 잘 하는 사람 보고 기죽지 않기
관계형 데이터베이스
구조화된 데이터를 저장하고 질의할 수 있도록 해주는 스토리지
- 엑셀 스프레드시트 형태의 테이블로 데이터를 정의하고 저장
- 테이블에는 컬럼과 레코드가 존재
관계형 데이터베이스를 조작하는 프로그래밍 언어가 SQL
- 테이블 정의를 위한 DDL (Data Definition Language)
- 테이블 데이터 조작/질의를 위한 DML (Data Manipulation Language)
대표적 관계형 데이터베이스
프로덕션 데이터베이스 : MySQL, PostgreSQL, Oracle, ...
- OLTP (Online Transaction Processing)
- 빠른 속도에 집중. 서비스에 필요한 정보 저장
데이터 웨어하우스 : Redshift, Snowflake, BigQuery, Hive,...
- OLAP (OnLine Analytical Processing)
- 처리 데이터 크기에 집중. 데이터 분석 혹은 모델 빌딩등을 위한 데이터 저장
- 보통 프로덕션 데이터베이스를 복사해서 데이터 웨어하우스에 저장
-> 취업할때 무슨 데이터 웨어하우스 인지 보면 알 수 있음
관계형 데이터베이스의 구조
관계형 데이터베이스는 2단계로 구성됨
- 가장 밑단에는 테이블들이 존재 (테이블은 엑셀의 시트에 해당)
- 테이블들은 데이터베이스(혹은 스키마)라는 폴더 밑으로 구성 (엑셀에서는 파일)
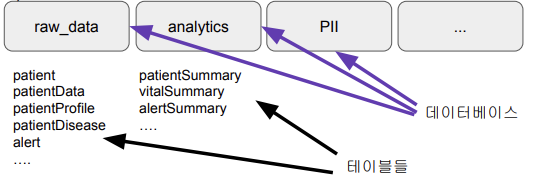
테이블의 구조 (테이블 스키마라고 부르기도 함)
- 테이블은 레코드들로 구성 (행)
- 레코드는 하나 이상의 필드(칼럼)로 구성 (열)
- 필드(컬럼)는 이름과 타입과 속성(primary key)로 구성됨
SQL 소개
SQL : Structured Query Language
- 관계형 데이터베이스에 있는 데이터(테이블)를 질의하거나 조작해주는 언어
SQL은 1970년대 초반에 IBM이 개발한 구조화된 데이터 질의 언어
두 종류의 언어로 구성됨
- DDL (Data Definition Language) : 테이블의 구조를 정의하는 언어
- DML (Data Manipulation Language) : 테이블에서 원하는 레코드들을 읽어오는 질의 언어, 테이블에 레코드를 추가/삭제/갱신해주는데 사용하는 언어
SQL은 빅데이터 세상에서도 중요
구조화된 데이터를 다루는한 SQL은 데이터 규모와 상관없이 쓰임
모든 대용량 데이터 웨어하우스는 SQL 기반
- Redshift, Snowflake, BigQuery, Hive
Spark나 Hadoop도 예외는 아님
- SparkSQL과 Hive라는 SQL언어가 지원됨
데이터 분야에서 일하고자 하면 반드시 익혀야할 기본 기술
- 데이터 엔지니어, 데이터분석가, 데이터 과학자 모두 알아야함
SQL의 단점
구조화된 데이터를 다루는데 최적화가 되어있음
- 정규표현식을 통해 비구조화된 데이터를 어느 정도 다루는 것은 가능하나 제약이 심함
- 많은 관계형 데이터베이스들이 플랫한 구조만 지원함(no nested like JSON)
- 구글 빅쿼리는 nested structure를 지원함 - 비구조화된 데이터를 다루는데 Spark, Hadoop과 같은 분산 컴퓨팅 환경이 필요해짐
- 즉 SQL만으로는 비구조화 데이터를 처리하지 못함 - 관계형 데이터베이스마다 SQL 문법이 조금씩 상이
Star schema
- Production DB용 관계형 데이터베이스에서는 보통 스타 스키마를 사용해 데이터를 저장
- 데이터를 논리적 단위로 나눠 저장하고 필요시 조인. 스토리지의 낭비가 덜하고 업데이트가 쉬움
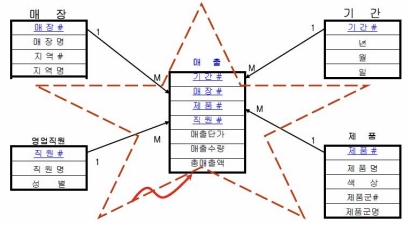
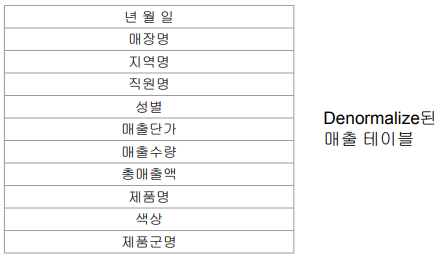
Denormalize schema
데이터 웨어하우스에서 사용하는 방식
- 단위 테이블로 나눠 저장하지 않음으로 별도의 조인이 필요 없는 형태를 말함
이는 스토리지를 더 사용하지만 조인이 필요 없기에 빠른 계산이 가능
데이터 웨어하우스: 회사에 필요한 모든 데이터를 저장
여전히 SQL 기반의 관계형 데이터베이스
- 프로덕션 데이터베이스와는 별도이어야 함
- OLAP (OnLine Analytical Processing) vs. OLTP (OnLine Transaction Processing) - AWS의 Redshift, Google Cloud의 Big Query, Snowflake 등이 대표적
- 고정비용 옵션 vs. 가변비용 옵션
데이터 웨어하우스는 고객이 아닌 내부 직원을 위한 데이터베이스
- 처리속도가 아닌 처리 데이터의 크기가 더 중요해짐
ETL 혹은 데이터 파이프라인
- 외부에 존재하는 데이터를 읽어다가 데이터 웨어하우스로 저장해주는 코드들이 필요해지는데 이를 ETL 혹은 데이터 파이프라인이라고 부름
데이터 인프라란?
데이터 엔지니어가 관리함
- 여기서 한 단계 더 발전하면 Spark과 같은 대용량 분산처리 시스템이 일부로 추가됨

데이터 순환 구조
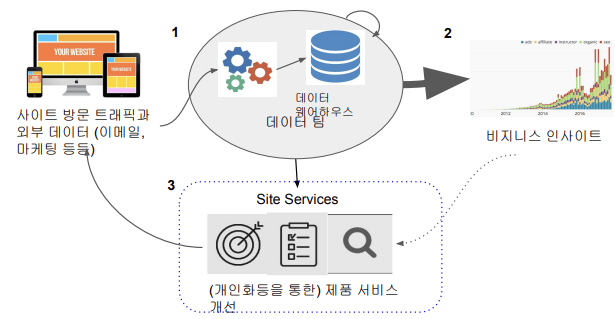
클라우드의 정의
컴퓨팅 자원(하드웨어, 소프트웨어 등등)을 네트웍을 통해 서비스 형태로 사용하는 것.
키워드 :
- "No Provisioning"
- "Pay As You Go"
자원(예를 들면 서버)을 필요한만큼 (거의) 실시간으로 할당하여 사용한만큼 지불
- 탄력적으로 필요한만큼의 자원을 유지하는 것이 중요
클라우드 컴퓨팅이 없었다면?
- 서버/네트워크/스토리지 구매와 설정등을 직접 수행해야 함
- 데이터센터 공간을 직접 확보 (Co-location)
- 확장이 필요한 경우 공간을 먼저 더 확보해야함 - 그 공간에 서버를 구매하여 설치하고 네트워크 설정
- 보통 설버를 구매해서 설치하는데 적어도 두세달은 걸림 - 또한 Peak time을 기준으로 Capacity planning을 해야함
- 놀고 있는 자원들이 높게 되는 현상 발생 - 직접 운영비용 vs. 클라우드 비용
- 기회비용
클라우드 컴퓨팅의 장점
초기투자 비용이 크게 줄어듬 - CAPEX (Capital Expenditure) vs. OPEX (Operating Expense)
리소스 준비를 위한 대기시간 대폭 감소 - Shorter Time to Market
노는 리소스 제거로 비용 감소
글로벌 확장 용이
소프트웨어 개발 기간 단축 - Managed Service (SaaS) 이용
AWS 소개
가장 큰 클라우드 컴퓨팅 서비스 업체.
2002년 아마존의 상품데이터를 API로 제공하면서 시작
- 현재 100여개의 서비스를 전세계 15개 지역에서 제공
- 대부분의 서비스들이 오픈소스 프로젝트들을 기반으로 함
- 최근 들어 ML/AI 관련 서비스들도 내놓기 시작
사용고객
- Netflix, Zynga등의 상장업체들도 사용.
- 많은 국내 업체들도 사용 시작 (서울 리전)
다양한 종류의 소프트웨어/플랫폼 서비스를 제공.
- AWS의 서비스만으로 쉽게 온라인서비스 생성.
Redshift : Scalable SQL 엔진
2 PB까지 지원
Still OLAP
- 응답속도가 빠르지 않기 떄문에 프로덕션 데이터베이스로 사용불가
Columnar storage
- 컬럼별 압축이 가능
- 컬럼을 추가하거나 삭제하는 것이 아주 빠름
벌크 업데이트 지원
- 레코드가 들어있는 파일을 S3로 복사 후 COPY 커맨드로 Redshift로 일괄 복사
고정 용량 비용 SQL 엔진
- vs. Snowflake vs. BigQuery
다른 데이터 웨어하우스 처럼 primary key uniqueness를 보장하지 않음
- 프로덕션 데이터베이스들은 보장함
Red shift는 Postgresql 8.x와 SQL이 호환됨
- 하지만 Postgresql 8.x의 모든 기능을 지원하지는 않음
- 예를 들어 text타입이 존재하지 않음 - Postgresql 8.x를 지원하는 툴이나 라이브러리로 엑세스 가능
- JDBC/ODBC - 다시 한번 SQL이 메인 언어라는 점 명심
- 그러기에 테이블 디자인이 아주 중요
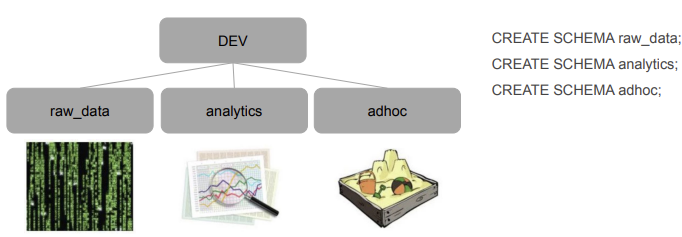
Redshift Schema (폴더) 구성

새싹 개발자