JOIN 이란?
SQL 조인은 두 개 혹은 그 이상의 테이블들을 공통 필드를 가지고 머지하는데
사용된다. 이는 스타 스키마로 구성된 테이블들로 분산되어 있던 정보를 통합하는데
사용된다.
왼쪽 테이블을 LEFT라고 하고 오른쪽 테이블을 RIGHT이라고 하자. JOIN의 결과는 방식에 상관없이 양쪽의 필드를 모두 가진 새로운 테이블을 만들어내게 된다.
조인의 방식에 따라 다음 두 가지가 달라진다:
1. 어떤 레코드들이 선택되는지?
2. 어떤 필드들이 채워지는지?
다양한 종류의 조인
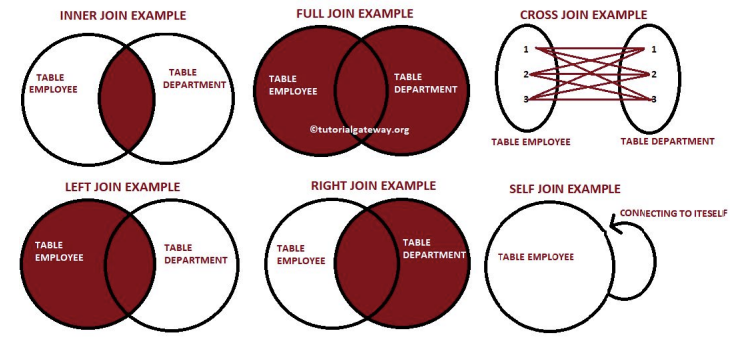
Source: https://theartofpostgresql.com/blog/2019-09-sql-joins/
JOIN 문법
SELECT A.*, B.*
FROM raw_data.table1 A
____ JOIN raw_data.table2 B ON A.key1 = B.key1 and A.key2 = B.key2
--INNER, FULL, LEFT, RIGHT, CROSS (대부분 INNER와 LEFT 사용)
WHERE A.ts >= '2019-01-01';
JOIN시 고려해야할 점
먼저 중복 레코드가 없고 Primary Key의 uniqueness가 보장됨을 체크
- 아주 중요함!!!
조인하는 테이블들간의 관계를 명확하게 정의
One to one
- 완전한 one to one: user_session_channel & session_timestamp
- 한쪽이 부분집합이 되는 one to one: user_session_channel & session_transaction
One to many? (order vs order_items)
- 이 경우 중복이 더 큰 문제됨 -> 증폭!!
Many to one?
- 방향만 바꾸면 One to many로 보는 것과 사실상 동일.
Many to many?
- 이런 경우는 많지 않으며 이는 one to one이나 one to many로 바꾸는 것이 가능하다면 변환하여 조인하는 것이 덜 위험
어느 테이블을 베이스로 잡을지 (From에 사용할지) 결정해야함
예제 테이블
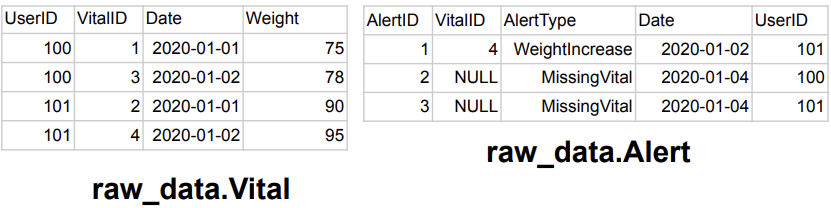
INNER JOIN
- 양쪽 테이블에서 매치가 되는 레코드들만 리턴함
- 양쪽 테이블의 필드가 모두 채워진 상태로 리턴됨
SELECT * FROM raw_data.Vital v
JOIN raw_data.Alert a ON v.vitalID = a.vitalID;
LEFT JOIN
- 왼쪽 테이블(Base)의 모든 레코드들을 리턴함
- 오른쪽 테이블의 필드는 왼쪽 레코드와 매칭되는 경우에만 채워진 상태로
리턴됨
SELECT * FROM raw_data.Vital v
LEFT JOIN raw_data.Alert a ON v.vitalID = a.vitalID;
FULL JOIN
- 왼쪽 테이블과 오른쪽 테이블의 모든 레코드들을 리턴함
- 매칭되는 경우에만 양쪽 테이블들의 모든 필드들이 채워진 상태로 리턴됨
SELECT * FROM raw_data.Vital v
FULL JOIN raw_data.Alert a ON v.vitalID = a.vitalID;
CROSS JOIN
- 왼쪽 테이블과 오른쪽 테이블의 모든 레코드들의 조합을 리턴함
SELECT * FROM raw_data.Vital v CROSS JOIN raw_data.Alert a;SELF JOIN
- 동일한 테이블을 alias를 달리해서 자기 자신과 조인함
SELECT * FROM raw_data.Vital v1
JOIN raw_data.Vital v2 ON v1.vitalID = v2.vitalID;
BOOLEAN 타입 처리
- True or False
- 다음 2개는 동일한 표현
- flag = True
- flag is True - 다음 2개는 동일한 표현인가? (수학적으로는 같지만 SQL에서는 같지 않다)
- flag is True
- flag is not False
SELECT
 COUNT(CASE WHEN flag = True THEN 1 END) true_cnt1,
 COUNT(CASE WHEN flag is True THEN 1 END) true_cnt2,
 COUNT(CASE WHEN flag is not False THEN 1 END) not_false_cnt
FROM raw_data.boolean_test;
NULL 비교
- NULL 비교는 항상 IS 혹은 IS NOT으로 수행
- NULL 비교를 = 혹은 != 혹은 <>으로 수행하면 잘못된 결과가 나옴
SELECT COUNT(1)
FROM raw_data.boolean_test
WHERE flag is NULL;
SELECT COUNT(1)
FROM raw_data.boolean_test
WHERE flag = NULL;
채널별 월 매출액 테이블 만들기 (숙제)
- 먼저 유일한 사용자 수부터 세보자
SELECT LEFT(ts, 7) "month",
 usc.channel,
 COUNT(DISTINCT userid) uniqueUsers
 FROM raw_data.user_session_channel usc
 JOIN raw_data.session_timestamp t ON t.sessionid = usc.sessionid
 GROUP BY 1, 2
 ORDER BY 1, 2;
복잡한 JOIN시 먼저 JOIN 전략부터 수립
raw_data.user_session_channel
raw_data.session_timestamp
raw_data.session_transaction
- 의 3개 테이블 모두 sessionid를 기반으로 조인을 해야함
- user_session_channel과 session_timestamp는 일대일로 조인가능: INNER JOIN
- 하지만 session_transaction의 경우에는 모든 sessionid가 존재하지 않음
- LEFT JOIN (혹은 RIGHT JOIN)
- FROM에 사용하는 테이블은 user_session_channel 혹은 session_timestamp가
되어야함
- 이제 session_transaction 테이블을 추가해보자
SELECT LEFT(ts, 7) "month",
 usc.channel,
 COUNT(DISTINCT userid) uniqueUsers
 FROM raw_data.user_session_channel usc
 JOIN raw_data.session_timestamp t ON t.sessionid = usc.sessionid
 LEFT JOIN raw_data.session_transaction st ON st.sessionid = usc.sessionid
 GROUP BY 1, 2
ORDER BY 1, 2;- 이제 paidUsers를 추가해보자
SELECT LEFT(ts, 7) "month",
 usc.channel,
 COUNT(DISTINCT userid) uniqueUsers,
 COUNT(DISTINCT CASE WHEN amount > 0 THEN usc.userid END) paidUsers,
 FROM raw_data.user_session_channel usc
 JOIN raw_data.session_timestamp t ON t.sessionid = usc.sessionid
 LEFT JOIN raw_data.session_transaction st ON st.sessionid = usc.sessionid
 GROUP BY 1, 2
ORDER BY 1, 2;- 이제 conversionRate을 추가해보자
첫 번째 시도:
- paidUsers/uniqueUsers AS conversionRate
두 번째 시도:
- paidUsers::float/uniqueUsers AS conversionRate
세 번째 시도: (소숫점 둘째까지)
- ROUND(paidUsers*100.0/uniqueUsers, 2) AS conversionRate
네 번째 시도: (NULLIF)
- ROUND(paidUsers*100.0/NULLIF(uniqueUsers, 0), 2) AS conversionRate
NULLIF
paidUsers/uniqueUsers
- 0으로 나누는 경우 divide by 0 에러 발생
- 이를 어떻게 방지할까? NULLIF를 사용하여 0을 NULL로 변경
- paidUsers/NULLIF(uniqueUsers, 0)
- 다시 한번 사칙연산에 NULL이 들어가면 결과도 NULL이 됨을 기억!
SELECT LEFT(ts, 7) "month", -- "year month"
 channel,
 COUNT(DISTINCT usc.userid) uniqueUsers,
 COUNT(DISTINCT CASE WHEN amount > 0 THEN usc.userid END) paidUsers,
 ROUND(paidUsers::float*100/NULLIF(uniqueUsers, 0),2) conversionRate,
 SUM(amount) grossRevenue,
 SUM(CASE WHEN refunded is False THEN amount END) netRevenue
 FROM raw_data.user_session_channel usc
 LEFT JOIN raw_data.session_timestamp t ON t.sessionid = usc.sessionid
 LEFT JOIN raw_data.session_transaction st ON st.sessionid = usc.sessionid
 GROUP BY 1, 2
 ORDER BY 1, 2;
COALESCE
- NULL 값을 다른 값으로 바꿔주는 함수
- 즉 NULL대신에 다른 백업값을 리턴해주는 함수 - COALESCE(exp1, exp2, exp3, …)
- exp1부터 인자를 하나씩 살펴서 NULL이 아닌 값이 나오면 그걸 리턴
- 끝까지 갔는데도 모두 NULL이면 최종적으로 NULL을 리턴
SELECT
 value,
 COALESCE(value, 0) -- value가 NULL이면 0을 리턴
FROM raw_data.count_test;
공백 혹은 예약키워드를 필드 이름으로 사용하려면?
- ""로 둘러싸서 사용
CREATE TABLE keeyong.test (
 group int primary key,
 'mailing address' varchar(32)
);
결과물
DROP TABLE IF EXISTS adhoc.keeyong_monthly_channel_summary;
CREATE TABLE adhoc.keeyong_monthly_channel_summary AS
SELECT LEFT(ts, 7) "month",
 channel,
 COUNT(DISTINCT usc.userid) uniqueUsers,
 COUNT(DISTINCT CASE WHEN amount > 0 THEN usc.userid END) paidUsers,
 ROUND(paidUsers::float*100/NULLIF(uniqueUsers, 0),2) conversionRate,
 SUM(amount) grossRevenue,
 SUM(CASE WHEN refunded is False THEN amount END) netRevenue
 FROM raw_data.user_session_channel usc
 LEFT JOIN raw_data.session_timestamp t ON t.sessionid = usc.sessionid
 LEFT JOIN raw_data.session_transaction st ON st.sessionid = usc.sessionid
 GROUP BY 1, 2;
새싹 개발자