인터넷 사용자간의 약속, HTTP
인터넷과 웹
- 두 컴퓨터를 연결하는 네트워크(Network)의 탄생
- 이 네트워크를 묶어 근거리 지역 네트워크(Local Area Network, LAN) 탄생
- 범지구적으로 연결된 네트워크 Inter Network - 인터넷(Ineternet) 탄생
- 인터넷에서 정보를 교환할 수 있는 환경 - WWW(World Wide Web, 줄여서 Web) 탄생
웹에서 정보를 주고받는 방법
정보를 요청하는 컴퓨틀를 클라이언트(Client), 정보를 제공하는 컴퓨터를 서버(Server)
1. 클라이언트가 서버에게 정보를 요청
2. 요청에 대해 서버가 작업을 수행
3. 수행한 작업의 결과를 클라이언트에게 응답
HTTP의 구조
Hypertext Transfer Protocol
웹 상에서 정보를 주고받기 위한 약속
클라이언트에서 서버로 정보를 요청하는 것을 HTTP 요청(Request) 라고 한다.
요청된 정보에대해 서버가 클라이언트에게 응답하는 것을 HTTP 응답(Response) 라고 한다.
HTTP는 요청/응답에 대한 정보를 담는 Head 와 내용물인 Body 로 나뉜다.
HTTPRequest
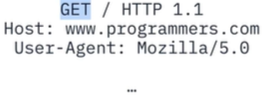
개발자도구를 보면 Head에서 Method, Path 등을 확인할 수 있다.
HTTPResponse
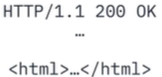
Head에서 content-type, date,...를 확인할 수 있다.
웹페이지와 HTML
웹 속에 있는 문서 하나는 웹 페이지
이런 웹 페이지의 모음은 웹 사이트
웹 브라우저는 HTML 요청을 보내고, HTTP 응답에 담긴 HTML 문서를 우리가 보기 쉬운 형태로 화면을 그려주는 역할을 담당
웹 페이지는 HTML이라는 형식으로 되어있고, 웹 브라우저는 우리가 HTTP 요청을 보내고, 응답받은 HTML코드를 렌더링 해주었습니다.
HTML의 특징
<!DOCTYPE html>을 통해 HTML5임을 명시
가장 바깥에 <html> 태그로 감싸져있다.
HTML 코드는 크게 Head와 Body로 나눌 수 있다.
Head는 문서에 대한 정보 (제목, 언어 등)을 작성한다.
Body는 문서의 내용 (글, 이미지, 동영상 등)을 작성한다.
이렇게 HTML은 여러 태그(Tag)로 감싼 요소(Element)의 집합으로 이루어져있다.
태그로 내용을 묶어 글의 형식을 지정
태그는 그에 맞는 속성(attribute)를 가지기도 한다.
웹 브라우저마다 지원하는 태그와 속성이 다르다.
윤리적으로 웹 스크래핑, 크롤링 진행하기
웹 스크래핑
- 웹 페이지들로부터 우리가 원하는 정보를 추출
- 특정한 목적으로 특정 웹 페이지에서 데이터를 추출하는 것
ex) 날씨 데이터 가져오기, 주식 데이터 가져오기,...
웹 크롤링
- 크롤러(Crawler)를 이용해서 웹 페이지의 정보를 인덱싱
- URL을 타고다니며 반복적으로 데이터를 가져오는 과정 - 데이터 색인
ex) 검색 엔진의 웹 크롤러
올바르게 HTTP 요청하기
웹 스크래핑/크롤링을 통해 어떤 목적을 달성하고자 하는가?
나의 웹 스크래핑/크롤링이 서버에 영향을 미치지는 않는가?
로봇 배제 프로토콜(REP)
1994년, REP(Robot Exclusion Protocol)의 탄생
웹 크롤러들은 이 규칙을 지키면서 크롤링을 진행
robots.txt에 User-agent, Disallow, Allow 등의 키워드를 통해 사용
웹브라우저가 HTML을 다루는 방법
브라우저는 HTML을 파싱해서 DOM을 생성한다.
파이썬으로 HTML을 분석하는 HTML Parser의 필요
DOM(Document Object Model)
브라우저의 랜더링 엔진은 웹 문서를 로드한 후, 파싱을 진행
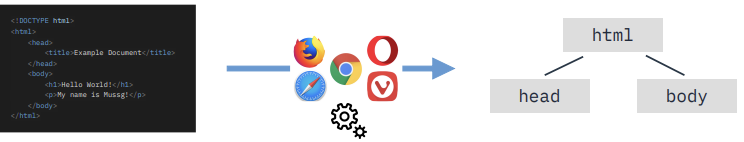
DOM의 목적
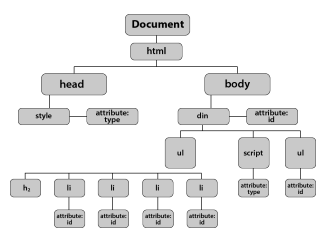
각 노드를 객체로 생각하면 문서를 더욱 편리하게 관리할 수 있다.
DOM을 다루는 예시
DOM Tree를 순회해서 특정 원소를 추가할 수 있다.
DOM Tree를 순회해서 특정 원소를 찾을 수 있다.
