Redis vs Local Cache: t3.micro 환경에서 ‘외부 캐시’는 사치일까?
데이터 기반의 기술 부채 청산과 최적의 캐시 전략 수립
연재글 안내
이 글은 이전 포스팅
「t3.micro 서버의 한계 측정: 7 TPS는 버티고 10 TPS는 왜 무너졌나」,
그리고 「쿼리 튜닝 1차: 병목 진단과 캐싱 설계」의 연장선이다.이번 글에서는 새로운 캐시를 도입하는 실험이 아니라,
이미 사용 중인 Redis가 현재 척척학사(t3.micro) 환경에 과연 적절한 선택인지,
혹은 과한 설계(Over Engineering)는 아닌지를 수치로 검증한다.
1. 실험의 발단: “당연하게 쓰던 Redis, 정말 최선인가?”
척척학사는 초기 설계부터 비교적 자연스럽게 Redis를 캐시 서버로 채택해 왔다.
일부 비즈니스 API 레벨에서 Redis를 사용하며 DB 접근을 줄이는 구조였다.
그러나 최근 진행한 서버 부하 테스트에서 t3.micro의 처참한 자원 한계를 직접 확인한 이후, 근본적인 의문이 생겼다.
“1GB 메모리라는 극한의 환경에서,
별도 컨테이너(Docker)를 띄우고 네트워크 통신을 거치는 Redis가 과연 최선일까?”
이전 글에서 병목 지점을 분석하고 캐싱 전략까지 설계했지만,
그 설계가 지금 이 서버 스펙과 트래픽 규모에서도 합리적인 선택인지는
정량적으로 검증된 적이 없었다.
이번 실험은 “캐시를 더 붙이자”는 시도가 아니다.
이미 사용 중인 Redis가 현재 환경에 어울리는지,
아니면 Local Cache로도 충분한 상황에서
불필요한 복잡도를 감수하고 있는 것은 아닌지를 확인하기 위한 검증이다.
2. 왜 ‘캐시 비교’가 필요했는가
이전 서버 성능 테스트에서 확인한 사실은 비교적 명확했다.
/health수준의 API는 t3.micro에서도 충분히 안정적- 인증 + DB 조회가 포함된 실제 API는 아주 낮은 TPS에서도 병목 발생
- 병목의 핵심은 요청당 발생하는 DB 접근 비용과 커넥션 풀 대기
즉, 문제는 Spring이나 Tomcat의 처리 성능이 아니라
DB 접근 비용이 서버 스펙 대비 지나치게 크다는 점이었다.
이 지점에서 자연스럽게 질문이 이어졌다.
“DB 접근을 줄이기 위해 캐시를 사용한다면,
이 작은 서버에서는 어떤 캐시 전략이 더 합리적일까?”
3. 비교 대상: External Cache vs Local Cache
| 항목 | Redis (External Cache) | Caffeine (Local Cache) |
|---|---|---|
| 위치 | EC2 내부 Docker 컨테이너 | JVM Heap 내부 |
| 통신 | TCP 네트워크 루프백 | 메모리 직접 접근 |
| 직렬화 | 필요 | 없음 |
| 장점 | 다중 인스턴스 간 데이터 공유 | 극도로 낮은 지연 시간 |
| 단점 | 네트워크/컨테이너 오버헤드 | 힙/GC 관리 필요 |
4. 테스트 환경
- Instance: AWS t3.micro (2 vCPU, 1GB RAM)
- OS: Ubuntu
- JVM: OpenJDK 17
- Framework: Spring Boot
- 환경 제약: 단일 EC2, 단일 애플리케이션 인스턴스
⚠️ 모든 결과는 단일 인스턴스 환경 기준이며,
다중 서버 환경에서는 결론이 달라질 수 있다.
5. 테스트 대상 API
API 특성
- Read-heavy
- 데이터 변경 거의 없음
- 캐시 hit 비율이 높을 것으로 예상되는 구조
이번 캐시 비교 실험의 테스트 대상 API는
졸업 요건 분석 API (/api/graduation/progress)로 결정했다.
이 API를 선택한 이유는 다음과 같다.
- 메인 페이지 진입 시 반드시 호출되는 핵심 API
- 졸업 요건 데이터 조회
- 사용자 학업 정보 조회
- 단일 전공 / 복수 전공 분기 로직 포함
- 내부적으로 여러 테이블을 조합해 결과를 계산
즉,
실제 서비스에서 호출 빈도가 높고,
요청당 처리 비용이 크며,
캐시 적용 효과가 가장 명확하게 드러나는 엔드포인트다.
6. 부하 테스트 시나리오
- 도구: k6
- 캐시 hit 비율: 약 95%
- 지속 시간: 20~30분
- TPS: 사전 테스트를 통해 산정 후 고정
단기 스파이크가 아닌,
지속 부하 상황에서 서버가 안정적으로 버틸 수 있는지를 확인한다.
7. 리소스 관측 기준 (Baseline)
부하 테스트 결과를 정확히 해석하기 위해,
먼저 부하가 없는 평상시 상태에서의 서버 리소스 사용량을 기준선(Baseline)으로 확보했다.
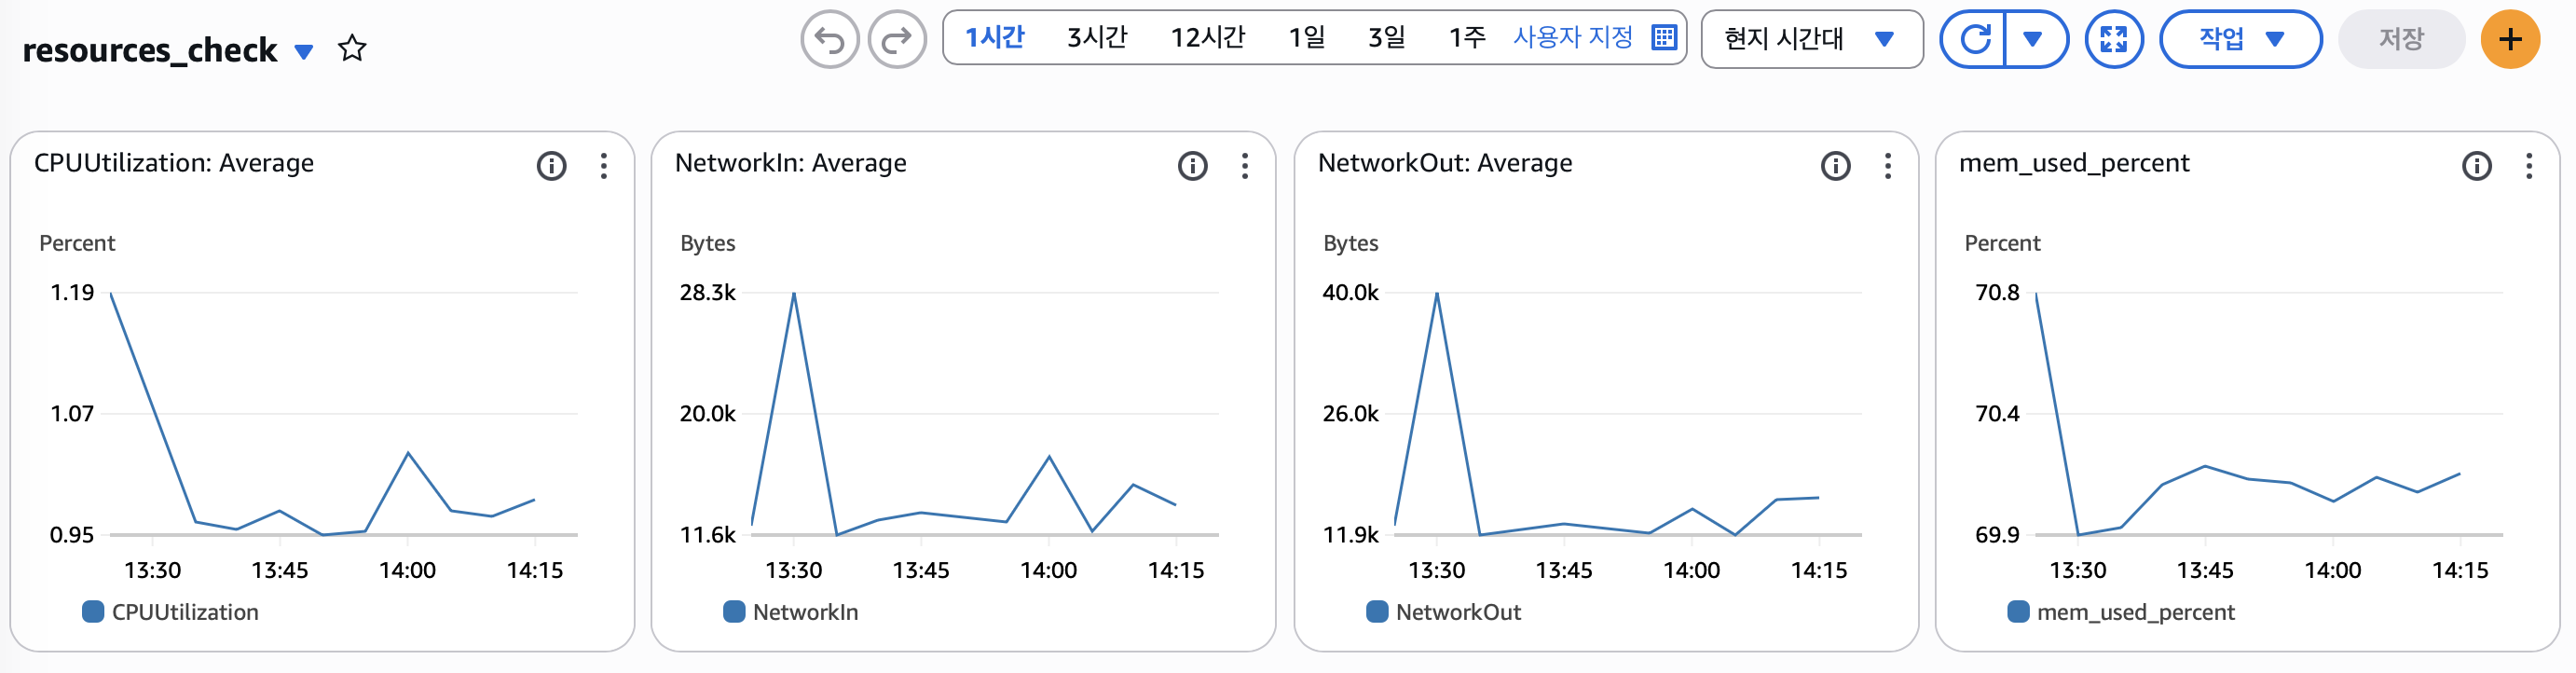
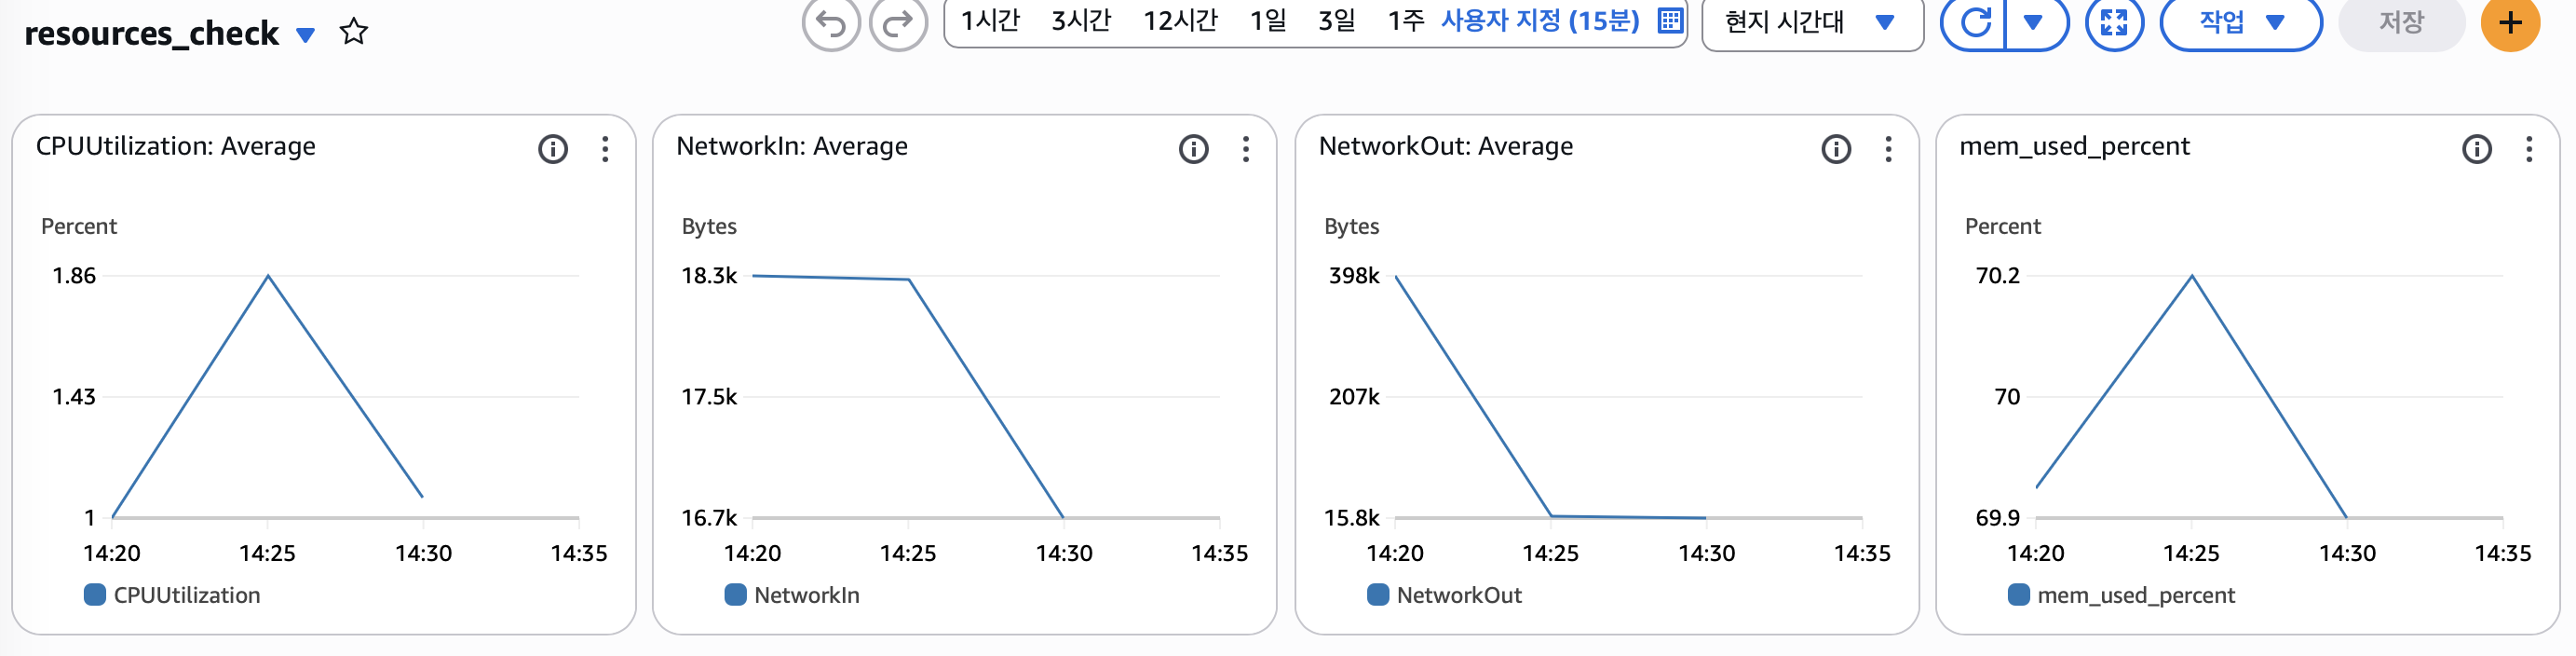
CloudWatch 대시보드를 통해 아래 지표를
부하 테스트를 수행하기 전, 동일한 시간 범위에서 관측했다.
- CPU Utilization (Average, 60s)
- Memory Used (%) (Average, 60s)
- NetworkIn (Sum, 60s)
- NetworkOut (Sum, 60s)
📌 CloudWatch 대시보드 – 전체 1시간 구간 (부하 테스트 전)
📌 CloudWatch 대시보드 – 평상시 15분 확대 (부하 테스트 전 기준선)
기준선 해석
- CPU: 약 1% 내외로 매우 안정적인 상태
- Memory: 큰 변동 없이 완만한 곡선 유지
- NetworkIn / NetworkOut: 유의미한 트래픽 없이 거의 정체 상태
이 구간은 이후 Redis / Local Cache 부하 테스트 결과와 비교하기 위한
절대 기준선(Baseline) 으로 사용된다.
분석 가이드 (비교 관점)
이후 부하 테스트 결과에서는 다음 항목을 중심으로 비교한다.
- CPU: 캐시 전략에 따라 CPU 곡선의 평균 및 변동성이 달라지는지
- Memory: Redis 컨테이너의 고정 점유 vs JVM Heap 증가 폭 비교
- Network: Redis 사용 시 루프백 트래픽이 지속적으로 발생하는지
8. Redis 캐시 구성 (Baseline 기준)
Redis는 다음과 같은 형태로 구성되어 있다.
- EC2 내부 Docker 컨테이너로 실행
- 단일 Redis 인스턴스
- 별도 튜닝 없이 기본 설정 사용
📌 [docker ps 결과 – Redis 컨테이너 실행 상태]
CONTAINER ID   IMAGE     COMMAND                  CREATED        STATUS        PORTS                                         NAMES
facb05a65269   redis     "docker-entrypoint.s…"   13 hours ago   Up 13 hours   0.0.0.0:6379->6379/tcp, [::]:6379->6379/tcp   redis
📌 [docker stats 결과 – 부하 테스트 전 기준선]
CONTAINER ID   NAME      CPU %     MEM USAGE / LIMIT     MEM %     NET I/O         BLOCK I/O         PIDS
facb05a65269   redis     0.22%     5.242MiB / 914.2MiB   0.57%     340kB / 541kB   50.8MB / 57.3kB
Baseline 기준 관측 결과
- Redis 컨테이너 메모리 사용량: 약 5MB
- t3.micro(1GB mem) 기준: 약 0.5% 이상의 메모리를 항상 선점
- CPU 사용률: 0.2% 내외
- Network I/O: 매우 낮은 수준 유지
즉, Redis는 실제 트래픽이 없더라도
컨테이너로 실행되는 순간부터 일정 수준의 고정 리소스 비용을 발생시키는 구조임을 확인할 수 있다.
이 기준선은 이후 Redis 부하 테스트 시
리소스 증가폭을 판단하기 위한 비교 지점으로 사용된다.
k6 Test Script
export const options = {
  scenarios: {
    graduation_cache_test: {
      executor: 'ramping-arrival-rate',
      startRate: 5,
      timeUnit: '1s',
      preAllocatedVUs: 50,
      maxVUs: 100,
      stages: [
        { target: 10, duration: '5m' },  // 워밍업 (캐시 안정화)
        { target: 20, duration: '10m' }, // 안정 구간 (비교 핵심)
        { target: 30, duration: '10m' }, // 한계 구간 (차이 명확)
      ],
    },
  },
};

export default function () {
  const res = http.get(`${BASE_URL}/api/graduation/progress`, {
    headers: {
      Authorization: ACCESS_TOKEN,
    },
    timeout: '5s',
  });

  check(res, {
    'status is 200': (r) => r.status === 200,
  });
}
9. Redis 캐시 부하 테스트 결과
k6 결과 요약
📌 [Redis 사용 시 k6 결과 로그]
  █ TOTAL RESULTS

    checks_total.......: 26205  17.47025/s
    checks_succeeded...: 22.60% 5923 out of 26205
    checks_failed......: 77.39% 20282 out of 26205

    ✗ status is 200
      ↳  22% — ✓ 5923 / ✗ 20282

    HTTP
    http_req_duration..............: avg=918.1ms  min=6.72ms   med=11.6ms   max=5s    p(90)=5s    p(95)=5s
      { expected_response:true }...: avg=672.34ms min=214.59ms med=234.73ms max=4.98s p(90)=2.04s p(95)=3.77s
    http_req_failed................: 77.39% 20282 out of 26205
http_reqs......................: 26205 17.47025/s- 테스트 시간: 25분
- 평균 처리량: 약 17.4 req/s
- 성공률: 22.6%
- 실패율: 77.39%
- 평균 응답 시간: 918ms
- p95 Latency: 5s (timeout 상한 도달)
대부분의 실패 요청은 서버에서 응답을 반환하지 못하고
타임아웃(5s)에 도달하며 실패했다.
이는 단순한 지연(latency 증가)이 아니라,
서버가 요청을 처리할 수 있는 한계를 초과했음을 의미한다.
CloudWatch 기반 리소스 분석
📌 [Redis 부하 테스트 – 전체 1시간: CloudWatch]
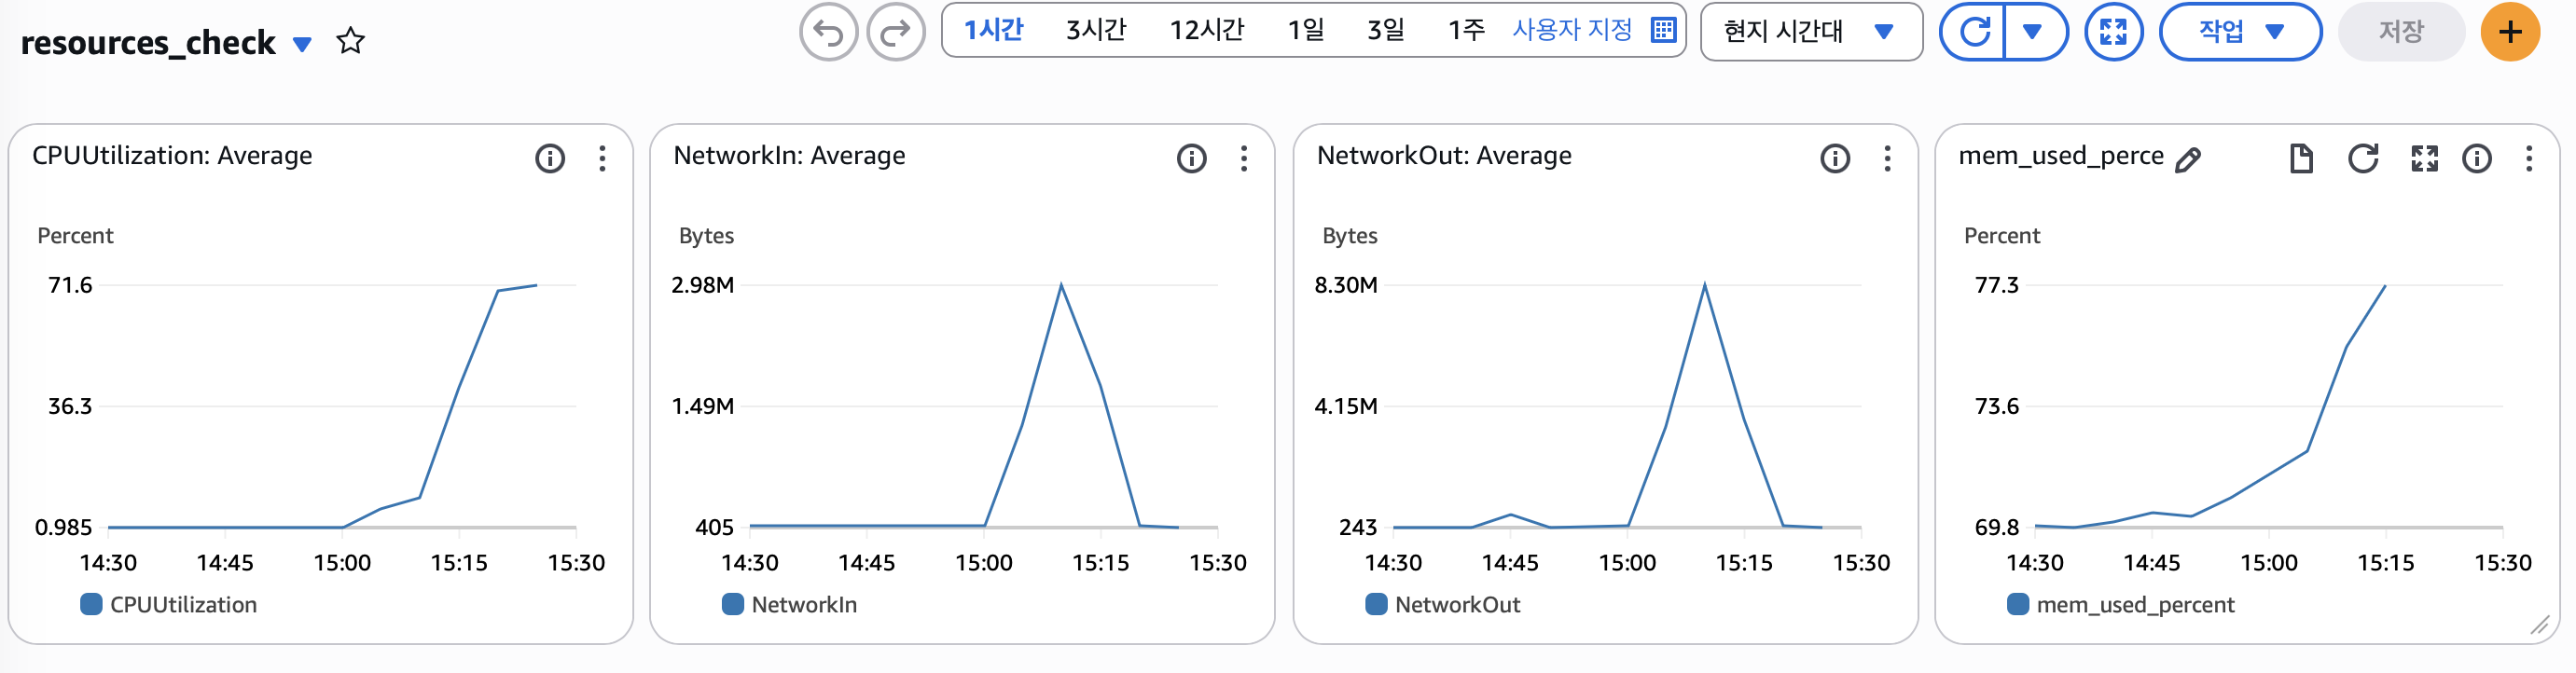
테스트 시간: 15:06 ~ 15:31 (25분)
위 그래프는 부하 테스트 전/중/후를 포함한 전체 구간이다.
- 테스트 이전: CPU, Memory, Network 모두 안정 상태
- 테스트 중반 이후:
- CPU Utilization이 70% 이상으로 급상승
- Memory Used (%)가 70% → 77%까지 지속 증가
- NetworkIn / NetworkOut에서 급격한 spike 발생
- 테스트 후반:
- 모든 지표가 급락하며 정상 패턴 붕괴
- 이후 EC2 SSH 접속 불가 상태 발생
이는 애플리케이션 또는 인스턴스 단위에서
더 이상 요청을 정상 처리하지 못하는 상태에 도달했음을 의미한다.
서버 붕괴 직전 구간 상세 분석: 15분 확대
📌 [Redis 부하 최고 구간 15분 확대: CloudWatch]
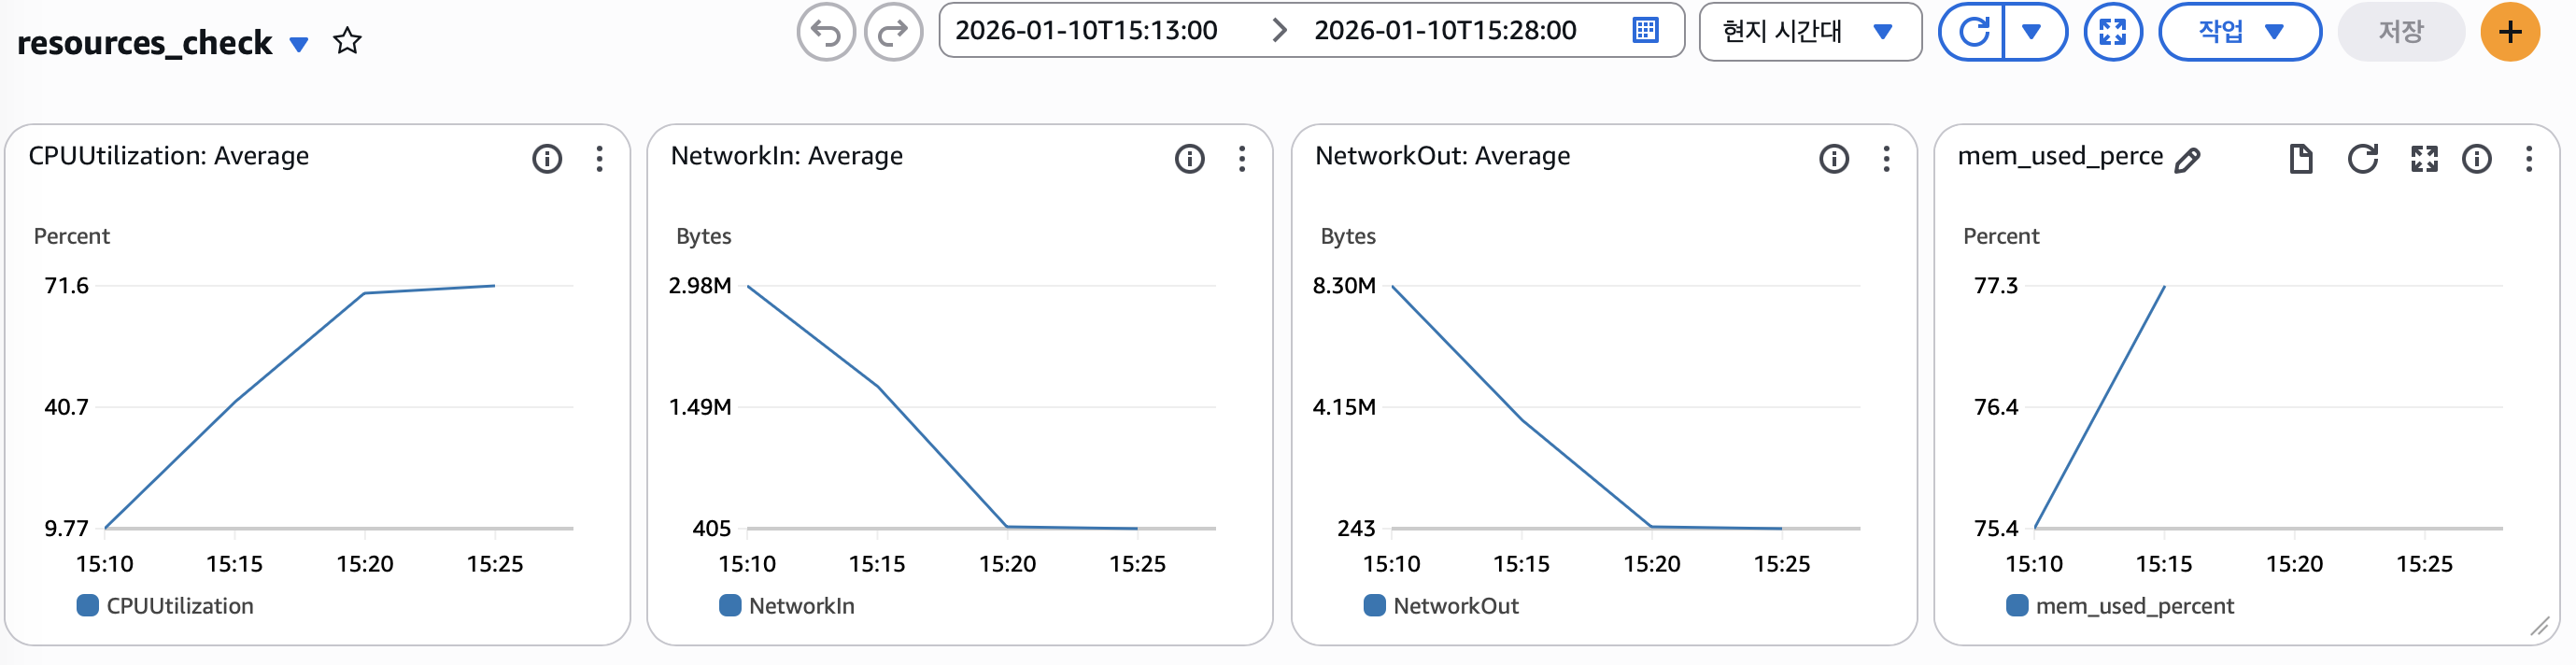
이 구간은 부하 테스트가 진행되던 중
서버가 한계에 도달하기 직전의 15분을 확대한 것이다.
관측된 특징은 다음과 같다.
- CPU Utilization이 지속적으로 상승하며 70% 이상 유지
- Memory Used (%)가 단조 증가, 회수(감소) 구간 없음
- NetworkIn / NetworkOut이 동시에 급증
- 이후 모든 지표가 급락하며 서버 응답 불가 상태로 전환
이는 GC, 네트워크 스택, 스레드 풀 중
특정 하나가 아니라 전체 시스템 자원이 동시에 포화되었음을 시사한다.
Docker 기준 Redis 리소스 상태
📌 [docker ps / docker stats 캡처]
redis  CPU: 0.22%
Memory: 5.2MB / 914MB (0.57%)
Network I/O: 340kB / 541kB
Redis 컨테이너 자체만 놓고 보면
CPU와 메모리 사용량은 매우 낮은 수준이다.
그러나 문제는 Redis 단독이 아니라,
- Redis ↔ Application 간 네트워크 통신 비용
- 직렬화/역직렬화 비용
- Spring + JVM Heap + Redis 컨테이너가 동시에 메모리를 점유하는 구조
이 모든 비용이 합산되어
1GB 메모리를 가진 t3.micro 환경에서는 감당 불가능한 구조적 부담으로 작용했다.
Redis는 기능적으로 안정적이었지만,
이 환경에서는 캐시 이득보다 고정 비용이 더 크게 작용했다
10. Local Cache (Caffeine) 적용 배경
Redis 부하 테스트를 통해 확인한 사실은 명확했다.
- Redis 컨테이너 자체의 리소스 사용량은 낮았지만
- 네트워크 통신, 직렬화/역직렬화, 컨테이너 오버헤드가 누적되며
- t3.micro 환경에서는 구조적으로 부담이 되는 선택이었다
이 지점에서 자연스럽게 다음 질문으로 이어졌다.
“네트워크 비용과 직렬화 비용을 제거하면,
이 환경에서도 안정적인 처리량을 확보할 수 있지 않을까?”
이에 대한 대안으로 선택한 것이 Local Cache (Caffeine) 이다.
Local Cache는 다음과 같은 구조적 특성을 가진다.
- 네트워크 hop 없음
- 직렬화 / 역직렬화 비용 없음
- JVM Heap 메모리에 직접 접근
Redis 사용 시 발생하던 외부 비용을 모두 제거한 상태에서
순수하게 애플리케이션의 처리 한계를 확인할 수 있는 조건이다.
다만, Local Cache 역시 명확한 트레이드오프를 가진다.
- JVM Heap 사용량 증가
- GC 부하 증가 가능성
- 연산 비용이 JVM 내부에 집중
이번 테스트의 목적은 Local Cache가 “더 빠르다”를 증명하는 것이 아니라,
“외부 비용을 제거한 상태에서도
이 서버가 요청을 감당할 수 있는가”를 확인하는 것이다.
11. Local Cache 부하 테스트 결과 — 개선은 있었지만, 병목의 본질은 바뀌지 않았다
k6 결과 요약 (Local Cache)
📌 [Local Cache 적용 후 k6 결과 로그]
  █ TOTAL RESULTS

    checks_total.......: 51538  34.358172/s
    checks_succeeded...: 41.73% 21507 out of 51538
    checks_failed......: 58.26% 30031 out of 51538

    ✗ status is 200
      ↳  23% — ✓ 6139 / ✗ 19630
    ✗ latency < 1000ms
      ↳  59% — ✓ 15368 / ✗ 10401

    HTTP
    http_req_duration..............: avg=2s       min=6.84ms  med=244.7ms  max=5.01s p(90)=5s   p(95)=5s
      { expected_response:true }...: avg=646.73ms min=220.5ms med=256.98ms max=4.99s p(90)=1.9s p(95)=3.47s
    http_req_failed................: 76.17% 19630 out of 25769
    http_reqs......................: 25769  17.179086/s

    EXECUTION
    dropped_iterations.............: 481    0.320662/s
    iteration_duration.............: avg=2s       min=7.09ms  med=245.59ms max=5.01s p(90)=5s   p(95)=5s
    iterations.....................: 25769  17.179086/s
    vus............................: 0      min=0              max=100
    vus_max........................: 100    min=50             max=100

    NETWORK
    data_received..................: 42 MB  28 kB/s
data_sent......................: 1.8 MB 1.2 kB/s - 테스트 시간: 25분
- 평균 처리량: 약 17.18 req/s
- 성공률: 41.73%
- 실패율: 58.26%
- p95 Latency: 5s (timeout 상한 도달)
Redis 테스트와 비교했을 때 가장 눈에 띄는 변화는 성공률이다.
- Redis 성공률: 22.6%
- Local Cache 성공률: 41.7%
즉, Local Cache 적용으로 정상 응답을 반환한 요청 비율은 약 2배 가까이 증가했다.
이는 네트워크 hop 제거와 직렬화/역직렬화 제거가
실제 사용자 관점에서 체감 가능한 성공률 개선으로 이어졌음을 의미한다.
그러나 여기서 중요한 점이 하나 있다.
성공률의 개선이 곧 병목 제거를 의미하지는 않는다.
그러나, 서버는 여전히 붕괴했다
성공률은 분명 개선되었지만, 테스트는 끝까지 안정적으로 유지되지 못했다.
- dropped iterations: 481 발생
- p90 / p95 latency: 5s 타임아웃 도달
- 테스트 후반부에 서버 응답 불능 상태 진입
그리고 이 시점의 서버 로그에서는
이전 실험과 동일한 오류가 반복적으로 관측되었다.
CannotCreateTransactionExceptionCould not open JPA EntityManager for transactionHikariPool - Connection is not available, request timed out
이는 다음 사실을 명확히 보여준다.
Local Cache 적용 이후에도 DB 커넥션 풀 병목은 여전히 존재했다.
Local Cache는 비즈니스 로직 내부의 네트워크 비용과 직렬화 비용을 제거했지만,
- 인증 필터 단계
- 트랜잭션 시작 시점
에서 발생하는 DB 커넥션 요구 자체는 그대로 유지되었다.
결과적으로 요청 수가 증가하면서 HikariCP 커넥션 풀 대기가 다시 병목으로 작동했다.
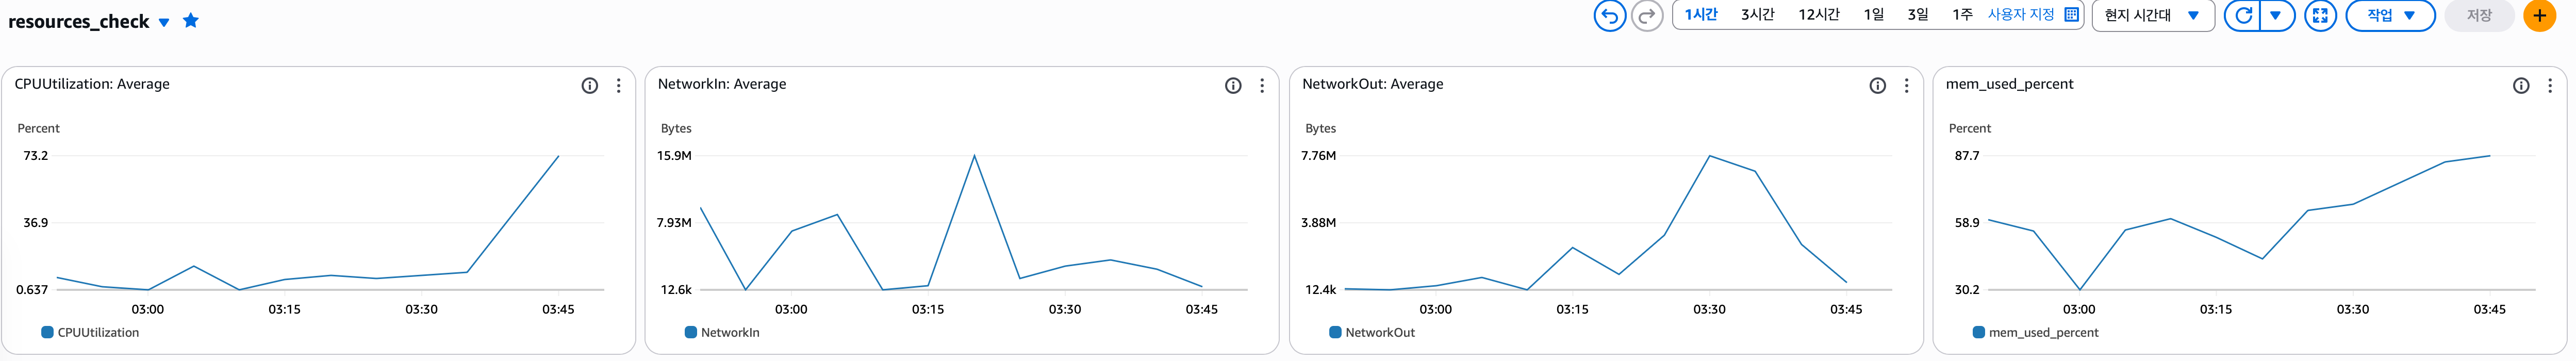
CloudWatch 기반 리소스 분석 (Local Cache)
📌 [Local Cache 부하 테스트 – 전체 1시간 CloudWatch]
📌 [Local Cache 부하 최고 구간 15분 확대]
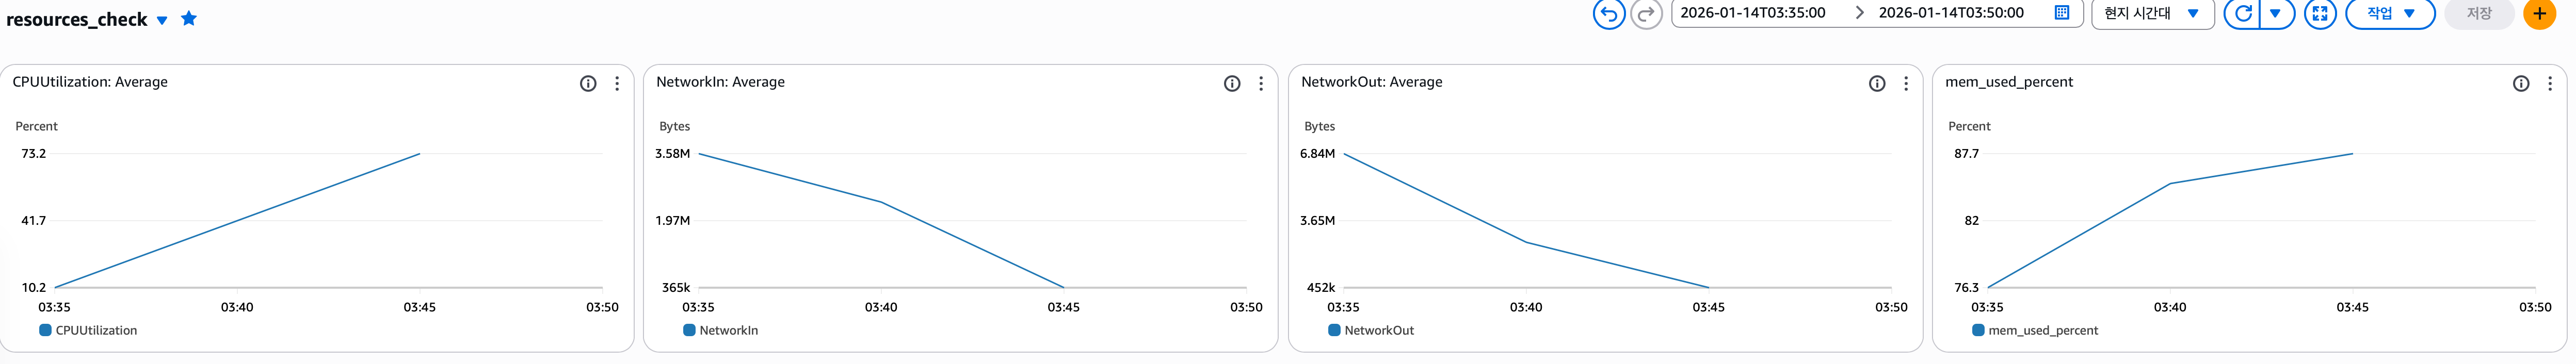
관측된 리소스 패턴은 다음과 같다.
- CPU Utilization: 지속 상승, 70% 이상 구간 장시간 유지
- Memory Used (%): 약 76% → 87%까지 단조 증가
- Network I/O: Redis 대비 감소했으나 완전히 제거되지는 않음
- GC 회수 구간이 거의 관측되지 않음
이 패턴은 다음 구조를 시사한다.
DB 커넥션 대기 → 요청 적체 →
스레드 유지 및 객체 증가 → CPU / Heap 압박
즉, CPU와 JVM Heap 사용량 증가는 병목의 원인이라기보다 결과에 가깝다.
해석: Local Cache의 한계는 ‘캐시’가 아니다
Local Cache는 분명 다음과 같은 효과를 만들었다.
- Redis 대비 네트워크 hop 제거
- 직렬화/역직렬화 비용 제거
- 정상 응답 성공률의 유의미한 개선
그러나 동시에, 다음 비용은 그대로 남아 있었다.
- 인증 필터 단계에서의 DB 커넥션 요청
- 트랜잭션 시작 시 커넥션 풀 대기
- 요청 적체로 인한 스레드 점유
- JVM Heap 내 객체 증가와 GC 압박
이 모든 요소가 결합되며 t3.micro 단일 인스턴스의 처리 한계를 다시 초과했다.
따라서 이번 실험의 결론은 다음과 같다.
Local Cache의 문제가 아니다.
캐시 변경만으로는 해결할 수 없는 DB 커넥션 병목이 구조적으로 남아 있다.
12. Redis vs Local Cache 종합 비교 (수정)
| 분석 항목 | Local Cache | Redis |
|---|---|---|
| 성공률 | 높음 (개선됨) | 낮음 |
| Latency | 낮음 (정상 구간) | 중 |
| Network I/O | 매우 낮음 | 지속 발생 |
| CPU 사용 | 매우 높음 (연산 집중) | 높음 |
| 메모리 특성 | JVM Heap 집중 | Heap + 컨테이너 분산 |
| 서버 붕괴 원인 | DB 커넥션 대기 + JVM 압박 | DB 커넥션 대기 + 네트워크 비용 |
| t3.micro 적합성 | ❌ | ❌ |
이번 실험의 핵심은 어느 캐시가 더 빠른가가 아니다.
캐시는 분명 효과가 있었다.
그러나 병목의 ‘위치’는 아직 바뀌지 않았다.
13. 결론 — 캐시는 성공했고, 병목은 아직 남아 있다
이번 실험을 통해 확인한 사실은 명확하다.
t3.micro 단일 인스턴스 환경에서는
Local Cache 캐시로의 변경만으로는 DB 커넥션 병목을 제거할 수는 없다.
그러나 동시에 중요한 진전도 있었다.
- Local Cache는 명확한 성공률 개선을 만들어냈다
- 네트워크 및 직렬화 비용은 효과적으로 제거되었다
- 병목은 이제 더 선명하게 DB 커넥션 풀로 드러났다
이번 실험은 실패가 아니라 다음 병목을 명확히 드러낸 성공적인 중간 결과다.
14. 다음 단계
이제 다음 질문은 명확하다.
“모든 요청에서 발생하는 인증 단계의 DB 커넥션 요구를 제거하면 병목은 어디로 이동할까?”
다음 실험에서는
- 인증 필터 단계에 캐시를 적용해
- 요청당 고정 DB 접근을 제거하고
- 이후 HikariCP 튜닝을 통해
- 실제로 병목이 어디까지 이동하는지를 검증할 예정이다.
이 실험이 끝나면
t3.micro 환경에서 구조적으로 감당 가능한 TPS의 상한을
처음으로 명확하게 정의할 수 있게 된다.