CPU 코어 하나가 여러 프로그램을 번갈아 실행할 때 일어나는 컨텍스트 스위칭을 정리했습니다. PCB에 무엇을 저장하는지, 언제 전환이 일어나고 왜 비용이 드는지, 리눅스에서 직접 세어 보는 방법까지 살펴봅니다.
들어가며
"코어는 네 개뿐인데, 어떻게 프로그램 수백 개가 동시에 돌아가는 걸까?"
지난번 프로세스와 스레드를 정리하면서 컨텍스트 스위칭이라는 말을 짧게 짚고 넘어갔습니다. 그런데 막상 "그래서 정확히 뭘 저장하고 뭘 꺼내는데?", "그게 왜 비싸다는 거지?"라고 스스로 물어보니 대답이 흐릿했습니다.
그래서 이번에는 전환이 일어나는 순간을 처음부터 끝까지 따라가 보기로 했습니다. 무엇을 어디에 저장하는지, 언제 전환이 일어나는지, 그리고 그 비용이 서버에서 어떤 모습으로 나타나는지까지 정리했습니다.
한눈에 보기
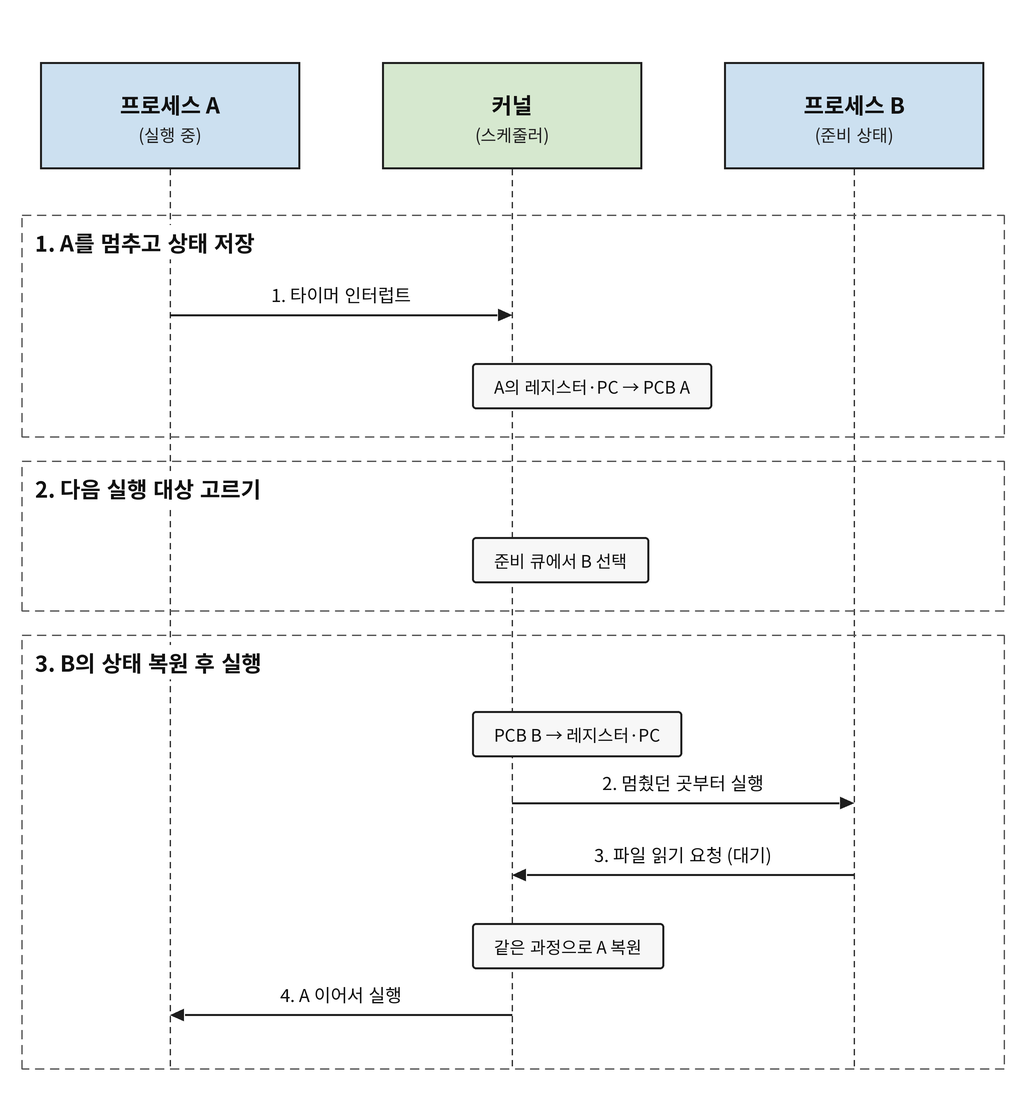
CPU(Central Processing Unit) 코어 하나는 한 순간에 한 실행 흐름만 처리합니다. 여러 프로그램이 동시에 도는 것처럼 보이는 건 OS(Operating System, 운영체제)가 아주 짧은 간격으로 실행 대상을 바꿔 주기 때문입니다.
이때 지금 실행 중이던 흐름의 상태를 저장하고, 다음에 실행할 흐름의 상태를 불러오는 작업을 컨텍스트 스위칭(Context Switching)이라고 합니다. 순서는 크게 세 단계입니다.
- 지금 흐름을 멈추고, 그 상태를 저장합니다.
- 다음에 실행할 흐름을 고릅니다.
- 고른 흐름의 상태를 복원하고, 멈췄던 곳부터 이어서 실행합니다.
잠깐, "컨텍스트"가 뭐예요?
처음엔 컨텍스트라는 단어가 너무 막연했습니다. 여기서 컨텍스트는 이 흐름을 나중에 똑같이 이어서 실행하려면 기억해 둬야 하는 모든 것을 말합니다.
책을 읽다가 잠깐 덮을 때 책갈피를 끼우고, 어디까지 이해했는지 메모해 두는 것과 비슷합니다. 다시 펼쳤을 때 그 책갈피와 메모만 있으면 바로 이어서 읽을 수 있습니다. CPU 입장에서 책갈피는 다음에 실행할 명령어 위치이고, 메모는 계산하던 중간값입니다.
무엇을 저장할까: PCB
OS는 프로세스마다 관리 정보를 담은 구조체를 하나씩 둡니다. 이걸 PCB(Process Control Block, 프로세스 제어 블록)라고 하고, 컨텍스트 스위칭 때 저장하는 값도 여기에 들어갑니다.
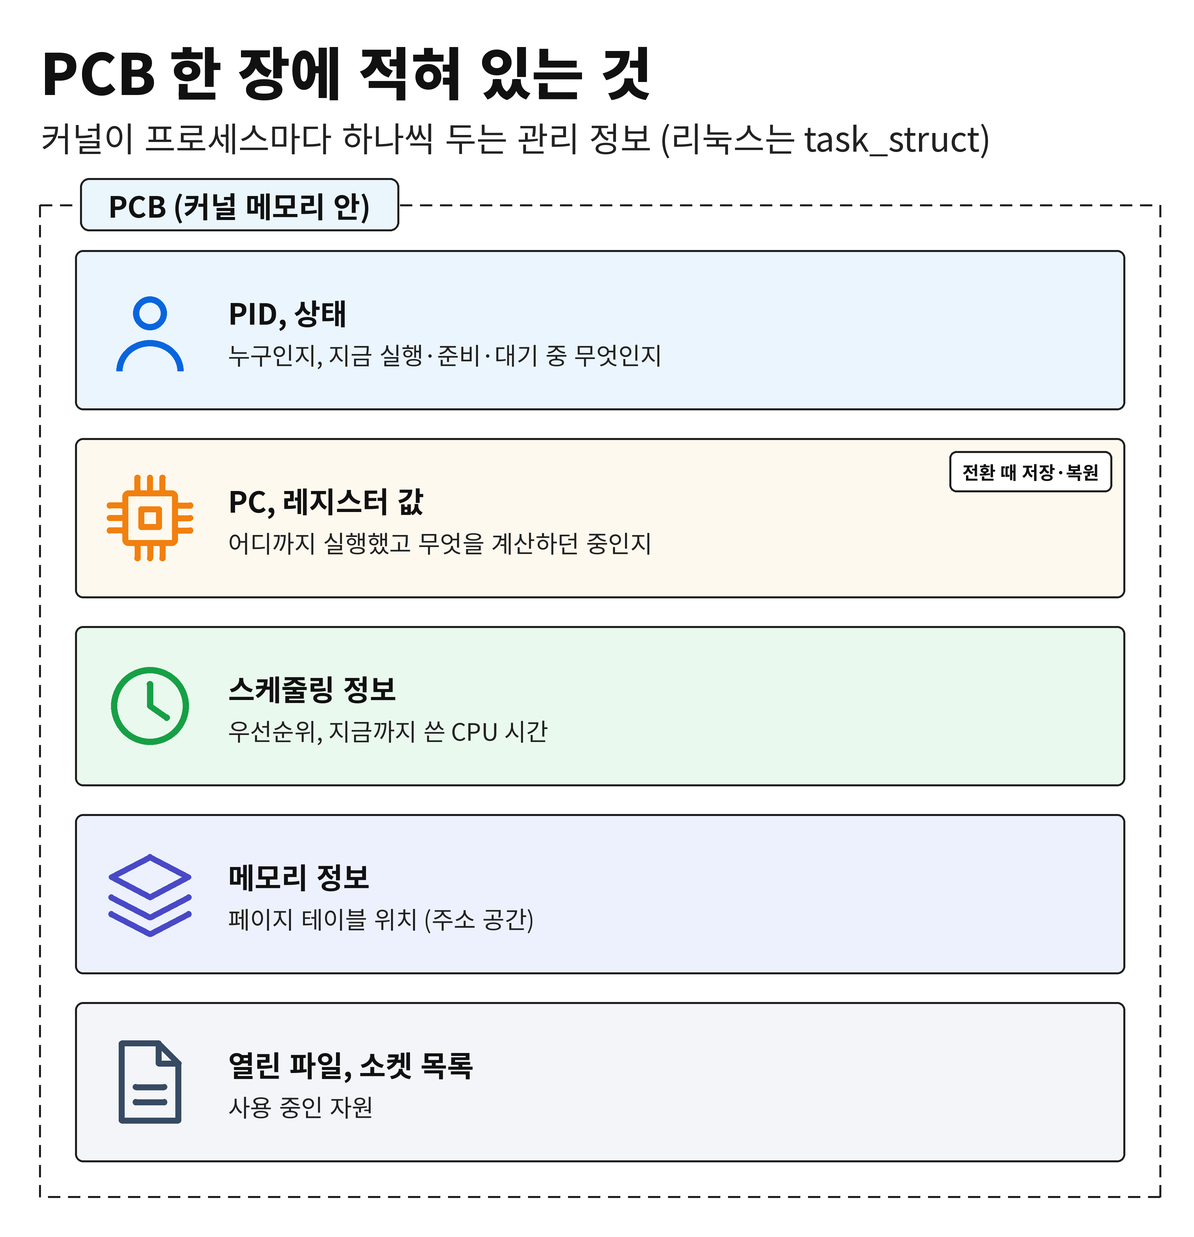
- PID(Process ID)와 상태: 이 프로세스가 누구인지, 지금 실행 중인지 기다리는 중인지를 적어 둡니다.
- PC(Program Counter)와 레지스터 값: 다음에 실행할 명령어의 위치와 계산하던 중간값입니다. 전환할 때 실제로 저장하고 복원하는 핵심이 바로 이 부분입니다.
- 스케줄링 정보: 우선순위나 지금까지 쓴 CPU 시간처럼, 다음에 누구를 실행할지 고를 때 쓰는 값입니다.
- 메모리 정보: 이 프로세스의 주소 공간을 가리키는 페이지 테이블 위치입니다.
- 열린 파일, 소켓 목록: 프로세스가 지금 쓰고 있는 자원입니다.
리눅스에서는 이 역할을 task_struct라는 구조체가 맡습니다. 리눅스는 스레드도 같은 구조체로 관리해서, 스레드마다 하나씩 있다고 보면 됩니다.
잠깐, 레지스터는 왜 꼭 저장해야 하나요?
레지스터는 CPU 안에 있는 아주 작고 빠른 저장 칸입니다. 그런데 코어마다 한 벌뿐이라서, 다음 흐름이 실행되는 순간 그 값이 덮어써집니다.
그래서 떠나는 흐름의 레지스터 값을 메모리에 옮겨 적어 두지 않으면, 나중에 돌아왔을 때 계산하던 값이 전부 사라집니다. 처음엔 "메모리에 있는 데이터는 그대로인데 뭘 저장하지?" 싶었는데, 저장 대상이 메모리가 아니라 CPU 안의 값이라는 걸 알고 나니 이해가 됐습니다.
언제 전환이 일어날까
프로세스는 실행되는 동안 몇 가지 상태를 오갑니다. 가장 많이 쓰는 구분은 준비, 실행, 대기 세 가지입니다.
- 준비(Ready): 실행할 준비는 끝났고, CPU 차례를 기다립니다.
- 실행(Running): 지금 CPU 코어 위에서 명령어를 실행하고 있습니다.
- 대기(Waiting): 디스크나 네트워크 응답처럼 다른 무언가를 기다리고 있어서, 차례가 와도 당장 실행할 수 없습니다.
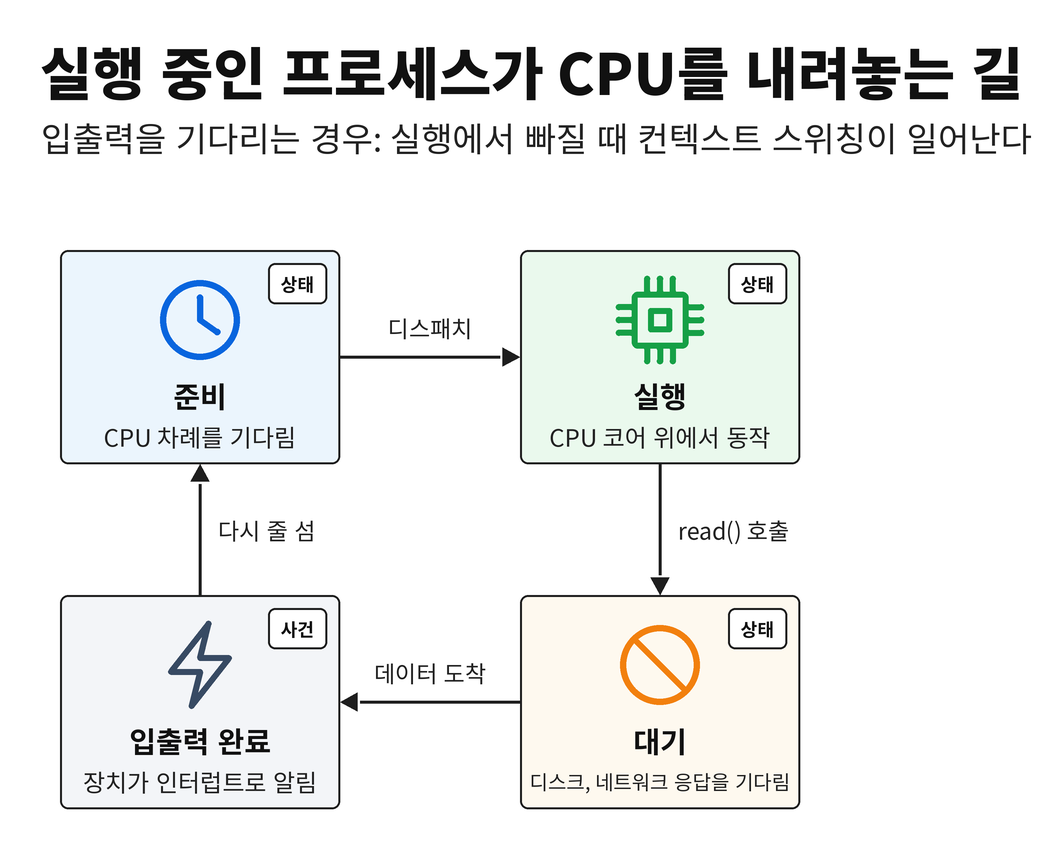
준비 상태에서 실행 상태로 올리는 걸 디스패치(Dispatch)라고 합니다. 그림은 입출력을 기다리는 경우만 그렸고, 할당 시간을 다 써서 실행에서 곧장 준비로 돌아가는 길도 있습니다. 어느 쪽이든 실행 상태에서 빠지는 순간마다 컨텍스트 스위칭이 일어납니다.
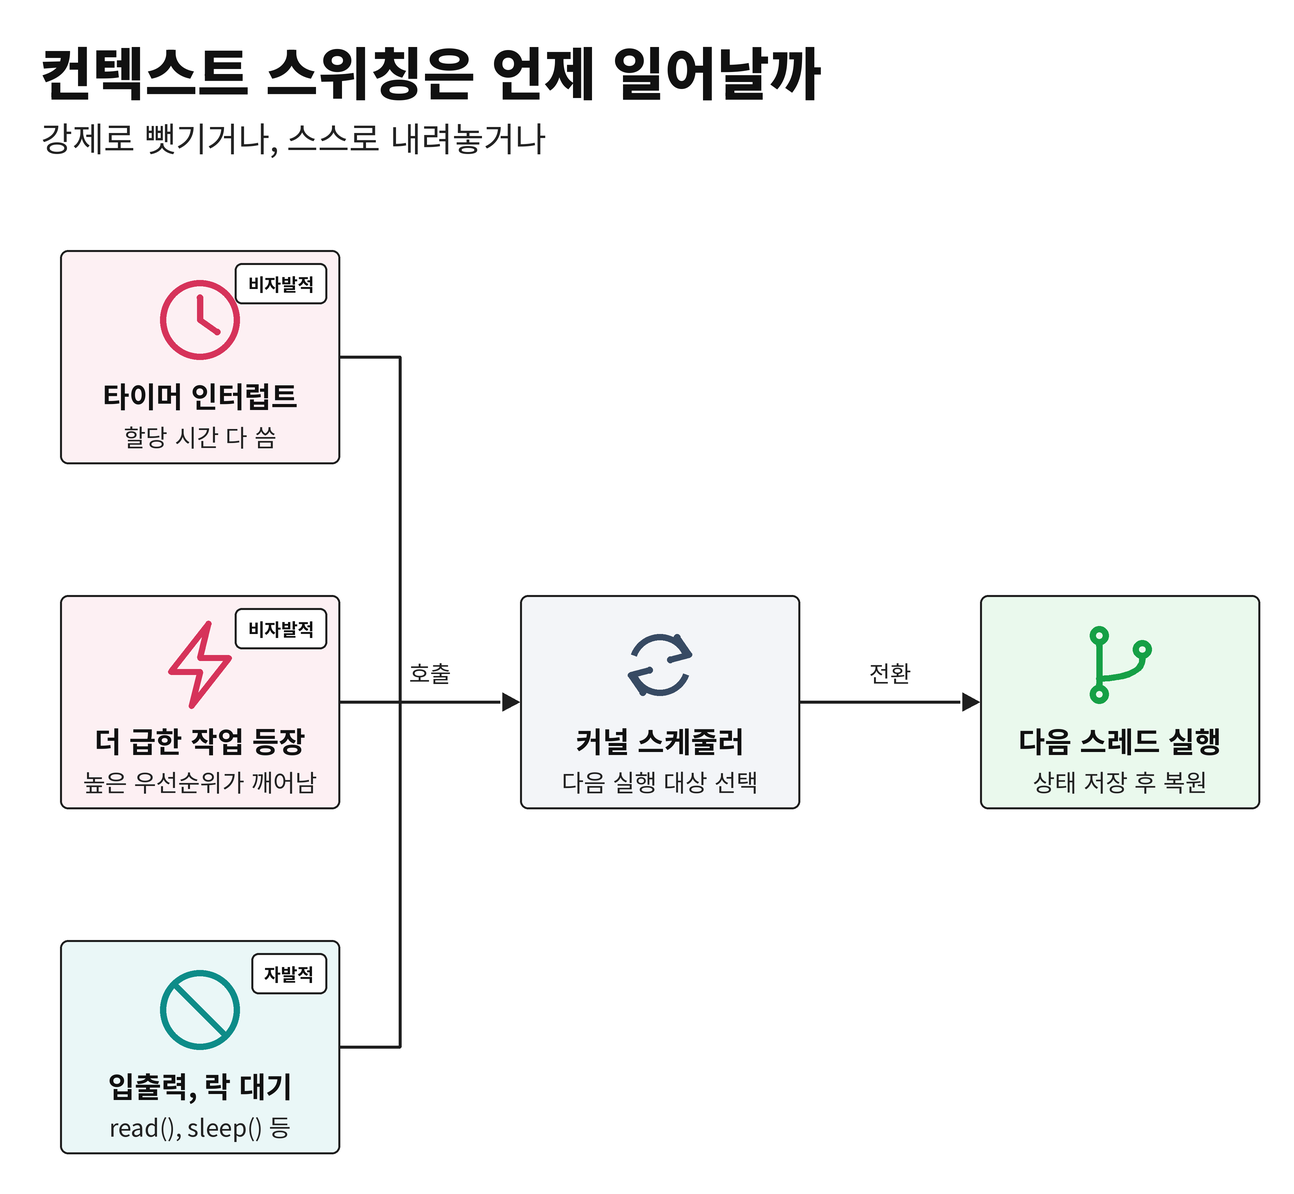
실행에서 빠지는 계기는 크게 둘로 나눌 수 있습니다.
- 비자발적 전환: 스스로는 더 실행하고 싶은데 OS가 빼앗는 경우입니다. 할당받은 시간을 다 써서 타이머 인터럽트가 오거나, 우선순위가 더 높은 작업이 깨어나면 일어납니다. 이렇게 빼앗는 방식을 선점(Preemption)이라고 합니다.
- 자발적 전환: 파일 읽기, 네트워크 응답, 락처럼 무언가를 기다려야 해서 스스로 CPU를 내려놓는 경우입니다.
sleep()을 호출해도 여기에 해당합니다.
할당 시간이 정확히 몇 ms인지는 OS와 스케줄러 설정에 따라 다릅니다. 리눅스 스케줄러는 고정된 시간 조각을 쓰지 않고 실행 중인 작업 수와 가중치에 따라 몫을 계산해서, 하나의 숫자로 말하기 어렵습니다.
잠깐, 인터럽트가 뭐예요?
인터럽트(Interrupt)는 하드웨어나 소프트웨어가 CPU에게 "지금 하던 거 잠깐 멈추고 이것부터 처리해 주세요"라고 보내는 신호입니다. CPU는 신호를 받으면 하던 일을 멈추고 커널의 처리 코드로 넘어갑니다.
수업 중에 교실 문을 두드리는 것과 비슷합니다. 선생님은 하던 설명을 멈추고 문을 열어 본 뒤, 별일 아니면 하던 설명으로 돌아오고 급한 일이면 다른 일을 먼저 합니다. 타이머 인터럽트는 일정 간격으로 문을 두드려서 OS가 "이제 다른 프로세스 차례인가?"를 판단할 기회를 만들어 줍니다.
시스템 콜과 컨텍스트 스위칭은 다르다
이 부분이 제일 헷갈렸습니다 🤔 시스템 콜(System Call)을 부르면 커널로 들어가니까, 그게 곧 컨텍스트 스위칭인 줄 알았습니다.
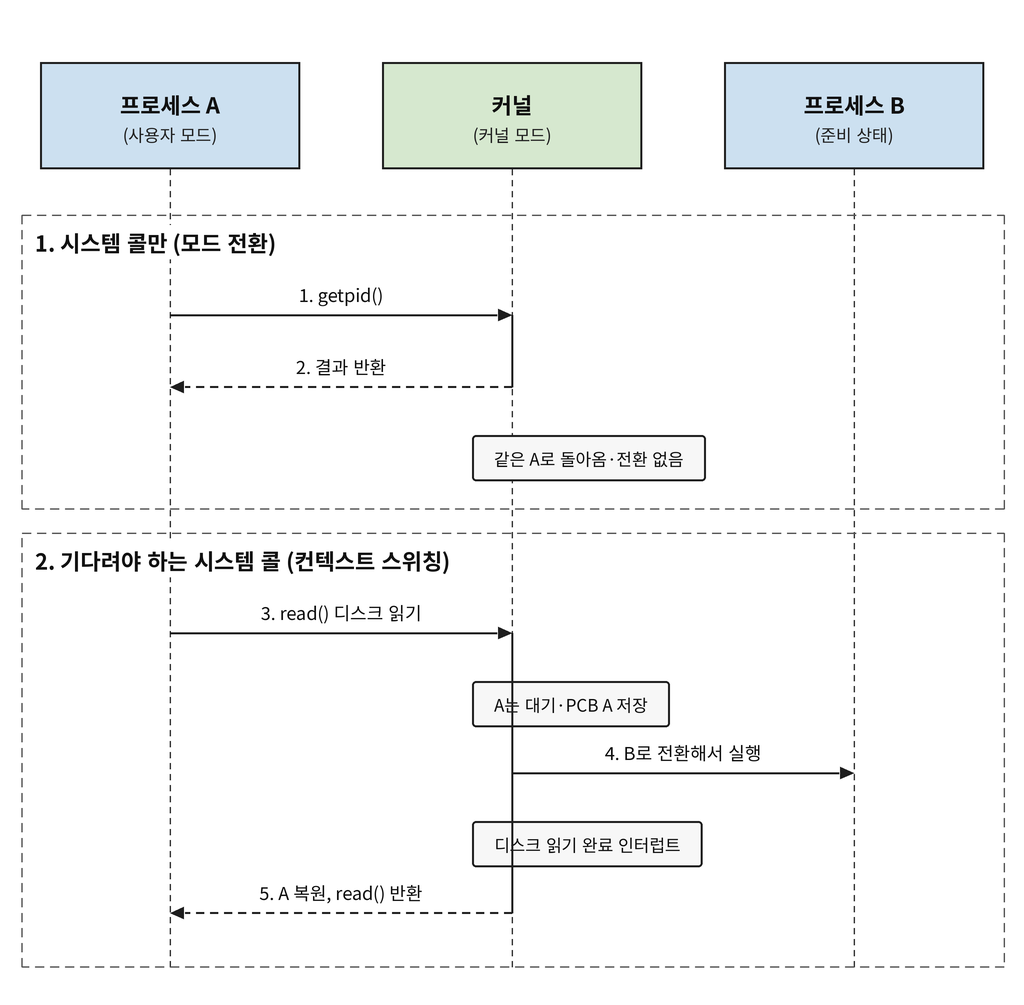
알고 보니 둘은 구분해야 했습니다.
- 모드 전환(Mode Switch): 같은 프로세스가 사용자 모드에서 커널 모드로 들어갔다가 다시 나오는 것입니다.
getpid()처럼 바로 답이 나오는 시스템 콜은 커널에 들어갔다가 같은 프로세스로 돌아옵니다. 실행 대상은 바뀌지 않습니다. - 컨텍스트 스위칭: 실행 대상 자체가 다른 프로세스나 스레드로 바뀌는 것입니다.
read()로 디스크를 읽는데 데이터가 아직 없으면, 기다리는 동안 CPU를 놀릴 수 없으니 커널이 다른 프로세스로 전환합니다.
구분 기준을 한 줄로 정리하면, 실행 중인 흐름이 바뀌었는지입니다. 모드 전환은 컨텍스트 스위칭의 한 부분으로 일어나지만, 모드 전환이 일어났다고 항상 컨텍스트 스위칭이 일어나는 것은 아닙니다.
잠깐, 사용자 모드와 커널 모드는 왜 나눠요?
CPU에는 권한 단계가 있습니다. 우리가 짠 프로그램은 권한이 낮은 사용자 모드에서 돌고, 하드웨어를 직접 만지거나 다른 프로세스의 메모리를 건드리는 일은 커널 모드에서만 할 수 있습니다.
은행 창구로 비유하면, 손님(프로그램)은 금고에 직접 들어갈 수 없고 창구 직원(커널)에게 요청해야 합니다. 시스템 콜은 창구에 번호표를 내미는 행동이고, 직원이 금고에 다녀오는 동안 손님이 잠깐 자리를 비워도 되면 다음 손님을 먼저 받는 것이 컨텍스트 스위칭입니다.
전환 비용은 어디서 생길까
컨텍스트 스위칭이 비싸다고 하는데, 처음엔 레지스터 몇 개 저장하는 게 뭐가 비싸나 싶었습니다. 비용은 크게 두 종류였습니다.
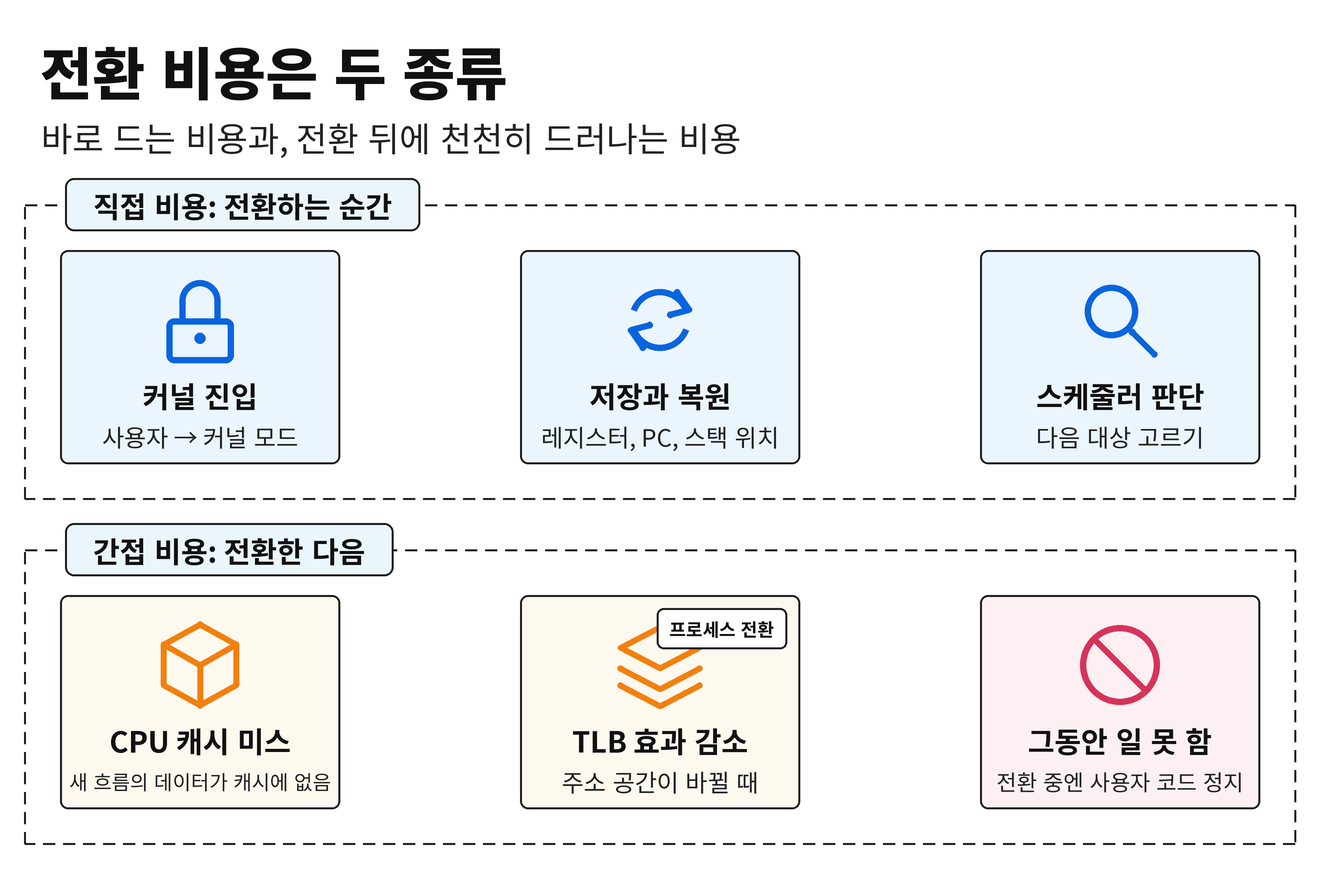
직접 비용: 전환하는 순간
- 커널로 들어가고 나오는 비용
- 레지스터, PC, 스택 위치를 저장하고 복원하는 비용
- 스케줄러가 다음 대상을 고르는 비용
이 시간 동안 CPU는 커널 코드를 실행할 뿐, 사용자 프로그램의 일은 전혀 진행되지 않습니다.
간접 비용: 전환한 다음
실제로 더 큰 건 전환한 뒤에 천천히 드러나는 비용이었습니다.
- 캐시 미스(Cache Miss): CPU 캐시에는 직전 흐름이 쓰던 데이터가 들어 있습니다. 새 흐름이 쓰는 데이터는 캐시에 없으니, 한동안 느린 메인 메모리에서 다시 가져와야 합니다.
- TLB(Translation Lookaside Buffer, 주소 변환 캐시) 효과 감소: TLB는 가상 주소를 실제 주소로 바꾼 결과를 기억해 두는 캐시입니다. 다른 프로세스로 넘어가면 주소 공간이 바뀌어서, 이전 프로세스의 변환 결과를 쓸 수 없습니다.
요즘 CPU는 TLB 항목에 주소 공간 번호를 붙여 두는 기능이 있어서, 프로세스를 바꿀 때마다 TLB를 통째로 비우지 않아도 됩니다. 그래도 새 프로세스의 변환 결과가 다시 채워지기 전까지는 느릴 수밖에 없습니다.
그래서 스레드 전환이 더 싼 이유
같은 프로세스의 스레드끼리는 주소 공간이 같습니다. 그래서 페이지 테이블을 갈아 끼울 필요가 없고, TLB에 담긴 변환 결과도 그대로 쓸 수 있습니다. 힙 데이터를 함께 쓰니 캐시가 살아 있을 가능성도 큽니다.
다만 레지스터를 저장하고 복원하는 직접 비용은 스레드 전환에도 똑같이 듭니다. 스레드 전환이 공짜인 게 아니라, 주소 공간을 바꾸는 비용이 빠질 뿐이라는 점을 기억해 두려고 합니다.
직접 확인해 보기
리눅스는 프로세스마다 컨텍스트 스위칭 횟수를 세어 둡니다. 클라우드 리눅스 환경(코어 4개)에서 직접 확인해 봤습니다.
# 1) 0.05초씩 20번 잠드는 프로세스
bash -c 'for i in $(seq 20); do sleep 0.05; done; grep ctxt /proc/self/status'

# 2) 코어 4개에 쉬지 않고 도는 프로세스 8개
for i in $(seq 8); do timeout 4 bash -c 'while :; do :; done' & done
grep ctxt /proc/<PID>/status
# 1) 결과
voluntary_ctxt_switches: 21
nonvoluntary_ctxt_switches: 0
# 2) 결과 (3초쯤 지난 뒤, 그중 한 프로세스)
voluntary_ctxt_switches: 0
nonvoluntary_ctxt_switches: 383/proc/<PID>/status: 리눅스가 프로세스 정보를 파일처럼 보여 주는 곳입니다./proc/self는 지금 이 명령을 실행하는 프로세스 자신을 뜻합니다.voluntary_ctxt_switches: 자발적 전환 횟수입니다. 1번은sleep을 기다릴 때마다 스스로 CPU를 내려놓아서 이 숫자가 올라갔습니다.nonvoluntary_ctxt_switches: 비자발적 전환 횟수입니다. 2번은 할 일이 계속 남아 있는데 코어보다 프로세스가 두 배 많아서, 3초 만에 수백 번 CPU를 빼앗겼습니다.
처음엔 2번도 0이 나와서 당황했습니다. 프로세스를 하나만 돌렸더니 놀고 있는 코어가 있어서 아무도 빼앗을 이유가 없었던 것이었습니다. 코어 수보다 많이 돌리고 나서야 숫자가 올라가는 걸 보니 확실히 기억에 남았습니다.
시스템 전체의 초당 전환 횟수는 vmstat 1의 cs 열에서 볼 수 있습니다. sysstat 패키지가 있다면 pidstat -w 1로 프로세스별 초당 자발적(cswch/s), 비자발적(nvcswch/s) 전환 수도 볼 수 있습니다.
백엔드 개발자 입장에서 보면
스프링 부트 서버는 JVM(Java Virtual Machine) 프로세스 하나 안에서 요청마다 스레드를 배정합니다. 내장 톰캣의 기본 최대 스레드 수는 200개이고, 이 스레드는 OS 스레드와 1대1로 대응합니다.
이 구조에서 컨텍스트 스위칭은 이렇게 드러납니다.
- 요청 대부분은 DB(Database)나 외부 API(Application Programming Interface) 응답을 기다리는 시간입니다. 기다리는 동안 스레드는 자발적 전환으로 CPU를 내려놓으니, CPU는 그 사이 다른 요청을 처리할 수 있습니다.
- 그렇다고 스레드 수를 무작정 늘리면 실행 가능한 스레드가 코어보다 훨씬 많아집니다. 그러면 비자발적 전환과 캐시 미스가 늘어서, 실제 일보다 전환에 쓰는 시간이 커질 수 있습니다.
- 반대로 CPU 계산 위주 작업이라면 스레드 수를 코어 수 근처로 두는 편이 낫습니다. 전환해 봐야 기다릴 일이 없어서 비용만 들기 때문입니다.
잠깐, 가상 스레드는 뭐가 다른가요?
Java 21에 정식으로 들어온 가상 스레드(Virtual Thread)는 이 전환 비용을 줄이려는 방법입니다.
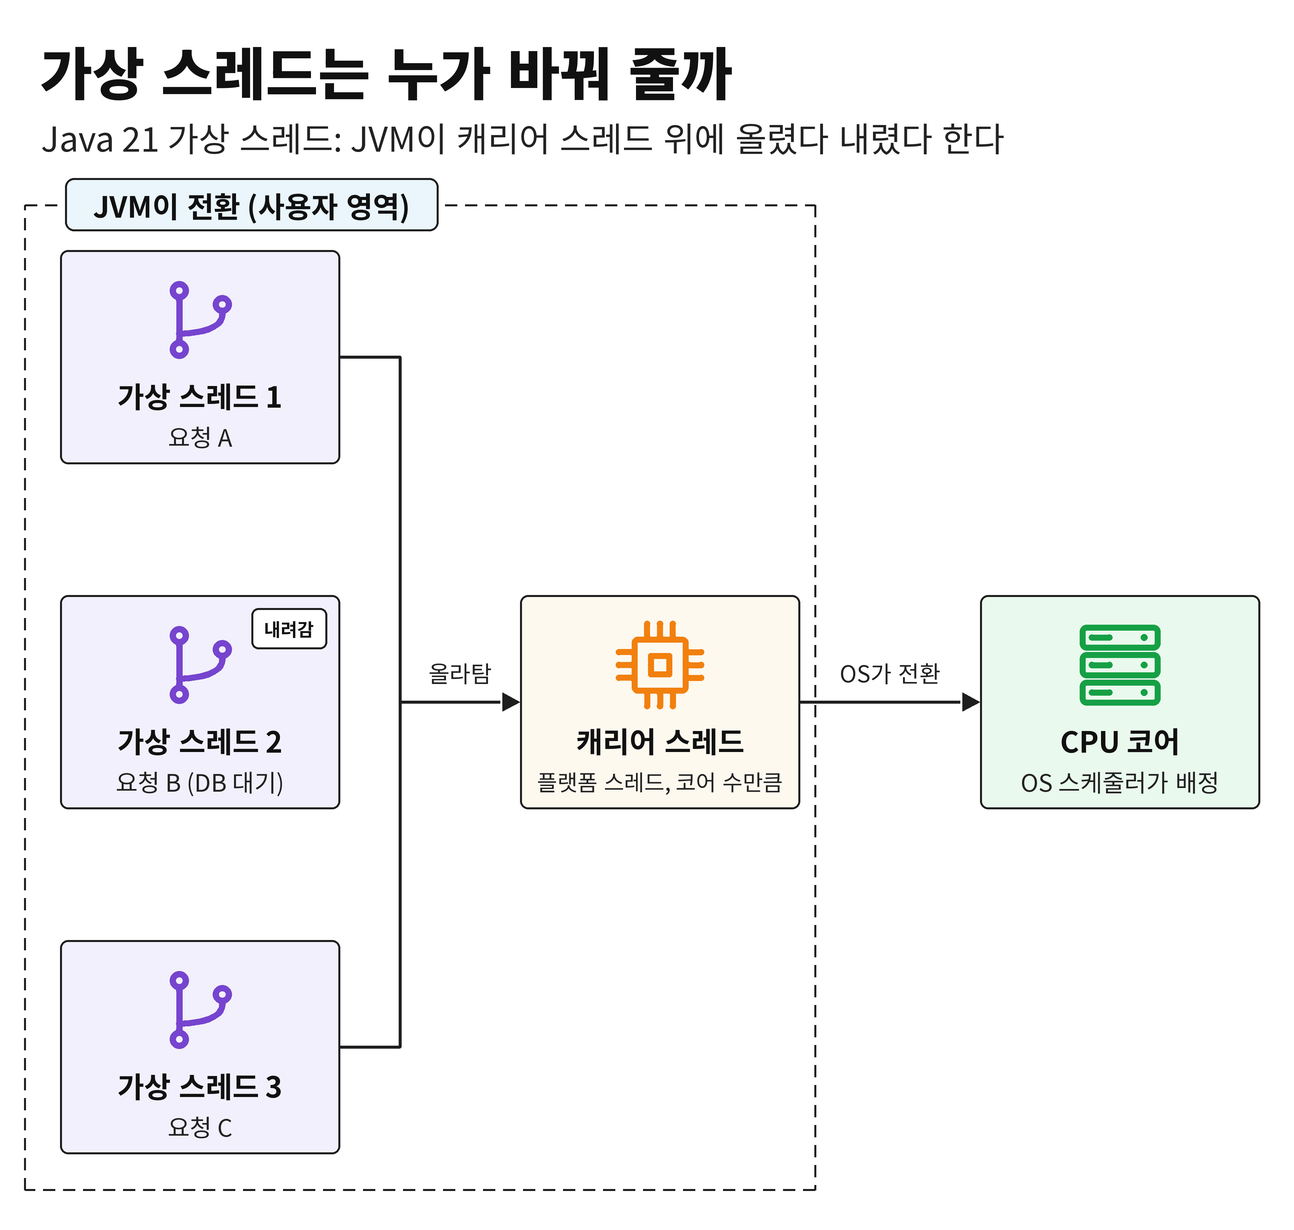
가상 스레드는 OS가 아니라 JVM이 관리합니다. JVM은 코어 수 정도의 플랫폼 스레드(캐리어 스레드)를 두고, 그 위에 가상 스레드를 올렸다 내렸다 합니다. 가상 스레드가 DB 응답을 기다리면 캐리어 스레드에서 내려오고, 그 자리에 다른 가상 스레드가 올라탑니다.
이 전환은 커널을 거치지 않고 JVM 안에서 일어나서, OS 스레드끼리 전환하는 것보다 가볍습니다. 스프링 부트 3.2부터는 spring.threads.virtual.enabled=true 설정 하나로 요청 처리에 가상 스레드를 쓸 수 있습니다.
다만 캐리어 스레드 자체는 여전히 OS가 코어에 배정하니, OS 수준의 컨텍스트 스위칭이 사라지는 건 아닙니다.
스스로 점검해 보기
- Q. 컨텍스트 스위칭이란 무엇인가요?
- CPU 코어에서 실행 중인 프로세스나 스레드를 다른 것으로 바꾸는 과정입니다. 지금 흐름의 레지스터와 PC 같은 상태를 PCB에 저장하고, 다음 흐름의 상태를 복원해 멈췄던 곳부터 이어서 실행합니다. 이 덕분에 코어 수보다 많은 작업이 동시에 실행되는 것처럼 보입니다.
- Q. 컨텍스트 스위칭은 언제 일어나나요?
- 할당 시간을 다 써서 타이머 인터럽트가 오거나, 우선순위가 더 높은 작업이 깨어나면 OS가 실행을 빼앗습니다. 또 입출력이나 락을 기다려야 할 때는 프로세스가 스스로 CPU를 내려놓습니다. 앞의 경우를 비자발적 전환, 뒤의 경우를 자발적 전환이라고 합니다.
- Q. 컨텍스트 스위칭이 잦으면 왜 성능이 떨어지나요?
- 전환하는 동안 CPU는 커널 코드만 실행하고 사용자 작업은 진행하지 못합니다. 게다가 전환한 뒤에는 캐시와 TLB에 새 흐름의 데이터가 없어서 한동안 메모리 접근이 느려집니다. 그래서 전환이 너무 잦으면 실제 일보다 전환에 쓰는 시간이 커집니다.
- Q. 스레드 컨텍스트 스위칭이 프로세스보다 빠른 이유는 무엇인가요?
- 같은 프로세스의 스레드끼리는 주소 공간이 같아서 페이지 테이블을 바꿀 필요가 없고, TLB와 캐시의 내용도 그대로 쓸 수 있기 때문입니다. 레지스터를 저장하고 복원하는 비용은 양쪽 모두 듭니다.
- Q. 시스템 콜을 호출하면 항상 컨텍스트 스위칭이 일어나나요?
- 아닙니다. 시스템 콜은 같은 프로세스가 커널 모드로 들어가는 모드 전환이고, 바로 끝나는 호출이면 같은 프로세스로 돌아옵니다.
read()처럼 기다려야 하는 호출일 때 커널이 다른 프로세스로 전환하면서 컨텍스트 스위칭이 일어납니다.
- 아닙니다. 시스템 콜은 같은 프로세스가 커널 모드로 들어가는 모드 전환이고, 바로 끝나는 호출이면 같은 프로세스로 돌아옵니다.
정리
- 컨텍스트 스위칭은 실행 중인 흐름의 레지스터와 PC 같은 상태를 PCB에 저장하고, 다음 흐름의 상태를 복원해 실행 대상을 바꾸는 과정입니다.
- 전환은 타이머 인터럽트나 선점으로 빼앗기는 비자발적 전환과, 입출력이나 락을 기다리며 내려놓는 자발적 전환으로 일어납니다.
- 비용은 저장과 복원 같은 직접 비용과 캐시, TLB 효과가 줄어드는 간접 비용이 있고, 스레드 전환은 주소 공간을 바꾸지 않아서 더 가볍습니다.