프로세스와 스레드의 차이를 메모리 구조부터 다시 정리했습니다. 스레드끼리 무엇을 함께 쓰고 무엇을 따로 가지는지, 그 차이가 컨텍스트 스위칭과 스프링 서버의 동시성 문제로 어떻게 이어지는지 살펴봅니다.
들어가며
"프로세스는 실행 중인 프로그램이고, 스레드는 그 안의 실행 단위다."
이 한 줄은 수업에서도 여러 번 들어서 안다고 생각했습니다. 그런데 "그래서 스레드는 프로세스랑 뭐가 다른데?", "왜 스레드가 더 가볍다는 거지?"라고 스스로 물어보니 바로 말문이 막혔습니다 😅
외운 문장 말고, 메모리 안에서 실제로 무엇이 나뉘고 무엇이 공유되는지 그림으로 이해하고 싶었습니다. 그래서 프로세스와 스레드를 메모리 구조, 전환 비용, 그리고 제가 쓰는 스프링 서버 안의 모습까지 이어서 정리해 봤습니다.
한눈에 보기
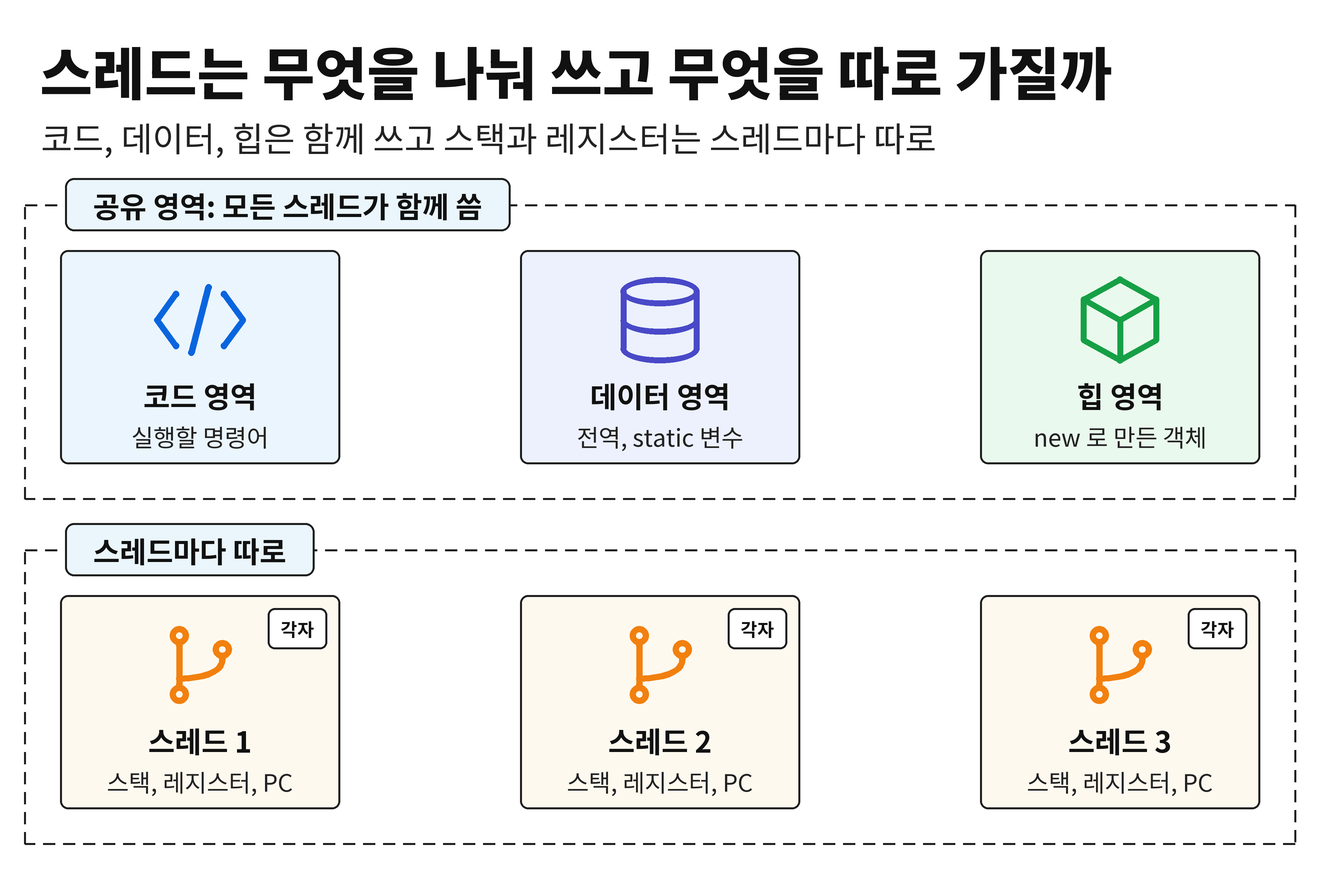
핵심은 그림 한 장으로 정리됩니다. 프로세스는 운영체제에게 자원을 받는 단위이고, 스레드는 그 자원 안에서 실제로 코드를 실행하는 흐름입니다.
| 구분 | 프로세스(Process) | 스레드(Thread) |
|---|---|---|
| 정체 | 실행 중인 프로그램 하나 | 프로세스 안의 실행 흐름 하나 |
| 메모리 | 자기만의 주소 공간(코드, 데이터, 힙, 스택) | 코드, 데이터, 힙은 공유, 스택은 따로 |
| 서로 통신 | 운영체제가 제공하는 별도 통로가 필요 | 같은 힙의 객체를 바로 읽고 씀 |
| 만들고 전환하는 비용 | 큼 | 상대적으로 작음 |
| 하나가 망가지면 | 다른 프로세스는 보통 영향 없음 | 같은 프로세스 전체가 영향을 받을 수 있음 |
잠깐, 프로그램과 프로세스는 뭐가 다를까요?
처음엔 둘을 같은 말로 썼는데, 구분하고 나니 이후 내용이 훨씬 잘 들어왔습니다.
- 프로그램: 디스크에 저장된 실행 파일입니다. 아직 아무 일도 하지 않는 "요리책"에 가깝습니다.
- 프로세스: 그 파일을 메모리에 올려 실제로 실행 중인 상태입니다. 요리책을 펴 놓고 재료를 꺼내 요리하고 있는 "주방" 하나라고 볼 수 있습니다.
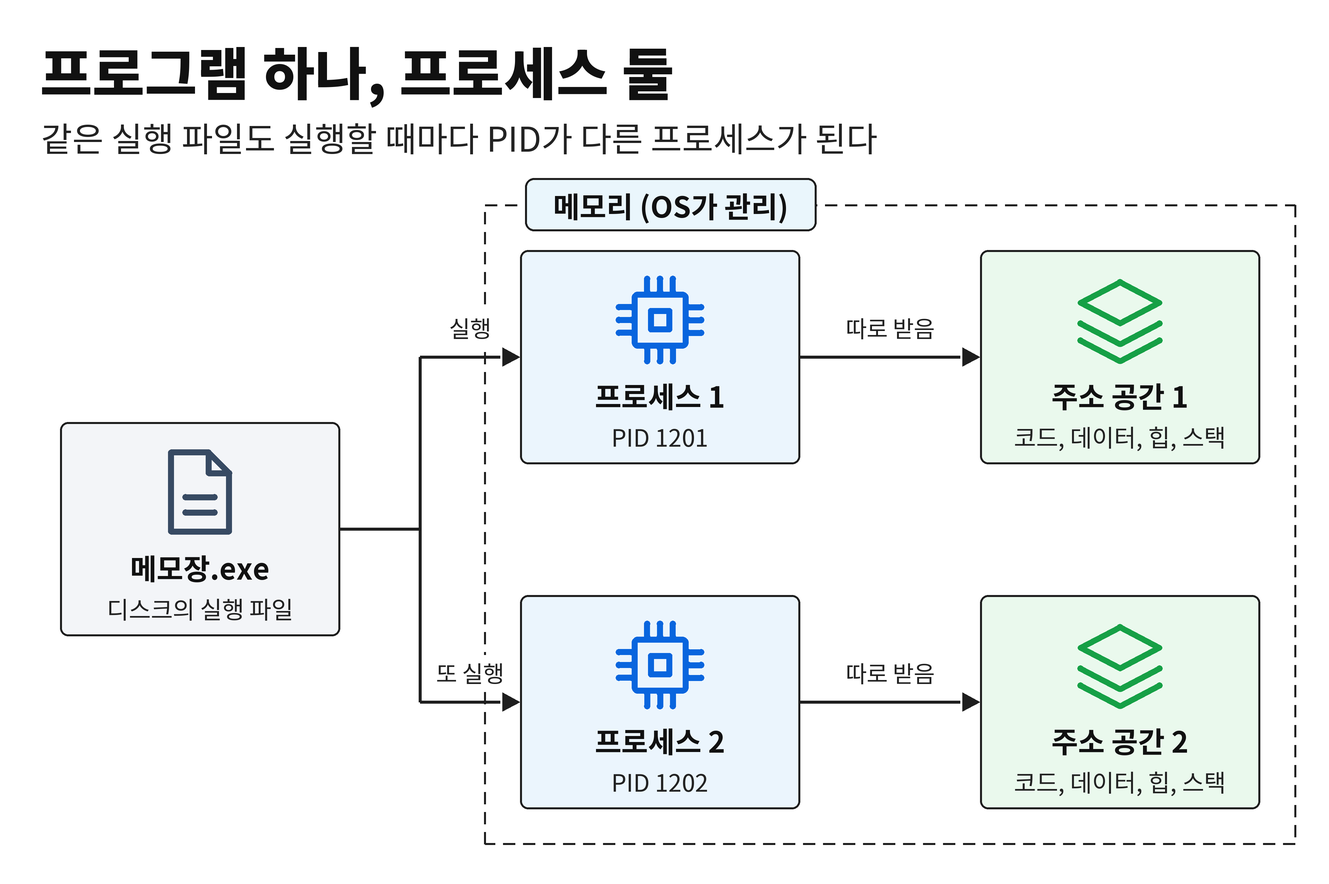
그래서 같은 메모장 프로그램을 두 번 실행하면 프로그램은 하나지만 프로세스는 두 개가 됩니다. OS(Operating System, 운영체제)는 프로세스마다 PID(Process ID)라는 번호를 붙여 구분합니다.
프로세스: 자원을 받는 단위
OS는 프로세스를 만들 때 그 프로세스만 쓰는 메모리 공간을 하나 떼어 줍니다. 이 공간은 보통 네 영역으로 나눠서 설명합니다.
- 코드 영역: 실행할 기계어 명령어가 들어 있습니다.
- 데이터 영역: 전역 변수, static 변수처럼 프로그램 내내 살아 있는 값이 들어 있습니다.
- 힙 영역: 실행 중에 필요할 때 만드는 공간입니다. Java에서
new로 만든 객체가 여기에 생깁니다. - 스택 영역: 함수를 호출할 때마다 지역 변수, 매개변수, 돌아갈 위치가 쌓였다가 함수가 끝나면 빠집니다.
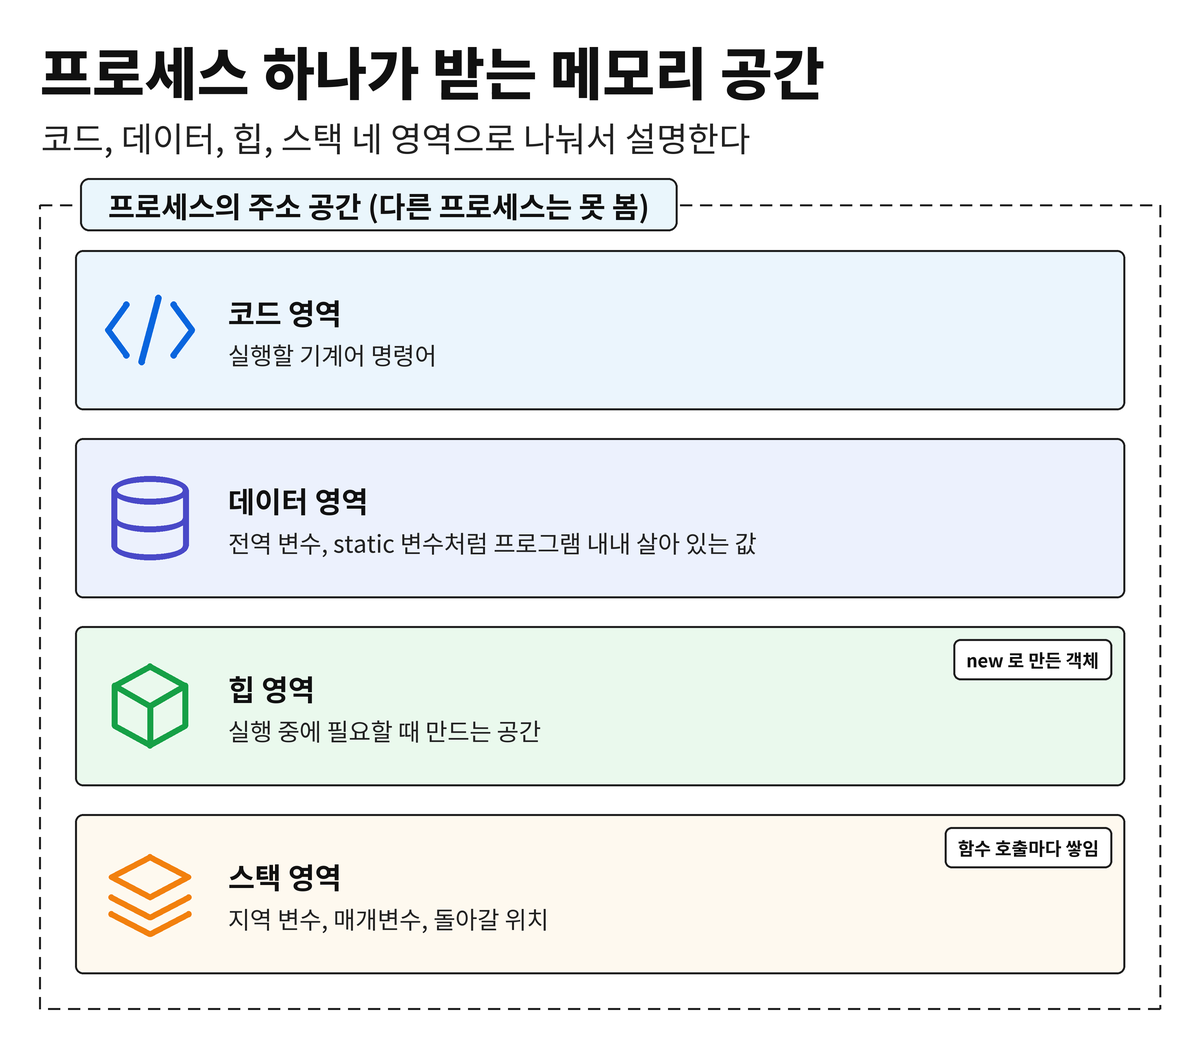
중요한 점은 프로세스끼리는 이 공간을 서로 볼 수 없다는 것입니다. 크롬 탭 하나가 멈춰도 다른 프로그램이 같이 죽지 않는 이유가 여기에 있습니다.
잠깐, 주소 공간이 "따로"라는 건 무슨 뜻일까요?
처음엔 프로세스마다 실제 메모리 칸이 물리적으로 딱 나뉘어 있는 줄 알았는데 조금 달랐습니다. 프로세스는 각자 "0번지부터 시작하는 나만의 메모리"를 가진 것처럼 보이고, OS와 하드웨어가 그 주소를 실제 메모리 위치로 바꿔 줍니다. 이걸 가상 메모리라고 하고, 다음에 따로 정리해 볼 생각입니다.
비유하면 아파트 동마다 "101호"가 있는 것과 같습니다. A동 101호와 B동 101호는 이름은 같아도 다른 집이라서, A 프로세스의 1000번지와 B 프로세스의 1000번지는 서로 다른 곳을 가리킵니다. 그래서 남의 메모리를 실수로 덮어쓸 수 없습니다.
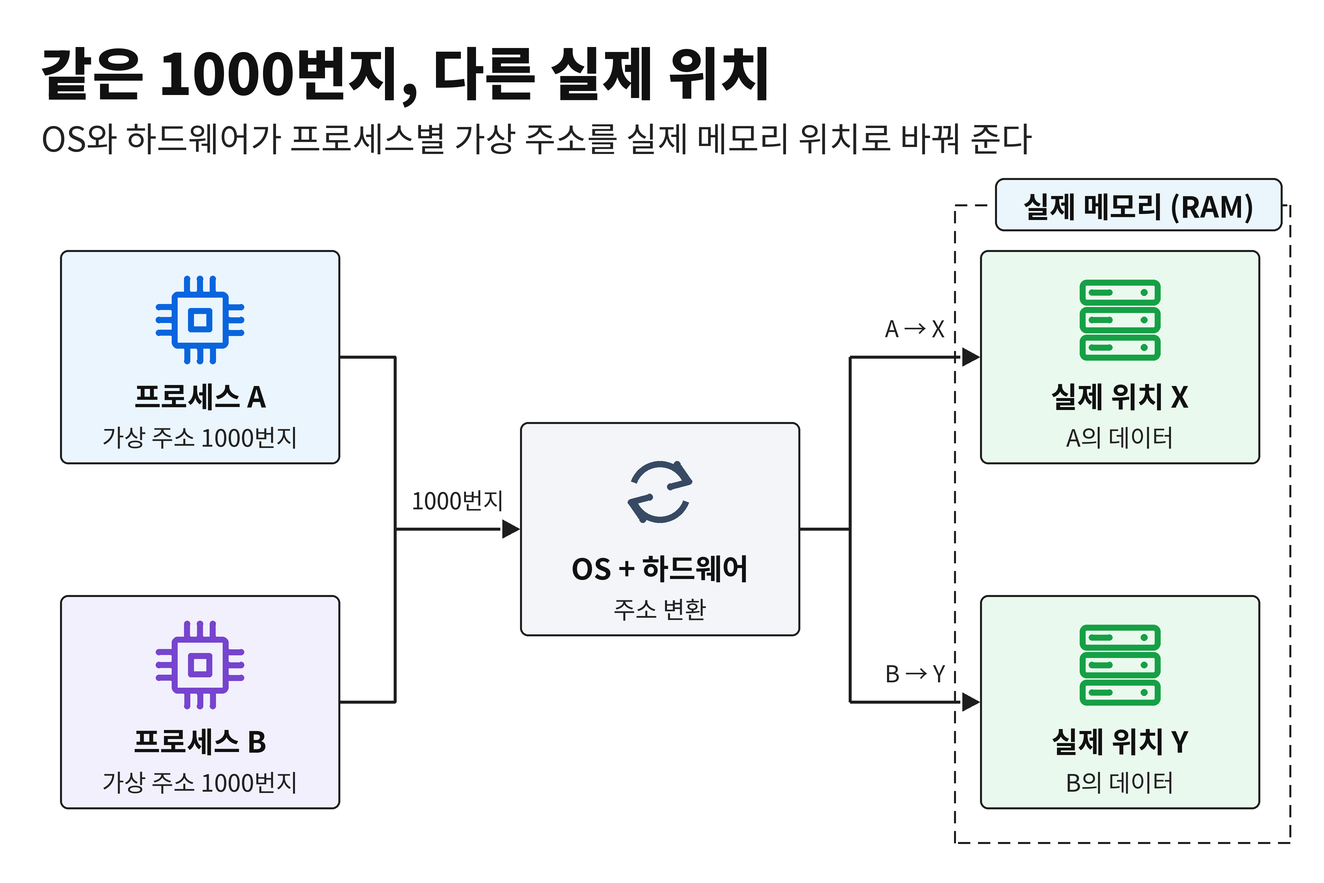
그 대신 프로세스끼리 데이터를 주고받으려면 IPC(Inter-Process Communication, 프로세스 간 통신)라는 별도 통로가 필요합니다. 파이프, 소켓, 공유 메모리 같은 방법이 있고, 모두 OS를 거쳐야 해서 번거롭습니다.
스레드: 실제로 실행되는 흐름
스레드는 프로세스 안에서 코드를 실제로 한 줄씩 실행하는 흐름입니다. 프로세스를 하나 만들면 기본으로 스레드도 하나(메인 스레드) 생기고, 필요하면 더 만들 수 있습니다.
한 프로세스 안의 스레드들은 코드, 데이터, 힙 영역을 함께 씁니다. 반대로 아래 세 가지는 스레드마다 따로 가집니다.
- 스택: 스레드마다 호출하는 함수가 다르니 지역 변수와 호출 기록도 따로 있어야 합니다.
- 레지스터: CPU(Central Processing Unit) 안의 아주 작고 빠른 저장 칸입니다. 계산 중인 값이 여기 들어 있습니다.
- PC(Program Counter): "다음에 실행할 명령어가 어디인지"를 가리키는 값입니다. 스레드마다 코드의 다른 줄을 실행하고 있으니 따로 있어야 합니다.
잠깐, 왜 스택만 따로일까요?
이 부분이 제일 헷갈렸습니다. 같은 코드를 실행하는데 왜 스택은 나눠야 할까요?
요리사 두 명이 한 주방(프로세스)에서 같은 요리책(코드)과 같은 냉장고(힙)를 쓴다고 생각해 보면 쉽습니다. 그런데 "지금 몇 번째 단계까지 했는지", "내 도마 위에 뭐가 있는지"까지 공유하면 서로 순서가 뒤엉킵니다. 그래서 각자 메모장(스택)과 지금 보고 있는 페이지(PC)는 따로 가지는 것입니다.
스택은 "지금 이 흐름이 어디까지 진행했는지"를 기록하는 곳이라 흐름마다 하나씩 있어야 합니다. 알고 나니 왜 스택만 따로인지 납득이 됐습니다.
그래서 스레드가 "가볍다"는 건 무슨 뜻일까?
스레드가 가볍다는 말은 크게 세 가지를 뜻합니다.
만들 때
새 프로세스를 만들면 OS가 새 주소 공간을 준비하고 관리 정보를 새로 꾸려야 합니다. 스레드는 이미 있는 주소 공간에 스택과 몇 가지 정보만 더하면 되니 준비할 게 훨씬 적습니다.
바꿀 때 (컨텍스트 스위칭)
CPU 코어 하나는 한 순간에 한 흐름만 실행합니다. 여러 프로그램이 동시에 도는 것처럼 보이는 건 OS가 아주 짧은 간격으로 실행 대상을 바꿔 주기 때문이고, 이 전환을 컨텍스트 스위칭(Context Switching)이라고 합니다.
전환할 때는 지금 흐름의 레지스터와 PC 값을 저장하고 다음 흐름의 값을 불러옵니다. 프로세스의 이런 정보는 PCB(Process Control Block)라는 관리 구조에 담깁니다.
여기서 차이가 생깁니다.
- 다른 프로세스로 바꿀 때: 주소 공간 자체가 바뀝니다. 그래서 가상 주소를 실제 주소로 바꾸던 정보도 갈아 끼워야 하고, 주소 변환을 빠르게 해 주던 TLB(Translation Lookaside Buffer, 주소 변환 캐시)나 CPU 캐시에 담긴 내용도 쓸모가 줄어듭니다.
- 같은 프로세스의 다른 스레드로 바꿀 때: 주소 공간이 그대로라 이런 작업이 필요 없습니다. 레지스터, PC, 스택 위치 정도만 바꾸면 됩니다.
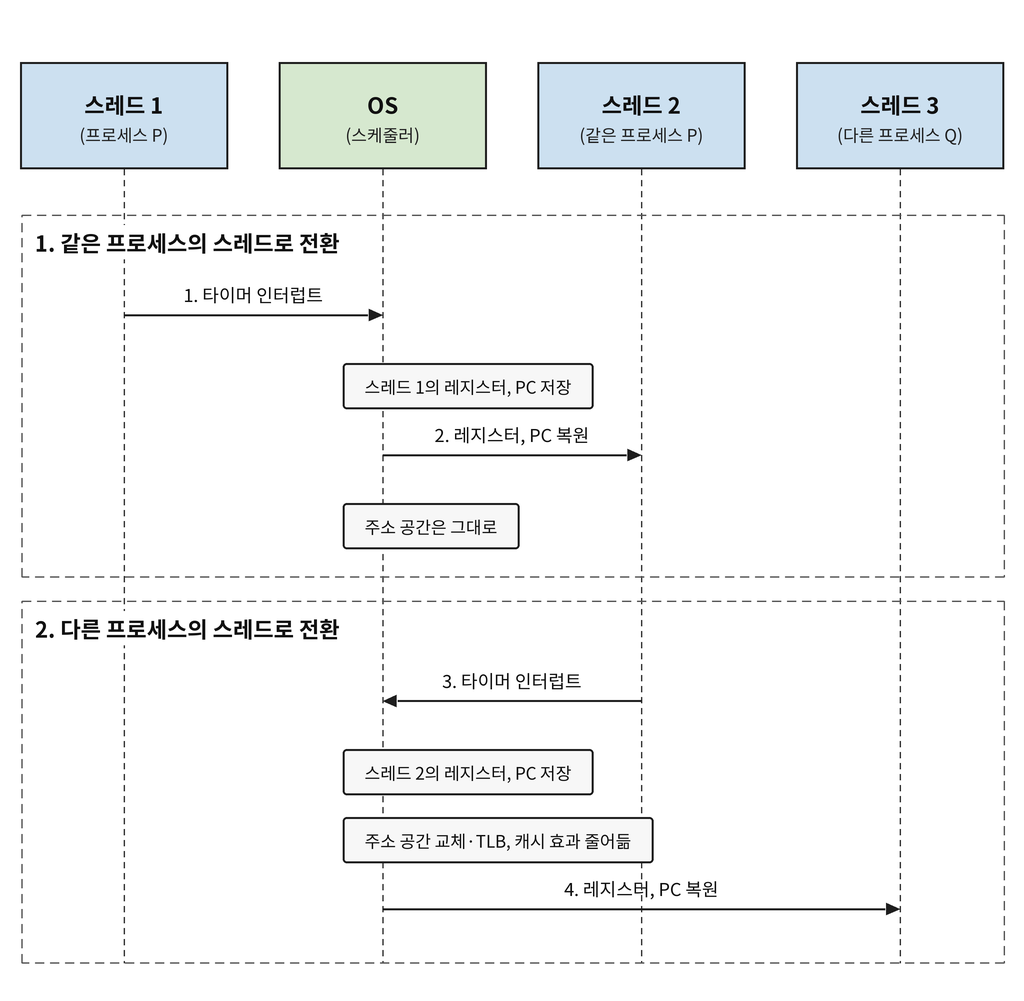
처음엔 "스레드 전환은 공짜"라고 오해했는데, 스레드 전환도 레지스터를 저장하고 불러오는 비용은 똑같이 듭니다. 주소 공간을 바꾸는 비용이 없을 뿐이라는 게 정확한 표현이었습니다. 이 주제는 다음 글에서 더 자세히 다뤄 보려 합니다.
통신할 때
스레드끼리는 같은 힙의 객체를 그냥 읽고 쓰면 되니 IPC가 필요 없습니다. 아주 편하지만, 바로 이 점이 스레드의 가장 큰 함정이기도 합니다.
공유한다는 건 양날의 검
같은 객체를 여러 스레드가 동시에 건드리면 결과가 꼬일 수 있습니다. 이걸 경쟁 상태(Race Condition)라고 합니다.
또 한 스레드가 공유 메모리를 망가뜨리거나 프로세스 전체를 죽이는 오류를 내면, 같은 프로세스의 다른 스레드도 함께 영향을 받습니다. 브라우저가 탭마다 프로세스를 나누는 방식을 쓰는 것도 이런 격리의 이점 때문입니다.
정리하면 선택 기준은 이렇게 볼 수 있습니다.
- 격리와 안정성이 중요하면 프로세스를 나눕니다.
- 빠른 공유와 적은 자원이 중요하면 스레드를 씁니다. 대신 동기화를 직접 신경 써야 합니다.
코드로 보기
두 스레드가 힙에 있는 객체 하나를 함께 고치는 Java 코드입니다.
public class Counter {
    private int count = 0;

    public void increment() {
        count++;
    }

    public int get() {
        return count;
    }
}

public class Main {
    public static void main(String[] args) throws InterruptedException {
        Counter counter = new Counter();            // 힙에 객체 하나

        Runnable task = () -> {
            for (int i = 0; i < 100_000; i++) {     // i 는 각 스레드의 스택에
                counter.increment();
            }
        };

        Thread t1 = new Thread(task);
        Thread t2 = new Thread(task);
        t1.start();
        t2.start();
        t1.join();
        t2.join();

        System.out.println(counter.get());          // 200000 이 아닐 수 있음
    }
}
new Counter(): 객체는 힙에 하나만 생깁니다. 두 스레드가 모두 이 객체를 가리킵니다.for (int i = 0; ...): 지역 변수i는 스레드마다 자기 스택에 따로 생깁니다. 그래서 두 스레드의 반복 횟수는 서로 섞이지 않습니다.t1.start(): 이 순간 새 스레드가 만들어지고task를 실행하기 시작합니다.run()을 직접 부르면 새 스레드 없이 메인 스레드에서 그냥 실행된다는 점이 헷갈리기 쉽습니다.t1.join(): 메인 스레드가t1이 끝날 때까지 기다리게 합니다. 이게 없으면 다 세기도 전에 결과를 출력합니다.count++: 한 줄처럼 보이지만 실제로는 "값 읽기, 1 더하기, 다시 쓰기" 세 단계입니다. 두 스레드가 같은 값을 동시에 읽고 각자 1을 더해 쓰면 한 번이 사라집니다.
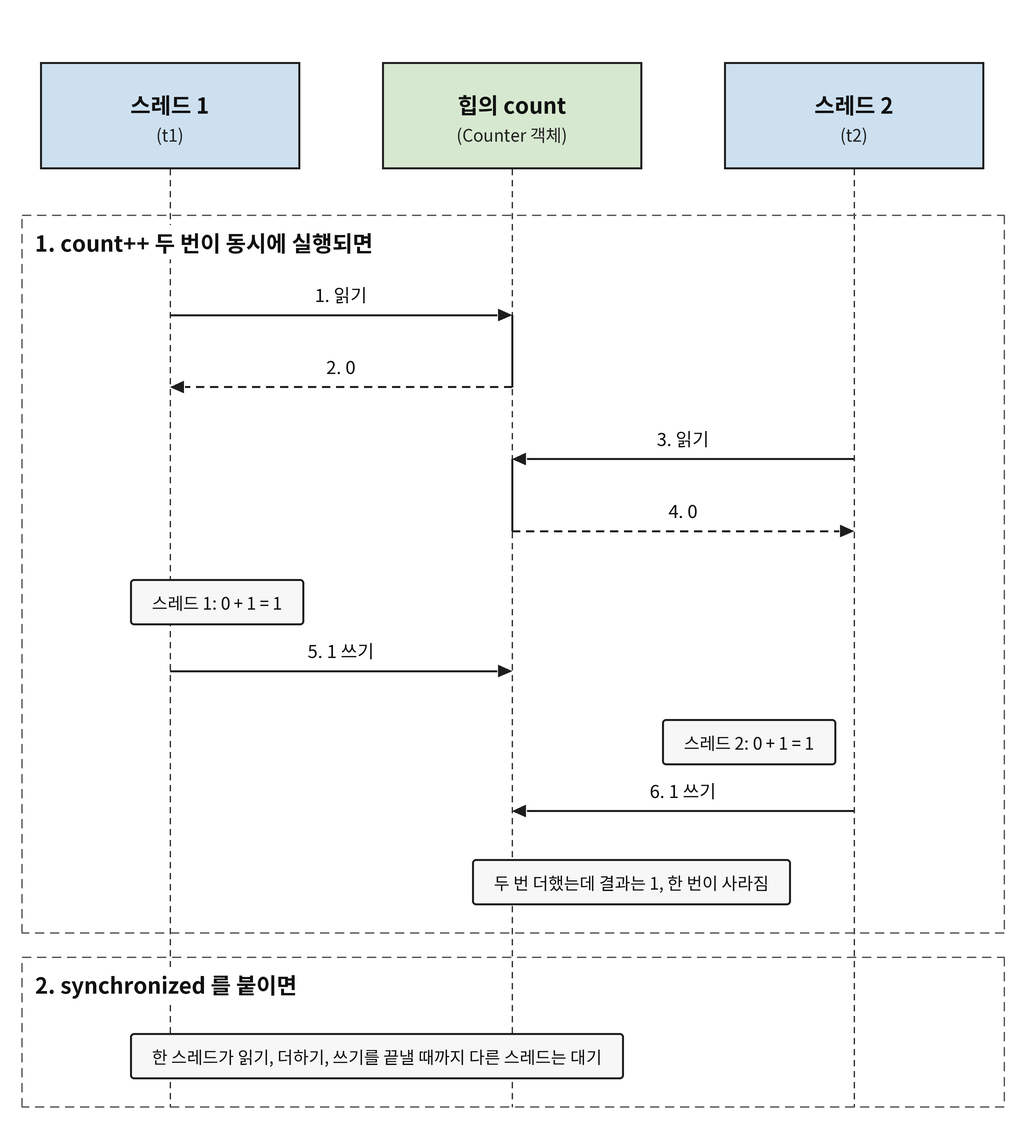
그래서 실행할 때마다 200000보다 작은 숫자가 나올 수 있습니다. increment()에 synchronized를 붙이거나 AtomicInteger를 쓰면 200000이 나옵니다. 숫자가 매번 다르게 찍히는 걸 보니 "공유는 위험하다"는 말이 확실히 와닿았습니다.
백엔드 개발자 입장에서 보면
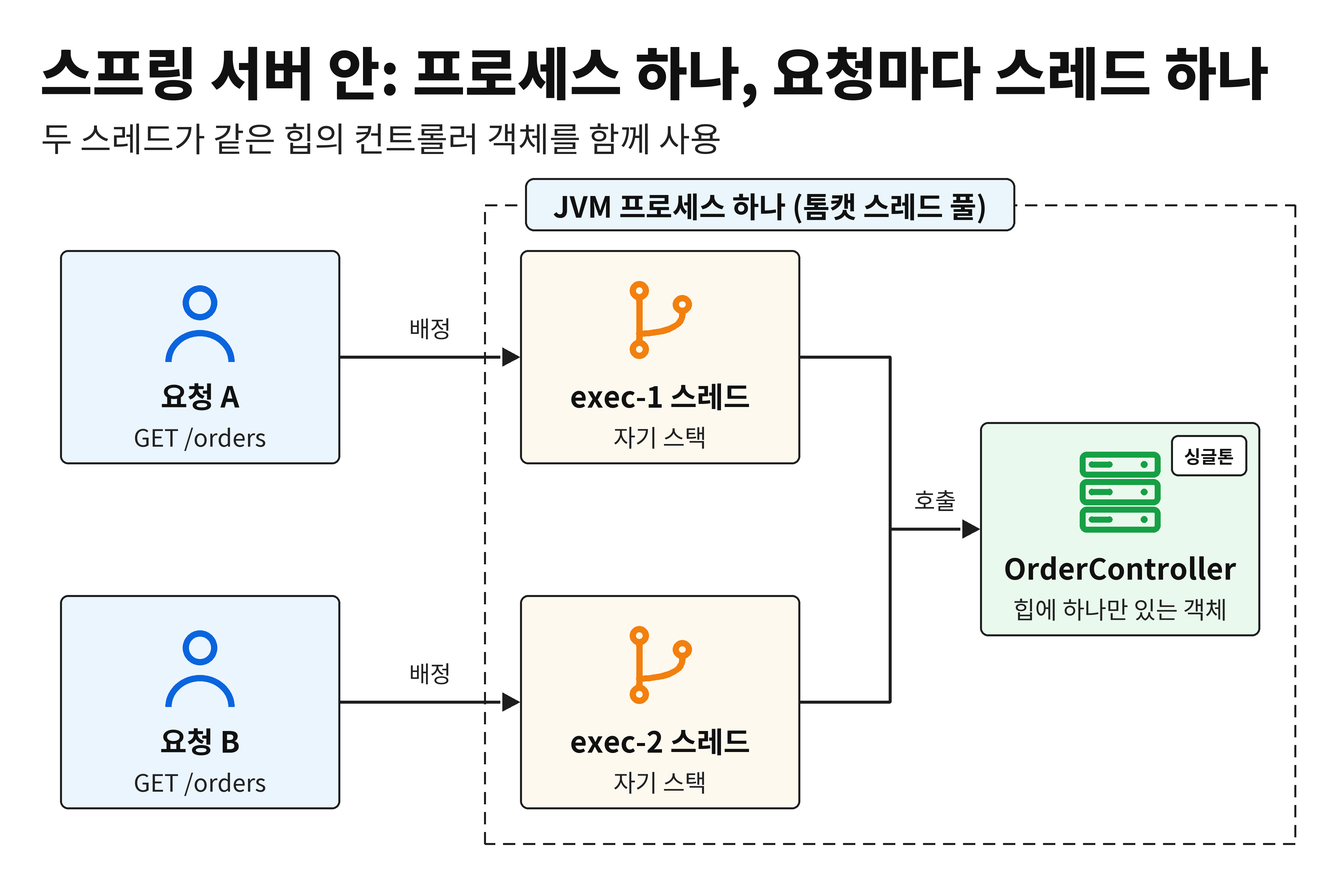
스프링 부트 서버를 실행하면 JVM(Java Virtual Machine) 프로세스가 하나 뜹니다. 그 안의 톰캣은 스레드 풀(Thread Pool)을 들고 있다가, 요청이 들어올 때마다 쉬고 있는 스레드 하나를 배정합니다. 스프링 부트의 톰캣 기본 최대 스레드 수는 200개입니다.
잠깐, 스레드 풀은 왜 쓸까요?
요청마다 스레드를 새로 만들고 버리면 만드는 비용이 계속 듭니다. 그래서 미리 일정 수의 스레드를 만들어 두고 돌려 쓰는데, 이걸 스레드 풀이라고 합니다. 식당이 손님 올 때마다 직원을 새로 뽑지 않고, 정해진 직원이 돌아가며 테이블을 맡는 것과 같습니다.
여기서 실무와 바로 연결되는 지점이 생깁니다.
- 컨트롤러와 서비스 객체는 보통 하나뿐입니다. 스프링 빈은 기본이 싱글톤이라 힙에 객체 하나를 두고 모든 요청 스레드가 함께 씁니다. 그래서 빈의 필드에 요청마다 달라지는 값(사용자 정보 등)을 저장하면, 다른 사용자의 요청과 값이 섞이는 사고가 납니다.
- 메서드 안의 지역 변수는 안전합니다. 지역 변수는 각 스레드의 스택에 따로 생기기 때문입니다. "빈은 상태를 갖지 않게 만들라"는 말이 바로 이 구조에서 나옵니다.
- 스레드는 공짜가 아닙니다. 스레드마다 스택 메모리가 필요해서 스레드 수를 무작정 늘리면 메모리와 전환 비용이 커집니다. 최근 Java 21에는 이 부담을 줄인 가상 스레드(Virtual Thread)도 정식으로 들어왔습니다.
직접 확인해 보기
실행 중인 서버가 프로세스 하나에 스레드 여러 개라는 걸 명령어로 볼 수 있습니다.
# 실행 중인 Java 프로세스와 PID 보기
jps -l

# 리눅스: 그 프로세스 안의 스레드 개수 보기
ps -o nlwp= -p <PID>

# 톰캣 요청 처리 스레드 이름만 보기
jstack <PID> | grep '"http-nio'
jps -l: JDK(Java Development Kit)에 들어 있는 도구로, 실행 중인 JVM 프로세스의 PID와 메인 클래스 이름을 보여 줍니다.ps -o nlwp= -p <PID>:nlwp는 그 프로세스에 속한 스레드 수입니다. 리눅스는 스레드를 경량 프로세스로 관리해서 이런 이름이 붙었습니다. 아무 요청이 없어도 숫자가 수십 개 나오는데, GC(Garbage Collection) 스레드처럼 JVM이 내부적으로 쓰는 스레드도 있기 때문입니다.jstack <PID>: 그 순간 모든 스레드의 이름과 상태, 호출 스택을 찍어 줍니다.http-nio-8080-exec-1같은 이름이 보이면 바로 요청을 처리하는 톰캣 스레드입니다.
스스로 점검해 보기
- Q. 프로세스와 스레드의 차이는 무엇인가요?
- 프로세스는 실행 중인 프로그램으로, OS에게 독립된 주소 공간과 자원을 받는 단위입니다. 스레드는 프로세스 안에서 실제로 코드를 실행하는 흐름으로, 같은 프로세스의 코드, 데이터, 힙 영역을 공유하고 스택과 레지스터, PC만 따로 가집니다. 그래서 스레드는 만들고 전환하고 통신하는 비용이 작지만, 공유 자원에 대한 동기화를 신경 써야 합니다.
- Q. 스레드마다 스택을 따로 가지는 이유는 무엇인가요?
- 스택에는 함수 호출 기록과 지역 변수가 쌓이는데, 스레드마다 실행 중인 함수와 진행 위치가 다르기 때문입니다. 스택을 공유하면 서로의 호출 기록이 뒤섞여 독립적으로 실행할 수 없습니다.
- Q. 스레드의 컨텍스트 스위칭이 프로세스보다 빠른 이유는 무엇인가요?
- 같은 프로세스의 스레드끼리는 주소 공간이 같아서, 전환할 때 주소 변환 정보를 바꾸거나 TLB를 비울 필요가 없기 때문입니다. 레지스터와 PC를 저장하고 복원하는 비용은 양쪽 모두 듭니다.
- Q. 멀티 프로세스 대신 멀티 스레드를 쓰면 어떤 문제가 생길 수 있나요?
- 여러 스레드가 같은 데이터를 동시에 고치면 경쟁 상태로 결과가 틀어질 수 있습니다. 또 한 스레드의 심각한 오류가 같은 프로세스 전체에 영향을 줄 수 있어서, 격리가 중요한 경우에는 프로세스를 나누는 편이 안전합니다.
- Q. 스프링 빈의 필드에 사용자별 값을 저장하면 왜 위험한가요?
- 빈은 기본이 싱글톤이라 힙에 하나만 있고, 요청마다 다른 스레드가 같은 객체를 함께 쓰기 때문입니다. 한 요청이 저장한 값을 다른 요청 스레드가 덮어쓰거나 읽을 수 있으므로, 요청별 값은 지역 변수나 매개변수로 다뤄야 합니다.
정리
- 프로세스는 독립된 주소 공간을 받는 실행 단위이고, 스레드는 그 안에서 코드, 데이터, 힙을 공유하며 스택, 레지스터, PC만 따로 가지는 실행 흐름입니다.
- 스레드는 주소 공간을 공유해서 만들고 전환하고 통신하는 비용이 작지만, 공유 자원 때문에 경쟁 상태와 장애 전파 위험이 있습니다.
- 스프링 서버는 JVM 프로세스 하나에서 요청마다 스레드를 배정하고, 싱글톤 빈을 함께 쓰기 때문에 빈은 상태를 갖지 않게 만들어야 합니다.
그러면 스레드에는 PCB가 없을까요?