학습 내용
- DataFrame 살펴보기
- DataFrame 변형하기
- DataFrame 병합하기
학습 목표
- Pandas를 활용하여 데이터를 처리하고 분석할 수 있다.
데이터 처리 및 분석
-
AI 모델링에서 가장 많은 시간 할애
-
AI 모델 성능에 중요한 영향
1. DataFrame 살펴보기
DataFrame
-
2차원(col과 row) 테이블 데이터 구조를 가진 자료형
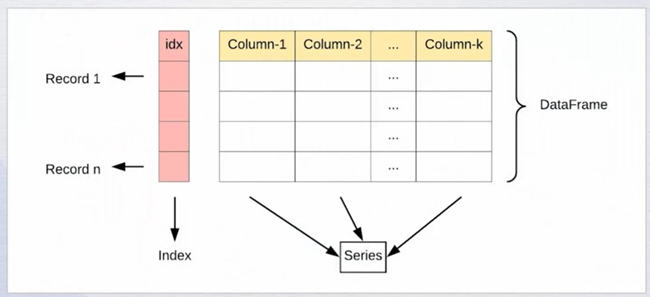
DataFrame 생성 방법
- 딕셔너리를 활용하여 DataFrame 생성
- 리스트를 활용하여 DataFrame 생성
- 파일을 읽어서 DataFrame 생성
파일을 읽어서 DataFrame 생성
- read_csv 파일을 읽어서 DataFrame 생성할 수 있음
→ pandas를 먼저 import 해야 함
문법 : dataFrame명 = pd.read_csv(파라미터)
- read_csv 함수의 파라미터
⊙ filepath or buffer : 파일 경로/파일이름.csv을 입력하여 파일을 불러옴
⊙ sep or delimiter : 초기값은 ,(comma)
⊙ encoding : 인코딩(utf8, cp949 등)
DataFrame의 head, tail
- 특정 변수에 제대로 데이터가 들어갔는지 확인하기 위해 사용
⊙ 문법: DataFrame.head(n=10) (기본은 5)
DataFrame 기본 함수 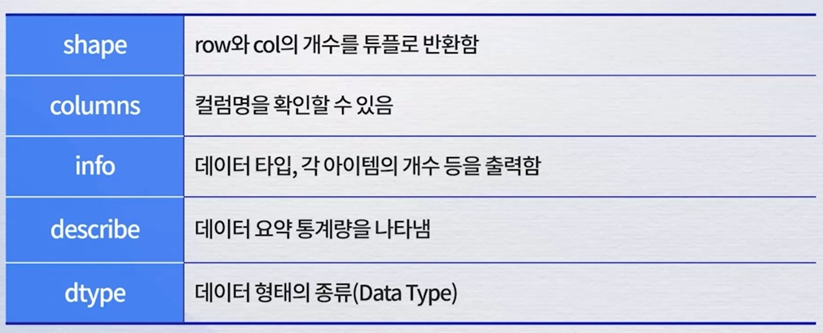
Data 조회
1) DataFrame에서 column 선택하기
- 기본적으로 []를 활용하여 column 추출
- 복수개의 column을 가지고 오고자 한다면 리스트 활용
2) DataFrame Sliicing
- 슬라이싱을 활용하여 row 레벨로 데이터를 가지고 올 수 있음
데이터를 가져오는 두 가지 방법
-
loc
⊙ 이름/라벨을 기준으로 슬라이싱, 인덱싱하는 경우 사용
⊙ DataFrame의 행이나 열에 label로 접근
⊙ location의 약자로 인간이 읽을 수 있는 label 값으로 데이터에 접근 -
iloc
⊙ 행 번호를 기준으로 슬라이싱, 인덱싱하는 경우 사용
⊙ DataFrame의 행이나 열에 인덱스 값으로 접근
⊙ integer location의 약자로 컴퓨터가 읽을 수 있는 인덱싱값으로 데이터에 접근
3) DataFrame column 추가/삭제하기
- column 삭제와 추가는 DataFrame을 가공하는 과정에서 빈번하게 발생함
<실습>
DataFrame 생성 방법
#pandas import
import pandas as pd
import numpy as np
# !pip install IPython
from IPython.display import Image
a1 = pd.DataFrame({"a":[1,2,3], "b":[4,5,6], "c":[7,8,9]}) a1a2 = pd.DataFrame([[1,2,3],[4,5,6],[7,8,9]],["a","b","c"]) a2
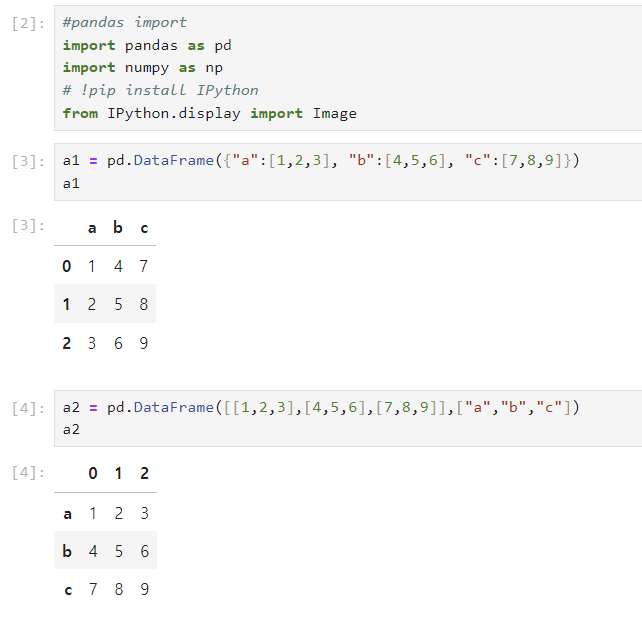
~~
2. DataFrame 변형하기
Group by
같은 값을 하나로 묶어서 통계 또는 집계 결과를 얻기 위해 사용하는 것
- 데이터 분할 (split)
- 적용 (applying)
- 데이터 병합 (combine)
pivot, pivot_table
DataFrame 형태를 변경하는 것
- pivot
⊙ pandas.pivot(index, columns, values) - pivot table
⊙ pandas.pivot_table (index, columns, values, aggfunc)
⊙ aggrefunction 함수를 활용하여 처리
pivot은 불가능하고 pivot table은 가능한 경우
- index가 2개 이상인 경우
- columns가 2개 이상인 경우
- 중복 값이 있는 경우

stack, unstack
DataFrame을 재구조화하기 위해 사용
-
stack
⊙ 컬럼 레벨에서 인덱스 레벨로 DataFrame 변경, 위에서 아래로 길게 쌓는 개념 -
unstack
⊙ 인덱스 레벨에서 컬럼레벨로 DataFrame 변경, 쌓은 것을 옆으로 늘어 놓는 개념
3. DataFrame 병합하기
concat / merge 함수
- 두 개 이상의 DataFrame을 하나로 합치는 경우에 사용
concat 함수
- 데이터 속성이 동일한 데이터 set 끼리 합치는 경우 사용
⊙ DataFrame을 단순히 합칠 때 사용 - 문법
pandas.concat(objs, axis=0,join='outer', ignore_index=False, keys=None, levels=None, names=None, verify_integrity=False, sort=False, copy=True)
merage 함수
- 두 DataFrame을 공통된 항목을 기준으로 합치는 것
⊙ inner left right outer - 문법
pandas.merge(left, fight, how='inner', on=None, left_on=None, right_on=None, left_index=False, right_index=False, sort=False, suffixes=('_x','_y'), copy=True, indicator=False, validate=None)
