🧩 핵심 기능과 부가 기능
애플리케이션 로직은 크게 두 가지로 나눌 수 있다.
-
핵심 기능: 해당 객체가 제공하는 고유의 기능이다. 예를 들어,
OrderService의 핵심 기능은 주문 로직이다. 이 객체가 존재하는 이유 그 자체다. -
부가 기능: 핵심 기능을 보조하기 위한 기능이다. 로그 추적, 트랜잭션, 실행 시간 측정 같은 것들이 여기에 속한다. 부가 기능은 단독으로 쓰이지 않는다. 로그 추적은 어떤 핵심 기능이 호출되었는지를 남기기 위해 존재하고, 트랜잭션은 핵심 기능을 하나의 작업 단위로 묶기 위해 존재한다. 이름 그대로 핵심 기능을 보조하기 위해 있는 것이다.
문제는 주문 로직을 실행하기 직전과 직후에 로그를 남겨야 한다면, 두 기능이 하나의 객체 안에 섞여 들어간다는 점이다. OrderService 코드를 보자.
public class OrderService {

    private final OrderRepository orderRepository;
    private final LogTrace trace;

    public void orderItem(String itemId) {
        TraceStatus status = null;

        try {
            status = trace.begin("OrderService.orderItem()");  // 부가 기능

            orderRepository.save(itemId);  // 핵심 기능 (단 한 줄!)

            trace.end(status);  // 부가 기능
        } catch (Exception e) {
            trace.exception(status, e);  // 부가 기능
            throw e;
        }
    }
}
핵심 기능은 orderRepository.save(itemId) 단 한 줄인데, 그걸 감싸는 부가 기능 코드가 훨씬 길다. 이 메서드만 봐서는 "주문을 처리한다" 는 본래 의도가 잘 보이지 않는다.
🕸️ 횡단 관심사 (Cross-Cutting Concerns)
더 큰 문제는 부가 기능이 보통 한 곳에만 필요한 게 아니라는 점이다. 만약 "모든 애플리케이션 호출을 로깅해 달라" 는 요구사항이 들어왔다고 해보자. 그러면 로그 추적 로직은 OrderController, OrderService, OrderRepository 전부에 들어가야 한다.
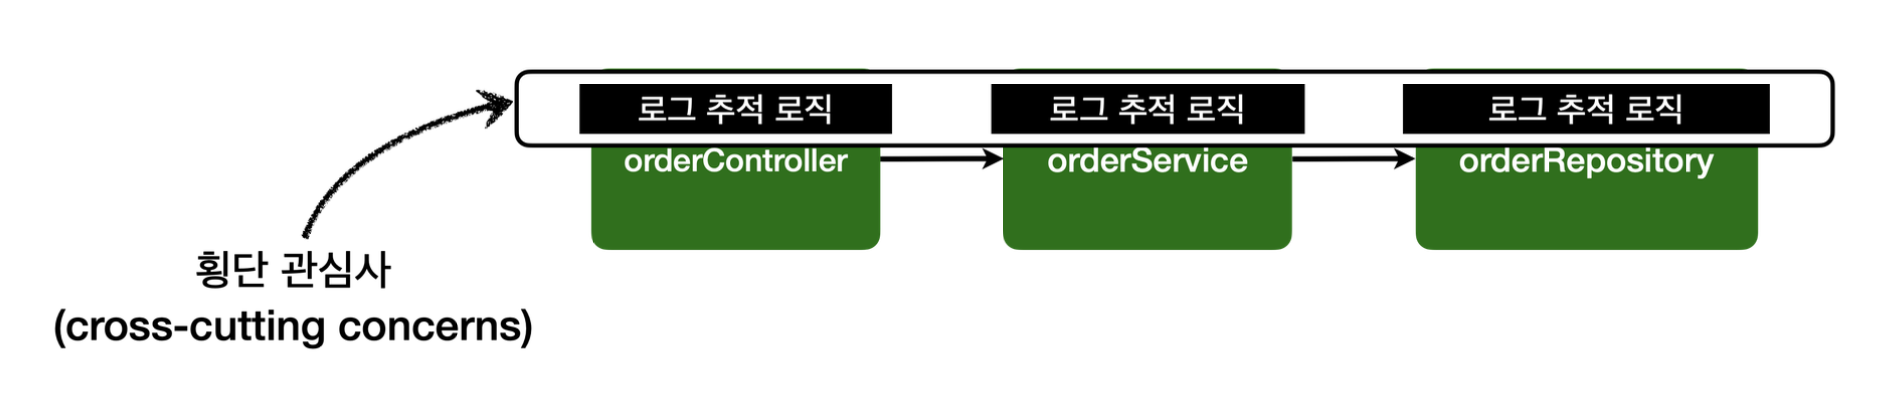
이렇게 하나의 부가 기능이 여러 클래스에 걸쳐 동일하게 사용되는 것을 횡단 관심사(Cross-Cutting Concerns)라고 한다.
하지만 부가 기능을 적용해야 할 클래스가 100개, 1000개, 그 이상이라면 어떻게 될까?
1. 아주 많은 반복이 필요: 100개 클래스에 동일한 코드를 100번 추가해야 한다.
2. 유틸리티 클래스로 빼도 근본적인 문제는 해결되지 않음: "그럼 로그 기능을 별도 클래스로 만들면 되지 않나?" 싶지만, 그 유틸리티를 호출하는 코드 역시 100군데 남을 것이다. 게다가 위 예제처럼 try ~ catch ~ finally 구조가 필요한 부가 기능이라면, 단순한 메서드 호출 한 줄로도 끝나지 않는다. 실행 시간 측정 같은 기능이 대표적이다.
3. 수정 지옥: 로그 형식을 바꿔야 한다면? 100개 클래스를 하나씩 찾아가며 고쳐야 한다.
4. 적용 대상을 바꾸는 것도 힘듦: 처음엔 컨트롤러 / 서비스 / 레포지토리 전부에 로그를 남겼는데, 로그가 너무 많아서 서비스 계층에만 남기는 것으로 바뀌었다면? 이번엔 컨트롤러와 리포지토리에서 해당 코드를 전부 걷어내야 한다.
| 문제 | 원인 |
|---|---|
| 아주 많은 반복 | 적용 대상마다 같은 코드를 넣어야 함 |
| 중복 코드 확산 | 부가 기능이 여러 클래스에 흩어짐 |
| 변경 시 대규모 수정 | 중복된 모든 지점을 고쳐야 함 |
| 적용 대상 변경 시 대규모 수정 | "어디에 적용할지" 가 코드 곳곳에 박혀 있음 |
소프트웨어 개발에서 변경 지점은 하나로 모듈화되어야 한다는 원칙이 있다. 그런데 부가 기능처럼 특정 로직을 애플리케이션 전반에 적용하는 문제는 일반적인 OOP 방식만으로는 깔끔하게 해결하기 어렵다.
💡 애스펙트(Aspect)의 등장
위와 같은 문제를 해결하기 위해 나온 아이디어는 단순하다.
“부가 기능을 핵심 기능에서 분리하고, 한 곳에서 관리하자. 그리고 그 부가 기능을 어디에 적용할지 선택하는 기능도 함께 만들자.”
이렇게 부가 기능과 그 부가 기능을 어디에 적용할지 정의한 것을 합쳐서 하나의 모듈로 만든 것이 바로 애스펙트(Aspect) 다. 예를 들면 "로그 출력 기능을, 모든 컨트롤러에 적용하라" 가 하나의 애스펙트다. 뭔가 익숙한 느낌이다. 이전에 직접 만들어본 LogTraceAspect가 바로 이것이다.
@Aspect
public class LogTraceAspect {

    @Around("execution(* com.example.advanced_spring.proxy..*(..))")  // 어디에 적용할지
    public Object execute(ProceedingJoinPoint joinPoint) throws Throwable {
        // 무엇을 적용할지 (로그 추적 로직)
    }
}
그리고 스프링의 어드바이저(Advisor)도 어드바이스(부가 기능)와 포인트컷(적용 대상)을 가지고 있으니, 개념상 하나의 애스펙트다.
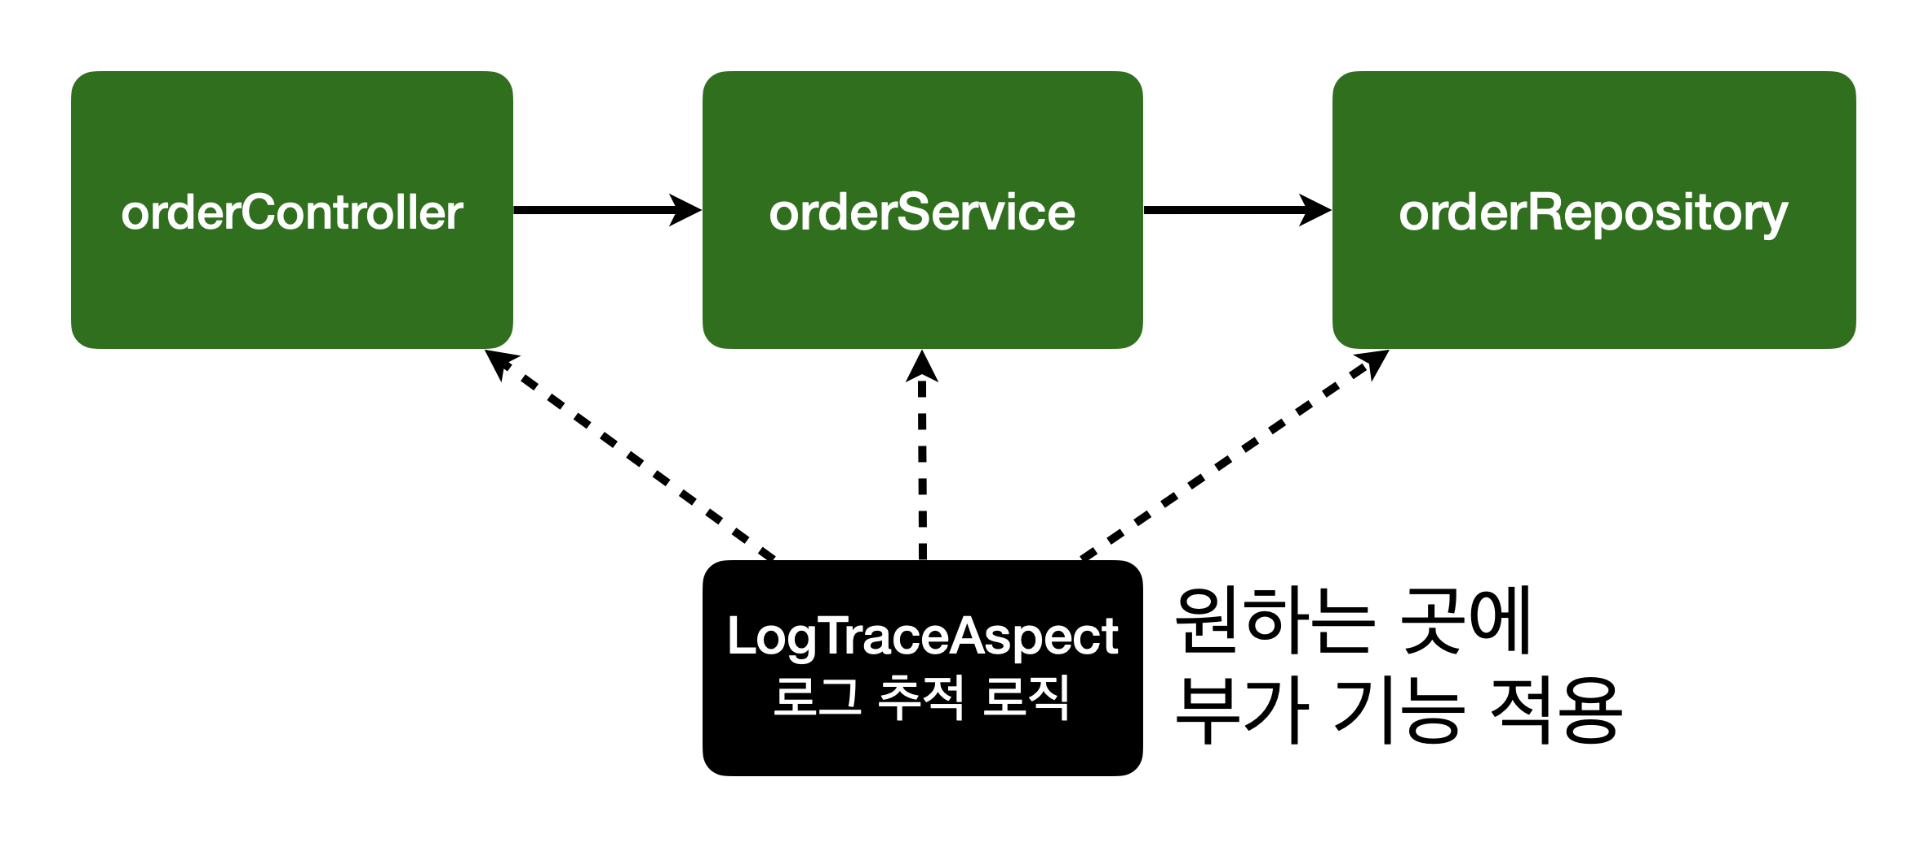
이제 핵심 기능 코드에는 로그 관련 코드가 한 줄도 없다. OrderService는 다시 주문 로직만 남는다.
public void orderItem(String itemId) {
    orderRepository.save(itemId);  // 핵심 기능만!
}
로그 형식을 바꾸고 싶으면 LogTraceAspect 하나만 고치면 되고, 적용 대상을 바꾸고 싶으면 포인트컷 표현식 하나만 고치면 된다. 앞서 본 네 가지 문제가 한 번에 해결된다.
🔭 관점 지향 프로그래밍 (AOP)
애스펙트(Aspect)는 우리말로 관점이다. 애플리케이션을 하나하나의 기능 단위로만 보던 시선에서, 횡단 관심사라는 관점으로 달리 보는 것이다. 이렇게 애스펙트를 사용한 프로그래밍 방식을 관점 지향 프로그래밍, AOP(Aspect-Oriented Programming)라고 한다.
여기서 꼭 짚고 넘어가야 할 점은, AOP는 OOP를 대체하기 위한 것이 아니라는 점이다. 횡단 관심사를 깔끔하게 처리하기 어려운 OOP의 부족한 부분을 보조하기 위해 개발되었다. 핵심 기능은 여전히 객체지향으로 설계한다. AOP는 그 위에서 여러 객체를 가로지르는 관심사만 따로 떼어내 관리하도록 돕는 도구라고 생각하면 된다.
🛠️ AspectJ 프레임워크와 스프링 AOP
AOP의 대표적인 구현체로 AspectJ 프레임워크가 있다. AspectJ는 스스로를 이렇게 소개한다.
- 자바 프로그래밍 언어에 대한 완벽한 관점 지향 확장
- 횡단 관심사의 깔끔한 모듈화
- 오류 검사 및 처리
- 동기화
- 성능 최적화(캐싱)
- 모니터링 및 로깅
스프링도 AOP를 지원하지만, 대부분 AspectJ의 문법을 차용하고 AspectJ가 제공하는 기능의 일부만 제공한다. 지금까지 써온 @Aspect, @Around, execution(...) 같은 표현식이 전부 AspectJ에서 온 것이다. 그렇다면 둘은 무엇이 다를까? 그 차이는 부가 기능을 언제, 어떻게 실제 코드에 붙이느냐에서 갈린다.
⏱️ AOP 적용 방식: 언제 부가 기능을 붙일 것인가
AOP를 쓰면 핵심 기능과 부가 기능이 코드상 완전히 분리된다. 그런데 결국 특정 시점에는 핵심 기능에 부가 기능이 결합된다는 말인데... 그렇다면 분리된 부가 기능은 어느 시점에 실제 로직에 추가되는 걸까?
크게 세 가지로 나눌 수 있다.
- 컴파일 시점
- 클래스 로딩 시점
- 런타임 시점(프록시)
그 전에 용어 하나만 짚고 가자. 원본 로직에 부가 기능 로직이 추가되는 것을 위빙(Weaving)이라고 한다. "옷감을 짜다, 직조하다" 라는 뜻으로, 애스펙트와 실제 코드를 엮어서 붙인다는 의미다.
1️⃣ 컴파일 시점 - 컴파일 타임 위빙
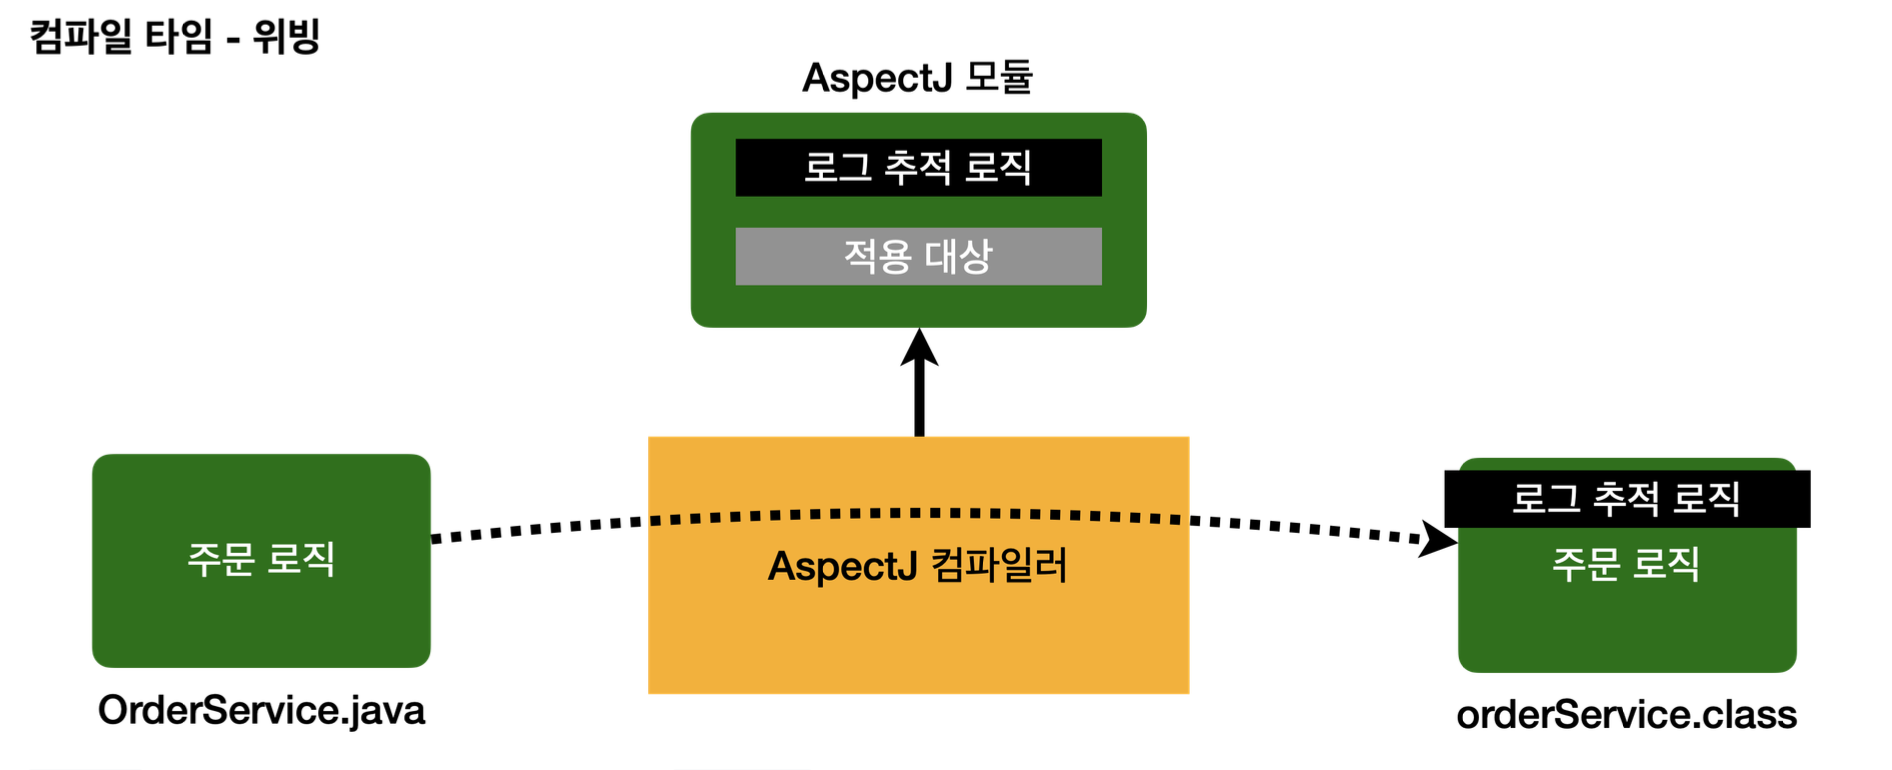
.java 소스 코드를 컴파일러로 .class로 만드는 시점에 부가 기능 로직을 추가하는 방식이다. 이때는 일반 javac가 아니라 AspectJ가 제공하는 특별한 컴파일러를 써야 한다.
AspectJ 컴파일러는 애스펙트를 확인해서 해당 클래스가 적용 대상인지 먼저 판단하고, 대상이라면 부가 기능 로직을 끼워 넣는다. 그래서 컴파일된 .class를 디컴파일해 보면 애스펙트 관련 호출 코드가 실제로 들어가 있다. 쉽게 말해 부가 기능 코드가 핵심 기능 코드 주변에 물리적으로 붙어 버리는 것이다.
단점: 특별한 컴파일러가 필요하고, 빌드 과정이 복잡해진다.
2️⃣ 클래스 로딩 시점 - 로드 타임 위빙
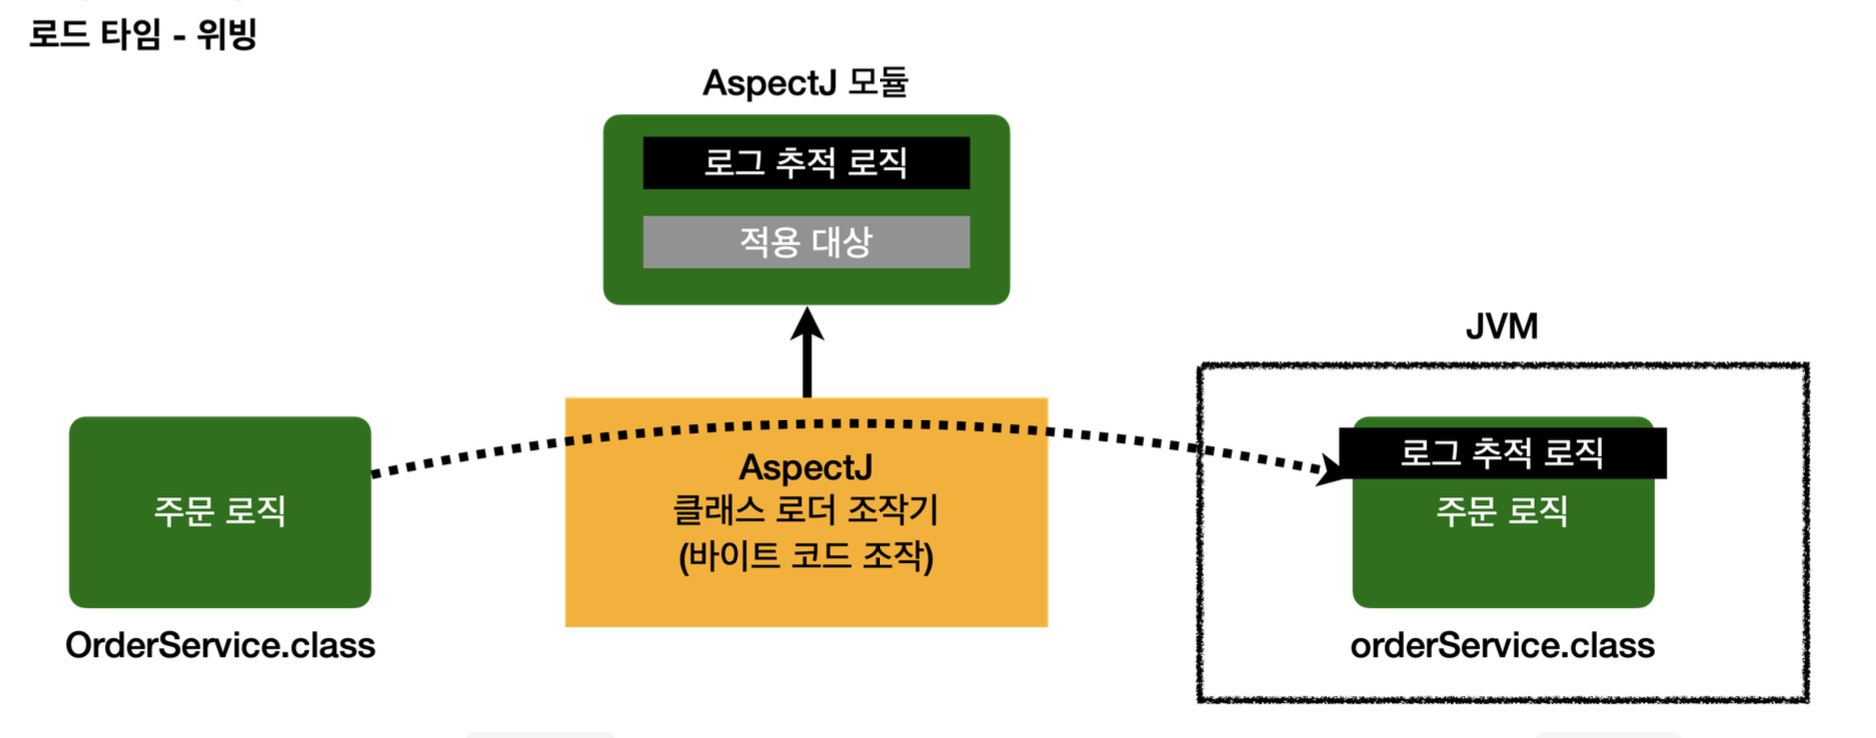
자바를 실행하면 클래스 로더가 .class 파일을 읽어 JVM에 올린다. 자바는 이렇게 JVM에 올리기 직전에 바이트코드를 조작할 수 있는 기능(Java Agent, java.lang.instrument)을 제공하는데, 이 틈을 이용해 바이트코드를 조작한 뒤 JVM에 올리는 방식이다. 이 시점에 애스펙트를 적용하는 것을 로드 타임 위빙이라 한다.
수많은 APM, 모니터링 툴이 바로 이 방식을 사용한다. 애플리케이션 코드를 한 줄도 건드리지 않고 메서드 실행 시간을 측정할 수 있는 비결이 여기에 있다.
단점: 자바를 실행할 때 java -javaagent 같은 특별한 옵션으로 클래스 로더 조작기를 지정해야 한다. 이 부분이 번거롭고 운영하기 어렵다.
3️⃣ 런타임 시점 - 프록시
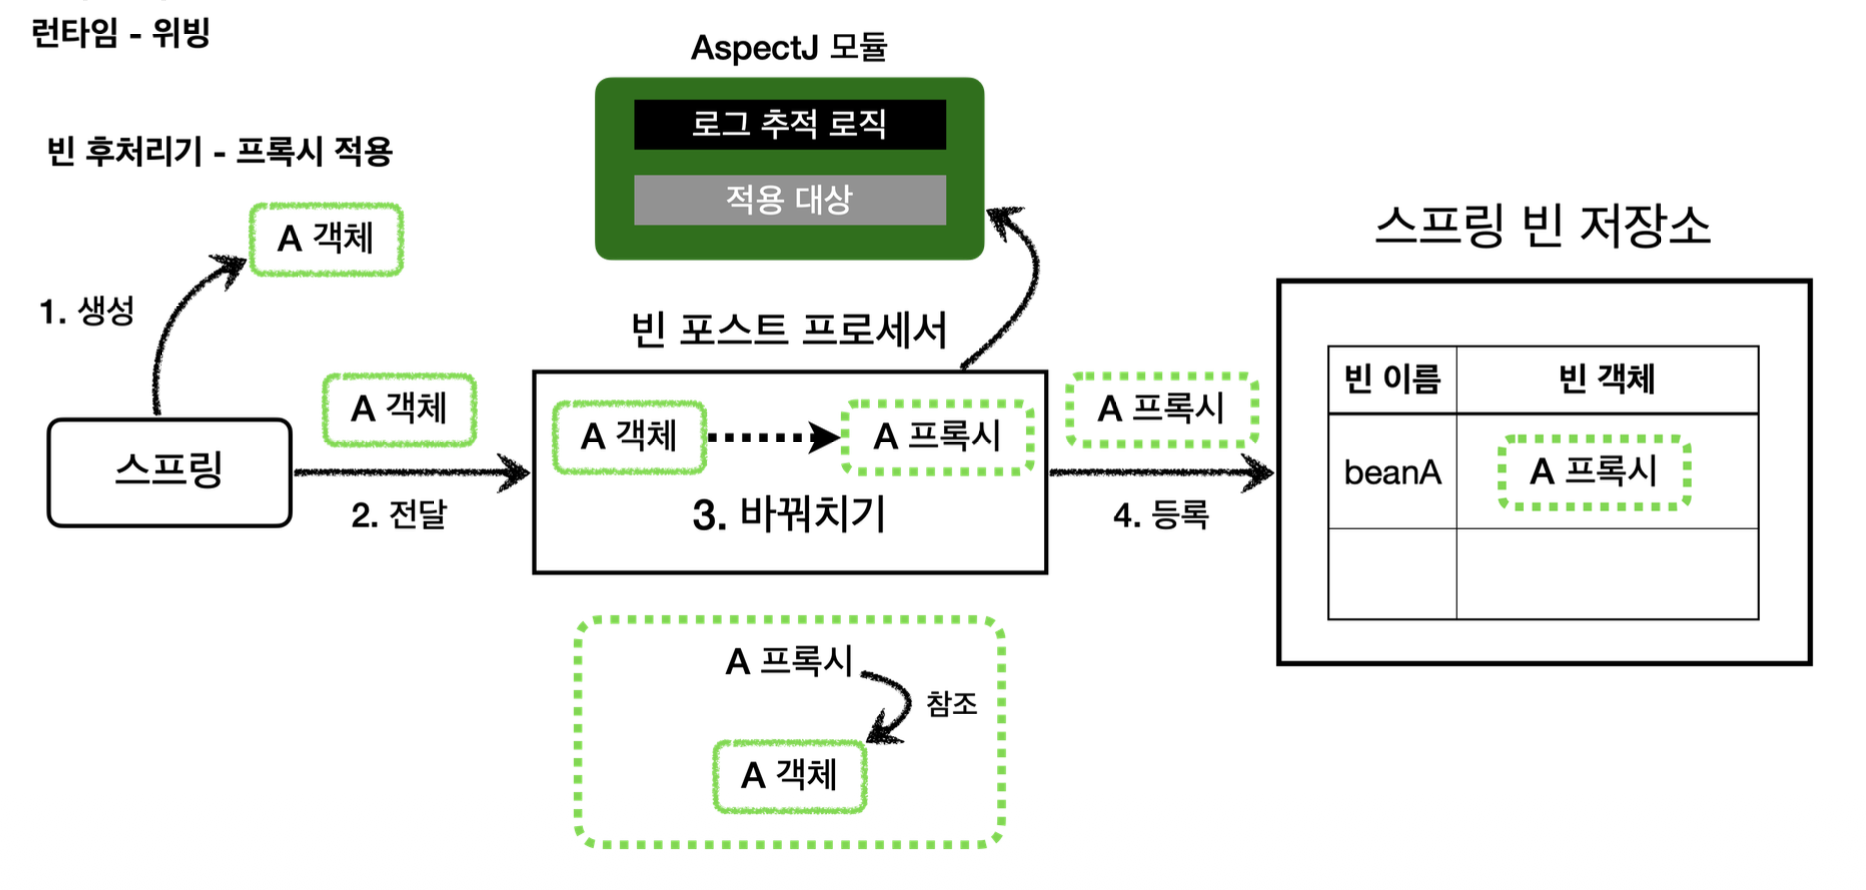
굉장히 익숙한 그림이다. 이전에 다룬 빈 후처리기의 동작 과정 그대로다.
런타임 시점은 컴파일도 다 끝나고, 클래스 로더에 클래스도 다 올라가서 이미 자바가 실행되고 난 다음(main 메서드가 실행된 이후)을 말한다. 바이트코드를 건드릴 수 없으니, 자바 언어가 허용하는 범위 안에서 부가 기능을 적용해야 한다.
그래서 스프링 같은 컨테이너의 도움을 받아 프록시, DI, 빈 포스트 프로세서 같은 개념을 총동원한다. 원본 객체 대신 부가 기능이 담긴 프록시를 스프링 빈으로 등록해 버리는 것이다. 그렇다. 지금까지 학습한 것이 바로 프록시 방식의 AOP였다.
장점: 특별한 컴파일러도, 복잡한 실행 옵션도, 클래스 로더 조작기도 필요 없다. 스프링만 있으면 된다.
단점: 프록시를 사용하기 때문에 AOP 기능에 일부 제약이 있다.
👀 세 가지 방식 한눈에 비교
| 구분 | 컴파일 시점 | 클래스 로딩 시점 | 런타임 시점 |
|---|---|---|---|
| 위빙 이름 | 컴파일 타임 위빙 | 로드 타임 위빙 | 런타임 위빙 |
| 방식 | AspectJ 컴파일러가 .class에 코드 삽입 | 클래스 로더 조작기가 바이트코드 조작 | 프록시를 빈으로 등록 |
| 실제 대상 코드 | 부가 기능 호출 코드가 포함됨 | 부가 기능 호출 코드가 포함됨 (메모리상 바이트코드) | 그대로 유지됨 |
| 필요한 것 | AspectJ 컴파일러(ajc) | AspectJ 위버, -javaagent 실행 옵션 | 스프링 컨테이너 |
| 사용하는 쪽 | AspectJ | AspectJ, 모니터링 툴 | 스프링 AOP |
📍 AOP 적용 위치: 조인 포인트와 스프링 AOP의 제약
AOP는 지금까지 다룬 메서드 실행 말고도 다양한 위치에 적용할 수 있다.
- 생성자 호출
- 필드 값 접근
- static 메서드 접근
- 메서드 실행
이렇게 AOP를 적용할 수 있는 지점을 조인 포인트(Join Point)라고 한다.
AspectJ를 써서 컴파일 시점이나 클래스 로딩 시점에 적용하는 AOP는 바이트코드를 실제로 조작하기 때문에, 위의 모든 지점에 다 적용할 수 있다.
반면 프록시 방식을 쓰는 스프링 AOP는 메서드 실행 지점에만 AOP를 적용할 수 있다. 왜일까?
프록시는 메서드 오버라이딩 개념으로 동작하기 때문이다. JDK 동적 프록시든 CGLIB이든, 결국 클라이언트가 호출한 메서드를 가로채서 부가 기능을 실행한 뒤 원본 메서드를 호출하는 구조다. 생성자나 static 메서드, 필드 값 접근은 오버라이딩으로 가로챌 방법이 없으니 프록시 개념이 적용될 수 없다.
같은 이유로 private 메서드에도 프록시 방식의 AOP는 적용되지 않는다. 특히 클래스를 상속해서 프록시를 만드는 CGLIB은 final 메서드도 오버라이딩할 수 없어서 가로채지 못한다. 스프링 부트는 기본으로 CGLIB 프록시를 사용하므로 이 부분을 주의해야 한다.
추가로, 프록시를 만들고 바꿔치기하는 주체가 스프링 컨테이너(빈 후처리기)이므로, 스프링 컨테이너가 관리하는 스프링 빈에만 AOP를 적용할 수 있다. new로 직접 만든 객체에는 적용되지 않는다. 꼭 기억하도록 하자.
스프링 AOP의 두 가지 제약
- 조인 포인트는 메서드 실행 지점으로 제한된다.
- 스프링 빈에만 적용할 수 있다.
참고로 이 제약은 실무에서 꽤 자주 마주친다. 대표적인 것이 같은 객체 안에서 자기 메서드를 호출하는 경우(this.method())인데, 이때는 프록시를 거치지 않고 원본 객체의 메서드를 직접 부르기 때문에 부가 기능이 적용되지 않는다. @Transactional이나 @Async를 붙였는데 동작하지 않는 대표적인 원인이기도 하다.
실제 프로젝트에서 같은 클래스 안의
@Async메서드를 내부 호출해서 비동기가 동작하지 않았고, 호출하는 쪽과@Async메서드를 서로 다른 빈으로 분리해 해결했다.
관련 PR: https://github.com/kb-final/nagasseum-cheongnyeon_backend/pull/44
🤔 그럼 기능이 더 많은 AspectJ를 직접 쓰는 게 낫지 않을까?
AspectJ를 쓰려면 공부할 내용도 많고, 특별한 컴파일러, AspectJ 전용 문법, 자바 실행 옵션 등 설정도 복잡하다.
반면 스프링 AOP는 별도의 추가 자바 설정 없이 스프링만 있으면 편리하게 AOP를 사용할 수 있다. 그리고 실무에서 필요한 부가 기능(로깅, 트랜잭션, 실행 시간 측정 등)은 대부분 스프링 빈의 메서드 실행 지점만으로 충분하다. 스프링이 제공하는 AOP 기능만으로도 대부분의 문제를 해결할 수 있으니, 스프링 AOP에 집중하는 것이 효율적이다.
참고로 스프링은 AspectJ의 문법을 차용하고, 실제 적용은 프록시 방식으로 한다. @Aspect를 쓴다고 해서 AspectJ 컴파일러가 동작하는 게 아니다. 이전에도 살펴본 것처럼, 자동 프록시 생성기가 @Aspect를 읽어 어드바이저로 변환한 뒤 프록시를 만드는 것이다.
📚 AOP 용어 정리
AOP 용어는 서로 얽혀 있어서 하나씩 외우면 금방 헷갈린다. 각 용어의 역할과 관계를 중심으로, 이전 글의 LogTraceAspect 코드에 대입하며 정리해 보자.
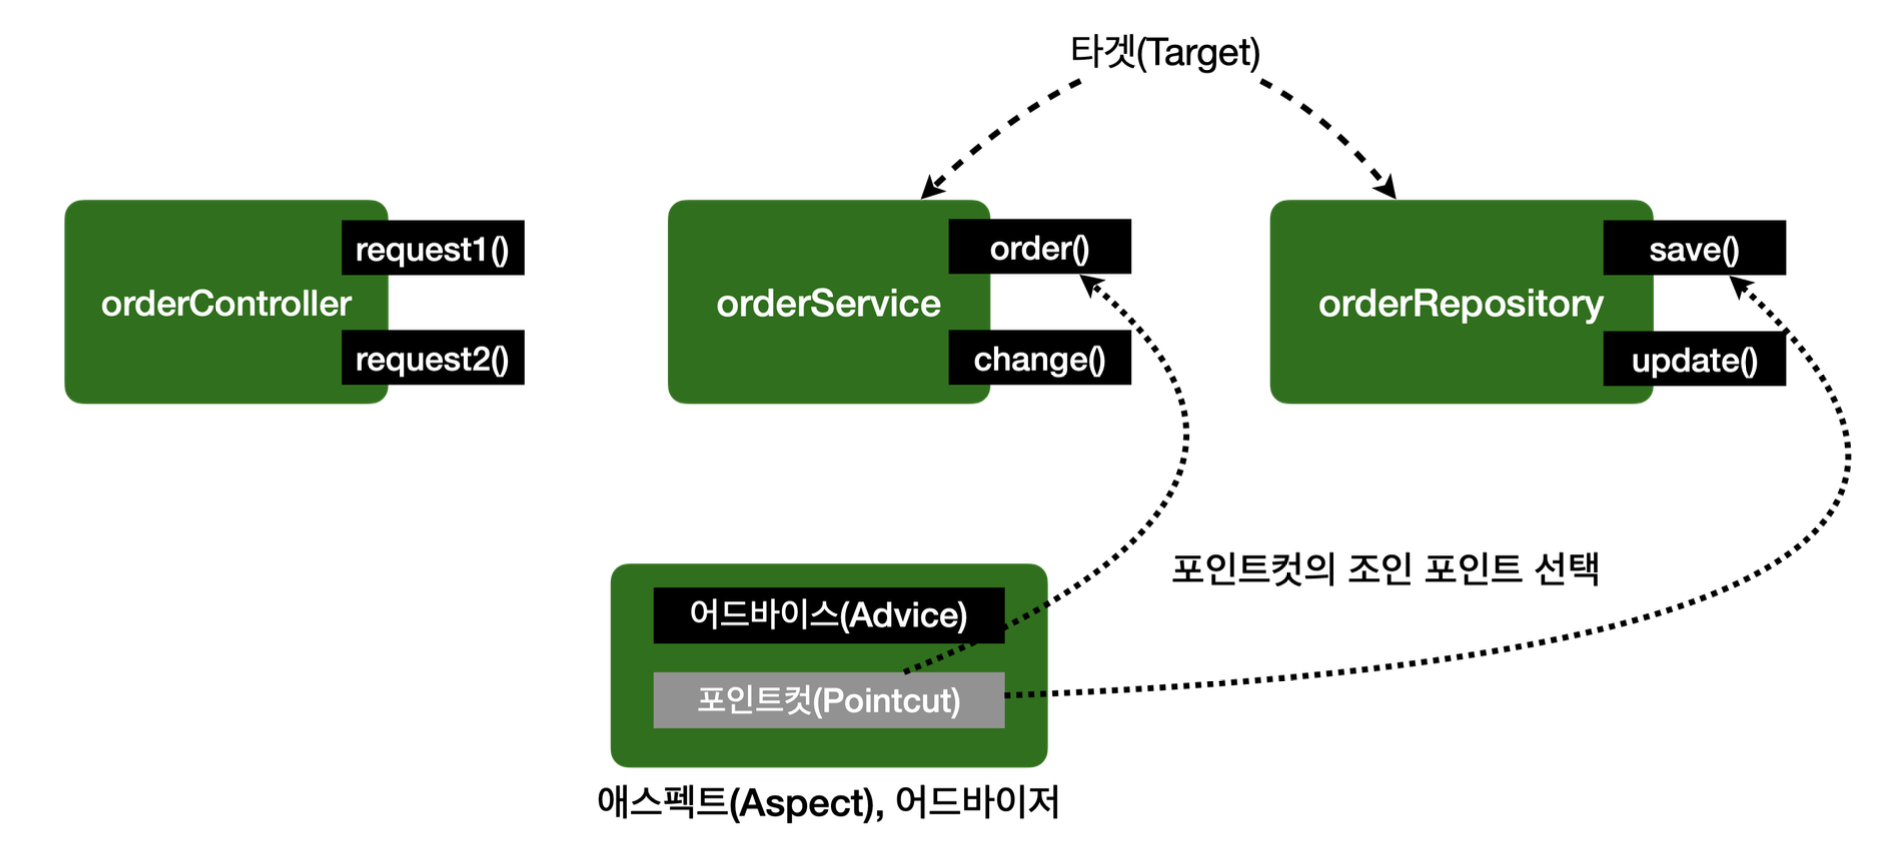
🍯 조인 포인트 (Join Point)
-
어드바이스가 적용될 수 있는 위치. 메서드 실행, 생성자 호출, 필드 값 접근, static 메서드 접근 같은 프로그램 실행 중의 지점이다.
-
추상적인 개념으로, AOP를 적용할 수 있는 모든 지점이라고 생각하면 된다.
-
스프링 AOP는 프록시 방식이므로 조인 포인트는 항상 메서드 실행 지점으로 제한된다.
-
코드에서는
ProceedingJoinPoint joinPoint파라미터가 바로 현재 실행 중인 조인 포인트의 정보(호출 대상, 인자, 메서드 시그니처)를 담고 있다.
🔍 포인트컷 (Pointcut)
-
조인 포인트 중에서 어드바이스가 실제로 적용될 위치를 선별하는 기능이다.
-
주로 AspectJ 표현식으로 지정한다. 코드에서는
@Around("execution(* ...proxy..*(..))")의 표현식 부분이다. -
프록시를 쓰는 스프링 AOP는 메서드 실행 지점만 선별할 수 있다.
🎯 타겟 (Target)
-
어드바이스를 받는 객체, 즉 부가 기능이 적용되는 원본 객체다.
-
포인트컷에 의해 결정된다. 위 그림에서
orderService,orderRepository가 타겟이다.
🛠️ 어드바이스 (Advice)
-
부가 기능 그 자체다. 특정 조인 포인트에서 애스펙트에 의해 취해지는 조치다.
-
Around(주변),Before(전),After(후) 등 다양한 종류가 있다. -
코드에서는
@Around가 붙은execute()메서드 안의 로그 추적 로직이다.
🍱 애스펙트 (Aspect)
-
어드바이스 + 포인트컷을 모듈화한 것이다.
-
@Aspect를 떠올리면 된다. 하나의 애스펙트 안에 여러 어드바이스와 포인트컷이 함께 존재할 수 있다.
🎏 어드바이저 (Advisor)
-
하나의 어드바이스와 하나의 포인트컷으로 구성된다.
-
스프링 AOP에서만 쓰이는 특별한 용어다. 이전에 살펴본
DefaultPointcutAdvisor가 바로 이것이다. -
애스펙트가 여러 쌍을 담을 수 있는 큰 모듈이라면, 어드바이저는 딱 한 쌍만 담은 가장 작은 단위의 애스펙트라고 보면 된다. 그래서 자동 프록시 생성기가
@Aspect를 읽으면, 그 안의 어드바이스, 포인트컷 쌍마다 어드바이저를 하나씩 만들어 내는 것이다.
🧶 위빙 (Weaving)
-
포인트컷으로 결정한 타겟의 조인 포인트에 어드바이스를 적용하는 것이다.
-
위빙 덕분에 핵심 기능 코드에 영향을 주지 않고 부가 기능을 추가할 수 있다.
-
앞서 본 세 시점(컴파일 타임 / 로드 타임 / 런타임)에 수행할 수 있고, 스프링 AOP는 런타임에 프록시 방식으로 위빙한다.
🤖 AOP 프록시
-
AOP 기능을 구현하기 위해 만든 프록시 객체다.
-
스프링에서 AOP 프록시는 JDK 동적 프록시 또는 CGLIB 프록시다. 이전에 실행 로그에서
jdk.proxy2.$Proxy54,...$$SpringCGLIB$$0으로 찍혔던 그 객체들이다.
@Aspect  // 애스펙트
public class LogTraceAspect {

    @Around("execution(* com.example.advanced_spring.proxy..*(..))")  // 포인트컷
    public Object execute(ProceedingJoinPoint joinPoint)  // 조인 포인트 정보
            throws Throwable {
        TraceStatus status = null;

        try {
        	// ── 어드바이스(부가 기능) 시작 ──
            status = logTrace.begin(joinPoint.getSignature().toShortString());

            Object result = joinPoint.proceed();  // 타겟 호출

            logTrace.end(status);

            return result;
        } catch (Exception e) {
            logTrace.exception(status, e);
            throw e;
            // ── 어드바이스 끝 ──
        }
    }
}joinPoint.proceed()가 호출하는 실제 객체가 타겟이고, 이 모든 것을 엮어 프록시로 만들어 빈으로 등록하는 과정이 위빙, 그 결과물이 AOP 프록시다.