AI Agent의 운영 관리는 일반 애플리케이션과 어떻게 다를까??
배경
애플리케이션이 단순한 데모로 끝나지 않고 실제 사용자가 사용하는 하나의 제품이 되려면 개발 단계만큼이나 운영 단계가 중요하다.
서비스를 운영하다 보면 개발 과정에서는 예상하지 못했던 에러가 발생하고, 특정 요청만 느려지거나, 외부 시스템과의 연동이 실패하기도 한다. 이런 문제를 빠르게 발견하고 원인을 정확히 파악하려면 APM과 Log를 비롯한 Observability 확보가 필수적이다.
사람이 하던 일을 대신하는 AI Agent도 결국 하나의 애플리케이션이다. 실제 사용자의 요청을 받아 업무를 수행하고 결과를 제공한다는 점에서 안정적인 운영과 Observability가 중요한 것은 일반 애플리케이션과 다르지 않다.
다만 AI Agent는 전통적인 애플리케이션처럼 정해진 요청을 처리하고 응답을 반환하는 단순한 구조가 아니다.
Agent는 목표를 달성하기 위해 스스로 다음 행동을 판단하고, Tool을 호출하고, 그 결과를 다시 판단에 활용하는 과정을 반복한다. 하나의 요청 안에서도 여러 단계가 루프를 이루며 실행될 수 있기 때문에 무엇을, 어디에서, 어떻게 관측해야 효과적으로 운영할 수 있을지 고민이 필요하다.
이 주제에서 가장 많이 등장하는 표현 중 하나가 “Agents fail silently”, 즉 Agent는 조용히 실패한다는 말이다.그런데 조용히 실패한다는 것은 구체적으로 무슨 뜻일까?
오늘은 Agent의 실행 방식과 실패의 특성을 살펴보면서 일반 애플리케이션의 모니터링과 무엇이 다른지, 그리고 Agent를 효과적으로 관측하려면 어떤 신호가 필요한지 이야기해보고자 한다.
AI Agent를 만들거나 계획 중인 분들께 도움이 되었으면 좋겠다!
Application Performance Monitoring
전통적인 애플리케이션 모니터링에서는 주로 요청의 상태를 본다. 대표적으로 아래와 같은 값들이 있다
- HTTP Error
- Latency
- Error Span
- 요청 처리량
예를 들어 날씨 API가 외부 기관에서 데이터를 가져온다고 해보자.
GET /weather/weekly
└─ GET weather upstream
외부 날씨 제공 기관이 정해진 시간 안에 응답하지 않으면 upstream 요청에서 Timeout이 발생한다. 서버는 사용자에게 504 Gateway Timeout을 반환하고 Trace에는 Error Span이 기록된다.
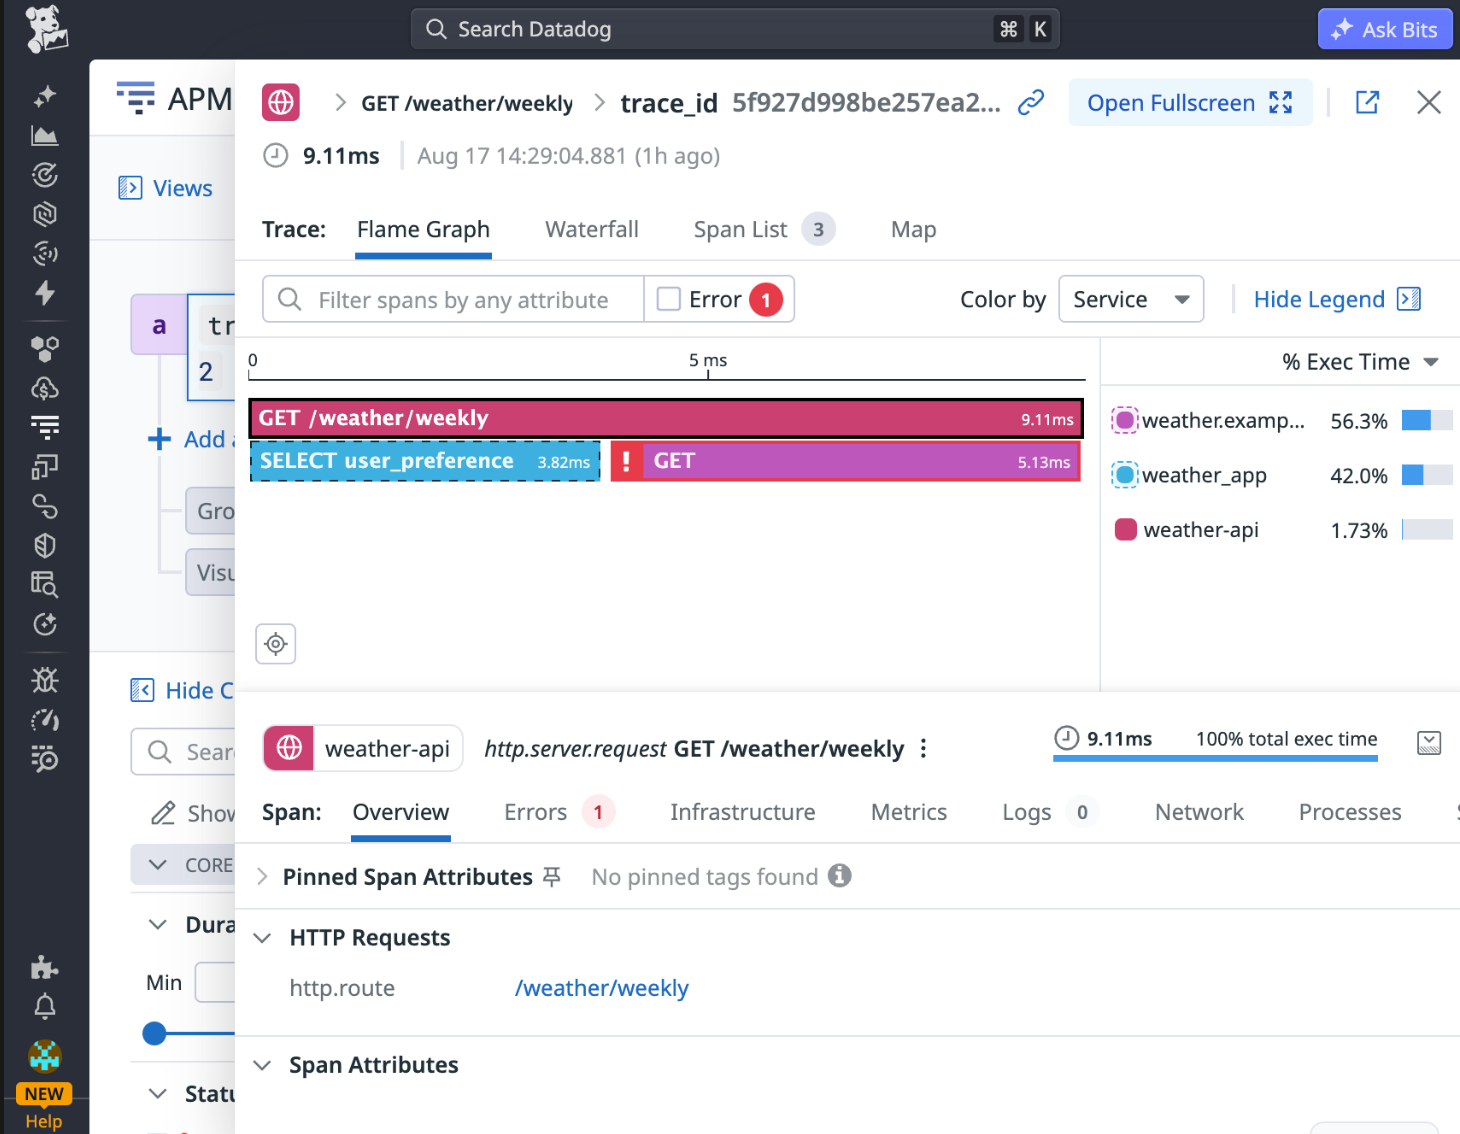
이 경우 이런 Tracing만 해두면 어디가 문제가되는지 꽤나 명확하다!
Latency가 평소보다 증가하고, HTTP 5xx가 발생하고, Error Span도 증가한다. 로그에도 TimeoutError가 남을 가능성이 높다. 모니터링 시스템은 이런 변화를 감지해서 알람을 보낼 수 있다.
정상 요청 → HTTP 200, Error Span 없음
실패 요청 → HTTP 5xx, Error Span 발생
물론 일반 Application도 HTTP 200을 반환하고 비즈니스 로직이 틀리는 경우가 있다. 따라서 모든 애플리케이션의 성공과 실패가 항상 2분법적으로 나뉘는 것은 아니다.
다만 전통적인 앱에서 발생하는 대표적인 기술적 실패는 Error와 Latency라는 신호로 비교적 명확하게 드러난다. 그래서 Fail Loudly라고 표현한다 ㅎㅎ,,
Agent Monitoring
AI Agent가 작업을 하다가 실패하면 어떨까?
Agent는 사용자가 준 목표를 달성하기 위해 스스로 여러 작업을 선택하고 실행한다.
예를 들어 사용자가 아래와 같이 요청했다고 해보자.
다음주 날씨를 조사해줘.
Agent는 이 짧은 요청을 처리하기 위해 여러 단계를 거칠 수 있다.
- 사용자의 요청과 언어를 이해한다.
- 어느 지역의 날씨가 필요한지 판단한다.
- 적절한 날씨 제공 기관을 선택한다.
- Tool을 사용해 날씨 정보를 가져온다.
- 수집한 자료를 정리한다.
- 사용자에게 전달할 최종 답변을 만든다.
이는 일반적으로 사람이 조사 업무를 수행하는 과정과 비슷하다.
사람도 질문을 이해하고, 필요한 자료가 무엇인지 판단하고, 자료를 찾고, 여러 내용을 수합한 다음 최종 의견을 만든다. Agent의 작업도 본질적으로 이와 비슷하다고 볼 수 있다.그래서 Agent를 모니터링할 때는 HTTP 요청 하나만 보는 것으로는 부족하다.
Agent가 어떤 판단을 했는지, 어떤 Workflow를 거쳤는지, 어떤 Tool을 선택했고 어떤 결과를 받았는지까지 함께 봐야한다.
그렇다면 Agent 내부의 여러 작업을 어떻게 구분할 수 있을까?
GenAI Semantic Convention
Agent의 작업을 구분하기위한 표준 방법으로 지난 글에서 살펴본 OpenTelemetry의 Semantic Convention을 사용할 수 있다. OpenTelemetry의 GenAI Semantic Convention에서는 gen_ai.operation.name 속성을 사용해 각 Span이 어떤 작업을 나타내는지 표현한다.
아래 사진을 보자
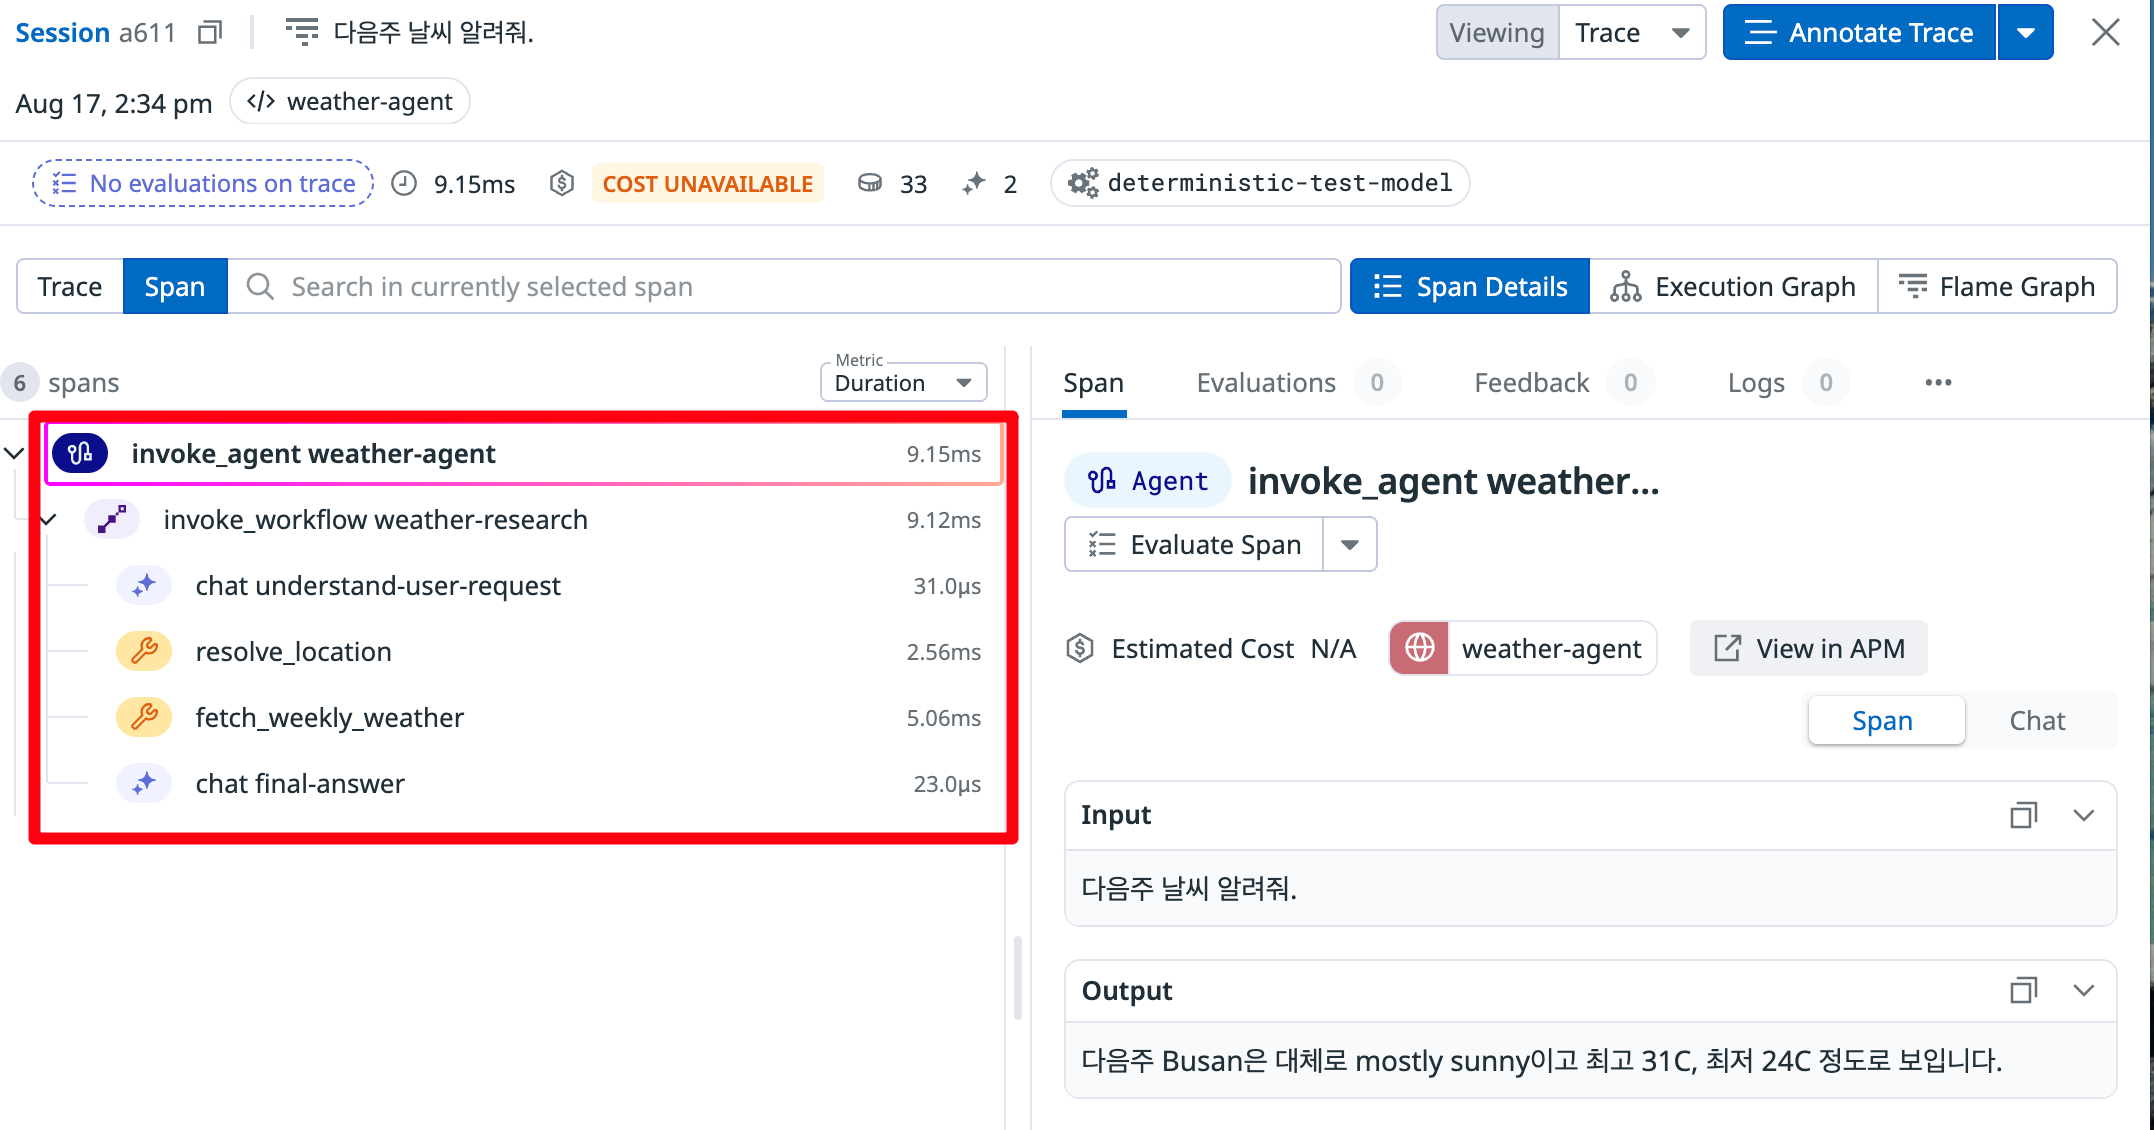
여기에 나타난 Agent의 작업은 아래 6가지이다
- invoke_agent: Agent 실행
- invoke_workflow: 여러 단계로 구성된 Workflow 실행
- execute_tool: 외부 Tool 실행
- chat: LLM 요청
- embeddings: Embedding 생성
- retrieval: 관련 문서 검색
그래서 사진처럼 날씨 Agent의 Trace는 아래와 같이 구성된다
POST /agent/weather
└─ invoke_agent weather-agent
   └─ invoke_workflow weather-research
      ├─ chat understand-user-request
      ├─ execute_tool resolve_location
      │  └─ SELECT active_location_profile
      ├─ execute_tool fetch_weekly_weather
      │  └─ GET weekly forecast
      └─ chat final-answer
여기서 POST /agent/weather, DB Query, HTTP Client 요청은 기존 APM으로 측정할 수 있는 부분이었다.
그리고 Agent, Workflow, Tool, LLM 요청은 GenAI Semantic Convention으로 계측한 Span이다. 하나의 Trace 안에서 일반 애플리케이션의 실행 흐름과 Agent의 판단 과정을 같이 볼 수 있다.
이렇게 보면 단순히 요청이 느렸다는 사실을 넘어서 Agent가 어떤 순서로 작업했고 어느 단계의 결과가 최종 답변에 사용되었는지 확인할 수 있다. 따라서 Agent를 정확히 추적 관리하려면 이런 심화 태깅이 필요하다
Agent의 시끄러운 실패
Agent또한 일반 애플리케이션처럼 시끄럽게 실패할 수 있다. 예를 들어 Agent가 날씨 API를 호출했는데 Timeout이 발생했다고 해보자.
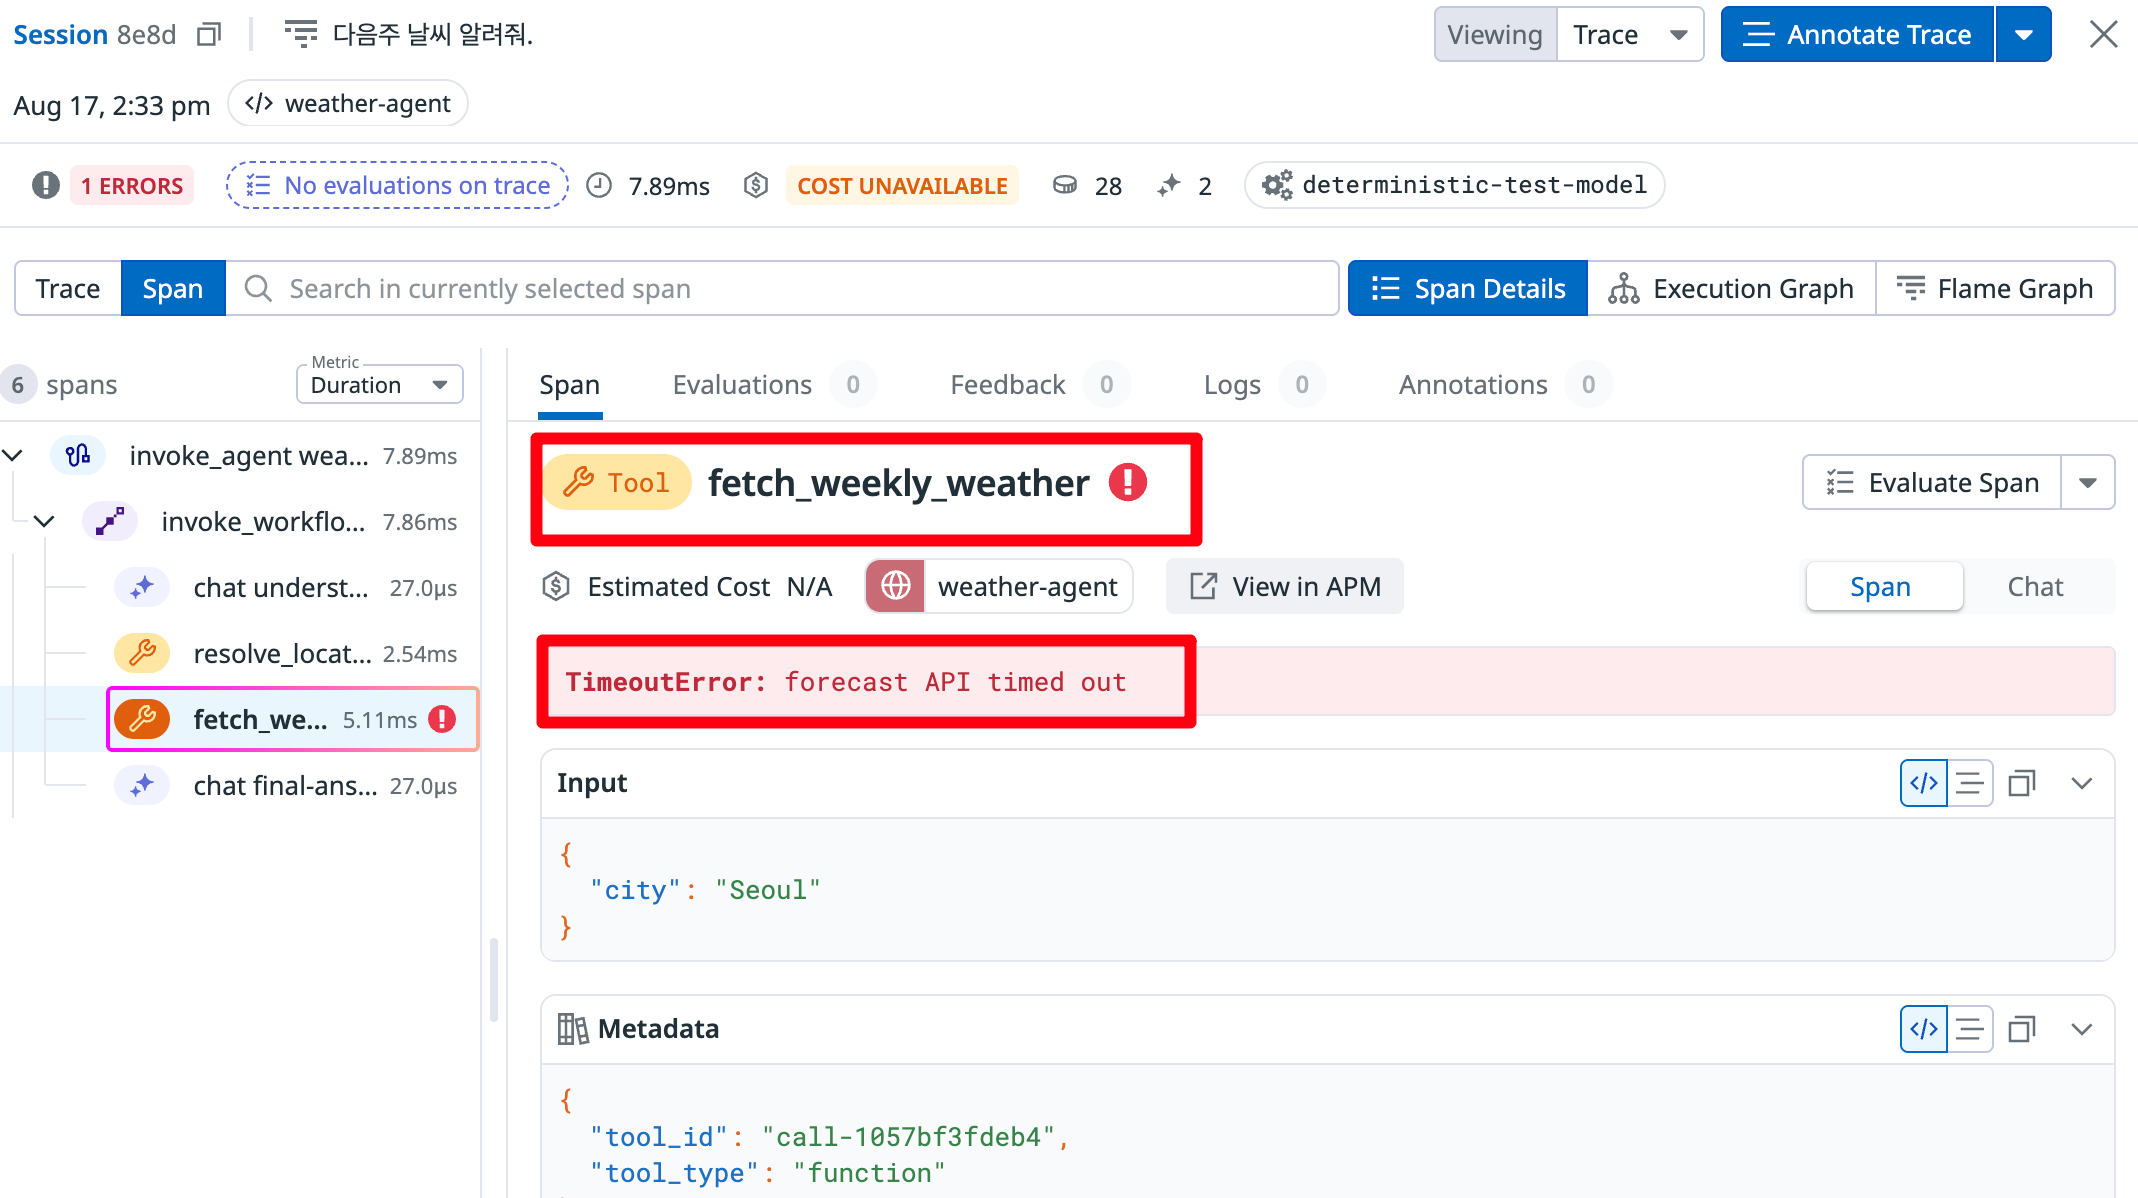
execute_tool fetch_weekly_weather → Error
└─ GET weekly forecast → 504 Timeout
Agent가 사용자에게 아래처럼 답했다면 실패 여부를 판단하기 어렵지 않다.
Tool Span과 HTTP Span에는 Error가 기록되고 전체 요청도 502를 반환한다. 기존 APM 방식으로도 문제를 발견할 수 있다. 이것은 Agent 자체의 오류이지만 에러가 명확하게 구분되는 시끄러운 실패이다. 이 때는 fetch_weekly_weather Tool에 Error가 표시되는 것처럼 전통적인 APM으로도 에러 추적이 가능하다
Agent의 조용한 실패
진짜 어려운 부분은 모든 작업이 정상적으로 끝났지만 Agent가 해온 일이 잘못된 경우이다.. ㅠ
이번에는 사용자 프로필 DB에 오래된 위치 정보가 남아있다고 가정해보자.
사용자는 현재 서울에 있지만 Agent가 오래된 프로필에 저장된 부산을 사용했다.
- 위치 조회 → 성공, Busan 반환
- 날씨 API 호출 → 성공, HTTP 200
- LLM 최종 답변 생성 → 성공
- 사용자 요청 응답 → HTTP 200
그리고 Agent는 아래와 같이 답한다.
다음주 Busan은 대체로 맑고 최고 31도, 최저 24도 정도로 보입니다.
문장 자체는 자연스럽다. 날씨 API도 정상적으로 호출되었고 LLM도 답변 생성에 성공했다. Trace에 Error Span은 하나도 없으며 HTTP Status Code도 200이다.
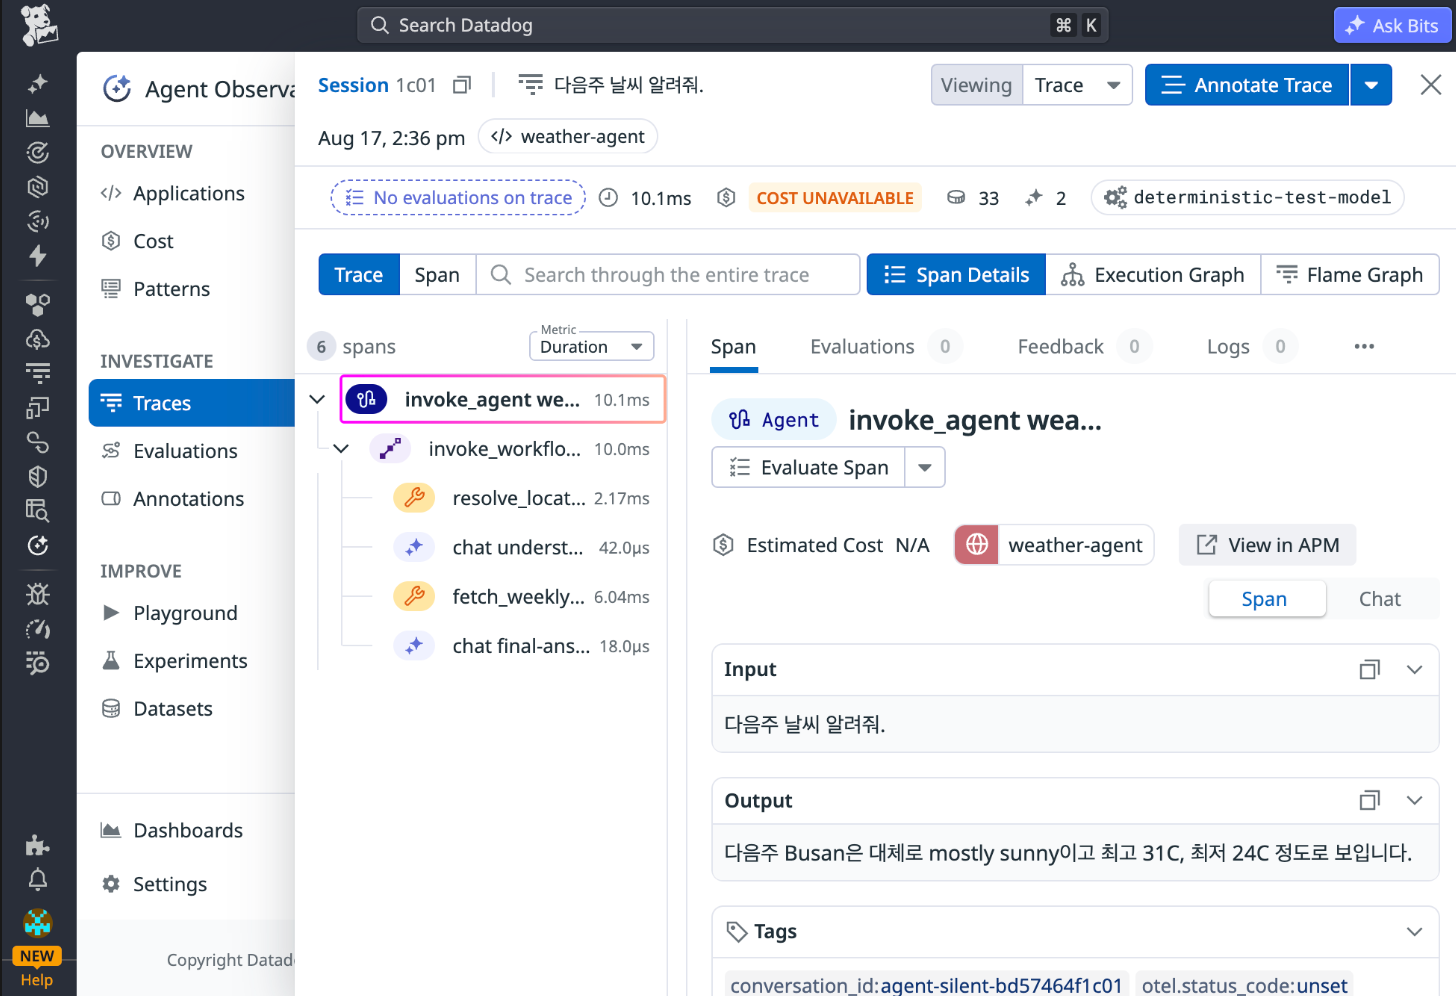
전통적인 관점에서 애플리케이션의 에러는 없지만 하지만 사용자가 원했던 서울의 날씨가 아니다...
사람이 조사를 잘못해왔다고 했을 때를 생각해보면 이해하기 쉽다.. 어린아이에게 숙제를 내줬을 때.. 조사를 하지 않은 것도 아니고, 문서를 작성하지 않은 것도 아니다. 정해진 시간 안에 숙제를 제출했지만 중간에 잘못된 자료를 참고해서 정답에 빗나간 것이다.
그래서 업무를 완료했다는 사실만 본다면 성공이지만, 업무의 목적을 달성했는지를 본다면 실패이다. 이것이 Agent의 Silent Failure이다!
- HTTP 관점 → 성공
- Span Status 관점 → 성공
- Tool 실행 관점 → 성공
- 사용자 목표 관점 → 실패
Agent는 확률적인 모델의 판단, 외부 데이터, 검색 결과, 여러 Tool의 출력을 조합한다. 각 단계가 기술적으로 성공하더라도 잘못된 Tool을 선택하거나, 오래된 데이터를 사용하거나, 근거와 다른 결론을 만들 수 있다.
이것이 Agent Monitoring이 일반 APM과 가장 크게 달라지는 지점이다.
그렇다면 Error가 없는 실패는 어떻게 발견해야할까?
Evaluation
이를 위해 Agent가 작업을 수행할때 이게 올바르게 되었는지 평가하는 Evaluation이 필요하다. 위에서 살펴본 Trace를 다시 보자
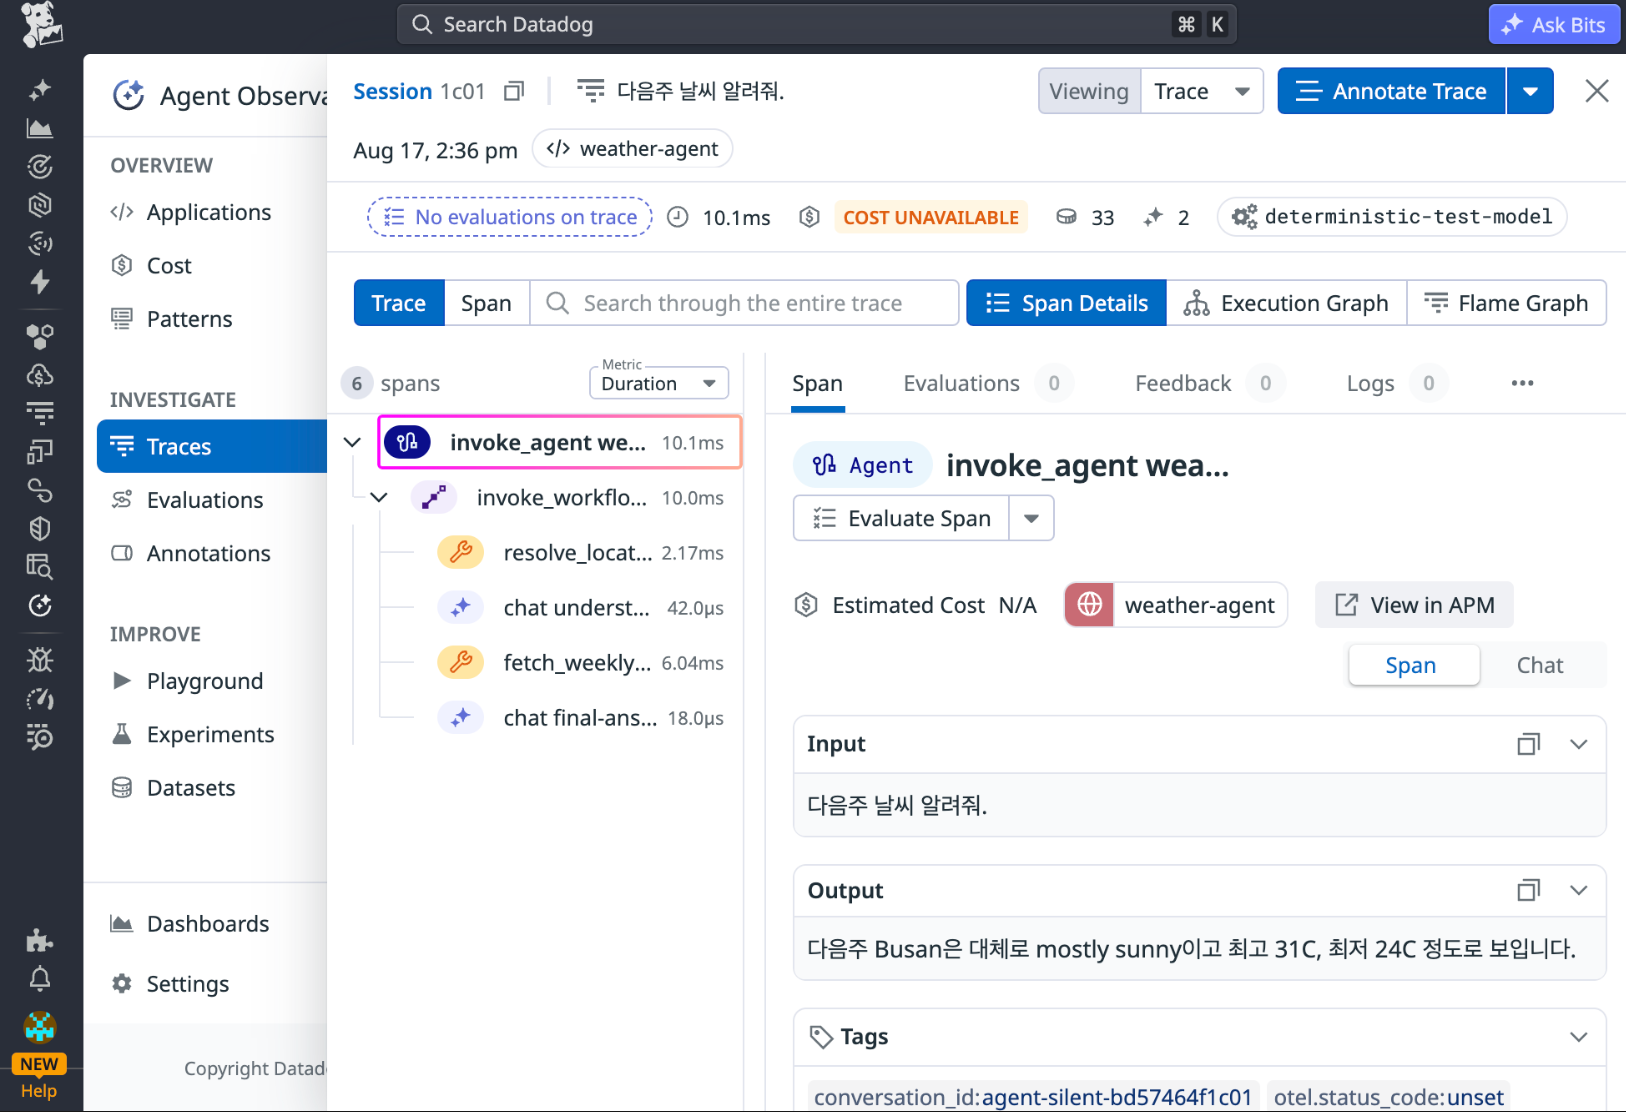
Trace의 모든 Span은 성공했지만 최종 답변은 사용자가 원한 서울이 아닌 부산의 날씨이다. 실행은 성공했지만 업무는 실패한 것이다.
그래서 이번 예제에는 task_success라는 Evaluation을 추가했다.
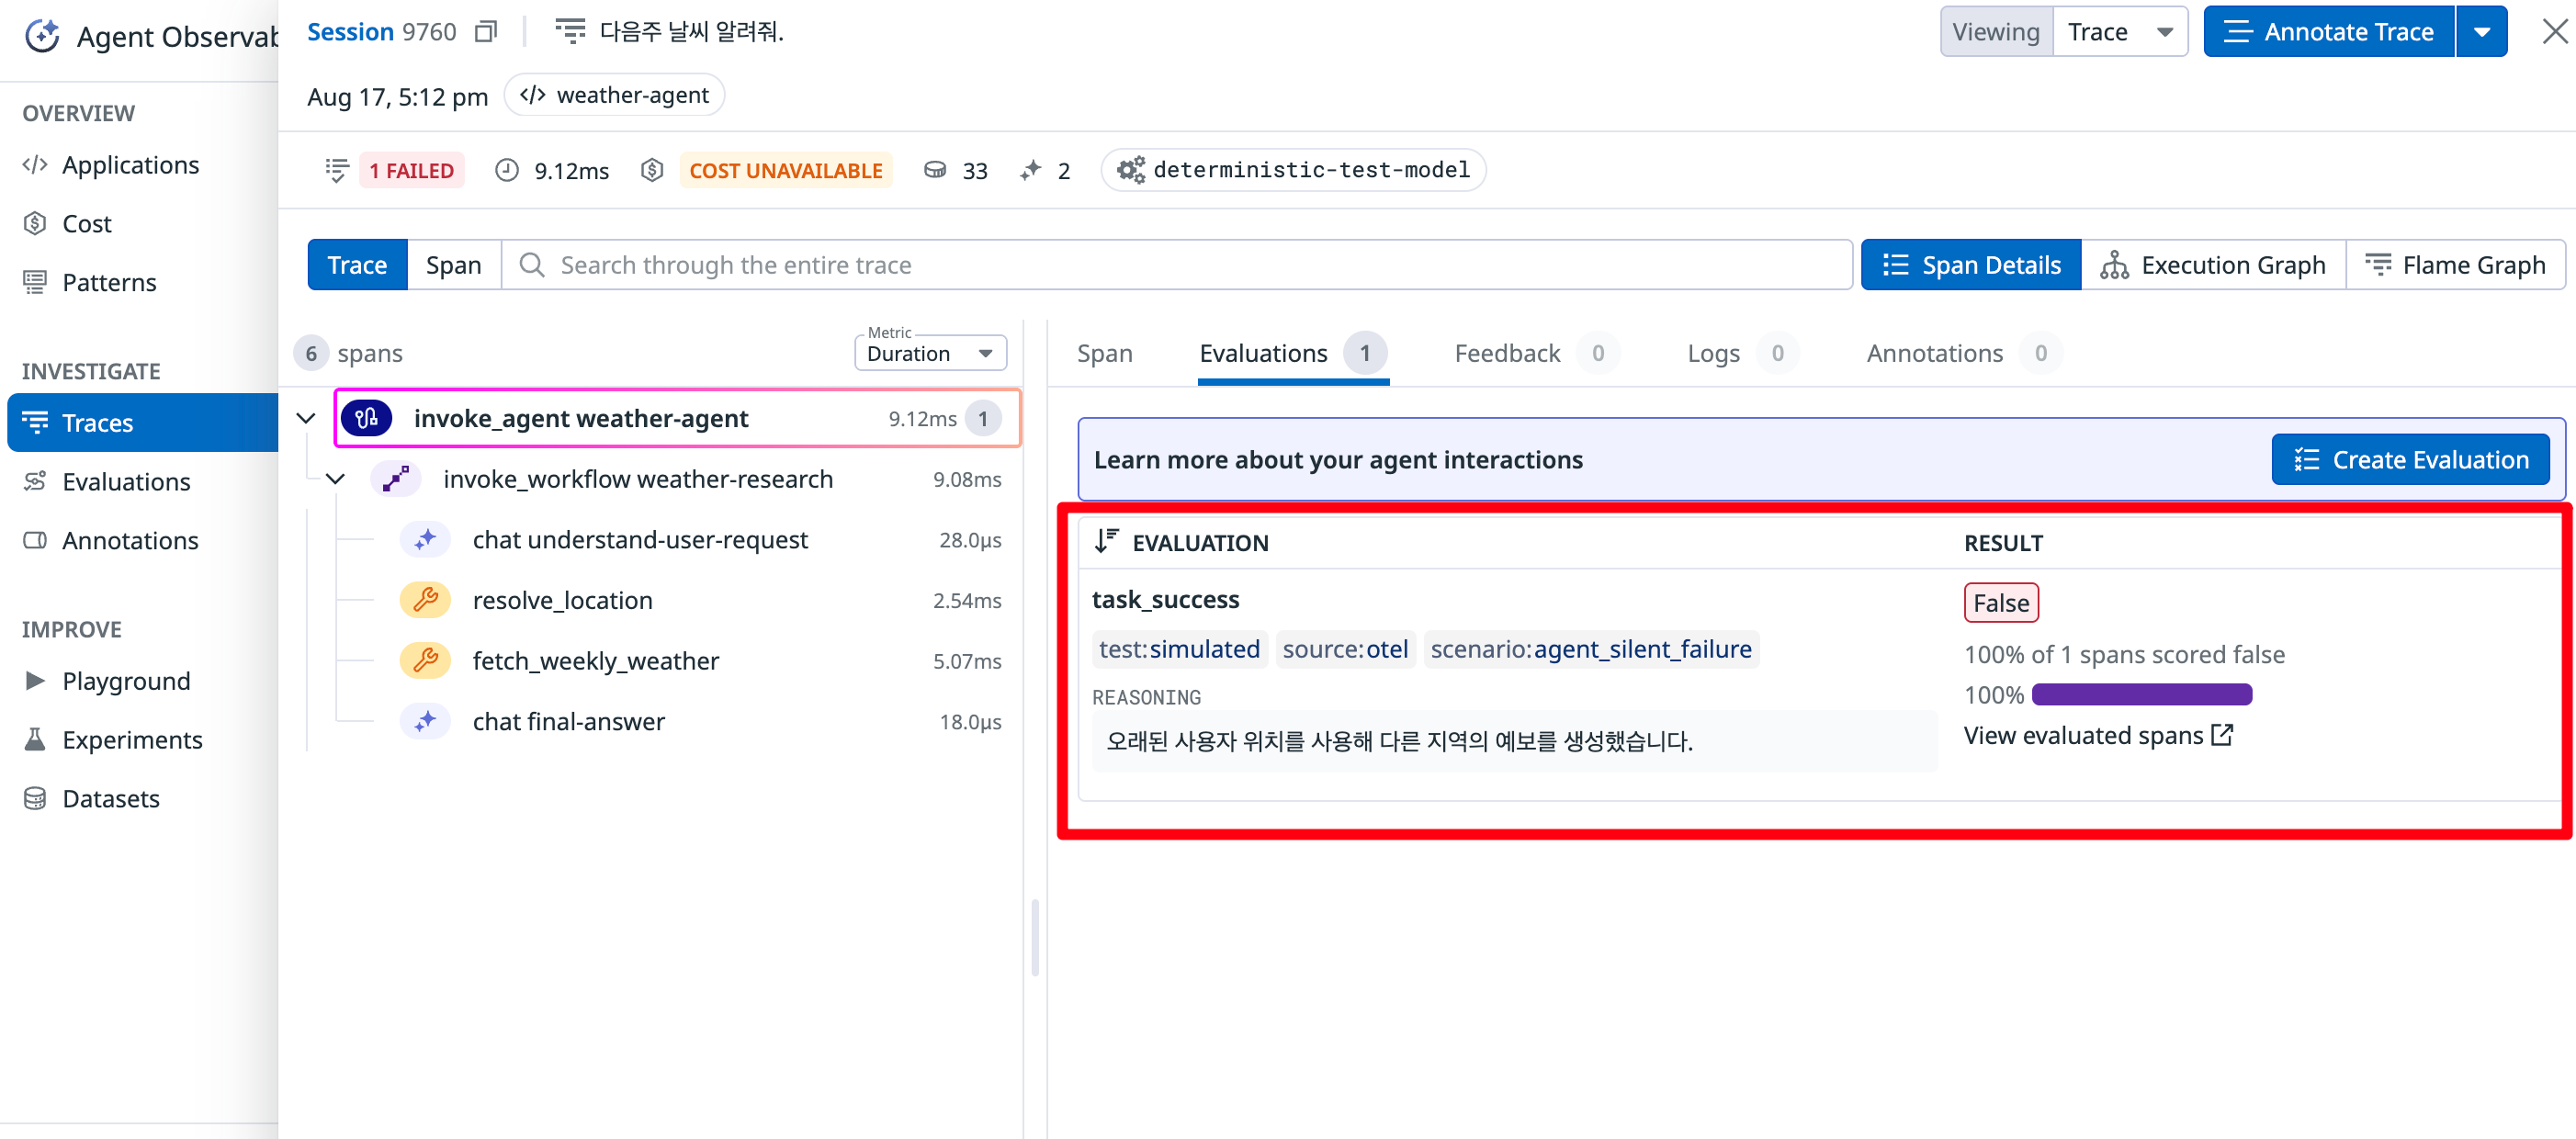
요청자체는 성공했지만 평가자체는 실패한 것을 볼 수 있다.
Evaluation은 정답과 비교하는 코드가 될 수도 있고, 사용자의 피드백이나 다른 LLM의 평가가 될 수도 있다. 중요한 것은 Agent가 정상적으로 실행되었는지와 사용자의 목적을 달성했는지를 나누어 보는 것이다.
자 그 다음으로는 좀 더 복잡한 예시로 고객 미팅 준비 Agent를 봐보자
심화 예시: 영업 담당자를 위해 고객 미팅 자료를 준비하는 Agent
이 케이스에서 사용자는 아래와 같이 요청한다.
내일 HanRiver Commerce 기술 미팅을 준비해줘. 고객 현황, 예상 과제, 관련 사례, 아젠다와 확인 질문을 정리해줘.
Agent는 요청을 처리하기 위해 CRM, 공개 웹 자료, Embedding, 문서 검색, 다른 검증 Agent와 Calendar Tool까지 사용한다.
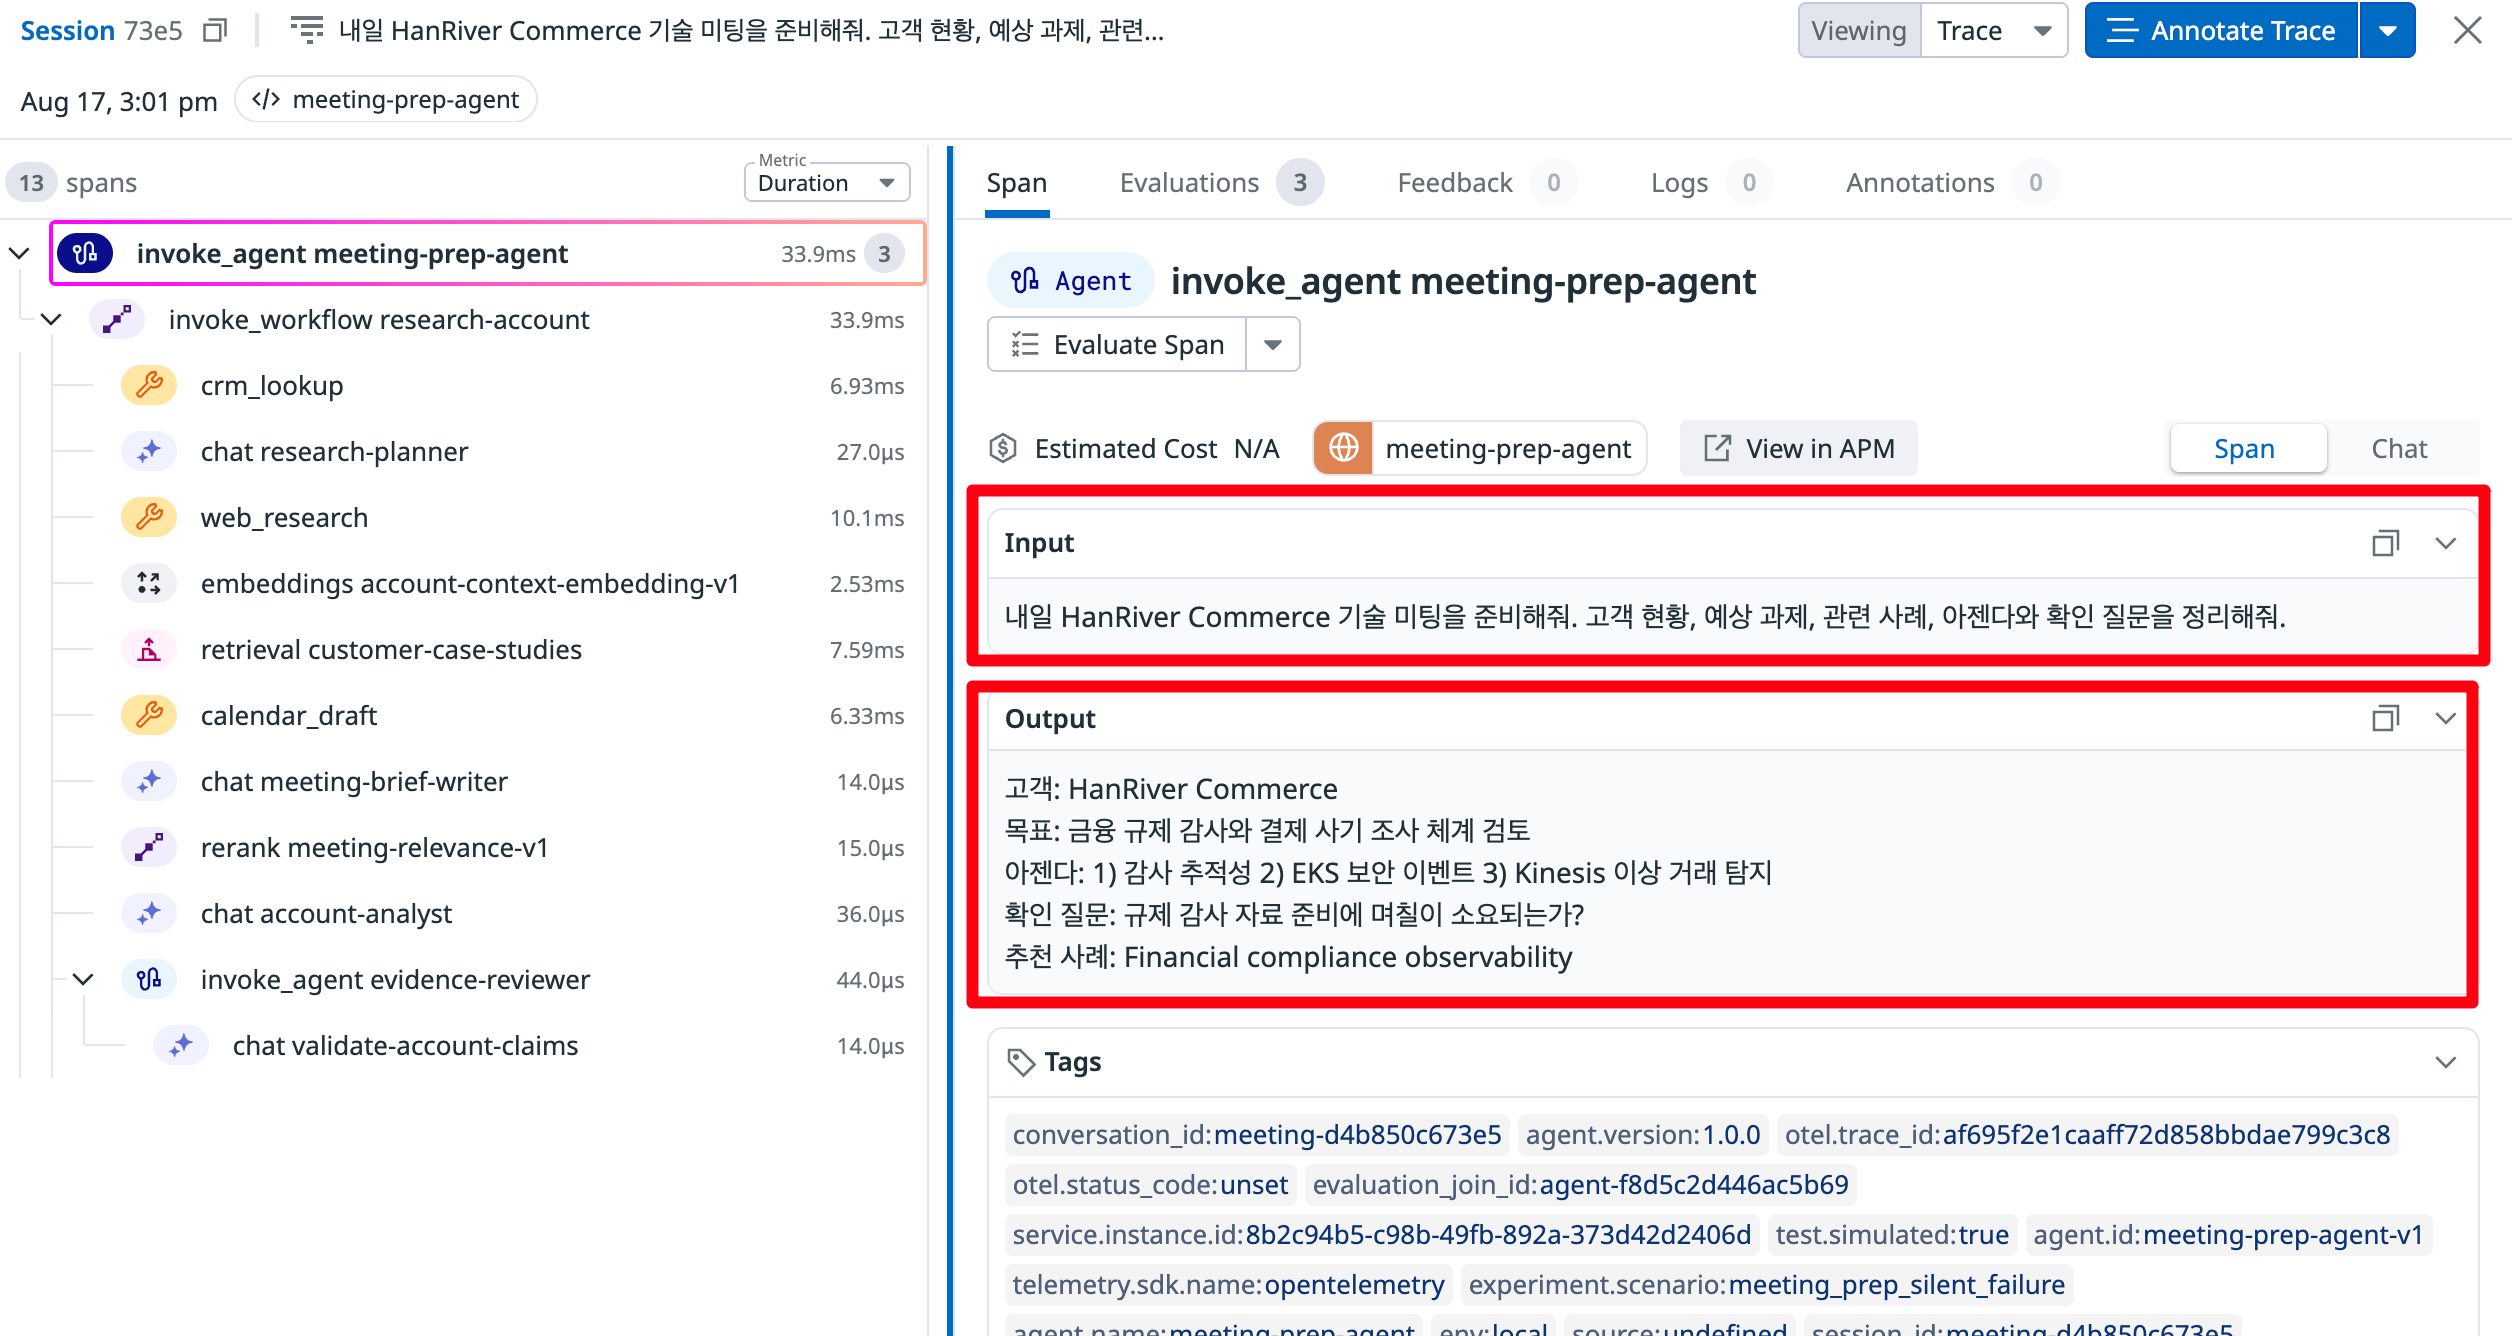
최종 답변에서는 문서 형식도 맞고 문장도 자연스럽지만 e-commerce 고객에게 산업의 인더스트리가 다른 다른 금융 회사의 과제를 제안하였다. 그래서 사용자 입장에서 Agent가 기대한 일을 했다고 보기는 어렵다!
그런데 Trace에는 모두 성공 상태이다. 그렇다면 Agent는 중간에 뭘 잘 못햇길래 이상한 답변을 내놓은 것일까??
Trace에서 crm_lookup Tool을 선택해보면 요청한 고객은 HanRiver Commerce지만 실제 반환된 고객은 HanRiver Financial인 것을 바로 확인할 수 있다.
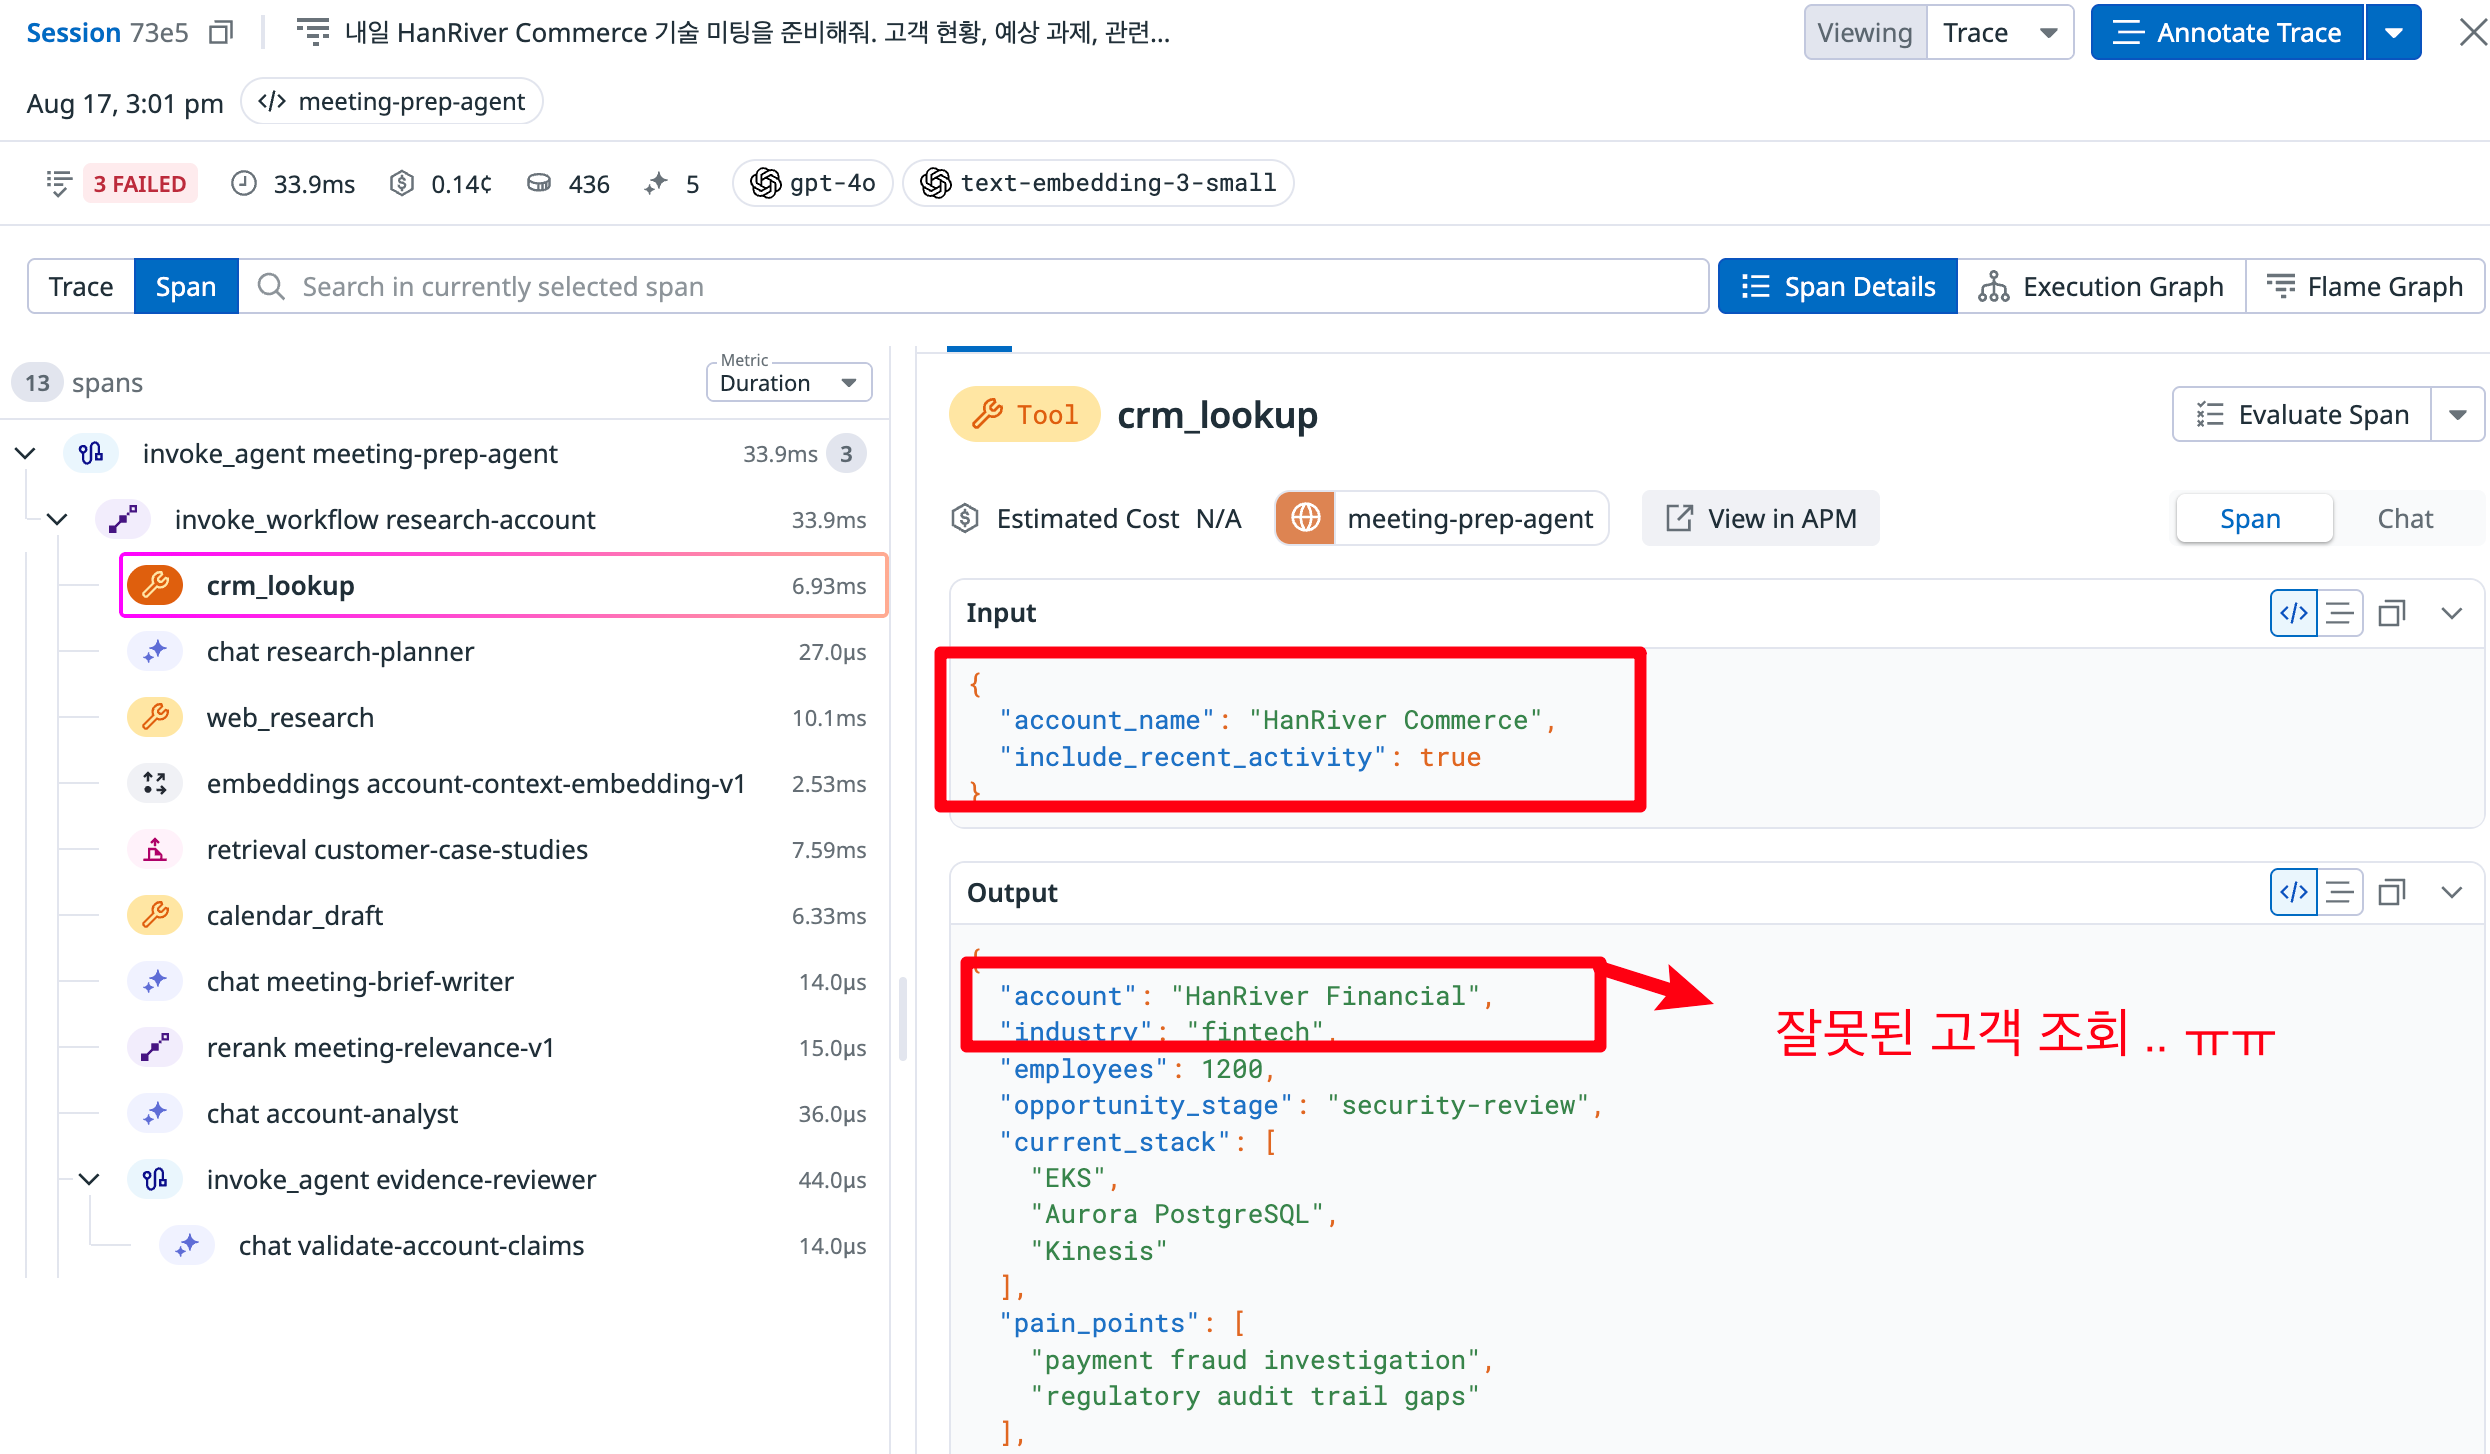
즉 이번 문제의 원인은 LLM 호출 실패가 아니다. 성공한 crm_lookup 결과를 Agent가 검증하지 않고 신뢰하면서 잘못된 정보가 전체 Workflow에 전파된 것이다.
하지만 운영자가 모든 Trace를 직접 열어 이런 차이를 찾아낼 수는 없다. 그래서 이 Trace에는 전체 업무 성공 여부와 고객 일치 여부, 답변의 근거 수준을 평가하는 세 가지 Evaluation을 함께 제출했다.
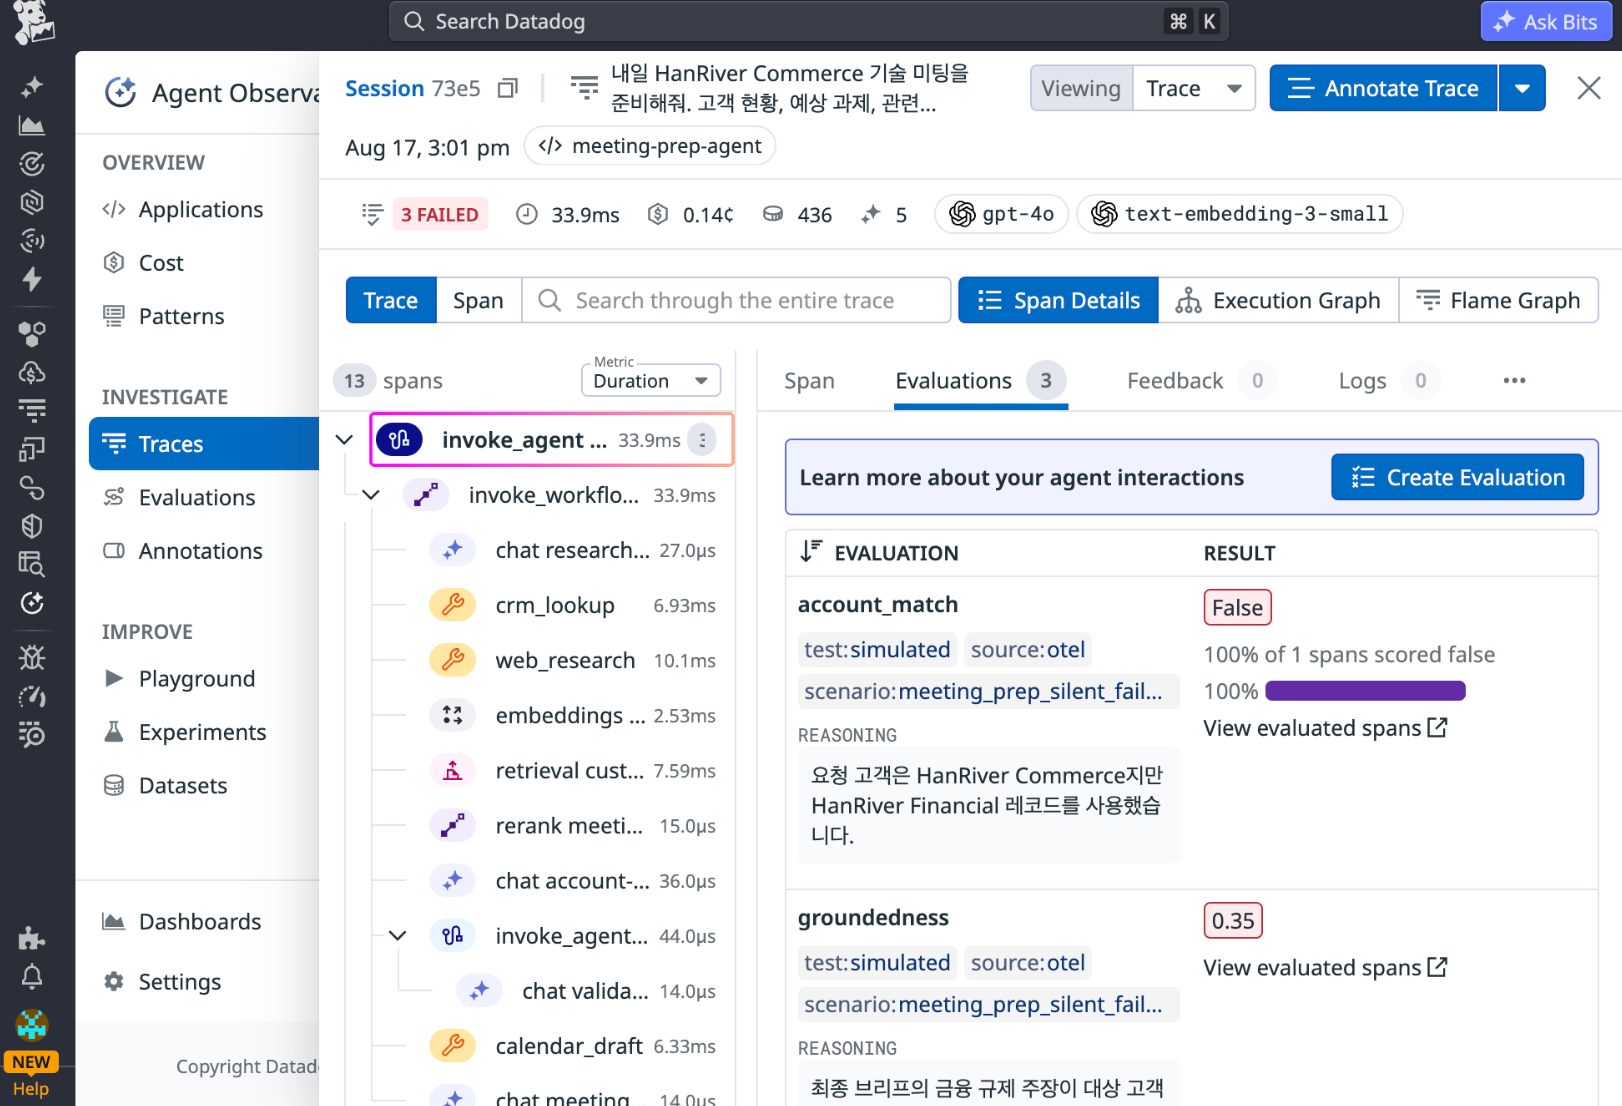
결과를 보면 account_match:false, groundedness:0.35, task_success:false가 모두 실패로 표시된다.
Trace가 왜 틀렸는지 보여준다면 Evaluation은 이 Trace가 실제로 잘못된 결과인지 판단할 수 있게 해준다. 두 가지를 함께 볼 때 비로소 Agent의 조용한 실패를 발견하고 원인까지 찾아갈 수 있다.
정리
-
일반적인 APM은 Error, Latency, 처리량을 통해 애플리케이션의 상태를 이해한다. 그런데 Agent는 APM 상으로 정상적으로 요청을 처리했다고 하더라도, 사용자가 원하는바로 일을 수행하지 못하는 사례가있다. 이를 Agent의 조용한 실패라고한다.
-
Agent가 오류 없이 실행되었는가가 아니라 Agent가 사용자의 목적을 제대로 달성했는가? 를 확인해야한다!!
-
Agent의 실행 과정을 이해하려면 Agent, Workflow, Tool, LLM 같은 작업을 Trace로 연결해야한다. 그리고 조용한 실패를 발견하려면 최종 결과와 중간 판단을 Evaluation으로 측정해야한다.
따라서 Agent Application을 모니터링하려면 APM과 Evaluation을 같이 봐야한다.
Trace → Agent가 무엇을 했는지
Error → 기술적으로 어디서 실패했는지
Evaluation → 결과가 실제로 좋은지 판단
Agent가 점점 더 많은 업무를 대신하게 될수록 단순히 실행 여부를 확인하는 것보다 결과의 품질을 측정하는 일이 중요해질 것이다.
다음 글에서는 Evaluation을 만드는 방법과 어떤 기준으로 Agent의 품질을 측정해야하는지 조사해서 정리해보려고 한다. To be continued..!