이번 글에서는 StarGAN에 대한 논문을 요약해보고자 한다.
1. Introduction
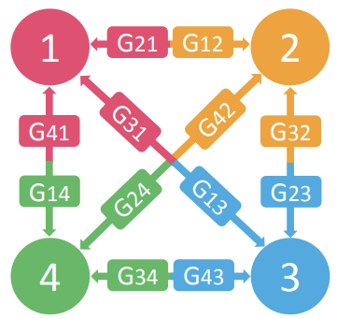
현존하는 이미지 변환 모델들의 한계점은 다음과 같다.
- 한 생성기가 2가지 범주 간의 변환만을 지원하기 때문에 k가지 범주 간의 변환을 위해서는 (2k)×2=k(k−1) 개의 생성기가 필요하다.
- 서로 연결고리가 없는 데이터셋을 함께 이용할 수 없어서 비효율적이다.
(ex : 데이터셋 1 - 머리 색, 성별, 피부색 / 데이터셋 2 - 표정)
반면, StarGAN은 다음과 같은 특성을 지닌다.
- 단 하나의 생성기로 다양한 영역을 학습할 수 있다.
- Mask Vector를 통해 다양한 데이터셋들을 함께 이용할 수 있다.
c′ : 기존에 속하던 범주
c : 변환하고자 하는 범주
G:G(x,c)→y
D:x→Dsrc(x),Dcls(x)
G(x,c)는 c′에 속하던 x를 c에 속하도록 변환하는 생성기이다.
Dsrc는 입력되는 사진이 생성기가 가짜로 생성해낸 것인지, 아니면 실제 데이터인지를 구별하는 판별기이다.
Dcls는 입력되는 사진이 어떤 범주에 속하는 지를 유추하는 판별기이다.
Adversarial Loss
Ladv=Ex[logDsrc(x)+Ex,c[log(1−Dsrc(G(x,c)))]]
Dsrc: x가 실제 샘플일때는 1, G(x,c)가 생성한 가짜 샘플일때는 0을 반환해서 둘을 구분하도록 학습한다.
∴maxDsrcLadv
G(x,c) : 가짜 샘플을 실제 샘플처럼 사실적으로 보이게 생성할 수 있도록 학습한다.
∴minGLadv
Domain Classification Loss
Lclsr=Ex,c′[−logDcls(c′∣x)]
Lclsf=Ex,c[−logDcls(c∣G(x,c))]
Dcls(c′∣x) : 입력받은 x를 그것의 범주인 c′으로 정확히 판별하도록 학습한다.
∴minDclsLclsr
Dcls(c∣G(x,c)) : 입력받은 G(x,c)를 의도한 범주인 c로 정확히 판별하도록 학습한다.
∴minDclsLclsf
Reconstruction Loss
Lrec=Ex,c,c′[∥x−G(G(x,c),c′)∥1]
G : x를 새로운 범주 c로 변환한 뒤 다시 원래의 범주였던 c′으로 변환했을 때 기존의 x가 복구될 수 있도록 학습한다.
∴minGLrec
Mask Vector
c~=[c1,...,cn,m]
m : 몇번째 데이터셋인지를 알려준다
c : 인풋 이미지가 해당 데이터셋의 속성들 중 지닌 것들을 알려준다
ex) Dataset 1 - 금발, 남성, 노인
Dataset 2 - 두려움, 행복함, 슬픔
C=[[1,1,0],[0,0,0],[1,0]]
C=[[0,0,0],[0,1,0],[0,1]]
3. Implementation
Ladv=Ex[logDsrc(x)+Ex,c[log(1−Dsrc(G(x,c)))]]
Ladv=Ex[Dsrc(x)]−Ex,c[Dsrc(G(x,c))]
−λgpEx^[(∥▽x^Dsrc(x^)∥2−1)2]
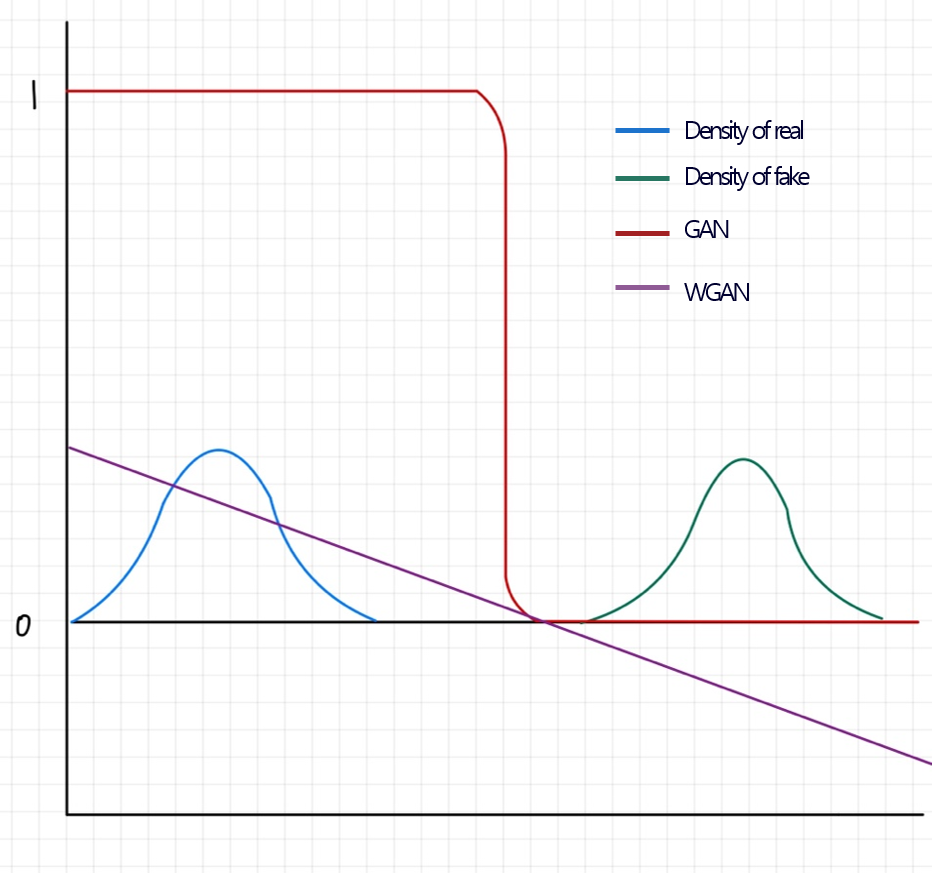
실제 구현에서는 앞서 소개한 Ladv를 위와 같이 바꾸어 사용했는데, 이는 다음과 같은 장점을 지닌다.
- Vanishing Gradient를 방지해 생성기의 성능을 높일 수 있다.
- Gradient가 급격히 변하더라도 패널티가 부여되어 안정적인 학습이 가능하다.
4. Result
비교 대상 1 - DIAT(Deep Identity-aware Transfer)
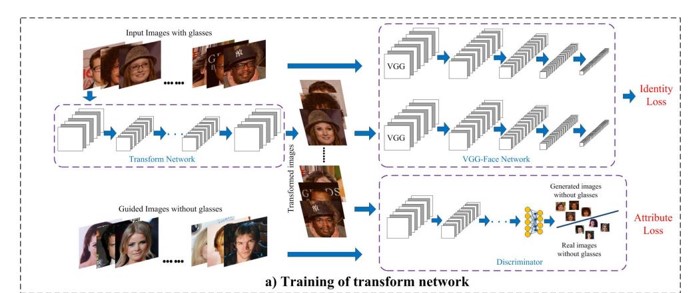
- 특성(ex : 안경)을 제거한 후에도 기존의 정체성(ex : 사람 얼굴)을 유지하기 위해 Identity loss를 이용한다
- 특성을 제거한 이미지가 유사한 다른 가이드 이미지들과 비슷해지기 위해 Attribute loss를 이용한다
비교 대상 2 - CycleGAN
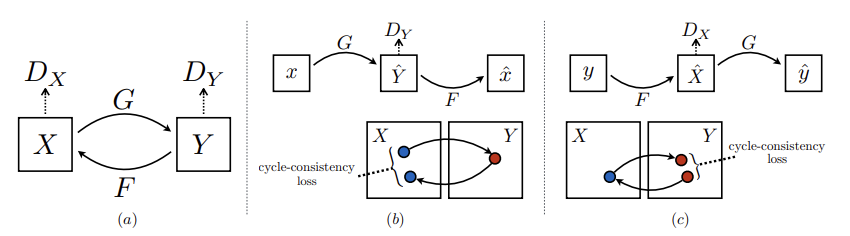
- 두 개의 Generator, 두 개의 Discriminator가 양방향으로 함께 학습해 상대방의 특징으로 생성할 수 있다
비교 대상 3 - IcGAN
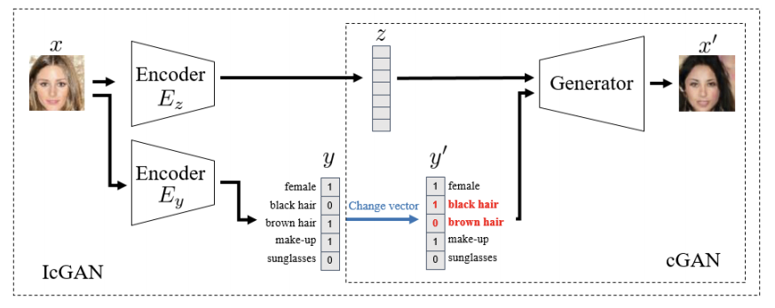
- 두 개의 인코더와 cGAN이 연결된 형태이다
- 실제 이미지 X는 Ez로 인코딩 되어 Generator의 인풋으로 들어가고, 특성은 Ey로 인코딩 되어 cGAN의 조건으로 쓰인다.
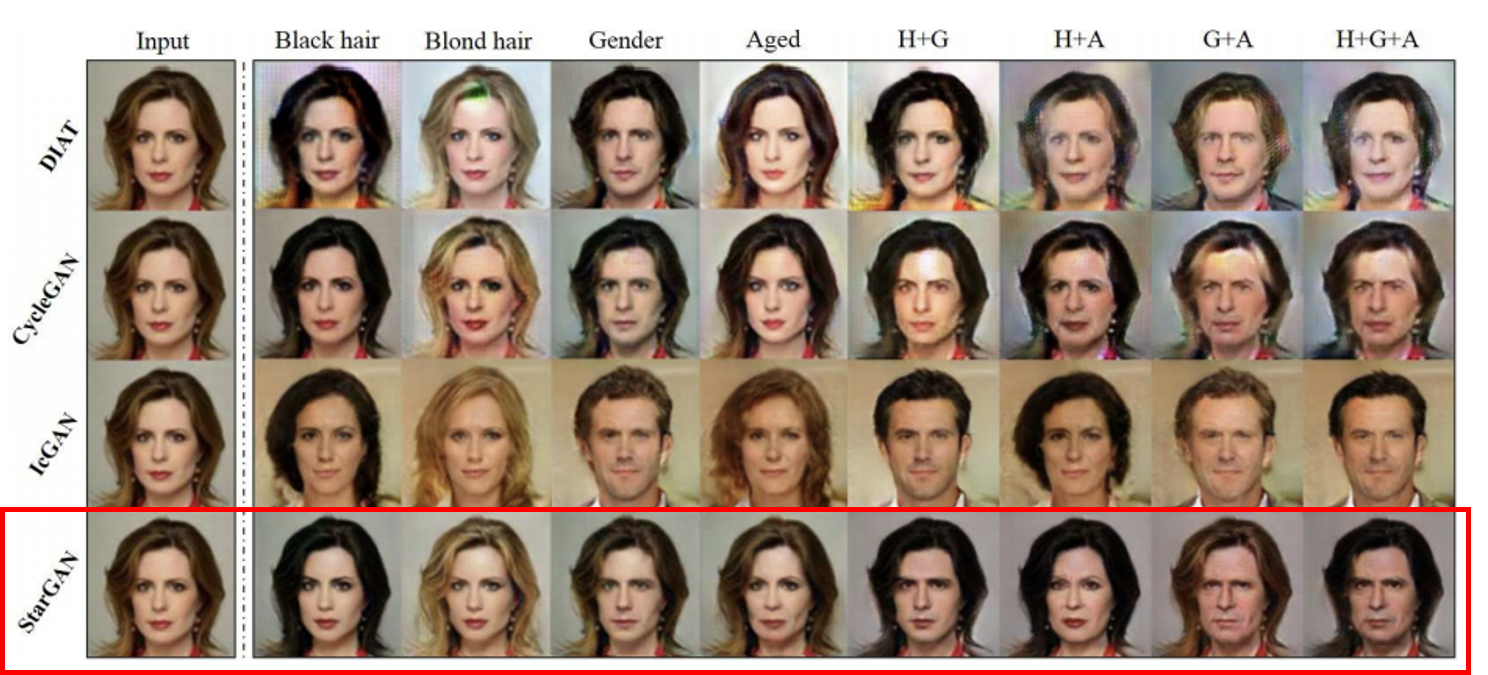
Qualitative evaluation
CelebA 데이터셋
RaFD 데이터셋
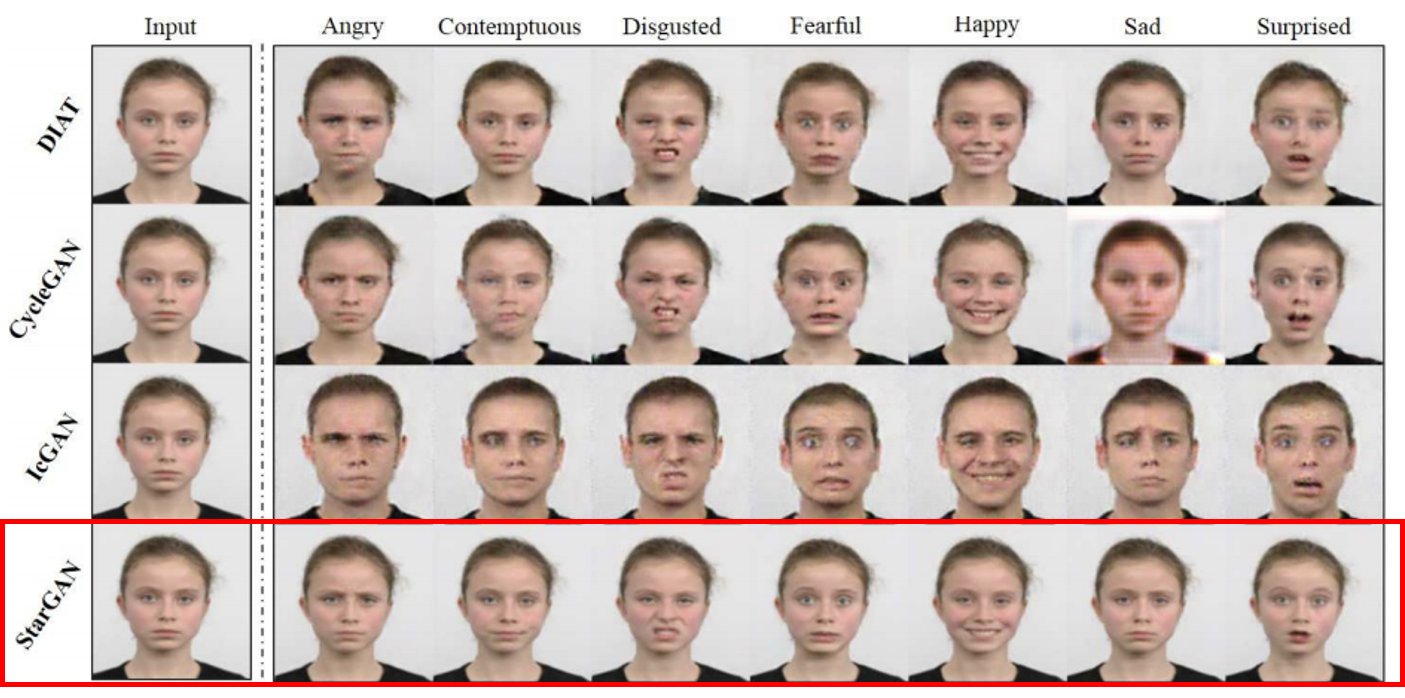
- 시각적 퀄리티가 가장 높다.
- 원본과의 유사성을 가장 잘 보존한다.