지난 시간까진 선형모델을 다뤄보았고 이제부터는 비선형모델인 신경망을 다룸
1. 신경망
- 신경망을 수식으로 분해하면 선형 모델의 수식과 비선형 함수들의 결합으로 이루어져 있음
-> 신경망을 다루려면 선형모델에 대해서도 잘 알아야 함
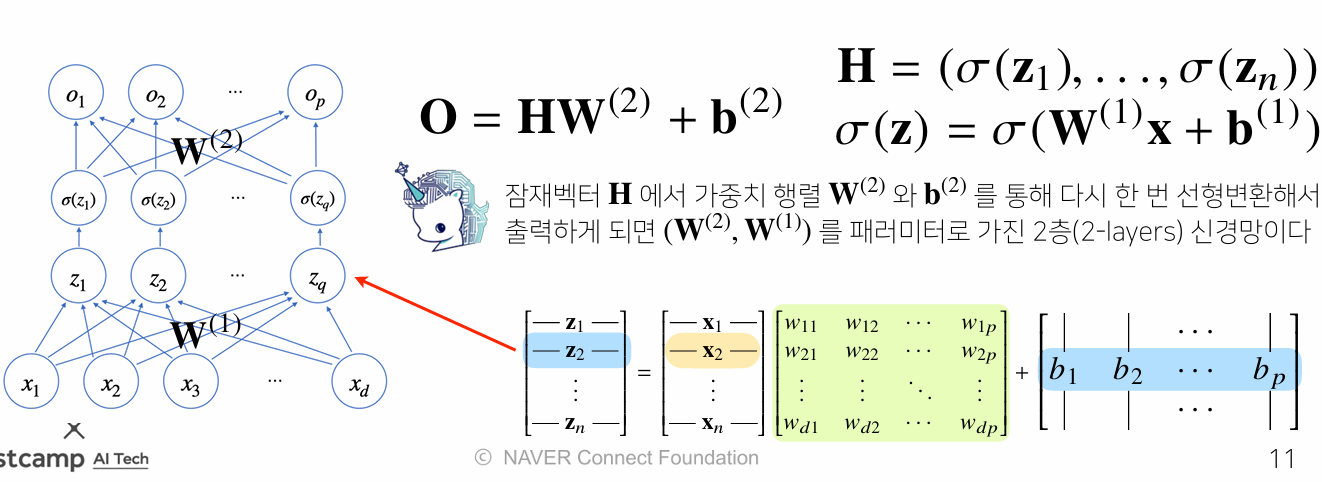
- 아래 그림은 X, W, b가 선형결합으로 이루어져 있음
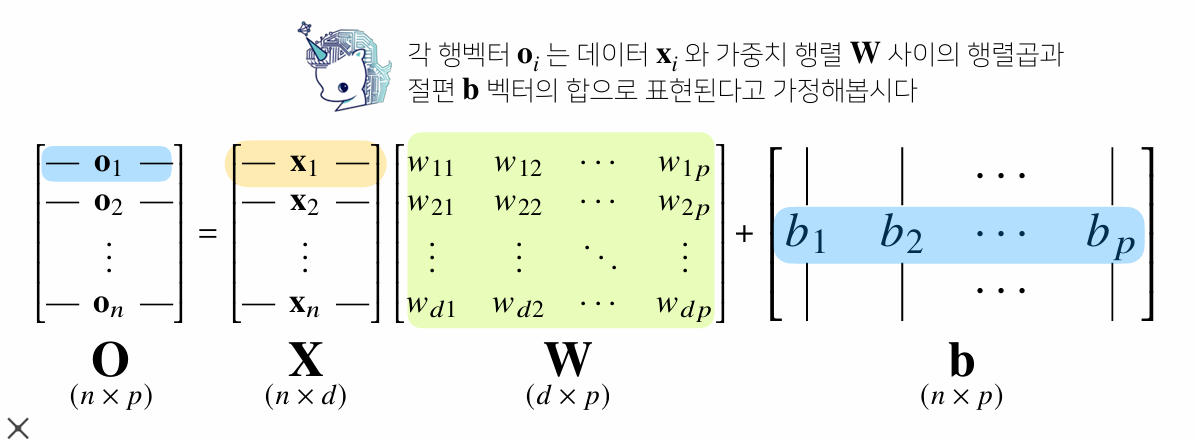
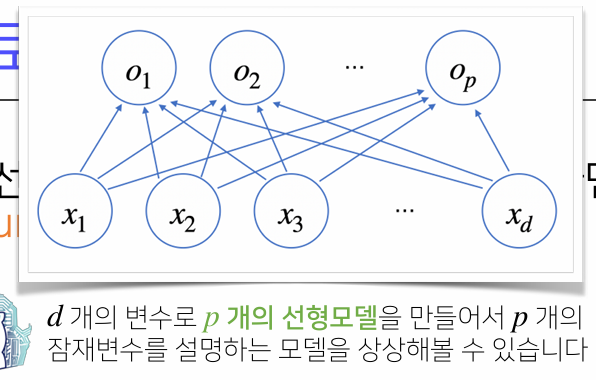
- 아래 그림에서 화살표의 개수는 d * p개 이므로 가중치 벡터 W의 원소 개수와 같음
2. Softmax
-
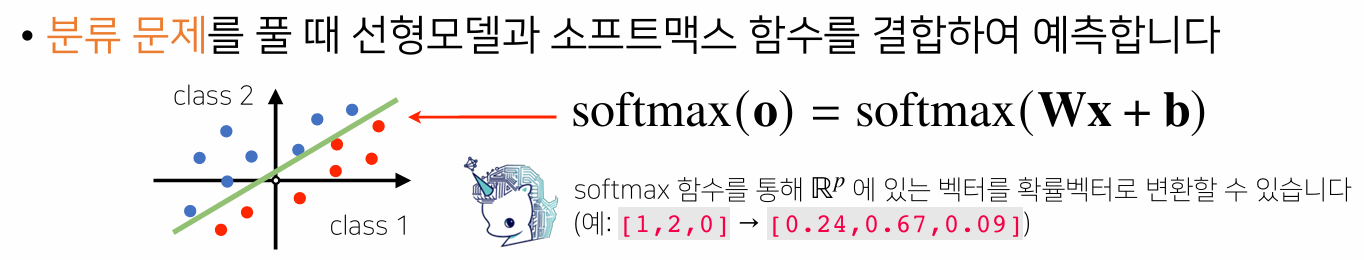
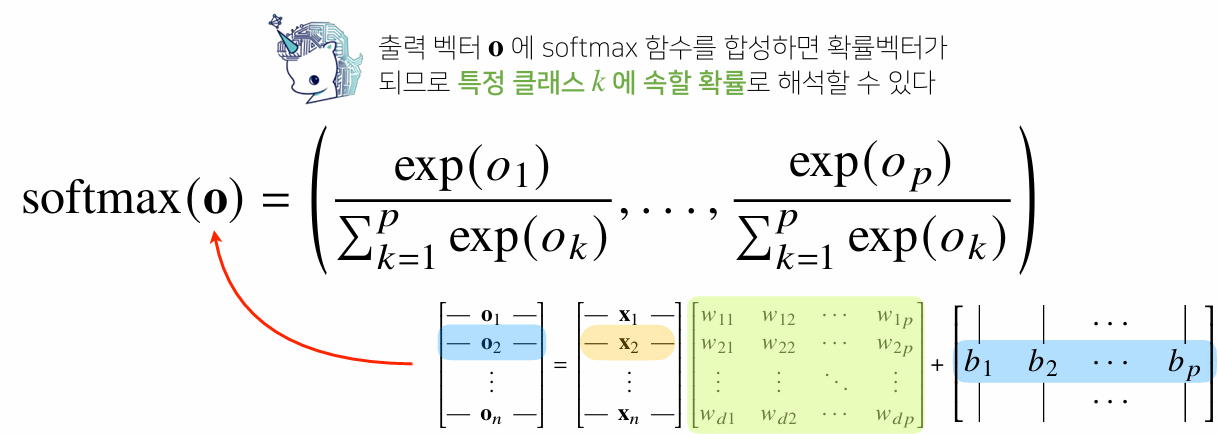
모델의 출력을 확률로 해석할 수 있게 변환해주는 연산
- softmax() 안에 넣으면 분류된 class에 속할 확률이 반환됨 -
분류 문제를 풀 때 선형모델과 결합하여 예측함
-
학습이 아니라 추론을 할 때는 원-핫 벡터를 이용하므로 softmax를 쓰지 않아도 됨
- 원-핫 벡터를 쓰면 최대값을 가진 주소만 1로 출력
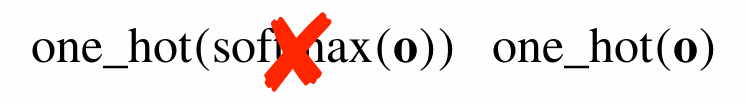
3. 활성함수
-
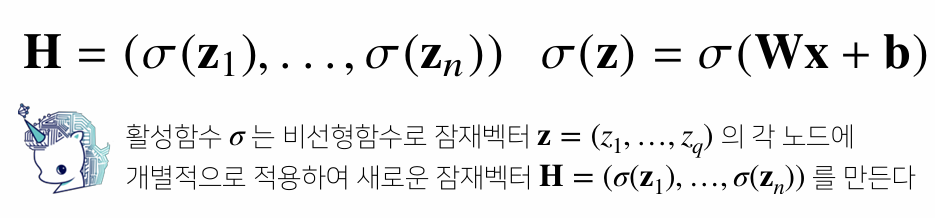
신경망은 선형모델과 활성함수(비선형함수임)를 합성한 함수임
-
선형모델로 나오게 되는 각각의 출력물에 적용함
-
Softmax와의 차이점: softmax는 출력물의 모든 값을 고려한다면 활성함수의 경우에는 특정 주소의 출력값만을 고려함
-> 그러므로 활성함수를 벡터를 input값으로 받지 않고 실수를 받음
-
선형 모델에 활성함수를 씌워 비선형 모델로 변환시킬 수 있고 이렇게 변형된 벡터를 잠재/히든 벡터라고 부름(뉴런이라고도 함)
-> 뉴런으로 이루어진 네트워크를 신경망, neural network라고 함 -
실수값을 입력으로 받고 출력도 실수값으로 뱉음
-
활성함수를 쓰지 않으면 딥러닝은 선형모형과 차이가 전혀 없음
[활성함수 종류]
-
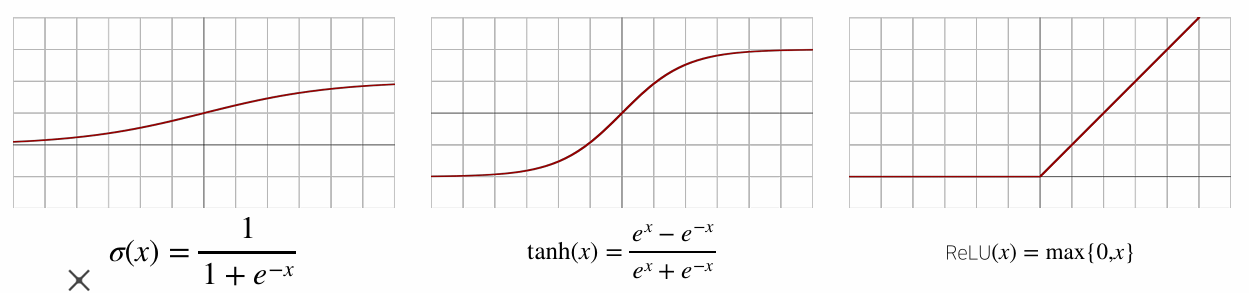
시그모이드
-
tanh 함수(하이퍼볼릭 탄젠트)
----------------------------------------전통적으로 쓰임 -
ReLU(현재 가장 많이 쓰임)
- 선형처럼 보이지만 비선형임
- 선형처럼 보이지만 비선형임
-
활성함수로 만든 잠재벡터 H에 가중치 W와 절편 b를 또 붙이면 2층 신경망이 됨
- 이때 파라미터는 (W2, W1)
- 이걸 반복하면 현대 딥러닝의 기본적인 모형인 Multi Layer Perceptron(다층신경망, MLP)
- MLP의 파라미터는 L개의 가중치 행렬 W(L),.....,W(1)로 이루어짐
-
왜 층을 여러개 쌓는가?
- 이론적으로는 2층 신경망으로도 임의의 연속함수를 근사할 수 있음- 층이 깊을 수록 목적함수를 근사하는데 필요한 뉴런(노드)의 숫자가 훨씬 빨리 줄어들어 좀 더 효율적으로 학습 가능(층이 얇으면 폭이 넓고, 층이 깊으면 폭이 좁음)
- 좀 더 적은 파라미터와 노드를 가지고도 복잡한 패턴을 표현 가능
4. 역전파 알고리즘
- 선형모델의 경우 그래디언트 벡터를 한 층에서 계산 가능하지만, 딥러닝의 경우에는 순차적으로 각 층별로 계산을 하기 때문에 gradient vector를 한번에 계산할 수는 없음
- 이 때문에 역순으로 계산해줌
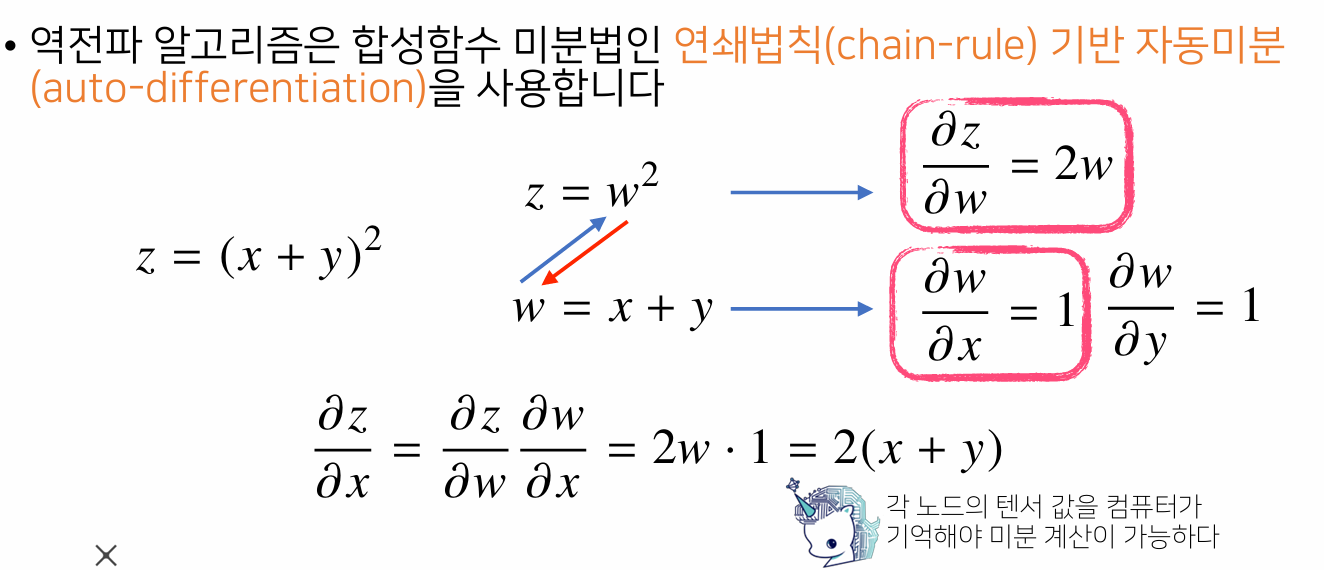
- 역전파 알고리즘의 목적: 각각의 가중치 행렬에서 손실함수에 대한 미분을 계산(윗층부터 역순으로 계산하여 gradient 벡터를 전달)
- 순전파에서는 미분을 저장하지 않지만 역전파에서는 미분값을 저장해야 함
- 손실함수를 첫번째 가중치로 편미분한 값 찾기
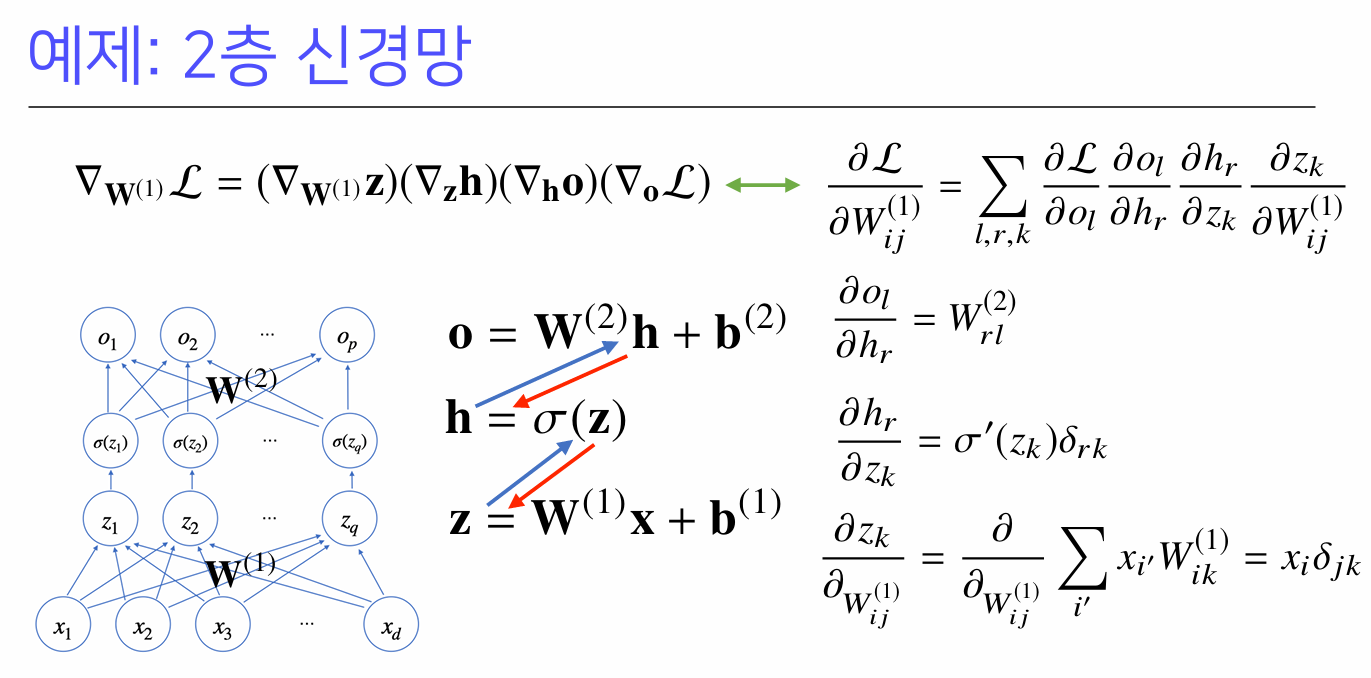
- 각각의 가중치 행렬에 대한 gradient벡터를 확률적 경사하강법을 이용해 각각의 파라미터를 batch로 번갈아가면서 학습하게 됨
- 주어진 목적식을 최소화하는 파라미터를 찾을 수 있음