-
회귀 분석에서 손실함수로 사용되는 L2-노름은 예측오차의 분산을 가장 최소화하는 방향으로 학습하도록 유도
-
분류 문제에서 사용되는 교차엔트로피는 모델 예측의 불확실성을 최소화하는 방향으로 학습하도록 유도
- 분산 및 불확실성을 최소화하기 위해서는 측정하는 방법을 알아야 함
- 두 대상을 측정하는 방법은 통계학에서 제공하기 때문에 기계학습을 이해하려면 확률론의 기본 개념을 알아야 함

이산확률변수 vs 연속확률변수
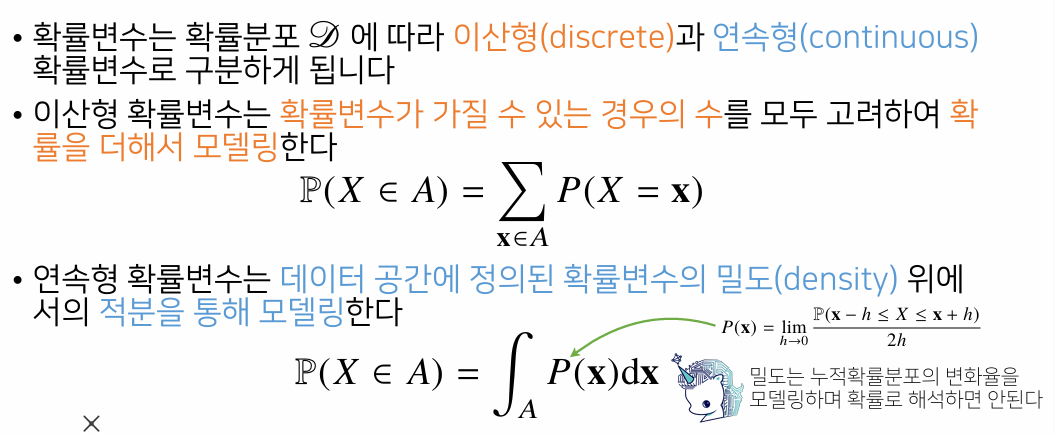
X가 A에 속할 확률을 구하는 방법은 이산, 연속에 따라 다르다.
-
항상 이 두가지로만 구분되지는 않는다. 어떤 경우에는 이산형, 어떤 경우에는 연속형에 따르는 변수도 있다.
-
결합 분포는 원래 확률분포 D가 이산이든 연속이든 상관없이 이산, 연속 중 아무거나 사용해도 상관없음(모델링 방법에 따라서 결정됨)
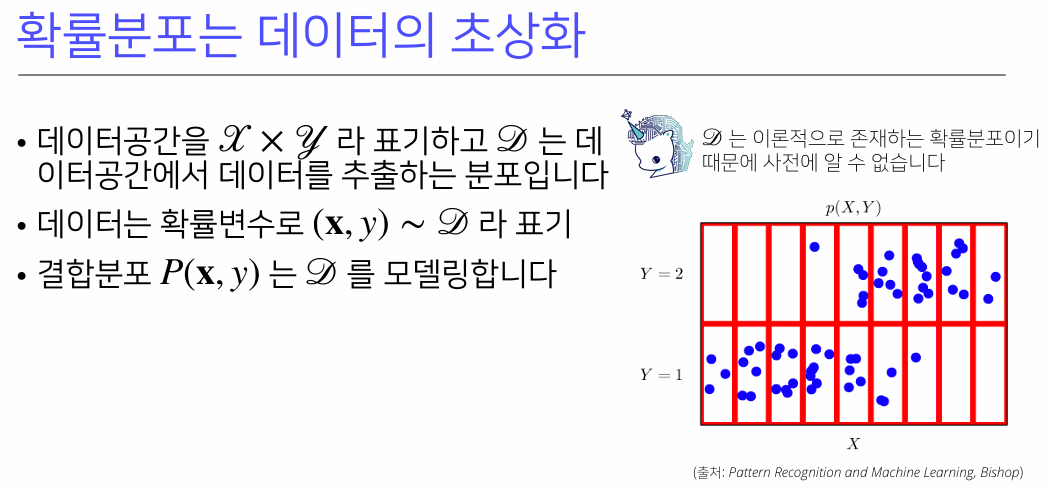
- 이산/연속: 데이터의 종류
- 주변확률/조건부확률: 확률을 다룰 때 쓰는 도구 (둘 다에서 공통적으로 사용됨)
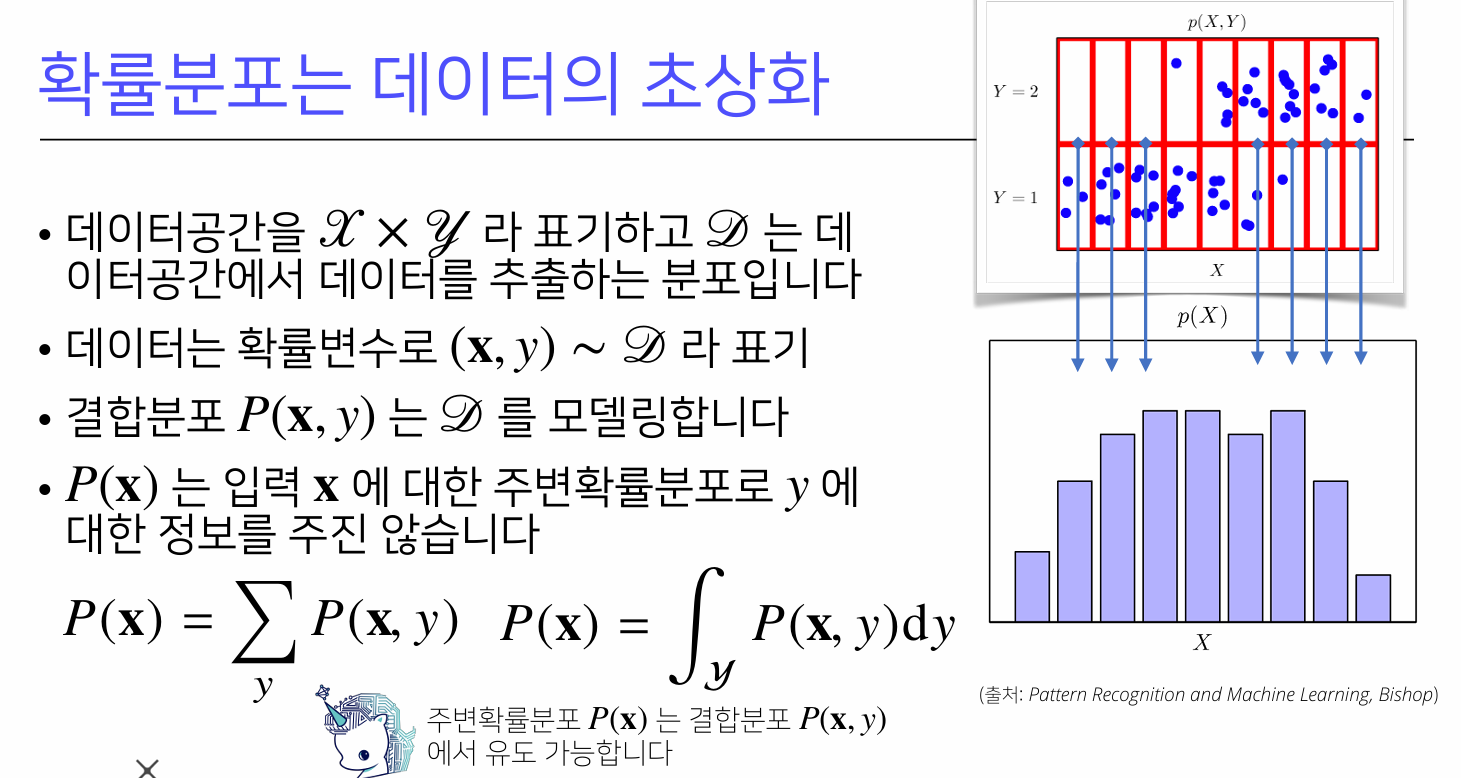
주변확률분포 P(x)
- 결합확률분포를 y에 대해서 더해주거나 적분을 한 것
- 아래는 입력 x에 따라 분포를 구한 것, y에 대한 분포가 아님(y에 대한 주변확률분포를 구할 수도 있음)
조건부확률분포
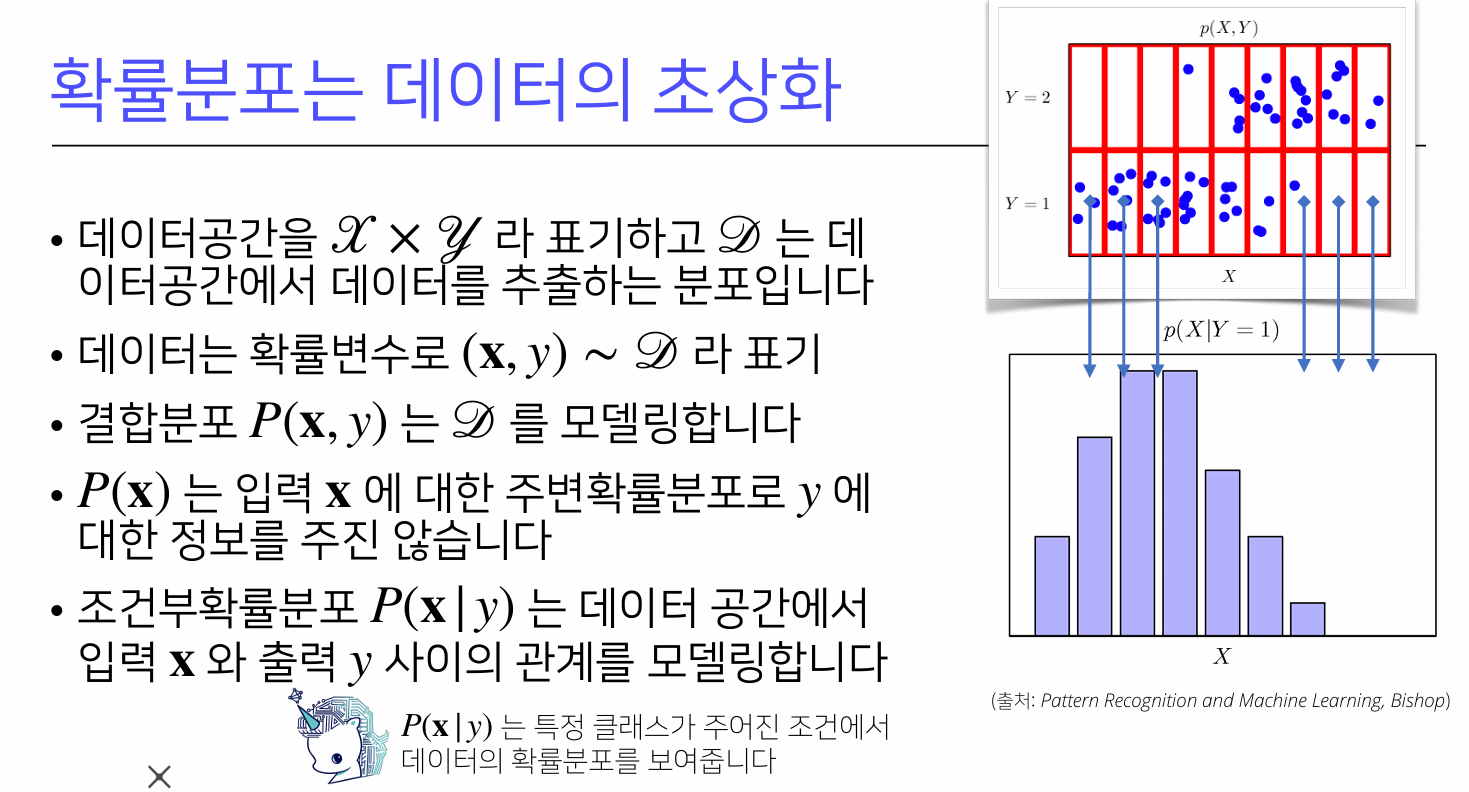
- 가 특정 값인 경우에만 해당하는 x의 분포를 구한 것
- 입력 와 출력 사이의 관계를 모델링함
- 입력과 출력 사이의 통계적 관계를 모델링할 때 사용- 예측 모형을 만들 때 사용
- 연속확률분포의 경우 는 확률이 아니고 밀도로 해석한다는 것을 주의
데이터 사이언스