에너지·설비 데이터를 위한 배열 기반 사고
에너지·설비·센서 데이터는 대부분 시간에 따라 누적되는 수치 데이터이다.
전력 사용량, 온도, 유량, 압력과 같은 값들은 하나의 숫자가 아니라 연속된 수치의 흐름, 즉 배열 형태로 관리된다.
NumPy는 이러한 수치 데이터를 빠르고 효율적으로 처리하기 위해 만들어진 파이썬의 핵심 수치 계산 라이브러리다.
이번 글에서는 NumPy를 단순한 문법 도구가 아니라 에너지 데이터 구조를 이해하고 설계하는 도구로 정리한다.
1. NumPy란 무엇인가?
-
NumPy는 다차원 배열(행렬)을 효율적으로 처리하기 위한 파이썬의 수치 계산 라이브러리다.
-
공식 문서에서는 NumPy를 다음과 같이 정의한다.
- “NumPy is the fundamental package for array computing with Python.”
-
NumPy는 Numerical Python의 약자이다.
-
내부적으로 C 언어 기반으로 구현되어 있어 매우 빠른 연산 속도를 제공한다.
-
NumPy의 핵심 가치는 에너지·설비 데이터를 값의 나열이 아닌 ‘구조화된 수치 데이터’로 다루게 해준다는 점에 있다.
📍 에너지 실무 포인트
에너지 데이터 분석에서 중요한 것은 단일 측정값이 아니라 시간에 따른 변화, 패턴, 집계 구조이다.
NumPy는 이러한 분석의 출발점이 된다.
🔎 개념 확인
하루 전력 사용량 데이터를 분석할 때, 왜 단일 값이 아닌 배열 단위로 접근해야 할까?
2. 행렬과 다차원 배열 (Dimension 개념)
- 행렬은 숫자나 수식을 행(row) 과 열(column) 로 배열한 2차원 구조의 수학적 객체이다.
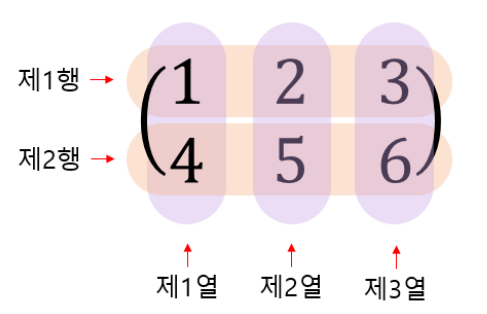
▲ 행(Row)·열(Column) 개념
행(row)은 시간 또는 관측 순서를, 열(column)은 변수 또는 센서를 의미한다.
NumPy의 2차원 배열은 이러한 구조를 그대로 데이터에 적용한다.
-
NumPy는 이 개념을 확장하여, 1차원부터 2차원, 3차원 이상까지의 다차원 배열 구조(
ndarray) 를 지원한다.-
1차원 배열: 값의 나열 (벡터), 예) 하루치 전력 데이터를 1분 간격으로 모은 배열
-
2차원 배열: 행렬, 예) 시간 × 센서 구조의 전력·온도 계측 데이터
-
3차원 이상 배열: 행렬의 집합, 예) 위치 × 설비 × 시간처럼 복수 사이트/설비를 동시에 다루는 로그
-
여기서 중요한 개념이 바로 차원(dimension) 이다.
-
차원(dimension)은 데이터가 몇 단계의 중첩 구조를 가지는지를 의미한다.
-
같은 값이라도 차원과
shape설정에 따라 “해석 방식”이 달라진다.
📍 에너지 실무 포인트
-
1차원 배열 ⇒ 하나의 센서에서 시간 순서대로 수집된 단일 로그
-
2차원 배열 ⇒ 여러 센서 × 시간 구성을 가지는 계측 데이터
-
3차원 이상 배열 ⇒ 위치 × 설비 × 시간처럼 복합적인 계측 구조
차원이 증가한다는 것은 데이터가 복잡해진 것이 아니라, 현실의 계측 구조를 더 정확히 담고 있다는 의미이다.
🔎 개념 확인
shape가 (1440,)인 배열은 어떤 방식으로 수집된 센서 데이터를 의미할까?
3. NumPy의 필요성 (Python 리스트의 한계)
-
Python의 리스트는 각 요소가 객체 포인터로 연결된 구조이다. 값을 저장하는 데는 편리하지만, 대량의 수치 연산에는 비효율적이다.
-
반면 NumPy의 배열(
ndarray)은 다음 특징을 지닌다.-
동일한 자료형으로 구성
-
연속된 메모리 블록 사용
-
브로드캐스팅, 벡터 연산 지원
-
반복문 없이 대량 연산 가능
-
📍 에너지 실무 포인트
리스트는 로그를 보관하기에는 충분하다. 하지만 계산·비교·집계는 반드시 ndarray에서 수행되어야 한다.
즉,
-
리스트 ⇒ 원시 로그
-
ndarray⇒ 분석 대상
🔎 개념 확인
센서 로그를 리스트로만 관리할 경우 어떤 문제가 발생할 수 있을까?
4. NumPy의 활용 분야 및 설치
1) NumPy의 활용 분야
- 과학 계산
- 데이터 분석
- 통계
- 신호 처리
- 이미지 처리
- 시뮬레이션
- 금융 공학
- 인공지능 / 머신러닝
NumPy는 Pandas, SciPy, scikit-learn 등 파이썬 데이터 분석 생태계의 기반이다.
2) NumPy 기본 사용
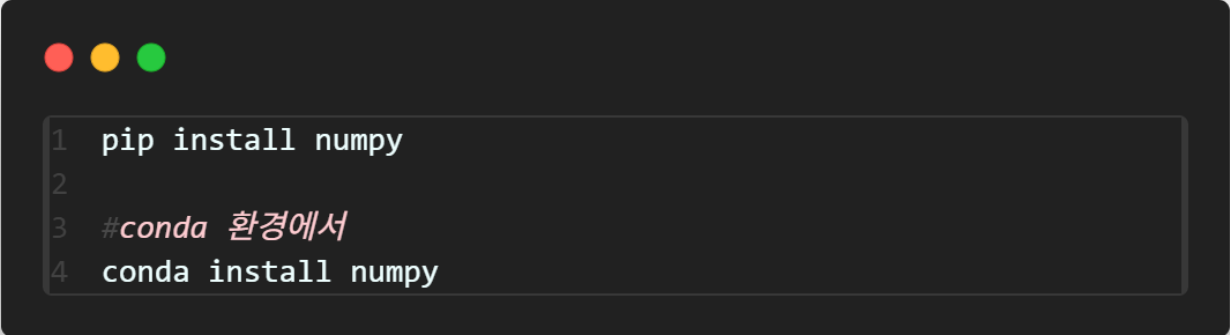
▲ NumPy 설치
NumPy는 pip 또는 conda 환경에서 설치할 수 있으며, 대부분의 데이터 분석 환경에서 기본적으로 사용된다.
- NumPy는 보통
np라는 별칭으로 사용된다.
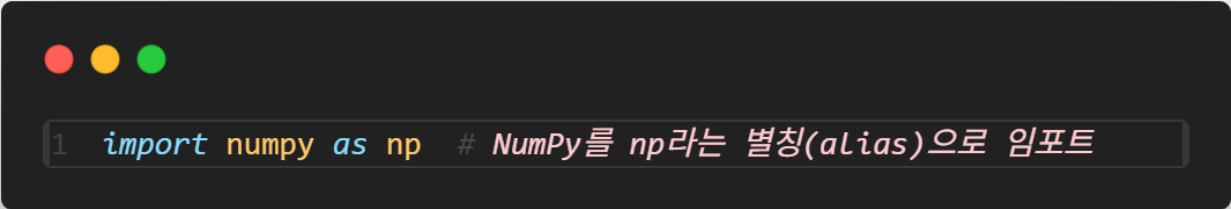
▲ NumPy 임포트 방식
NumPy는 관례적으로 np라는 별칭(alias)으로 임포트하며, 이후 모든 NumPy 함수는 이 별칭을 통해 호출한다.
np.array()를 통해 리스트나 튜플을 배열로 변환한다.
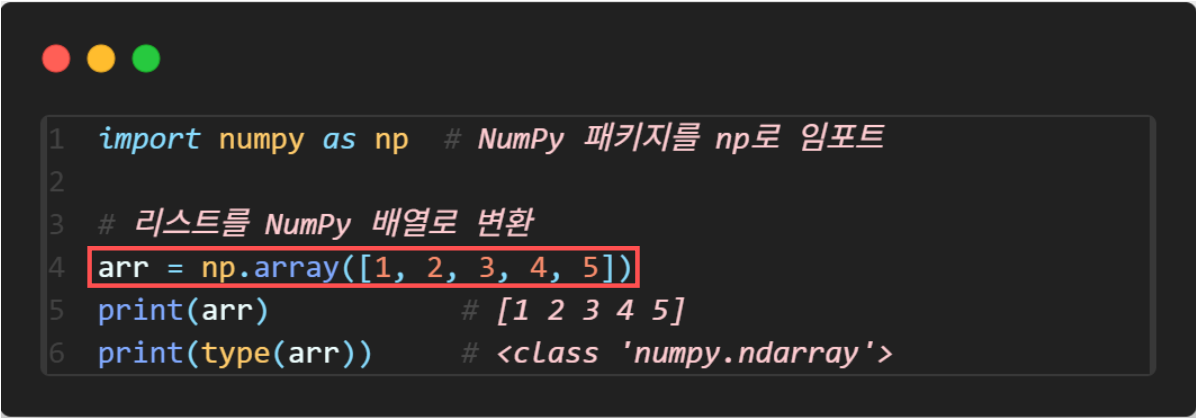
▲ Python 리스트 → ndarray 변환
np.array()를 사용하면 Python 리스트를 NumPy의 핵심 자료구조인 ndarray로 변환할 수 있다.
📍 에너지 실무 포인트
BEMS, IoT 계측 데이터 처리 역시 NumPy 배열 구조를 기반으로 진행된다.
5.
ndarray개념과 특징
-
ndarray는 NumPy의 핵심 데이터 구조이다. 모든 NumPy 연산은 결국 이 배열을 중심으로 이뤄진다. -
ndarray의 주요 속성-
shape: 배열의 구조를 나타내며 각 차원의 크기를 의미한다. -
ndim: 배열이 가지는 차원의 개수 -
size: 배열 전체 원소의 개수 -
dtype: 배열을 구성하는 전체 데이터의 자료형
-
⇒ 이 네 가지 속성은 센서 데이터가 어떻게 수집·저장되고 있는지를 읽어내는 기본 지표이다.
예를 들어,
-
shape = (1440, 5)- 1440: 하루 1분 단위 시간축
- 5: 센서 개수
-
dtype = float64- 실수형 전력·온도·유량 데이터
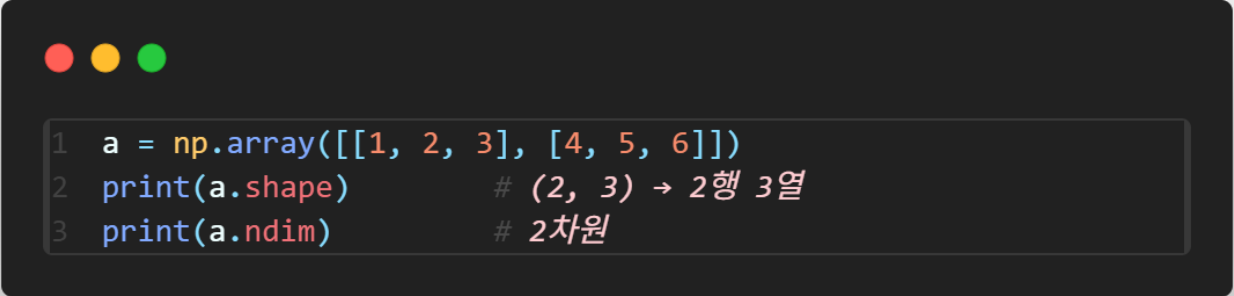
▲ 배열의 shape와 ndim
shape는 배열의 행·열 구조를, ndim은 배열의 차원 수를 나타낸다. 이는 센서 데이터의 수집 구조를 파악하는 핵심 지표이다.
-
특징
-
동일한 자료형(
dtype)을 가지는 다차원 배열 -
고정된 크기 (생성 후에는 보통 크기를 자주 바꾸지 않음)
-
수치 계산에 최적화된 연속 메모리 구조
-
벡터화 연산, 브로드캐스팅 등 대량 연산에 특화
-
즉, NumPy에서 다루는 모든 데이터는 결국 ndarray 형태로 표현되고 연산되며, 이는 센서·계측 데이터의 특성과 정확히 맞아떨어지는 구조이다.
dtype

▲ dtype 확인
NumPy 배열은 모든 요소가 동일한 자료형(dtype)을 가지며, 시스템 환경에 따라 기본 정수형이 달라질 수 있다.
-
ndarray의 모든 요소는 동일한 자료형(dtype)을 가진다. -
주요 dtype 예시:
int32,int64float32,float64bool,complex
-
astype(): 배열의 자료형을 명시적으로 변환할 수 있다.
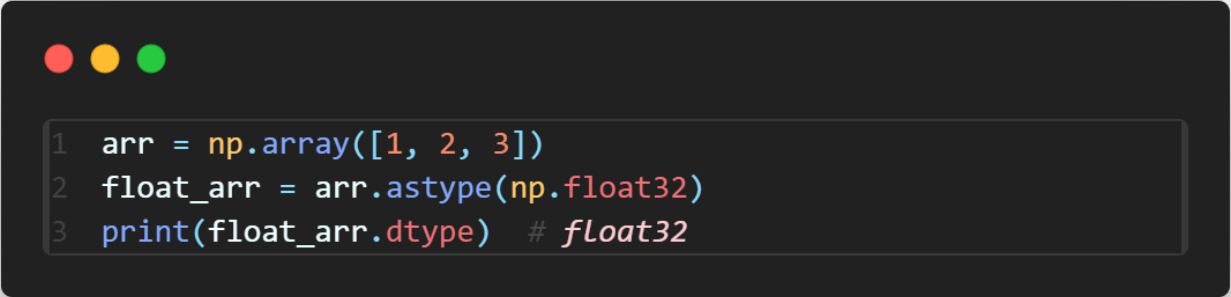
▲ astype을 이용한 자료형 변환
astype()을 사용하면 배열의 자료형을 명시적으로 변환할 수 있으며, 계산 정확도와 메모리 사용량을 조절할 수 있다.
📍 에너지 실무 포인트
센서 데이터는 의미가 명확한 수치 데이터이며, 일정한 시간 간격과 동일한 단위를 가진다.
ndarray는 이러한 실무 조건을 전제로 설계된 구조다.
에너지 분석에서는 대부분 실수형(float) 데이터를 사용한다. 자료형 관리가 곧 계산 정확도 관리이다.
🔎 개념 확인
전력·온도·유량 데이터가 서로 다른 값임에도 동일한 구조로 관리될 수 있는 이유는 무엇일까?
센서 데이터에서 dtype이 섞이면 어떤 문제가 발생할 수 있을까?
6. Python list VS ndarray
1) Python의 list
-
다양한 자료형을 담을 수 있는 가변 길이의 시퀀스 자료형
-
1차원부터 n차원까지 중첩 리스트로 표현 가능하지만, 명시적인 다차원 구조는 없음
-
원소로 여러 가지 자료형을 허용
-
내부 배열의 원소 개수가 달라도 됨
-
(원소 간) 빼기, 곱하기, 나누기 같은 원소 단위 연산이 바로 되지 않음
2) NumPy의 ndarray
-
동일한 자료형의 데이터를 정해진 크기의 다차원 배열로 저장
-
수치 계산에 최적화된 자료구조이며, 내부적으로 C언어 기반의 연속 메모리 구조 사용
-
원소로 한 가지 자료형만 허용
-
내부 배열의 원소 개수가 같아야 함
-
산술 연산: 같은 위치의 원소끼리 연산 (벡터화)
📍 에너지 실무 포인트
-
리스트: 수집 단계 (원시 로그 저장용)
-
ndarray: 분석·연산 대상
센서 로그를 리스트로만 관리하면 시간 축 집계, 평균, 비교 연산이 복잡해진다.
🔎 개념 확인
어느 시점에서 리스트를 ndarray로 변환하는 것이 적절할까?
7. Axis : 집계 방향을 결정하는 축
-
차원(dimension)이 데이터의 구조를 의미한다면, 축(axis)은 데이터가 어느 방향으로 연산되는지를 의미한다.
-
NumPy의 다차원 배열에서는 같은 데이터라도 axis 설정에 따라 완전히 다른 의미의 결과가 만들어진다.
-
예를 들어,
shape가(1440, 5)인 배열이 있다고 가정하자.-
1440 → 하루 동안의 시간 데이터 (1분 단위)
-
5 → 설치된 센서 개수
-
axis=0: “위에서 아래로” 내려가며, 각 열(column) 방향으로 집계- 센서별 평균, 센서별 최대값 등에 사용
-
axis=1: “왼쪽에서 오른쪽으로” 가며, 각 행(row) 방향으로 집계- 해당 시각에 모든 센서를 합산한 총 부하 등에 사용
-
📍 에너지 실무 포인트
-
시간 기준 집계인지, 센서 기준 집계인지에 따라 axis 선택은 완전히 달라진다.
-
axis 설정은 단순한 문법 옵션이 아니라, “어떤 관점에서 데이터를 바라볼지”를 결정하는 분석 설계 요소이다.
🔎 개념 확인
센서별 평균 전력과 하루 동안의 총 전력 프로파일을 계산할 때 각각 어떤 axis를 사용해야 할까?
8. 배열 생성과 초기화
NumPy는 값을 채우기 전에 배열의 구조를 먼저 만든다. 이는 실시간 계측·버퍼링 구조에서 매우 중요한 개념이다.
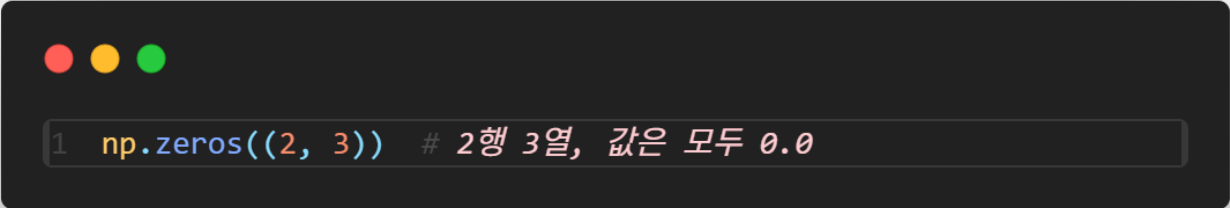
np.zeros(shape): 모든 값을 0으로 초기화
▲ zeros() 배열 생성
zeros()는 지정한 형태의 배열을 0으로 초기화한다.
구조를 먼저 만들고 값을 채우는 NumPy의 기본 철학을 보여준다.
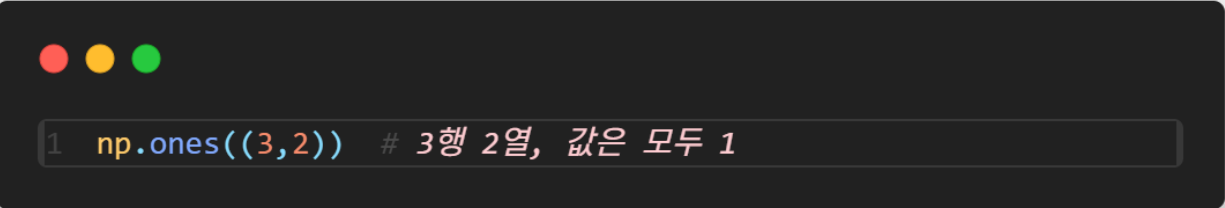
np.ones(shape): 모든 값을 1로 초기화
▲ ones() 배열 생성
ones()는 모든 값이 1인 배열을 생성하며, 테스트용 데이터나 기준 배열로 활용된다.
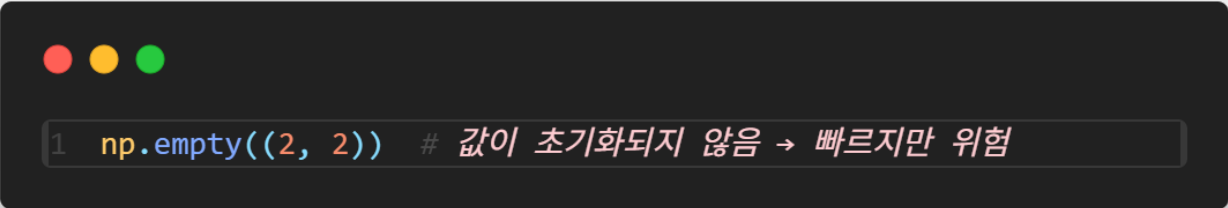
np.empty(shape): 초기화되지 않은 값 (쓰레기 값)
▲ empty() 배열 생성
empty()는 메모리 공간만 할당하고 값을 초기화하지 않는다.
속도는 빠르지만 쓰레기 값이 포함될 수 있어 실무에서는 주의가 필요하다.
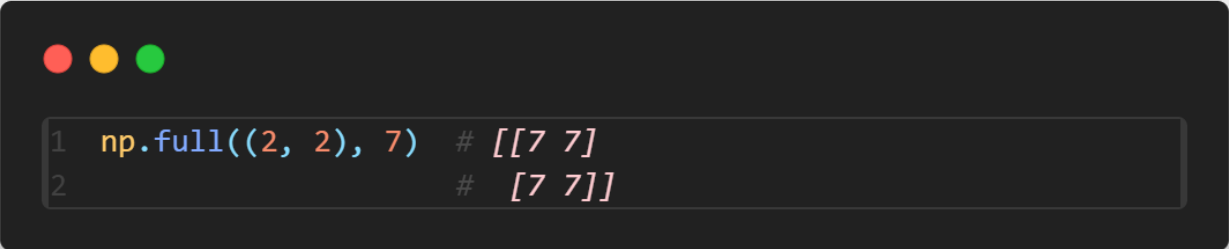
np.full(shape, value): 지정한 값으로 초기화
▲ full() 배열 생성
full()은 지정한 형태의 배열을 특정 값 하나로 초기화한다.
테스트용 상수 배열이나 기준값을 가진 데이터 구조를 만들 때 사용된다.
-
np.eye(N, M=None, k=0): 대각선에 1, 나머지에 0을 채운 2차원 배열을 생성하는 함수-
N: (필수) 행(row)의 수 -
M: (선택) 열(column)의 수, 생략하면M = N으로 처리되어 정방 행렬 생성 -
k: (선택) 1이 위치할 대각선의 인덱스(기본값은 0, 주대각선) -
단위행렬은 행렬 곱 연산에서 기준 역할을 한다.
-
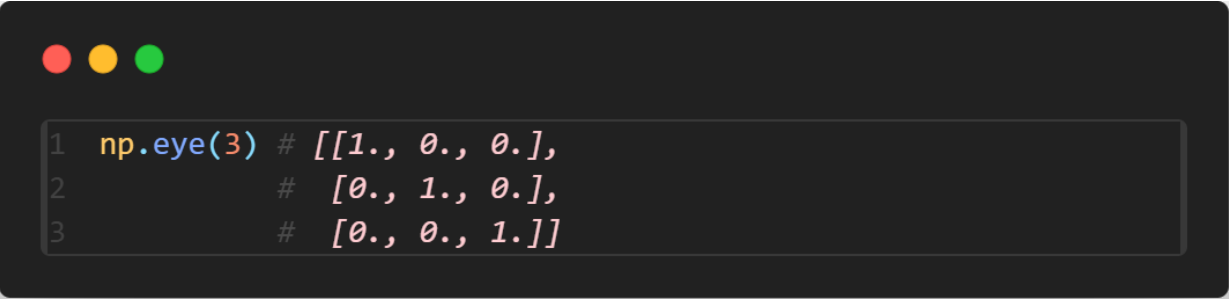
▲ eye() 단위행렬 생성
eye()는 대각선 요소가 1인 단위행렬(identity matrix)을 생성한다.
행렬 연산에서 기준(reference) 역할을 한다.
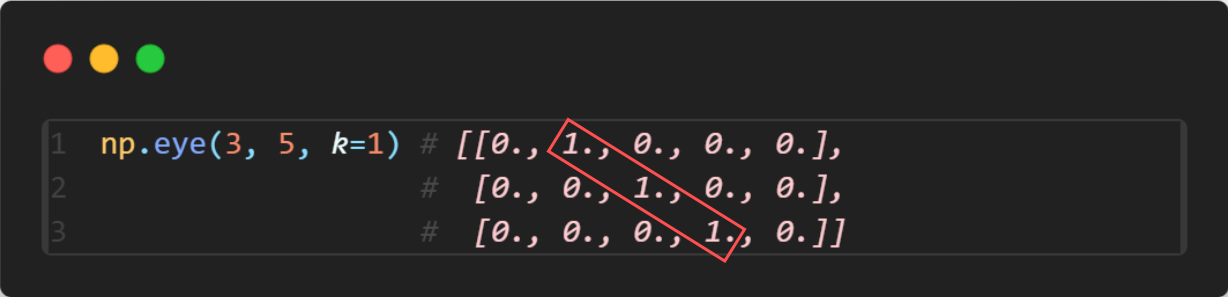
▲ eye()의 k 옵션
k 옵션을 사용하면 대각선의 위치를 위(+), 아래(–)로 이동할 수 있다.
비정방 행렬이나 보정 계수 모델링에 활용된다.
📍 에너지 실무 포인트
실무에서는 데이터가 들어오기 전이라도 수집 구조를 먼저 확보해야 한다.
특히 초기값 선택은 중요하다.
0⇒ 실제 측정값과 구분 불가NaN⇒ “아직 측정되지 않음”을 의미하는 상태 값
🔎 개념 확인
하루치 데이터 버퍼를 0이 아닌 NaN으로 초기화하는 이유는 무엇일까?
9. 범위 기반 배열 생성
-
np.arange(start, stop, step):range()와 유사한 함수- 시작(
start) 이상 ~ 끝(stop) 미만의 정수 배열을step간격으로 생성
- 시작(
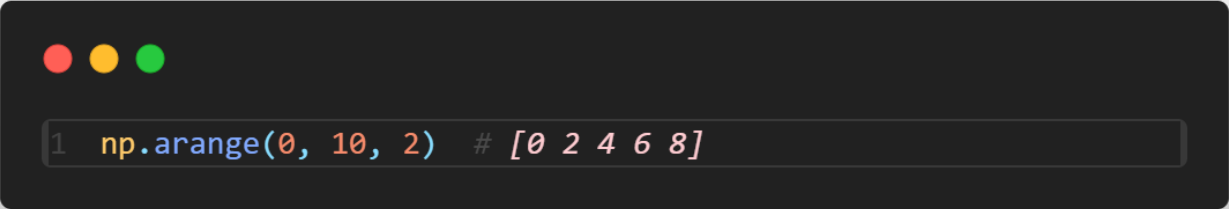
▲ arange() 범위 기반 배열
arange()는 일정한 간격(step)으로 값을 생성하는 함수로,
샘플링 간격이 중요한 계측 데이터에 적합하다.
-
np.linspace(start, stop, num)- 시작(
start) ~ 끝(stop)까지 균일 간격으로num개 생성
- 시작(
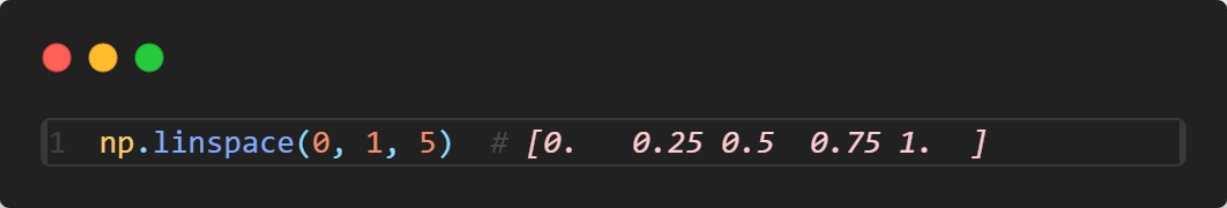
▲ linspace() 균등 분할 배열
linspace()는 시작과 끝 구간을 동일한 개수로 분할한다.
시간 구간 해석이나 비율 기반 분석에 자주 사용된다.
📍 에너지 실무 포인트
-
arange⇒ 샘플링 간격 기반 데이터 -
linspace⇒ 시간 구간 균등 분할 데이터
🔎 개념 확인
1분 단위 계측과 24시간 균등 분할 데이터는 각각 어떤 방식이 더 적합할까?
10. 난수 배열 생성
np.random.rand(m, n):m × n크기의 배열 생성 및 0 ~ 1 사이의 난수로 초기화
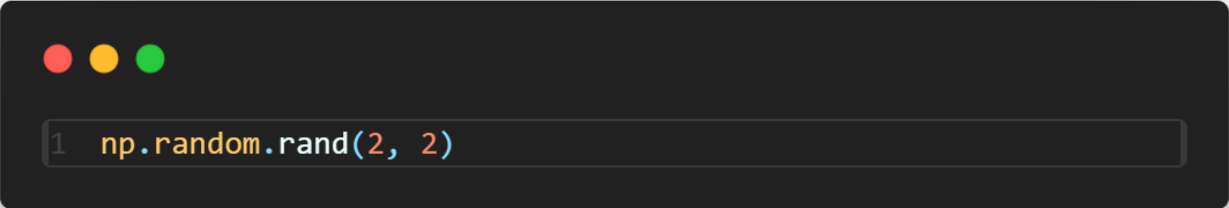
▲ random.rand() 난수 생성
rand()는 0 이상 1 미만의 균등분포 실수를 생성한다.
테스트 데이터나 시뮬레이션 입력값에 활용된다.
np.random.randn(m, n):m × n크기의 배열 생성 및 표준 정규분포(평균 0, 분산 1)를 따르는 난수로 초기화
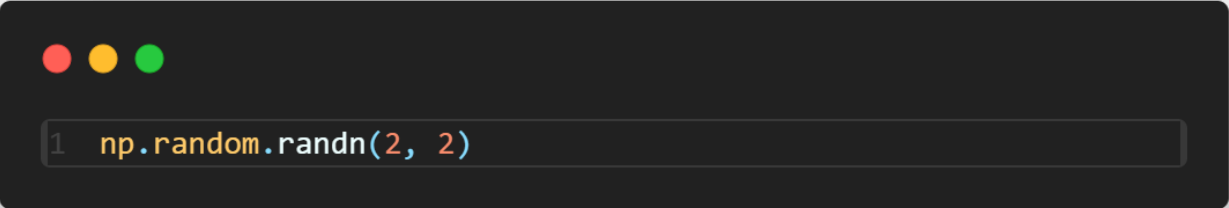
▲ random.randn() 정규분포 난수
randn()은 평균 0, 표준편차 1의 정규분포 난수를 생성한다.
노이즈 모델링이나 오차 시뮬레이션에 적합하다.
np.random.randint(low, high, size):low이상high미만의 숫자로size형태의 정수 배열 생성
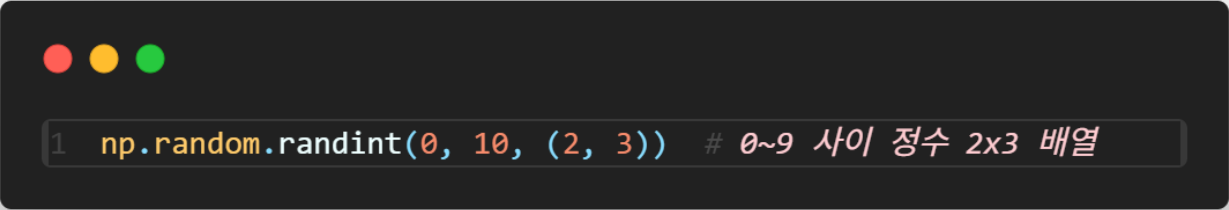
▲ randint() 정수 난수 배열
randint()는 지정한 범위의 정수 난수 배열을 생성한다.
상태 코드, 구간 인덱스 테스트에 자주 사용된다.
np.random.seed(): 시드는 난수 생성기의 시작값 → 같은 시드를 주면 항상 같은 결과를 얻을 수 있음
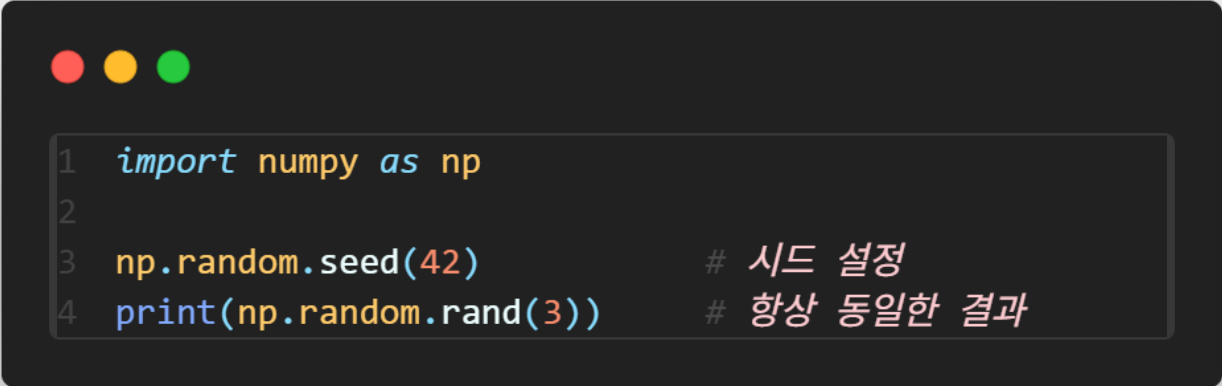
▲ seed()를 이용한 난수 고정
seed()를 설정하면 난수 생성 결과를 항상 동일하게 재현할 수 있다.
실험 검증과 결과 비교를 위해 필수적인 과정이다.
- 이러한 문제를 해결하기 위해 NumPy는 난수 생성을 객체 단위로 관리하는 Generator(RNG) 구조를 도입했다.
정리하자면,
-
간단한 실습이나 연습 코드 →
np.random.seed()방식으로도 충분하다. -
프로젝트·시뮬레이션·연구 코드 →
default_rng()기반의 Generator 사용을 권장한다.
📍 에너지 실무 포인트
난수는 테스트, 시뮬레이션, 이상 상황 가정에 사용된다.
11. Generator (RNG) 개념
-
NumPy에서 독립적으로 난수를 생성하고 관리할 수 있는 Generator 클래스 기반의 난수 생성기
-
NumPy 개발팀은 향후 Generator 기반의 RNG 사용을 표준 방식으로 권장
-
기존 방식(
np.random.seed)의 한계: 전역 상태를 사용하여 코드 전반에서 예측이 어려움 -
Generator(RNG)로는 간섭하지 않는 독립적인 난수 시퀀스 생성 가능
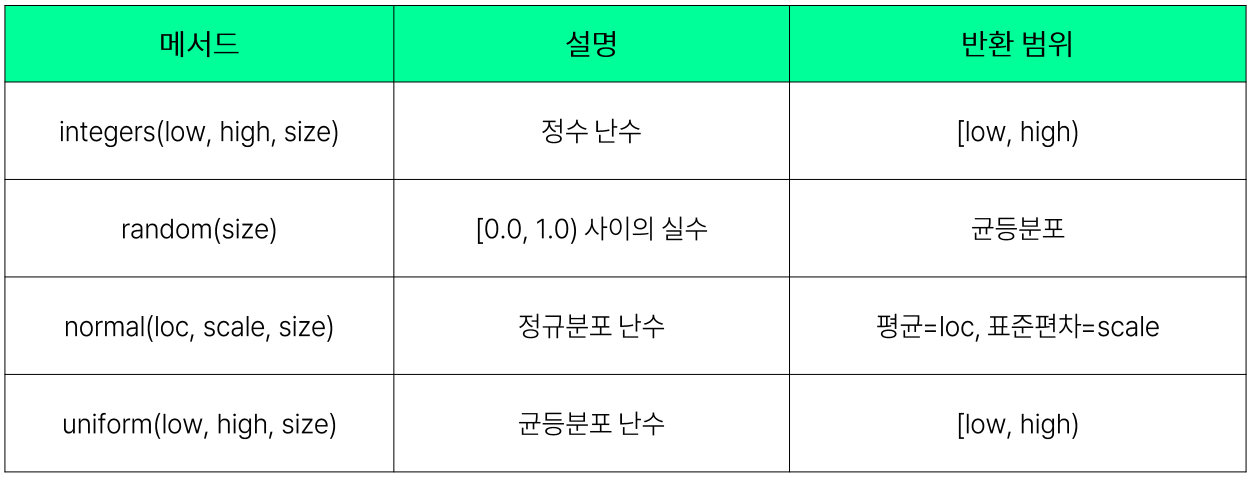
▲ Generator(RNG) 기반 난수 함수
NumPy는 전역 난수 방식 대신 Generator(RNG) 기반 난수 생성을 권장한다.
독립적인 난수 흐름 관리와 실험 재현성을 확보할 수 있다.
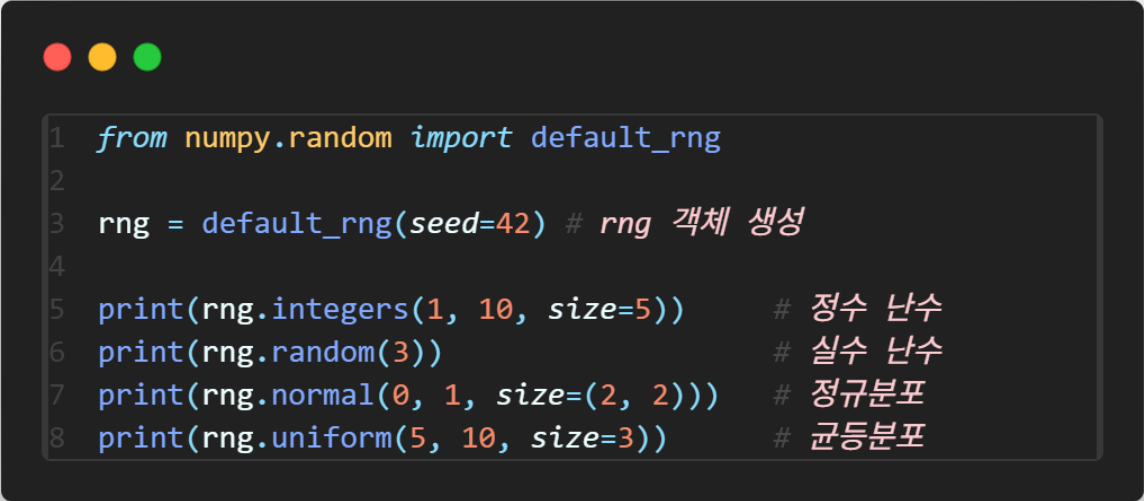
▲ default_rng() 기반 난수 생성 (Generator)
default_rng()는 NumPy가 권장하는 Generator(RNG) 객체 생성 방식이다.
난수 생성기를 객체로 분리해 관리함으로써,
서로 다른 실험에서도 독립적이고 재현 가능한 난수 흐름을 유지할 수 있다.
📍 에너지 실무 포인트
시뮬레이션·예측 모델 테스트에서는 재현 가능한 난수 구조가 필수다.
🔎 개념 확인
난수 재현성이 중요한 이유는 무엇일까?
12. 실무 확장 예제
실무 예제 1. 하루 전력 데이터 버퍼 생성 (1분 단위)
📌 언제 쓰나
-
스마트미터 / BEMS에서 하루 단위 전력 로그 수집
-
실시간 데이터가 들어오기 전, 저장 구조 선세팅
🎯 핵심 포인트
-
NumPy는 값을 채우기 전에 구조부터 만든다.
-
1440 = 24시간 × 60분
-
시간축 기반 데이터 모델링의 출발점
실무 예제 2. 결측(NaN) 기반 초기 버퍼
📌 언제 쓰나
-
센서 통신 전 / 장애 구간 / 점검 시간
-
“아직 값이 없음”을 명확히 표현해야 할 때
🎯 핵심 포인트
-
0은 실제 측정값일 수 있음 → 위험 -
NaN은 결측 상태를 의미 (NaN은 오류가 아니라 상태 정보이다.) -
이후 평균, 합계 계산 시 자동 제외 처리 가능
실무 예제 3. 여러 센서 동시 수집 구조
📌 언제 쓰나
-
여러 설비 / 회로 / 센서를 동일 시간축으로 수집할 때
-
센서별 비교, 합산, 평균 분석이 필요할 때
🎯 핵심 포인트
-
(1440, 5)→ 시간 × 센서 -
행(row) = 시간
-
열(column) = 센서
13. 한눈에 보기(핵심 정리)
-
NumPy ⇒ 수치 데이터를 배열 구조로 처리하는 파이썬 핵심 라이브러리
-
ndarray⇒ 동일한 자료형을 가지는 다차원 배열, 센서·계측 데이터의 기본 단위 -
dtype⇒ 배열 전체 데이터의 의미를 결정, 전력·온도·유량 = 보통float -
shape/ndim/size⇒ 데이터 구조를 읽는 지표, 계측 방식과 센서 구성을 파악하는 단서 -
NaN⇒ 값 0이 아닌 결측 상태 표현, 실무 데이터 신뢰도를 지키는 핵심 요소
NumPy는 단순히 배열을 만드는 도구가 아니라, 에너지 데이터의 구조를 설계하는 도구이다.
14. 아웃트로
NumPy를 안다는 것은 배열 문법을 아는 것이 아니라,
에너지 데이터를 어떤 구조로 바라볼지 결정하는 일이다.
다음 편에서는 이 구조 위에서 데이터를 실제로 다루는 방법, 인덱싱과 슬라이싱을 정리한다.