[Paper Review] - Do All Visual Tokens Matter Equally? Object-Evidence Preserving Token Merging for Vision-Language Retrieval (arXiv 2026)
[Paper Review]
[1. 문제 의식/Motivation]
- Multi-Vector vision-language Retrieval의 가장 큰 문제는 이미지 하나당 visual token을 수백~1000개가 넘는 visual token embedding을 저장해야함.
- 이미지가 많아질수록 retrieval index의 저장 공간이 크게 증가하고, query token과 모든 visual token을 비교해야 하므로 연산량과 retrieval latency도 증가함
- 이를 해결하기 위해 선행 연구에서는 visual token을 줄이는 pruning, pooling, merging 등의 compression 방법을 사용함
- 하지만 retrieval에서는 어떤 visual token이 중요한지가 미리 정해져 있지 않고, 어떤 query가 들어오는지에 따라 visual token의 중요도가 달라짐
- 예를 들어 동일한 이미지에 대해서도 어떤 query는 작은 객체에 의존하고, 다른 query는 속성에 의존하고, 또 다른 query는 관계에 의존함
- 기존 방식들
- pruning 방식을 통해 현재 중요하지 않아 보이는 visual token을 제외하게되면, 이후 특정 query에서는 해당 visual token이 필요할 경우 이를 복구할 수 없다는 문제가 있음
- Feature similarity 기반 merging은 비슷한 특징을 가진 visual token들을 하나의 representative token으로 합쳐 token 수를 줄일 수 있음
- 하지만 서로 다른 object instance임에도 visual feature가 유사한 경우, 해당 token들이 동일한 representation으로 합쳐질 수 있음
- 이로 인해 object-instance 구분 정보가 손실될 수 있음
[2. Main Contribution]
- 이 연구의 핵심은 단순히 visual token을 줄이는 문제(visual-token compression)가 아니라
- 압축 이후에도 query가 필요로 하는 객체나 visual evidence가 남아있도록 압축하는 것
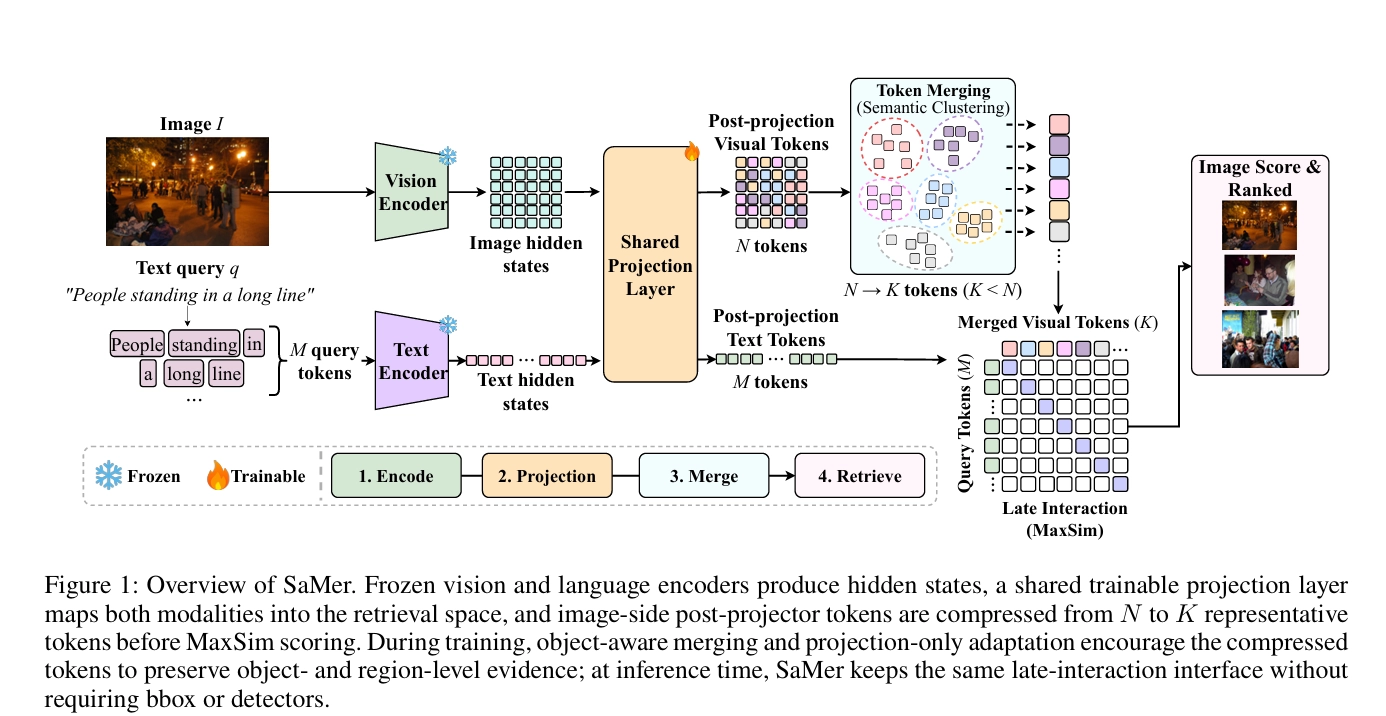
- 이를 위해 SaMer(Semantic-aware Merging)라는 object-aware visual token merging 방법을 제안
- Visual token을 병합할 때 feature similarity와 spatial information을 함께 고려하여, 의미적으로 비슷하고 위치적으로 가까운 token들이 같은 representative에 모이도록 함
- 또한 Soft Assignment를 통해 각 token이 여러 representative에 가중치를 두고 기여하도록 함
- 학습 과정에서는 bbox 기반 object annotation을 merge prior로 사용하여, 서로 다른 object instance의 token들이 하나의 representative에 섞이는 것을 억제함
- 추론 시에는 bbox annotation이나 object detector 없이 token merging을 수행
- (K=64)에서 visual token의 93% 이상을 줄이면서도 Flickr30K와 MSCOCO에서 full-token baseline보다 높은 retrieval 성능을 보였으며, storage와 MaxSim 연산량도 크게 감소시킴
[3. Proposed Method]
- 본 논문에서의 framework는 세단계로 구성됨
[1.Post-projector Visual Token Merging]
- 목적
- 원래 이미지 하나는 N개의 visual token으로 표현됨
- SaMer는 이를 K개의 representative token으로 압축함
- 이렇게 하면 retrieval index에 저장해야 하는 token 수와 MaxSim 비교 연산량을 줄일 수 있음
- 중요한 점은 Vision Encoder나 MaxSim 구조 자체는 바꾸지 않는다는 것
- 그렇다면 어떤 visual token들끼리 merging 할것인가???
- SaMer은 각 visual token을 어느 representative token에 넣을지 결정할 때 두가지를 고려
- feature similarity
- 의미적으로 비슷한 token끼리 묶음
- Spatial information
- 이미지 안에서 위치가 가까운 token끼리 묶음
- 시각적으로 유사하지만 공간적으로 멀리 떨어진 영역들이 지나치게 merge 되는것을 억제
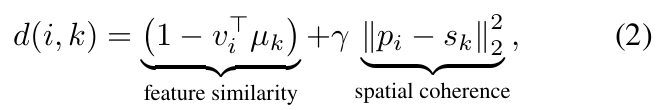
- Soft assignment
- 각 visual toekn을 하나의 representative 하나에 넣는 hard assignment 방식이 아닌, 여러 representative에 가중치를 나눠서 할당함.
- 압축된 각 representative는 할당된 visual token들의 weighted average로 생성됨
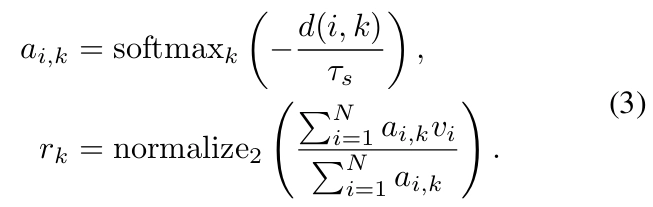
[2. Object-aware Merge Prior]
-
문제점
- Feature + Spatial 정보를사용해도 서로 다른 object instance가 같은 representative에 섞일 수 있음
- 예를 들어 Person A와 Person B가 시각적으로 유사하면 두 객체의 visual token이 하나의 representative에 합쳐질 수 있음
- 이렇게 되면 서로 다른 객체를 구분하는 object-level evidence가 손실될 수 있음
-
해결방법
- 학습시 bbox annotation을 이용해 각 visual token이 어떤 object instance에 속하는지 label을 부여
- 먼저 feature-spatial distance만 이용해 임시 hard assignment 수행
- 이 hard assingment는 실제 merged token을 만들기 위한것이 아니라
- 각 representative가 현재 어떤 obejct label의 visual token들로 구성되어 있는지 확인하기 위한 용도
- 각 representative
k에서 가장 많이 포함된 bbox label을 해당 representative의 dominant object label로 간주 - 이후 visual token
i를 representativek에 할당할 때- token
i의 bbox label이 representativek의 dominant label과 같으면 penalty를 작게 부여 - 서로 다른 object instance의 label을 가지면 penalty를 크게 부여
- token
- 즉, 같은 object에 속하는 token은 같은 representative로 잘 모이게 하고, 서로 다른 object에 속하는 token은 같은 representative에 섞이지 않도록 유도 → object-aware penalty
-
Soft assignment 전체 과정
- object-aware penalty를 기존 feature-spatial distance에 추가
- 최종 assignment weight는 다음과 같이 계산
- : 각 visual token i가 representative k에 얼마나 속하는지를 나타내는 soft assignment weight
- merged token 생성 (6)
- 각 representative는 자신에게 할당된 token들을 assignemt weight로 가중 평균하여 생성
- 즉, 특정 representative와 관련성이 높은 token일수록 representative k의 centroid 생성에 더 크게 반영됨
- 이렇게 생성한 representative를 Maxsim scoring에 사용
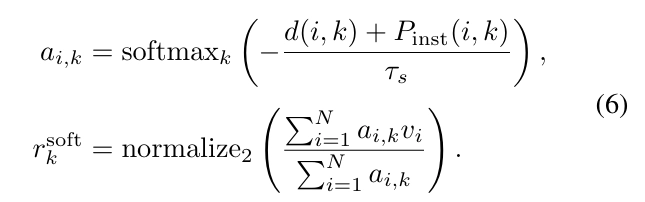
- 학습 시 역할
- bbox annotation 자체를 별도의 loss로 사용하는 것은 아님
- bbox 기반 penalty가 soft assignment weight를 변화시킴
- 변화된 assignment를 통해 merged centroid가 만들어지고, 이 centroid로 retrieval loss를 계산
- 따라서 gradient가 projection embedding과 merged centroid에 전달되면서
- 같은 object의 token은 더 잘 모이고
- 다른 object instance의 token은 덜 섞이는 방향으로 projection space가 학습됨
- 추론 시
- bbox annotation이나 object label은 사용하지 않음
- feature-spatial distance만 이용해 soft assignment 수행
- 학습 과정에서 object-aware prior의 영향이 projection space에 반영되어 있기 때문에
- 추론 시 bbox 없이도 object-consistent한 merging을 유도할 수 있음
[3. Compression-Aware Projection-Only Adaptation]
- 문제점
- 기존 multi-vector retriever는 원래
N개의 visual token을 모두 사용해서 MaxSim scoring하도록 학습되어 있음 - 하지만 SaMer는
N개의 token을K개의 merged token으로 압축해서 scoring함 - 즉,
- 기존 학습 환경:
N개 token 기반 representation - SaMer 적용 환경:
K개 merged token 기반 representation
- 기존 학습 환경:
- 따라서 기존 projection space가 압축된 representation에 최적화되어 있지 않을 수 있음
- 특히
K가 작아질수록 정보가 많이 합쳐지기 때문에 representation mismatch가 커질 수 있음
- 기존 multi-vector retriever는 원래
- 해결방법
- vision encoder와 language backbone은 고정
- image-text shared projection layer만 adaptation / 학습시킴
- 즉, backbone 자체를 다시 학습하는 것이 아니라
- visual/text feature를 retrieval space로 보내는 projection layer만
- 압축된
K개의 merged token에 잘 맞도록 재학습 - 새로운 retrieval architecture를 추가하지 않고 기존 구조를 그대로 유지
- 왜 projection layer만 학습하는가???
- SaMer의 token merging 자체는 non-parametric
- 즉, merging을 위한 별도의 학습 가능한 파라미터가 없음
- merged centroid는 soft assignment와 weighted average를 통해 projected visual embedding을 이용해 계산됨
- Retrieval loss
- SaMer는 compressed MaxSim score 를 이용해 multi-positive InfoNCE loss를 사용
- query와 positive image의 compressed score는 높이고, negative image의 compressed score는 낮추도록 학습
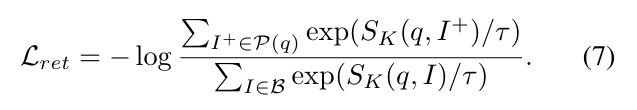
- notation
- P(q)
- query
q와 positive 관계인 image들의 집합
- query
- B
- 현재 batch 안의 모든 candidate image
- K개의 merged token을 이용한 compressed MaxSim score
- P(q)
[4. Experiments - Setting]
- 평가 데이터셋
-
Flickr30K: in-domain
-
MSCOCO: cross-dataset generalization (cross domain)
💡Flickr30K와 MSCOCO는 자연 이미지에 대한 text-to-image retrieval을 평가하며, query는 종종 자연 장면 속 객체, 속성, 관계를 참조
-
ImageCoDe: 시각적으로 유사한 이미지 사이에서 작은 객체/속성/관계 차이를 구분하는 능력 평가
-
DocVQA: OCR/layout 중심 문서 도메인으로, SaMer의 object-centric compression이 잘 맞지 않는 boundary case
- 문서 이미지 자체를 대상으로하는 visual retrieval
-
- 평가 지표
- R@1, R@5, nDCG@10
- 실험 설정
- SaMer는 image-side token을
K=64개로 압축 - ColPali, ColQwen2 같은 multi-vector retriever에 적용
- training-free와 projection adaptation 설정 모두 평가
- adaptation 시 backbone은 고정하고 shared projection layer만 3 epoch 학습
- SaMer는 image-side token을
- 비교 baseline
- Single-vector: CLIP 계열
- VLM-based: VLM2Vec-v2, GME, VisRAG
- Multi-vector: ColPali, ColQwen2
- ColPali는 PaliGemma 계열 VLM을 기반 → visual token embedding
- ColQwen2는 Qwen2-VL 계열 backbone을 기반으로 → visual token embedding
- Compression baseline: H-Pool, HPC, SAP
- H-pool : 비슷한 token들을 계층적 클러스터링(hierarchical clustering) 으로 묶고, 같은 cluster의 token들을 평균내서 하나의 vector로 만듦.
- feature similarity를 기준으로 묶는 방식
- HPC : attention으로 중요한 patch를 골라 덜 중요한 token은 pruning하고, 남은 embedding은 quantization까지 해서 저장 공간을 줄인다. 즉 “합치기”보다는 중요한 patch를 남기고 나머지를 제거하는 방식이 중심
- SAP: transformer의 중간 layer에서 attention 구조를 보고 문서/이미지의 구조를 대표하는 structural anchor token을 골라 남기고 나머지는 pruning
- H-pool : 비슷한 token들을 계층적 클러스터링(hierarchical clustering) 으로 묶고, 같은 cluster의 token들을 평균내서 하나의 vector로 만듦.
[4.1 Experiments - Result]
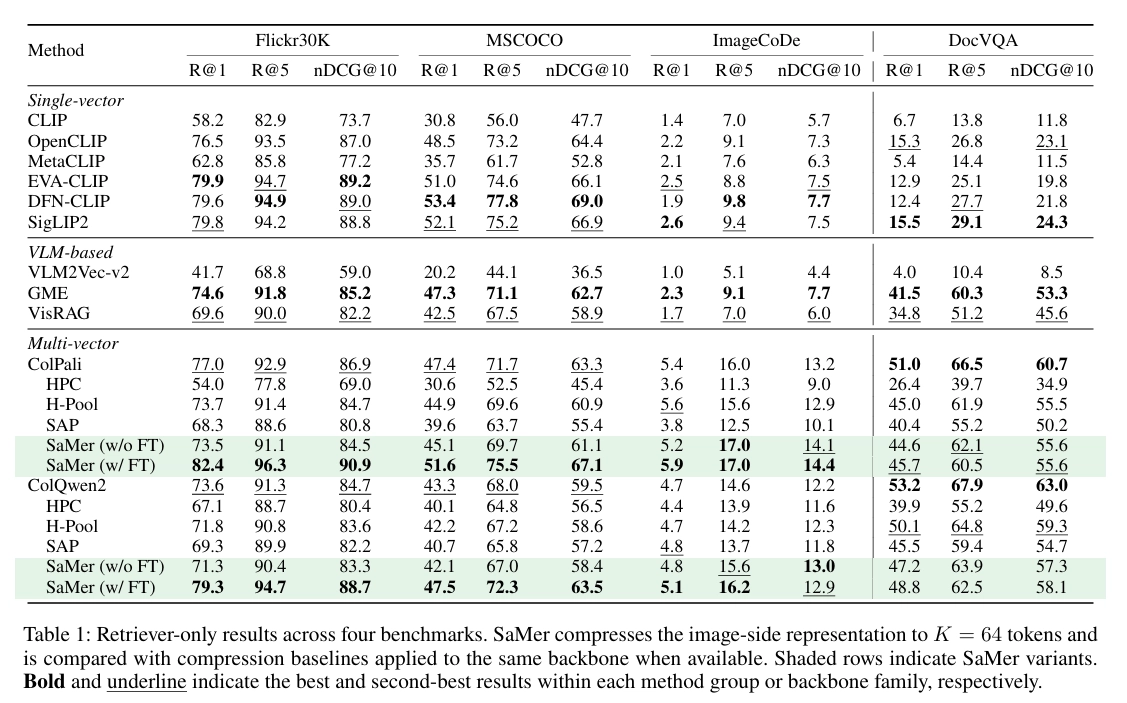
주요 결과
- Flickr30K에서 가장 큰 개선
- ColPali R@1:
77.0 → 82.4 - ColQwen2 R@1:
73.6 → 79.3
- ColPali R@1:
- MSCOCO에서도 개선
- ColPali R@1:
47.4 → 51.6
- ColPali R@1:
- ImageCoDe에서도 미세한 object evidence를 유지하며 성능 향상
- ColPali R@1:
5.4 → 5.9 - nDCG@10:
13.2 → 14.4 - ImageCoDe에서는 다양한 object-level evidence를 잘 보존하는 SaMer의 장점이 드러나고
- ColPali R@1:
- H-Pool, HPC, SAP 같은 기존 compression baseline보다 대체로 우수
- DocVQA에서는 이점이 상대적으로 작음
- 이유는 document retrieval이 object보다
- OCR token, layout cue
- 에 더 의존하기 때문
- aggressive compression이 희소한 text evidence를 제거할 수 있음
- 이유는 document retrieval이 object보다
[5. Ablation Study]
[1. 성능 향상이 단순히 Adaptation 때문인가??]
- SaMer에는 성능을 높일 수 있는 요소가 두개가 있음
- Projection-only Adaptation
- Object-aware Merging
SaMer 방식은 기존 compression된 representation에 맞게 projection layer를 3 epoch 다시 학습
SaMer의 merge 방식이 특별한 게 아니라, 그냥 projection layer를 fine-tuning해서 성능이 오른 거 아니야? 라는 의문점이 생길 수 있고, 이부분을 검증하고자 함.
Adaptation이라는 변수를 통제함
만약에 성능 차이가 난다면 그 차이는 어떤 방식으로 64개의 visual token을 만들었냐의 차이
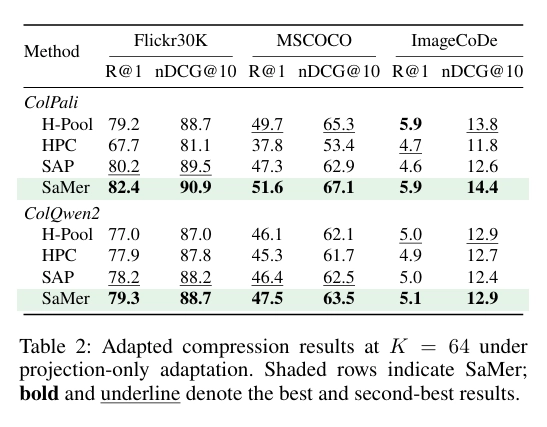
- 비교 조건
- 동일한 frozen backbone 사용
- 동일한 projection-only adaptation 적용
- 동일한
K=64token budget 사용
- 결과
- SaMer가 H-Pool, HPC, SAP보다 Flickr30K, MSCOCO, ImageCoDe에서 대체로 가장 높은 성능 달성
- 의미
- SaMer의 성능 향상이 단순히 projection layer를 fine-tuning해서 발생한 것이 아님
- 동일한 adaptation 조건에서도 SaMer가 더 높은 성능을 보이므로 merge 방식 자체가 효과적임
- 특히 서로 다른 object instance의 token이 하나의 representative에 섞이는 것을 억제하여 object/region-level evidence를 더 잘 보존
[2. Compression Budget Analysis]
- 목적
- merged token 개수 K를 얼마나 줄여도 retrieval 성능을 유지할 수 있는지 확인
- 즉, compression 효율과 retrieval quality 사이의 trade-off 분석
- 결과
K=32 → 64로 증가할 때 성능이 눈에 띄게 향상- 하지만
K=64이후에는 token 수를 늘려도 성능 향상이 매우 작음
이는 이러한 benchmark에서 소수의 merged token만으로도 대부분의 retrieval performance를 보존하기에 충분하다는 것을 시사
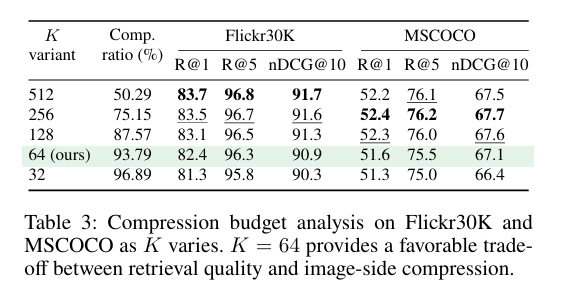
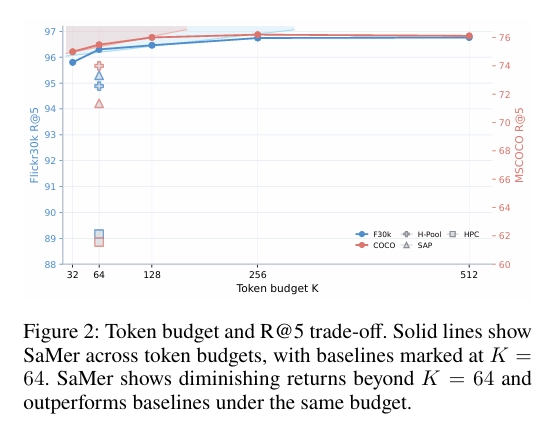
Figure2
- 동일한 K=64K=64 budget에서 SaMer와 경쟁 compression method들을 비교
- 실선이 SaMer 나타냄
- 동일한
K=64조건에서 SaMer가 H-Pool, SAP, HPC보다 Flickr30K와 MSCOCO에서 더 높은 성능을 보임- 즉, 같은 token budget을 사용할 때 SaMer가 더 좋은 quality-budget trade-off를 달성
main experiment 전체에서 K=64를 사용한다
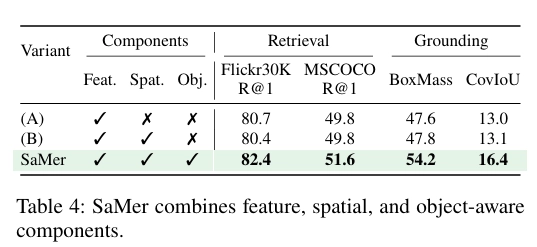
[3. Merge Component Study]
- 목적
- SaMer를 구성하는
Feature,Spatial,Object-aware요소가 각각 retrieval 성능에 얼마나 기여하는지 분석
- SaMer를 구성하는
- 결과
- spatial 정보를 추가해도 retrieval 성능은 거의 향상되지 않음
- 즉, 단순히 공간적으로 가까운 token끼리 잘 묶는 것만으로는 retrieval-oriented compression에 충분하지 않음을 의미함
- 이유
- Query-relevant evidence가 spatial proximity만이 아니라 object identity에 의존할 수 있기 때문
- 즉, spatial coherence는 인접한 token을 조직하는 데 도움을 주지만, 그 자체만으로 서로 다른 object가 같은 representative에 섞이는 문제까지 해결하지 못함
- 가장 큰 성능 향상은 object-aware prior에서 발생
- 서로 다른 object instance의 token이 하나의 representative에 섞이는 것을 억제하면서 object-level evidence를 더 잘 보존
- 성능 향상이 단순한 projection adaptation 때문만이 아니라, merge 자체가 object-instance structure를 고려하도록 설계되었기 때문임
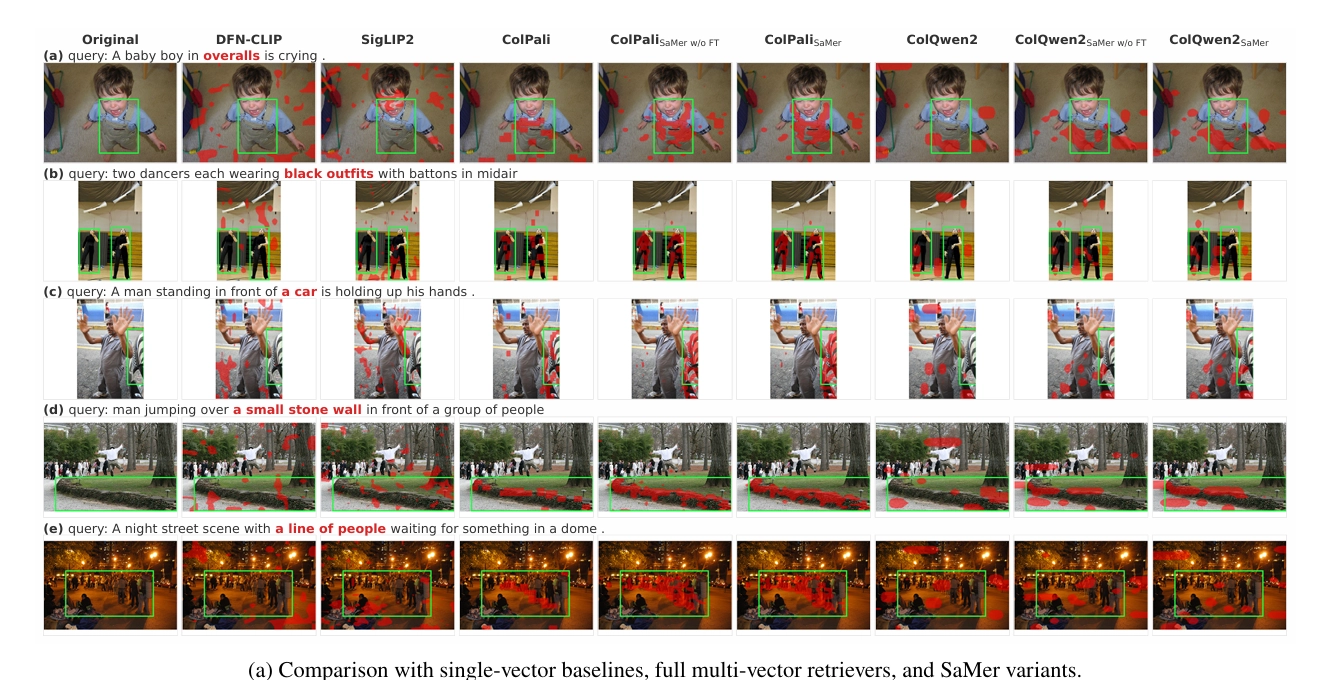
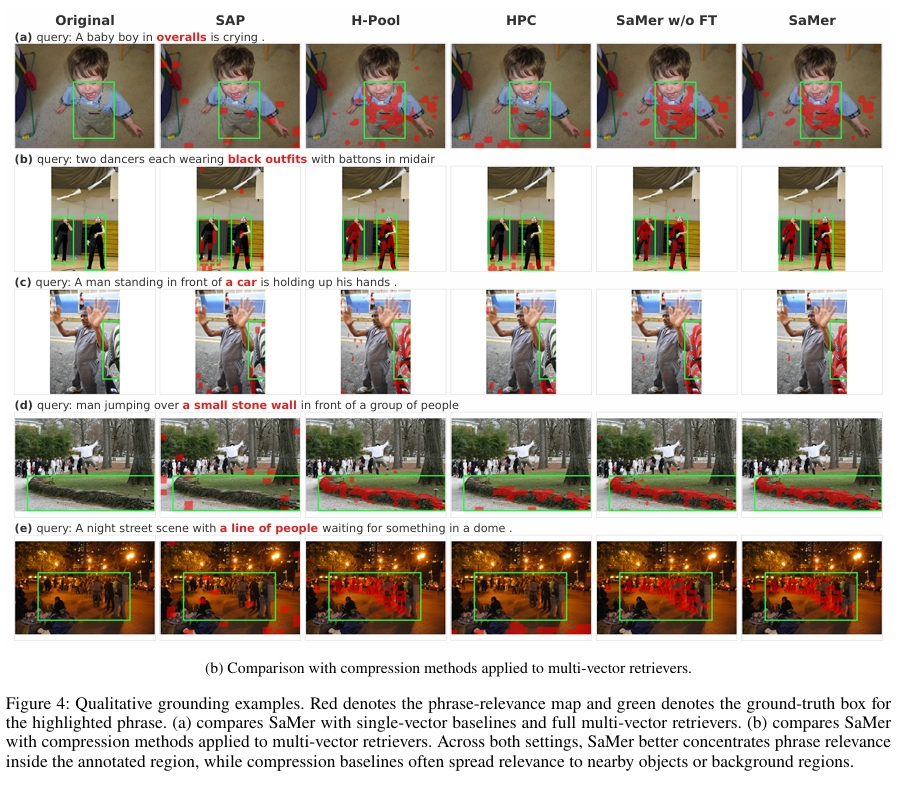
[6. Grounding Comparison]
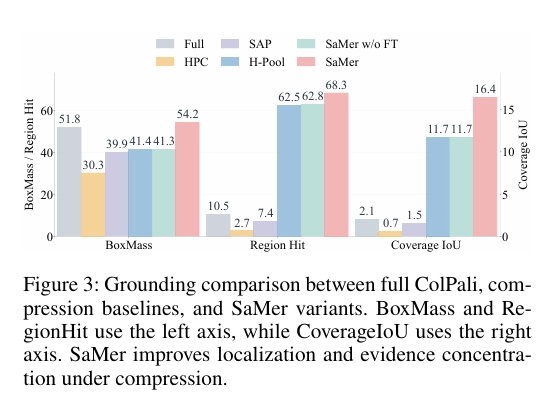
- 목적
- compressed representation이 phrase-level visual evidence를 얼마나 잘 보존하는지 평가
- 즉, token compression 이후에도 query phrase와 관련된 visual evidence가 실제 target object region에 남아 있는지 확인
- phrase grounding
- 텍스트의 특정 phrase가 실제 이미지의 어떤 visual region과 대응되는지 보는것
- 일부 compression 방법은 target object가 있는 대략적인 region을 찾는 localization은 유지하거나 향상시킬 수 있음
- 하지만 relevance가 target object에만 집중되지 않고
- 인접 object, 주변 context, background
- 에 퍼질 수 있음
- 즉, visual token을 줄여도 target area를 찾기 위한 signal은 남을 수 있지만, query phrase와 정확히 대응하는 object-specific visual evidence는 손실될 수 있음
- 따라서 localization이 좋아졌다고 해서 phrase grounding까지 정확해졌다고 볼 수는 없음
- 하지만 relevance가 target object에만 집중되지 않고
- Metric
- RegionHit
- target object region에 relevance가 도달했는지 확인
- CoverageIoU
- relevance가 형성된 영역과 target bbox가 얼마나 잘 겹치는지 확인
- BoxMass
- 전체 relevance 중 target bbox 내부에 얼마나 많은 relevance가 집중되어 있는지 확인
- 초록색 박스 = ground-truth bbox, 즉 query가 가리키는 정답 object/region
- 빨간색 영역 = 모델이 해당 query phrase와 관련 있다고 본 visual relevance map
- RegionHit
[7. Efficiency Analysis]
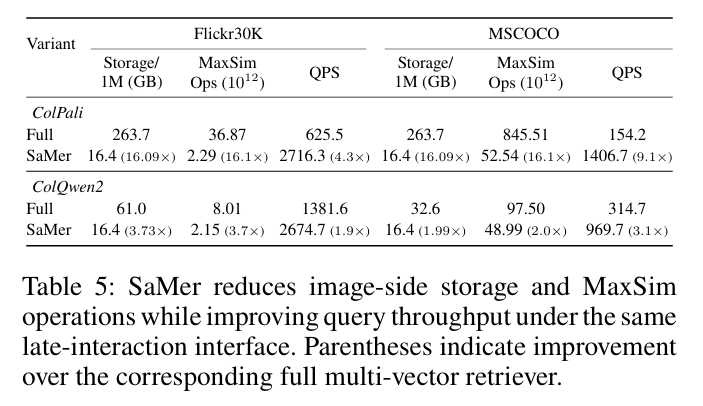
- 압축을 전혀 적용하지 않은 기존 ColPali, ColQwen2와의 원래 multi-vector representation과 비교
- storage
- MaxSim
- QPS (Queries Per Second)
- 즉 1초에 몇 개의 query를 처리할 수 있는지
[8. Conclusion]
- 본 연구에서는 효율적인 multi-vector vision-language retrieval을 위한 object-aware token merging framework을 제안
- 핵심 관점
- multi-vector retrieval에서 중요한 것은 단순히 token 수를 줄이는 것이 아니라, 나중에 query가 선택할 수 있는 visual evidence를 보존하는 것
- SaMer는 이를 위해 visual token을 object-aware하게 merge함
- 방법
- 많은 image-side token을
K개의 representative token으로 압축 - 학습 시 bbox annotation을 이용해 서로 다른 object instance의 token이 섞이지 않도록 유도
- 추론 시에는 bbox나 detector 없이 사용 가능
- backbone은 고정하고 projection layer만 adaptation
- 많은 image-side token을