3.2 상관관계 분석
df_corr = df1.drop(['Store', 'Holiday_Flag', 'Date'], axis=1)
#df_corr 변수에 df1테이블에서 Store,Holiday_Flag,Date 칼럼을 행단위로 제거한다.
#axis값은 0이나 1이 들어갈 수 있는데 0일때는 열단위(세로)로 계산 , 1일때는 행단위(가로)로 계산할때 쓴다.
df_corr.corr()
#df_corr테이블의 상관관계를 보여준다
df_corr = df1.drop(['Store','Holiday_Flag','Date'],axis=1)
#위와같이 df1의 테이블을 가져온다
sns.heatmap(df_corr.corr(),vmin=-1,vmax= +1 , annot = True , cmap = 'coolwarm');
#heatmap을 그릴건데 df1의 연속형 변수를 제외하고 그릴것이다. 최소-1 최대 +1로 지정한다.
#annot = True는 히트맵에 cell값을 표기하는 것이다.
plt.gcf().set_size_inches(6,6)
sns.scatterplot(x='Temperature',y='Weekly_Sales' , data = df1);
#온도와 주간판매량의 산점도를 출력한다.
plt.gcf().set_size_inches(7,7,)
4 ML활용 구매량 예측 (ML : 머신러닝)
df1['Dayofweek'] = df1['Date'].dt.dayofweek
df1['month'] = df1['Date'].dt.month
#.dt.year/month/day는 datetime 변수에서 년/월/일을 추출한다
#.dt.dayofweek 일주일중에 월~일중에 몇일인지를 추출한다. 월요일부터 0~일요일6으로 추출한다.
df1.head()
from sklearn.model_selection import train_test_split
#train/test를 분리하기 위해서 sklearn.mode_selection에 있는 train_test_split을 가져온다.
#train과 test(validation)을 나누는 이유는 머신러닝 모델에 train 데이터를 100% 학습시킨 후에 test 데이터에 모델을 적용했을 때 성능이 생각보다 나오지 않는 경우가 많다. 이런 경우를 오버피팅(overfitting)이라고 한다.
모델이 내가 가진 학습 데이터에 너무 과적합되어있어서 조금이라도 벗어난 데이터를 주면 예측률이 현저하게 떨어지기 때문에
오버피팅을 방지하는 것이 전체적인 모델 성능을 따져보았을 때 매우 중요한 프로세스 이다.
-> 즉, 오버피팅을 방지하기 위해서 데이터에 test(validation)을 지정해서 train 셋으로 학습 후에 중간중간 test셋으로
내가 학습한 모델 평가를 한다.
from sklearn.ensemble import RandomForestRegressor
#랜덤포레스트 라는 모듈을 가져온다.
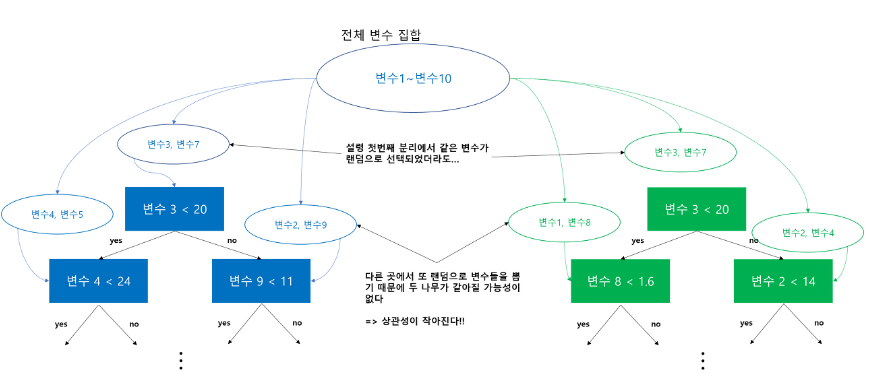
#랜덤 포레스트는 배깅을 사용하고 거기에 변수를 랜덤으로 선택하는 과정을 추가해서 개별 나무들간의 상관성을 줄여서 예측력을 향상한 모형이다.
#참고사진 첨부로 확인
from sklearn import metrics
#이건 왜 쓰는지 모르겠음 나중에 찾아봐야지 ★
X = df1.drop(['Store','Date','Weekly_Sales','CPI'],axis=1)
Y = df1['Weekly_Sales']
x_train, x_test, y_train , y_test = train_test_split(X,Y,test_size=0.4,random_state=1239)
#test_size는 test셋 구성의 비율을 말한다. 0.4면 전체 데이터셋의 40%를 test(validation)으로 지정한다는 의미
#random_state는 random함수의 seed값이라고 생각하면 된다. 예를들어 지정하지 않으면 1~100데이터가 있다고 치면 1~60까지가 train, 61~100까지가 test가 될 수도 있고 1~40이 test, 41~100이 train이 될수도 있기 때문에 항상 같은 결과를 도출해내기 위해서 seed 값을 지정한다고 생각하면 된다.
-> 즉 , random_state 값은 random의 seed값이고 , 지정해서 동일한 결과를 도출하기 위해 지정만 해주면된다.
print(x_train.shape)
print(y_train.shape)
print(x_test.shape)
print(y_test.shape)
rfr = RandomForestRegressor(n_estimators=500, max_depth =4, random_state = 1239)
#n_estimators = 개별나무의 개수
#max_depth = 개별 나무의 최대 깊이
rfr.fit(x_train, y_train)
#모델을 학습 시킨다.
import numpy as np
from sklearn.metrics import mean_absolute_error , r2_score
y_pred_trarin = rfr.predict(x_train)
y_pred_test = rfr.predict(x_test)
mae_trarin = mean_absolute_error(y_train,y_pred_train)
#mae = mean_absolute_error = 회귀 모델이 잘 학습되었는지를 확인할 때 사용되는 평가지표
print('mae_train(mae):' , mae_train)
r2_train = r2_score(y_train, y_pred_train)
#r2는 결정계수를 의미한다. 상관계수를 제곱한 값으로 보면된다. 회귀 분석에서 사용하는 수치이다.
print('r2_score(r2): ' , r2_train)
print('')
mae_test = mean_absolute_error(y_test , y_pred_test)
print('mae_test(mae): ' , mae_test)
r2_test = r2_score(y_test, y_pred_test)
print('r2_score(r2)' ,r2_test)
#이 부분은 하나하나 따지면서 가기가 너무 어렵다. 구조라도 알아두자. 여기부턴 정확히 회귀 모델이 뭔지를 알아야할 것 같다
#일단 대충 보면 predict 라는 함수를 사용해서 train과test의 예측을 하고 mae를 사용해서 확인한다.
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
poly = PolynomialFeatures(degree=2, include_bias=True)
X_train_poly = poly.fit_transform(x_train)
lin_reg = LinearRegression()
lin_reg.fit(X_train_poly, y_train)
X_test_poly = poly.transform(x_test)
y_pred_test = lin_reg.predict(X_test_poly)
mae_test = mean_absolute_error(y_test, y_pred_test)
print('mae_test(mae): ', mae_test)
r2_test = r2_score(y_test, y_pred_test)
print('r2_score(r2): ', r2_test)
#위에와 같이 예측하는 것이지만 여기서는 다른 모듈을 사용한다.
pd.options.display.float_format = '{:.2f}'.format
#소수 2자리 까지 형태로 나타낸다. .2f는 과학적 표기법을 사용안할때이고 .2e는 과학적 표기법을 사용할때이다.
result = pd.DataFrame({'Real Values':y_test, 'Predicted Values':y_pred_test})
result['diff'] = result['Real Values'] - result['Predicted Values']
result.head(5)
sns.scatterplot(result['Real Values'], result['Predicted Values'])
plt.xlim(1400000, 2000000)
plt.ylim(1400000, 2000000)
x = [1400000, 2000000]
y = [1400000, 2000000]
plt.plot(x, y, color='red')
plt.gcf().set_size_inches(8 ,8)
#에러가 뜨지만 일단 강의를 보면 그래프가 보이는데 예상한값과 실제값을 점으로 찍어서 상관관계를 보여준다.
result = result.reset_index(drop=True)
plt.plot(result.index, result['Real Values'], label='Real');
plt.plot(result.index, result['Predicted Values'], label='Pred');
plt.legend()
plt.gcf().set_size_inches(25, 6)
#실제 그래프를 보면 가끔씩 팍 올라칠때가 있는데 이 모델은 그것에 대한 예측을 성공적으로 하고 있지않다.
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
plt.style.use(['dark_background'])
ftrimportances_values = rfr.feature_importances
ftr_importances = pd.Series(ftr_importances_values, index = x_train.columns)
ftr_top20 = ftr_importances.sort_values(ascending=False)[:20]
plt.figure(figsize=(8,6))
plt.title('Feature Importances')
sns.barplot(x=ftr_top20, y=ftr_top20.index)
plt.show()
#Feature IMP(IMPORTANCE)분석을 통해서 중요변수를 파악한다.
#결과적으로 어떤 변수가 제일 중요한지를 알려주는 그래프를 그린다.
df1.groupby('Dayofweek')['Weekly_Sales'].mean().sort_values(ascending=False)
#요일이 가장 중요한 변수라고 나와서 요일과 주간판매량의 평균을 요일과 묶는다.
- 모델 save and read
import pickle
saved_model = pickle.dumps(rfr)
모델 저장
rfr_from_pickle = pickle.loads(saved_model)
모델 Read
샘플 프로젝트 2 제조/품질 관리를 위한 주요 인자 분석 -> 데이터 EDA 및 Classification(분류) 예측 : 독립적인 상태를 예측
A공장에서는 Wine을 생산한다. 좋은 품질의 Wine은 높은 단가로 시장에 판매할 수 있다. A공장에서 생산하는 Wine은 1~9등급까지의 등급이 있고, 7등급 이상이 가장 프리미엄 Wine이다. 7등급 이상의 Wine을 최대한 많이 생산해야 영업이익을 남길 수 있다. Wine 품질에 영향을 끼치는 주요 공정변수를 확인하고, 공정 변수 관리를 통해 7등급 이상의 Wine을 생성하고자 한다.
문제정의
: 7등급 이상 프리미엄 Wine 생산량 부족
기대효과
:7등급 이상 프리미엄 Wine 생산량 증가, 영업이익 증가
해결방안
:Wine 품질에 영향을 미치는 인자 도출 및 공정 관리를 통한 프리미엄 Wine 생산
성과측정
:공정변수 Control 전/후 프리미엄 Wine 생산량 비교
운영
:Model을 통해 도출된 중요 공정 변수와 품질간의 상관관계 분석
:해당 공정 변수 관리를 통해 프리미엄 Wine 생산
import numpy as np
df['target'] = np.where(df['quality']>6, 1, 0)
df.head(5)
#7등급 와인을 위주로 볼 것이기 때문에 target칼럼을 하나 만들어서 7등급 이상이면 1, 아니면 0으로 한다.
df['target'].value_counts()
#target의 수를 체크한다. 0(6등급이하)의 갯수와 , 1(7등급 이상)의 갯수
-Data EDA(Exploratory Data Analysis : 탐색적 데이터 분석)를 통해 중요인자 사전 탐색
import seaborn as sns
import matplotlib.pyplot as plt
%matplotlib inline
plt.style.use(['dark_background'])
sns.heatmap(df.corr(), vmin = -1, vmax = +1, annot = True, cmap = 'coolwarm');
plt.gcf().set_size_inches(10, 10)
#heatmap을 사용해서 중요 인자를 찾아본다.
#상관 계수가 0.2 이상의 변수를 체크한다. alcohold은 0.44 volatile acidity는 -0.27 density는 -0.31 이라서 3개 분석
fig, axes = plt.subplots(1, 3)
sns.scatterplot(data = df, x='volatile acidity', y='quality', linewidth=0, ax=axes[0]);
sns.scatterplot(x=df[df['density']<1]['density'], y=df[df['density']<1]['quality'], linewidth=0, ax=axes[1]);
sns.scatterplot(x=df['alcohol'], y=df['quality'], linewidth=0, ax=axes[2]);
plt.gcf().set_size_inches(20, 6)
#그래프로 3개의 변수를 분석해본다.
from sklearn.model_selection import train_test_split
from sklearn import metrics
X=df.drop(['quality', 'target'], axis=1)
Y=df['quality']
x_train, x_test, y_train, y_test = train_test_split(X, Y, test_size=0.3)
print(x_train.shape)
print(y_train.shape)
print(x_test.shape)
print(y_test.shape)
#train/test를 만들고 test는 전체 데이터의 30%로 지정한다.
#여기서 Y를 target으로 안하고 quality로 지정한 이유는 선형회귀는 연속형 변수를 예측할 떄 사용하는 알고리즘이다.
그래서 3~9등급 까지 있는 quality를 지정한다.
from sklearn.linear_model import LinearRegression
mlr = LinearRegression()
mlr.fit(x_train, y_train)
#선형 회귀 모델을 사용한다. fit으로 학습 시킨다.
import numpy as np
from sklearn.metrics import mean_absolute_error, r2_score
y_pred_train = mlr.predict(x_train)
y_pred_test = mlr.predict(x_test)
mae_train = mean_absolute_error(y_train, y_pred_train)
print('mae_train(mae): ', mae_train)
r2_train = r2_score(y_train, y_pred_train)
print('r2_score(r2): ', r2_train)
print('')
mae_test = mean_absolute_error(y_test, y_pred_test)
print('mae_test(mae): ', mae_test)
r2_test = r2_score(y_test, y_pred_test)
print('r2_score(r2): ', r2_test)
#샘플 프로젝트1 처럼 예측을하고 평가한다 -> 과적합 여부 판별을 한다. 오버피팅 방지
#r2와 mae를 조금 더 자세히 공부해보자
#r2는 100점 만점에서 높으면 적합한 것이고 아니면 아니다라고 생각하면 된다.
import matplotlib.pyplot as plt
plt.scatter(y_test, y_pred_test, alpha=0.4)
plt.xlabel("Actual")
plt.ylabel("Predicted")
plt.title("MULTIPLE LINEAR REGRESSION")
plt.gcf().set_size_inches(10, 10)
plt.show()
#예측 모델이 얼마나 실제 문제를 잘 설명하는가를 그래프로 표현한다.
df_result = pd.DataFrame({'Real Values':y_test, 'Predicted Values':list(round(df_result['Predicted Values'],0))})
df_result['diff'] = df_result['Real Values'] - df_result['Predicted Values']
df_result.head(5)
#실제 값과 예측값에 대한 표현
#보통 -1등급 정도 오차가 난다.
더 공부 해야 할것 : r2, mae , 선형 회귀