SQL
1.스터디노트 1일차

1
2.스터디노트 2일차
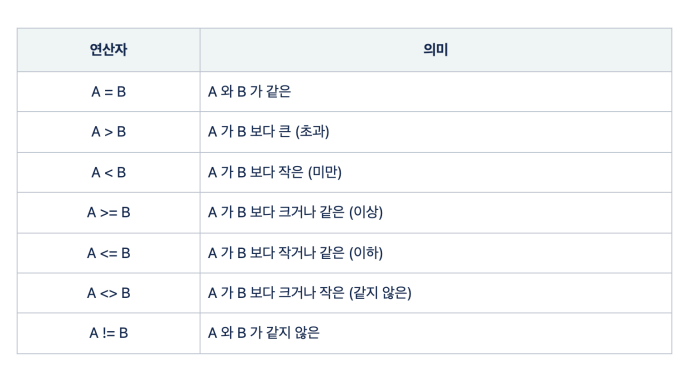
2024.02.05비교연산자ex1) 나이가 30세이하 데이터를 조회select from table where age<=30ex2) 소속사가 YG가 아닌 데이터를 조회select from talbe where agency!=YG\-정렬ASC(오름차순) : 기본적
3.스터디노트 3일차
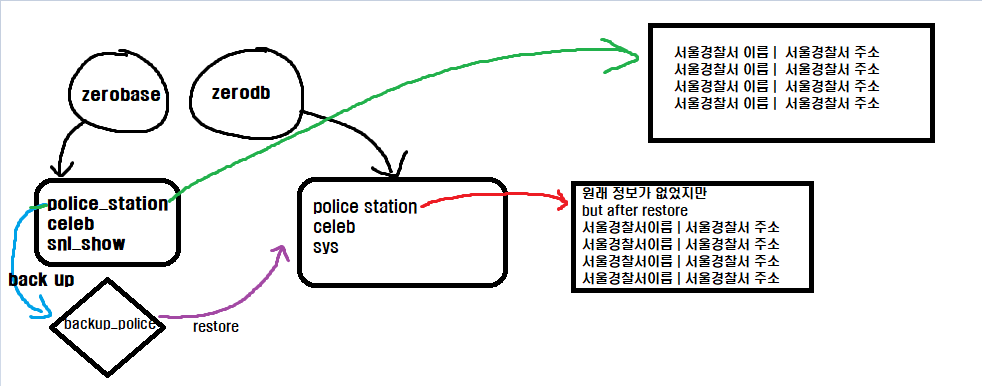
\-조인: 두 개 이상의 테이블을 결합하는 것※테이블A가 레프트 테이블※테이블B가 라이트 테이블INNER JOIN : select ~ from ~ inner join ~ on (AnB)\-Select 칼럼1,2,3 ~ FROM 테이블A INNER JOIN 테이블B ON
4.스터디노트 4일차

\-테이블 생성AWS RDS로 연결해주고cur = remote.cursor()cur.execute("CREATE TABLE sql_file(id int, filename varchar(16))")\-테이블 제거cur = remote.cursor()cur.execute(
5.스터디노트 5일차
\-pandas로 변환import pandas as pddf = pd.DataFrame(result)df.head\-csv파일읽기(pandas사용)import pandas as pd // pandas를 pd로 import하기df = pd.read_csv("police_
6.스터디노트 6일차
\-집계 함수count : 총 갯수 계산sum : 합계를 계산avg : 평균을 계산min : 가장 작은값 찾음max : 가장 큰 값 찾음first : 첫번째 결과값을 리턴last : 마지막 결과값을 리턴\-countselect count(~) from 테이블 (wher
7.스터디노트 7일차
2024.02.10샘플 프로젝트 1 마트 수요/매출 예측A마트는 주52시간제 운영으로 인하여 인력난을 겪고 있다. 주 당 판매량을 예측할 수 없기 때문에 근무 스케줄과 인력 운영을효율적으로 하기 힘든 상황이다. 대기업 마트가 아니기 때문에 방문자 수, 주차 대수 등 세
8.스터디노트 8일차
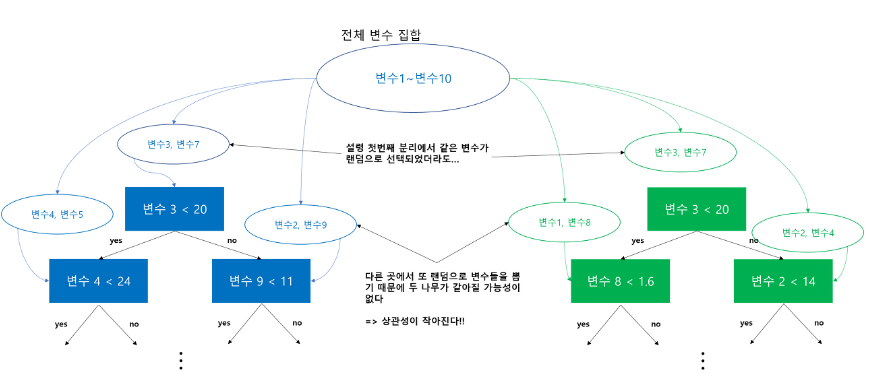
3.2 상관관계 분석df_corr = df1.drop('Store', 'Holiday_Flag', 'Date', axis=1)df_corr.corr()df_corr = df1.drop('Store','Holiday_Flag','Date',axis=1)sns.heatma
9.스터디노트 9일차
\-Scalar FunctionsUCASE : 영문을 대문자로 변환LCASE : 영문을 소문자로 변환MID : 문자열 부분을 반환LENGTH : 문자열의 길이ROUND : 지정한 자리에서 숫자를 반올림NOW : 현재 날짜 및 시간 반환FORMAT : 숫자를 천단위 콤마
10.스터디노트 10일차
\---------GIT \-VCS(version control system):버전관리시스템 ( 형상관리 시스템 )그래서 요즘은 GIT(Global Information Tracker)을 많이씀\-GIT 의 데이터 저장 방식:version이 올라갈때 마다 diff를 가
11.스터디노트 11일차
\-Git log:저장소의 commit 이력을 시간순으로 보여준다.ex) git log -2 : 로그 2개만 보여주기ex) git log --skip 5 : 로그 5개를 패스ex) git log -p -1 : commit 마다 변경내용 출력 , diff를 보여준다는 뜻
12.스터디노트 13일차
\---------------------Pythondf = pd.read_csv(DriveUrl)type(df)\-> pandas.core.frame.Dataframe : 엑셀같은 폼을 Dataframe이라고 함df.head(): 상위 5개의 행이 나옴print(df.
13.스터디노트 14일차
!다중공선성을 제거 한다df_corr = df.corr()df_corr = df_corr(abs(df_corr) > 0.5) & (df_corr != 1)df_corr!스케일링:특성들의 평균을 0, 분산을 1 로 스케일링하는 것입니다.즉, 특성들을 정규분포로 만드는 것
14.스터티노트 15일차
카드 거래이력 분석을 통한 고객 특성 파악 -> 데이터 EDA 및 인사이트 추출:A사는 신규 브랜드의 점포를 입점 시키려는 계획을 가지고 있다. 신규 브랜드이기 때문에 과거 상권에 대한 정보가 없어,어느 지역에 입점을 시켜야할지 고민이 많다. 고민 끝에 후보 지역A를
15.스터디노트 16일차
\-PivotIndicator을 삭제하고 First Tooltip 컬럼에서 신뢰구간에 해당하는 표현을 지워라df.drop('Indicator',axis=1,inplace=True)df'First Tooltip' = df'First Tooltip'.map(lambda x
16.스터디노트 17일차
Q1~Q20인기동영상 제작횟수가 많은 채널 상위 10개명을 출력하라 (날짜기준, 중복포함)df.channelTitle.value_counts()head(10)논란으로 인기동영상이 된 케이스를 확인하고 싶다.dislikes수가 like 수보다 높은 동영상을 제작한 채널을
17.스터디노트 18일차
\---------------------기초수학\-약수와 소수약수 코드 :inputNumber = int(input("0보다 큰 정수 입력:"))for number in range ( 1, (inputNumber +1) ): if inputNumber % number
18.스터디노트 19일차
\-등비수열등비수열 코드 inputN1 = int(input('a1입력 : '))inputR = int(input('공비 입력: '))inputN = int(input('n 입력: '))valueN = 0n = 1while n <= inputN: if n ==
19.스터디노트 20일차
\-순열 : n개에서 r개를 택하여 나열하는 경우의 수 ( nPr = n(n-1)(n-2)~(n-r+1) )ex) 8P3 = 8x7x6 or 8!/5!순열 ( n x (n-1) x ~ x (n-r+1)로 구하는 ) 코드numN = int(input('numN 입력 :
20.스터디노트 21일차
jupyter notebook으로 실습'온라인 쇼핑몰 운영형태별 상품군별거래액.csv'파일에 데이터를 확인하고해당 데이터를 쓸모있게 만들기 위해서 전처리를 실시.https://drive.google.com/drive/folders/1d1hy4Kk6zgJImnB
21.스터디노트 22일차
\-tableau데이터 필드 역할 및 유형정보데이터 필드는 데이터 원본의 열에서 만들어진다. 각 필드에는 정수,문자열,날짜 등과 같은 데이터 유형과 불연속형 차원이나연속형 측정값 또는 연속형 차원이나 불연속형 측정값같은 역할이 자동으로 할당된다.ex)이름 , 날짜 ,
22.스터디노트 23일차
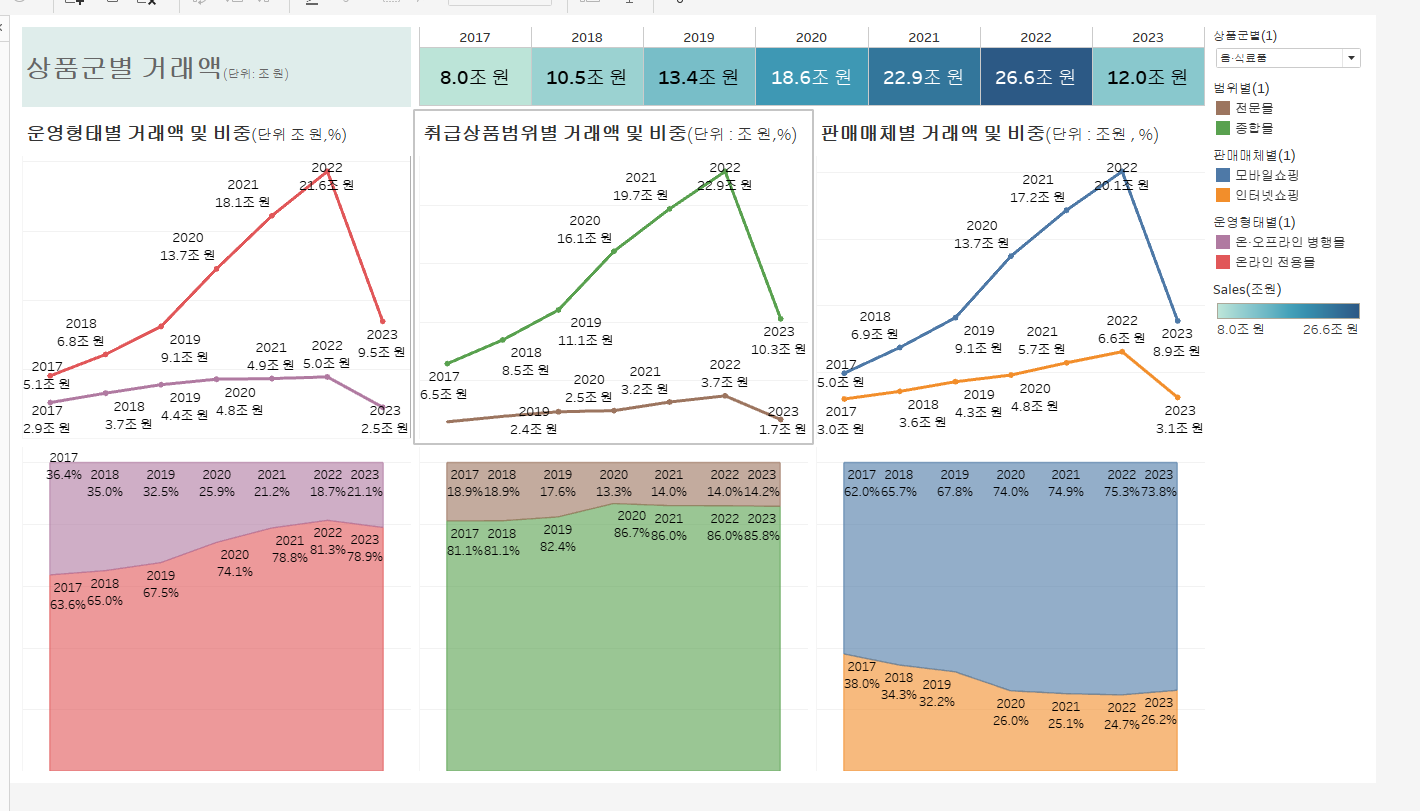
과제1과제2과제3실습 파일 : https://drive.google.com/drive/folders/1guETAlJkapGIZAS4bVSKf9GCs4dIQ5ZJ?usp=drive_link
23.스터디노트 24일차
\-Looker studio알아야할 개념1\. 측정기준:측정기준은 이름,설명,색상,크기 등 데이터의 카테고리라고 생각할 것. 측정기준은 속성 패널에서 녹색 필드로 표시된다.2\. 측정항목:측정항목은 측정기준에 포함된 데이터를 측정하고 차트의 숫자 척도와 데이터 계열을
24.스터디노트 25일차
샘플 프로젝트5.연관 규칙분석을 통한 장바구니 분석 ( 연관규칙분석을 배우는 부분 )A마트는 지속적인 매출 감소가 매대 진열에 문제가 있다고 판단하였다.따라서 매대 진열을 다시 기획하고 있다. 서로 잘 팔리는 상품에 대해서는 근접하게 매대에 배치하려고 한다.고객의 구
25.스터디노트 26일차
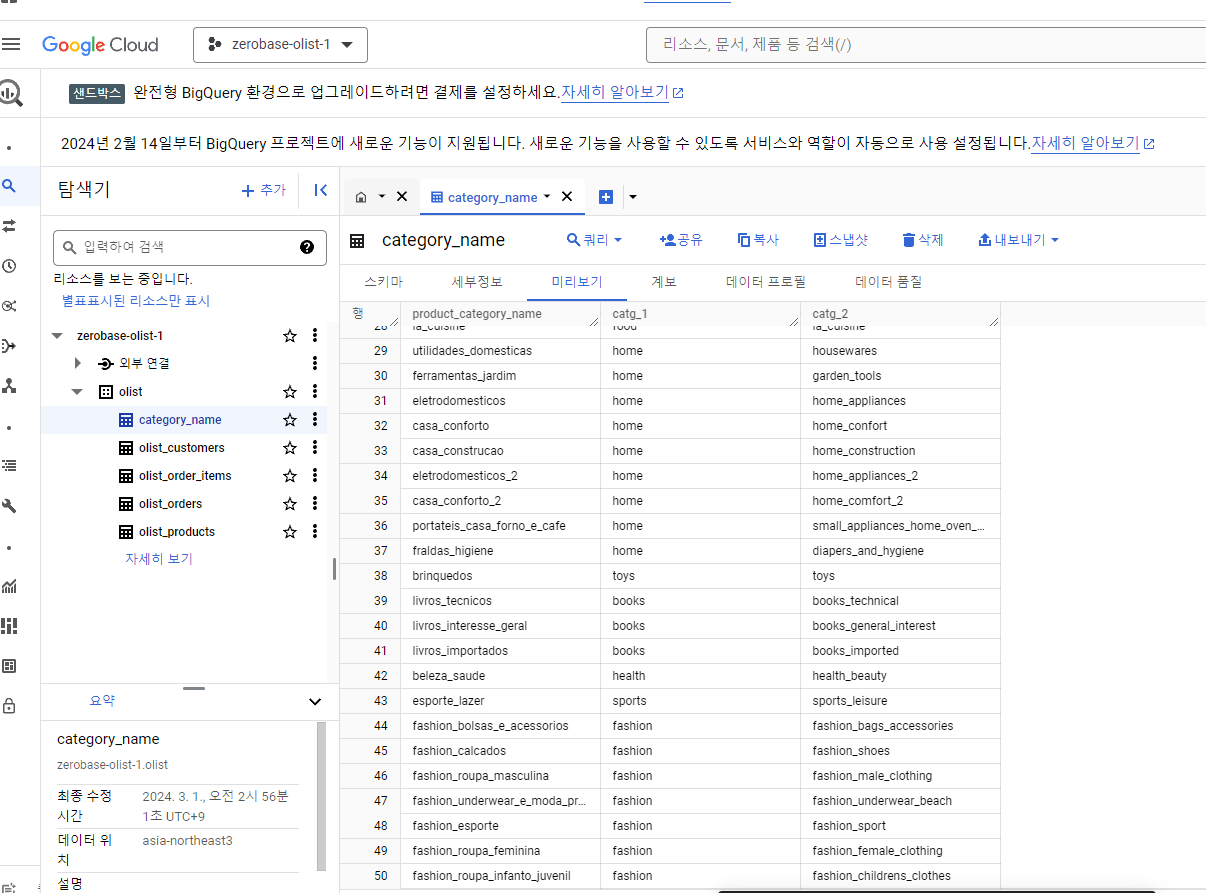
olist 테이블을 활용해서 실습한 것Select COUNT(DISTINCT order_id) AS ord_cnt, ---------전체 주문 건수 SUM(price) AS ord_amt, ------주문 금액 총합 SUM(price) / COUNT(DIST
26.스터디노트 27일차
SQL 2회차 과제/ 1번 문제 /WITH tb AS( SELECT ord.order_id, cust.customer_unique_id FROM olist.olist_orders as ord LEFT JOIN olist.olist_customers as
27.스터디 노트 28일차
/ 주 별 주문수 , 고객수 /\-- 고객 정보 기준\-- 주문 상태는 필터링하지 않음SELECT customer_state, COUNT(DISTINCT ord.order_id) as ord_cnt, COUNT(DISTINCT cust.customer_uniqu
28.스터디노트 29일차
/\*대카테고리별 매출 구하기 2017년 월별집계 후 연도,월 기준 오름차순 매출 기준 내림차순배송완료 된 건만 집계주문 테이블과 주문 상품 정보 테이블에 모두 있는 주문건만 사용 , 주문 상품 정보 테이블 기준으로 카테고리명을 붙일 것\*/SELECT DATE_TR
29.스터디 노트 30일차
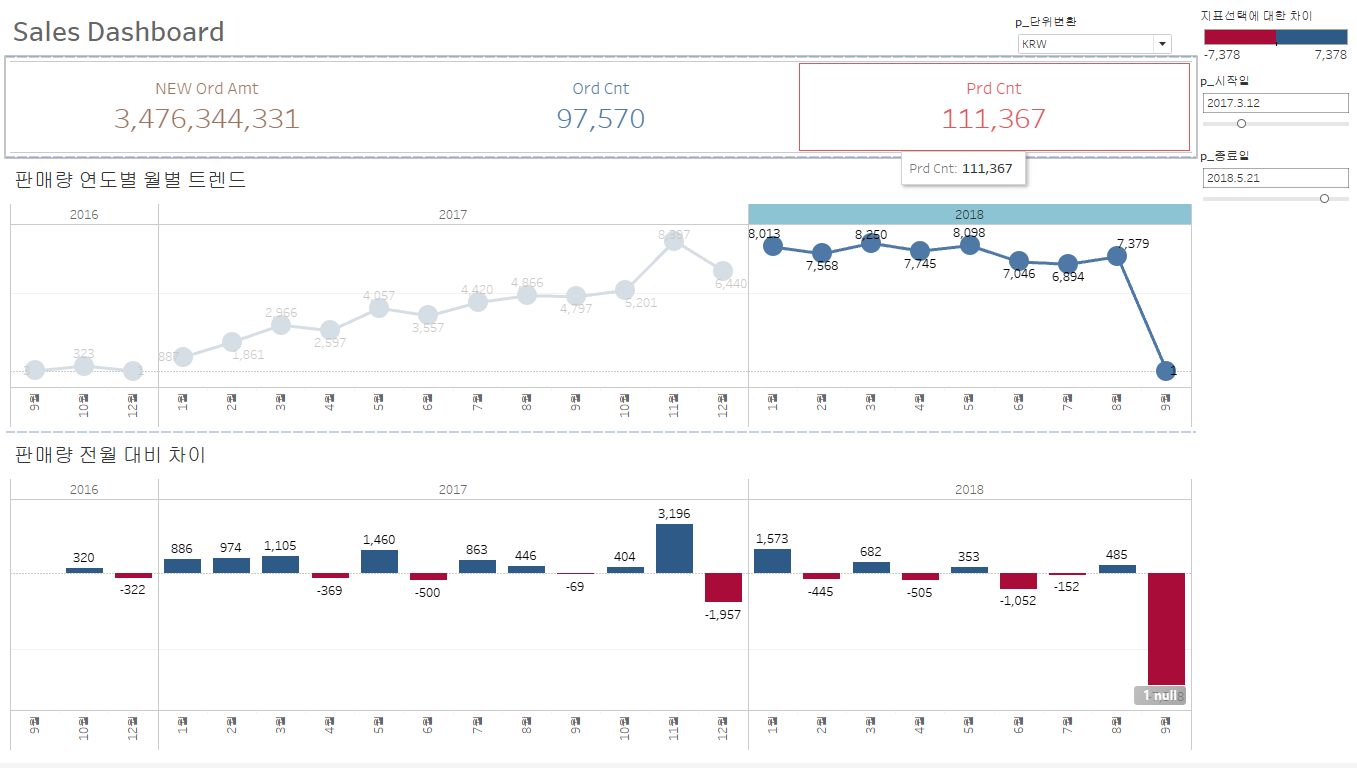
Tableau 실습 매개변수 , 단위변환 , 시작일,종료일 등등 Looker studio 실습새로운 데이터 활용하기\-AARRR 프레임 워크: 유입(Acquisition) , 활성화(Activation) , 유지(Retention) , 추천(Referral) , 수익(
30.스터디 노트 31일차
개인프로젝트 8 완개인프로젝트 1 colab에서 dashboard만들기에서 시간을 너무 많이 써서 중단개인프로젝트 8 에서 배운 것 : Collaboration Filltering추천 시스템을 구현하는데게임의 평가(Rating)데이터셋이 없다.그래서 임의로 평가기준을
31.스터디 노트 32일차
개인프로젝트 1 마무리개인프로젝트 2 완료학습내용개인프로젝트2 에서는 시계열 데이터를 다루는데 정확하게 다루는 법을 몰라서샘플프로젝트에서 연습했던 것처럼 다뤄서 피드백을 주시면 다시 공부해볼 예정
32.스터디 노트 33일차
\-HR 데이터를 통한 채용 기획DB : Data 적재 , Relationship 이해 , ERDSQL , Python : Adhoc Analysis , EDA , Data TransformationBI : Visualization , Reporting , Automa
33.스터디 노트 34일차
colab 실습: https://colab.research.google.com/drive/17iKB872ZiIv16JZZ7ALrAxhsTc_Jrgge배운 것 : visualizationHeatmapBar graphBar Graph with FacetGridHi
34.스터디 노트 35일차
과제 4 완료 및 해설강의
35.스터디노트 36일차
DBeaver 설치 및 실습\-- DATAset 전체 읽기SELECT \*FROM hr.hr_employee_attrition hea ;\-- 특정 column 만 일기SELECT EmployeeNumber ,Attrition ,Department ,JobRole ,J
36.스터디 노트 37일차
개인프로젝트 4 진행
37.스터디 노트 38일차
개인프로젝트 14 진행
38.스터디노트 39일차
/\* Table CreateCREATE TABLE -> INSERT INTO;SOURCE TABLE -> CREATE (SELECT FROM );\*/\-- 1. Object (Text) Type CREATE TABLE hr.hr_cate( EmployeeNumber
39.스터디 노트 40일차
과제 6 실습\-- Q1\-- 1. Department , JobLevel , JobRole 별 재직자 대상\-- 2. 평균 월급 , 평균 Salary 인상률 ( 이 인상률을 연 인상률로 가정)\-- 3. 인당 월급과 연 인상률을 활용해서 내년 추정 월급 산출 \--
40.스터디노트 41일차
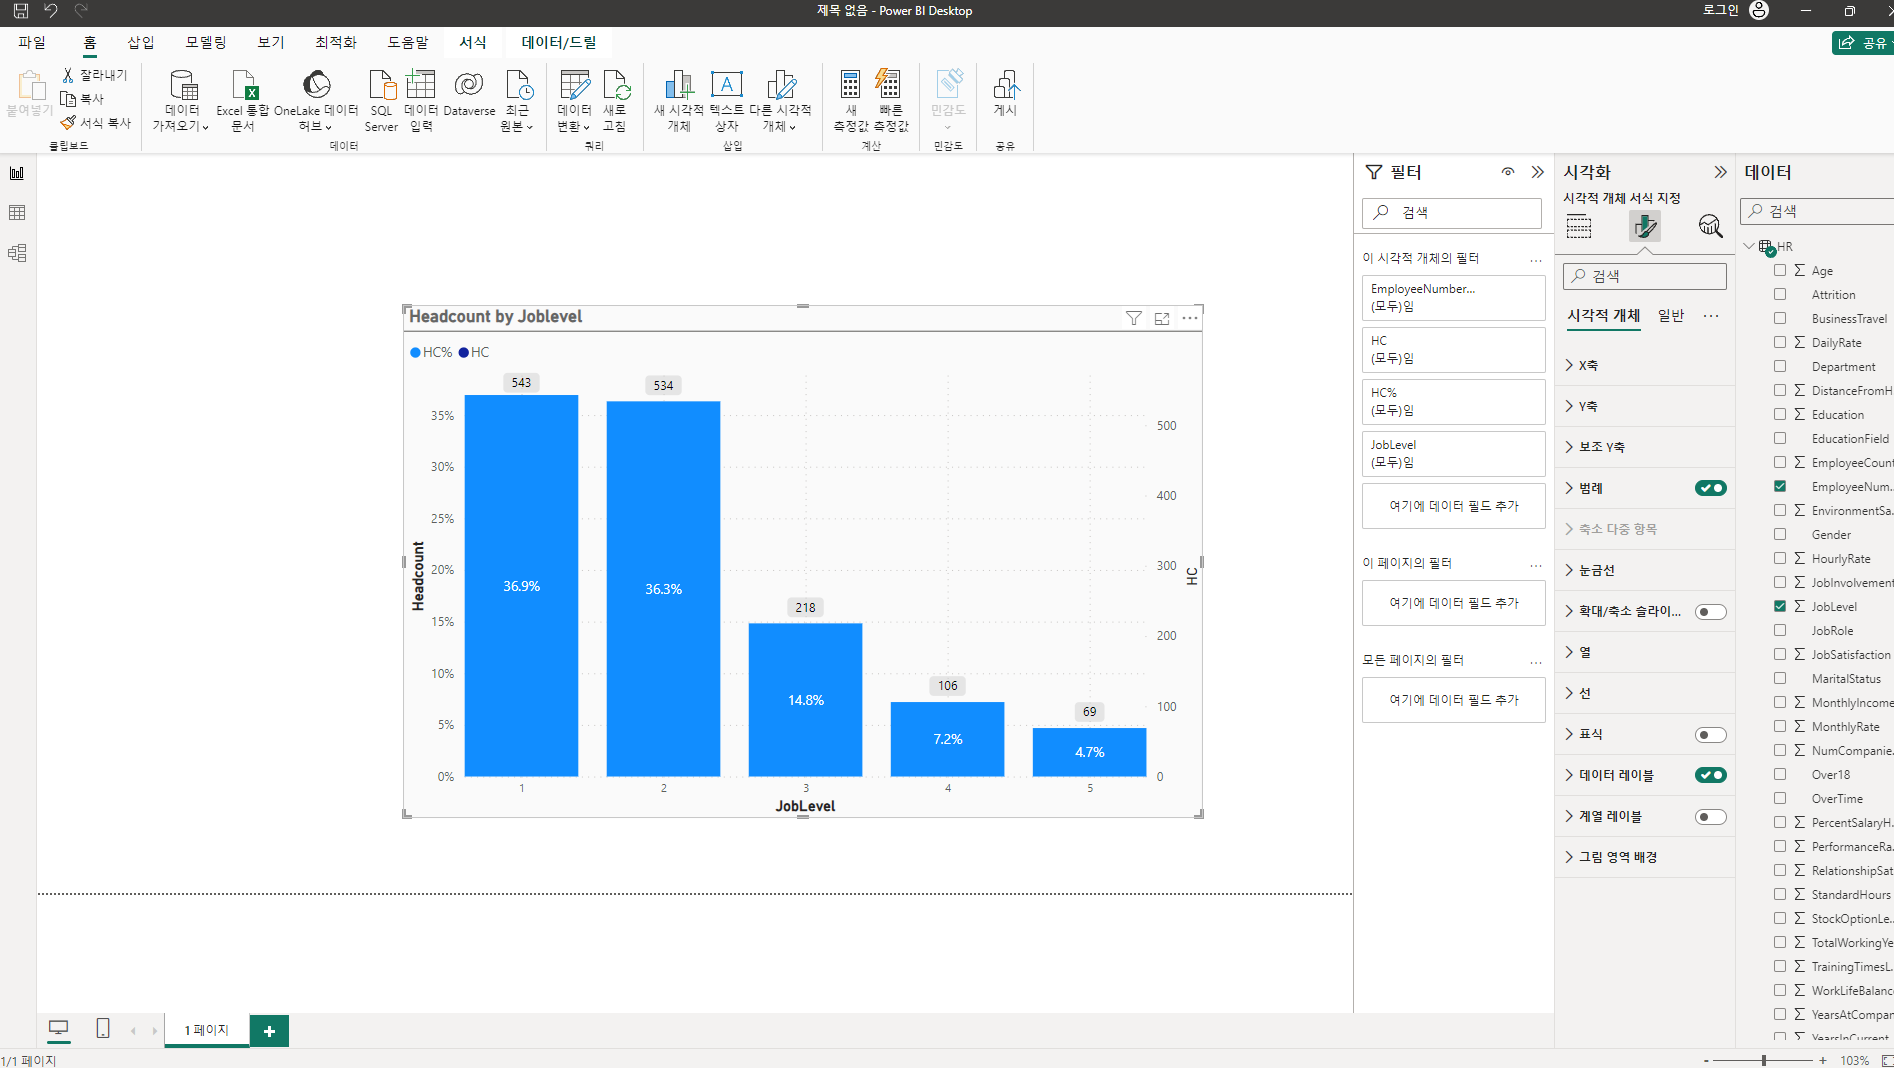
Power BI 설치 및 데이터변환 , Bar 차트 다루기
41.스터디 노트 42일차
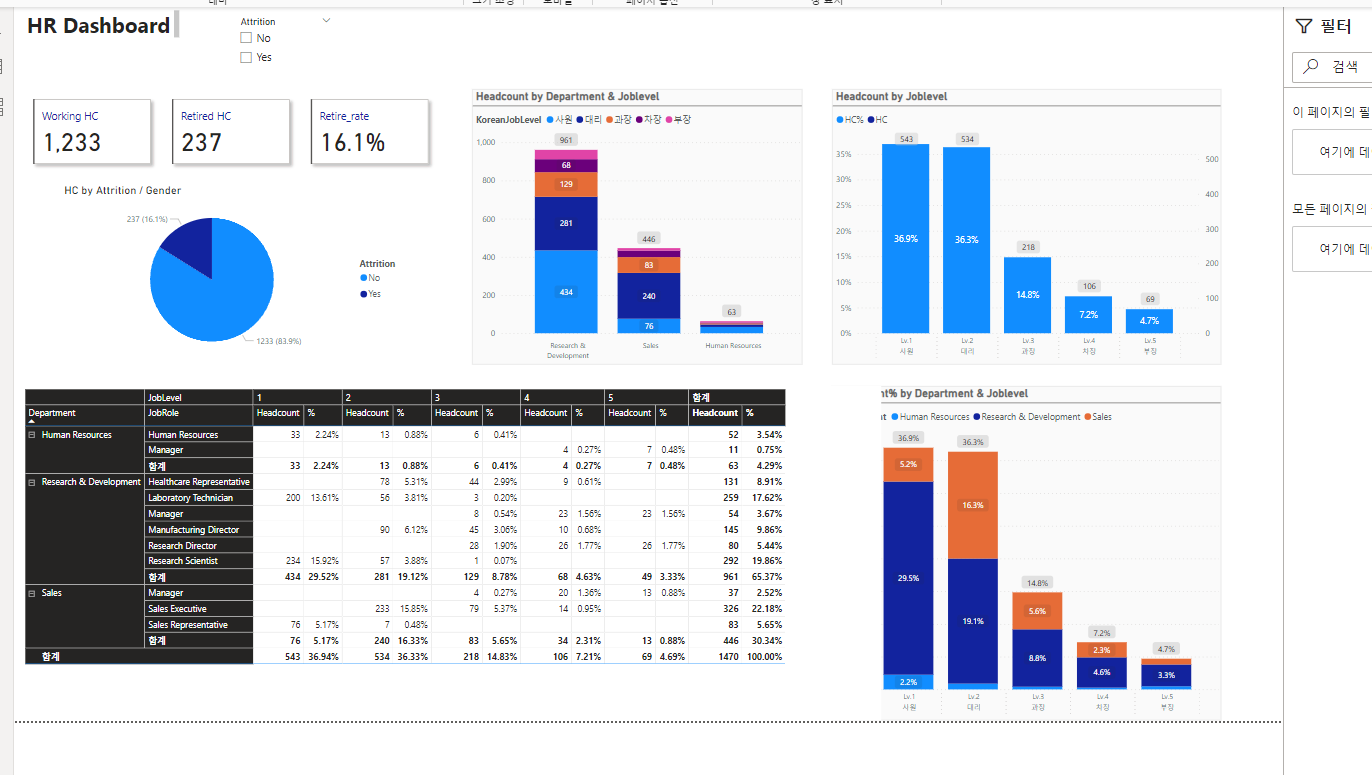
Power BI 실습Bar 그래프Stacked Bar 그래프Pie 그래프Table & Matrix빈 테이블 만들고 그 안에 계산식을 이용하여 데이터 만들기Line 그래프전체적인 Dashboard 만들기Filter 걸기
42.스터디 노트 43일차
개인프로젝트 14 , 19 완료
43.스터디노트 44일차
Historical_inventory 라는 새로운 csv파일 데이터로inventory 테이블을 생성데이터 살펴보기SELECT count(\*)FROM inventory;SELECT count()FROM ( SELECT DISTINCT FROM inventory i
44.스터디노트 45일차
과제8 실습dBeaver inventory 테이블에서 실습\-Case When\-With절\-Subquery\-- 100 -> 70 : (100-70) / 100 = 30% 할인SELECT File_Type , SoldFlag , sum(ItemCount) inve
45.스터디 노트 46일차
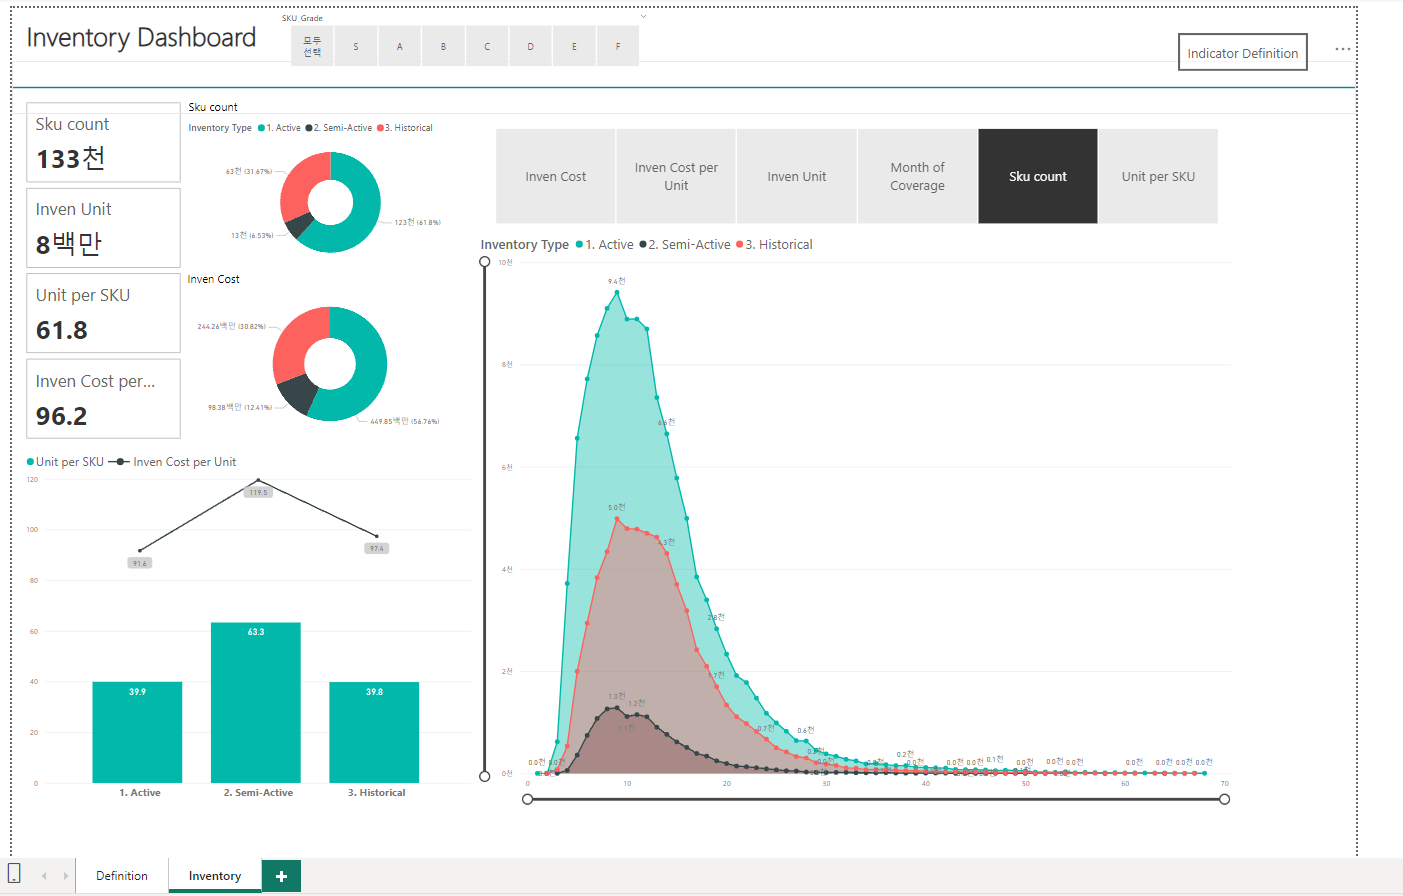
SKU_Grade 칼럼 만들기 -- SKU_Grade 기획 -- 물류 창고 계약 기간이 5년이 남았다고 가정 = 60개월 -- Month of coverage = 보유 재고로 몇달 동안 판매가 가능한가 = 재고량 / 1달 평균 판매량 -- WINDOW 함수란? --
46.스터디 노트 47일차
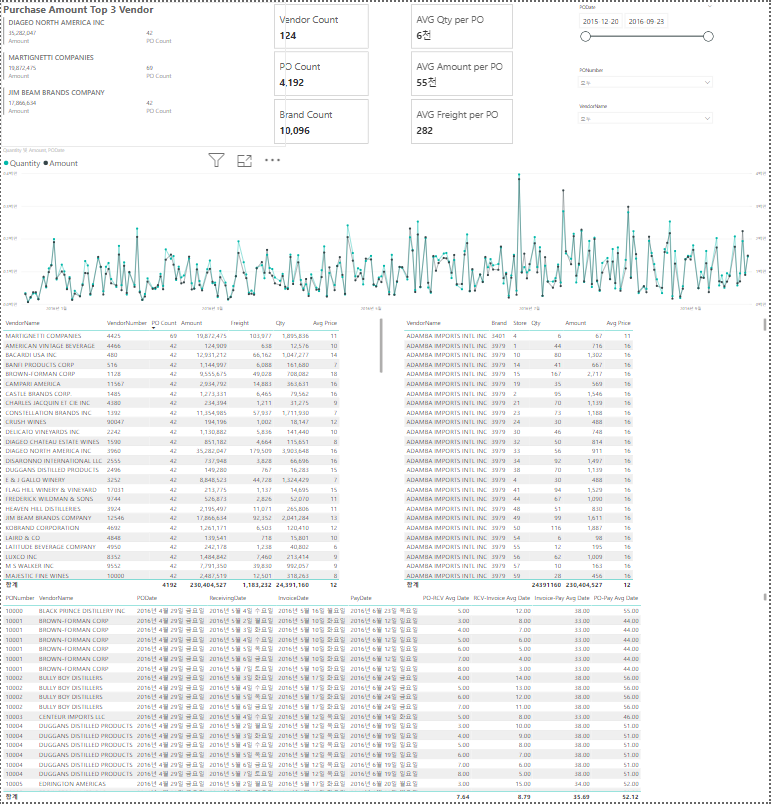
구매InvoicePurchasesPurchases재고BegInv : 기초 재고Endlnv : 기말 재고고객 판매Sales기초재고 + 입고 - 출고 + (.....) = 기말재고Vendor CountPO countBrand countAVG Qty per PO : PO 한
47.스터디 노트 48일차
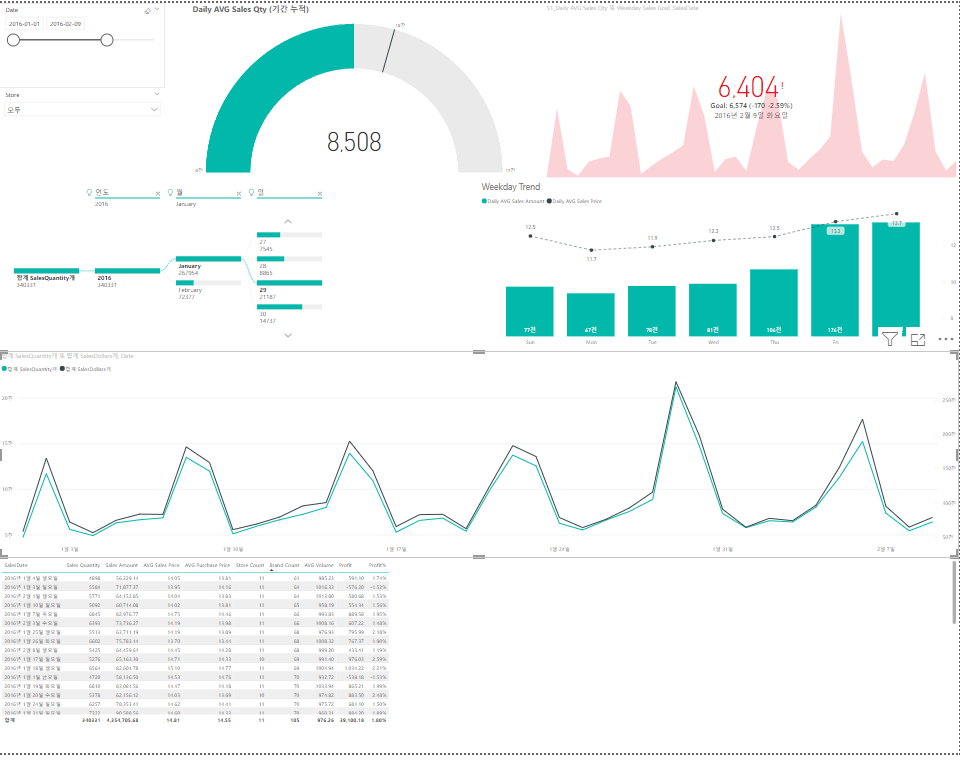
Power BI 실습\-Sales 대시보드 만들기\-분해 트리 \-테이블 병합 , 이익 계산\-Calendar Dax식\-계기 차트\-KPI 시각화\-AVERAGEX , ALL , FILTER Dax식Spark학습 및 환경 세팅하기분산 클러스터 :시스템의 전반적인 성능
48.스터디 노트 49일차
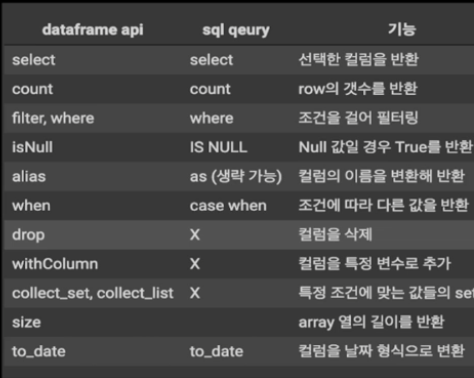
apt-get: 시스템에서 사용 가능한 패키지에 대한 설치, 패키지 검색, 업데이트 및 기타 여러 작업을 수행wget: 웹 상의 파일을 다운로드 받을 때 사용하는 명령어tar: 여러 개의 파일을 하나의 파일로 묶거나 풀 때 사용하는 명령어pip: 파이썬에서 외부 라이브
49.스터디 노트 50일차
toPandaspyspark dataframe 객체를 pandas dataframe 객체로 변환pandas로 변환하는 이유?시각화를 하기 위해서는 모든 데이터를 한번에 로드해야함대부분의 시각화 라이브러리 지원 가능pyspark는 분산 처리 기반즉, 시각화에는 적합하지
50.스터디 노트 51일차
USE Mydb;select City , count(StoreNumber) high_sale_store_cntfrom ( select City , StoreNumber , SUM(SaleDollars) sales_sum , row_number
51.스터디 노트 52일차
팀 프로젝트 진행팀프로젝트EDA 과정일단 ClassicMode만 고려라인별로 championId순위 10뽑기게임 벨런즈 조정신규 유저 가이드1) 게임 벨런스 조정은총 매치 데이터에서 accountId별로 조인을 한다음에 그 안에 champion의 고유값을 사용해서 고유
52.스터디 노트 53 , 54일차
팀 프로젝트 진행팀프로젝트EDA 과정일단 ClassicMode만 고려라인별로 championId순위 10뽑기게임 벨런즈 조정신규 유저 가이드1) 게임 벨런스 조정은총 매치 데이터에서 accountId별로 조인을 한다음에 그 안에 champion의 고유값을 사용해서 고유
53.스터디 노트 55일차
가상환경: 컴퓨터 안에 작은 가상의 컴퓨터를 만드는 것\-> 정리정돈 하기가 용이해지기 때문에 , 프로젝트 관리가 편리해짐
54.스터디 노트 56일차
import randomrandom.randint(0,10)random.seed(42)for \_ in range(5): print(random.randint(0,10))grade = l for l in 'ABCDF'for \_ in range(5): pri
55.스터디 노트 57일차
names_sr = pd.Series(names, index = index , name = '이름')ages_sr = pd.Series(ages, index = index , name = '나이')display(names_sr)display(ages_sr)df1 =
56.스터디 노트 58일차
devs_df'Currency'.value_counts()devs_df'CompTotal'.describe()devs_df'Currency' = devs_df'Currency'.str.slice(start=0,stop=3)devs_df'Currency'.value_co
57.스터디 노트 59일차
filtered_df = lang_df\[(lang_df'DevType' != 'Developer, full-stack')&(lang_df'DevType' != 'Developer, back-end')]grouped_df = filtered_df.groupby('Lan