지난 글에서는 SUMO에서 차량 데이터를 수집하고 Kafka 3 Broker 클러스터를 구성했습니다.
하지만 Broker 컨테이너 세 개가 실행된다는 사실만으로 데이터가 자동으로 분산되고 안전하게 복제되는 것은 아닙니다.
이번에는 토픽의 파티션과 복제 정책을 명시적으로 구성하고, Producer가 데이터를 보내는 도중 Broker 한 대를 직접 중단했습니다.
이후 Kafka의 Leader 변경, ISR 축소와 복원, 저장된 데이터의 재소비까지 확인했습니다.
1. Broker가 세 개 실행됐다고 끝이 아니다
지난 글에서 Docker Compose를 이용해 다음과 같이 Kafka Broker를 구성했습니다.
kafka-1 → localhost:29092
kafka-2 → localhost:39092
kafka-3 → localhost:49092
Broker별 Named Volume도 연결했습니다.
하지만 당시에는 실제 토픽이 생성되지 않은 상태였습니다.
docker exec kafka-1 /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server kafka-1:19092 \
  --list
명령을 실행했지만 아무 토픽도 출력되지 않았습니다.
Broker는 Kafka 서버이고, 실제 차량 이벤트는 토픽의 파티션에 저장됩니다. 따라서 Broker만 실행한 것으로는 데이터 저장 구조가 완성되지 않습니다.
2. 토픽 자동 생성을 비활성화한 이유
현재 Kafka 설정에서는 자동 토픽 생성을 비활성화했습니다.
KAFKA_AUTO_CREATE_TOPICS_ENABLE: "false"자동 생성을 허용하면 Producer가 존재하지 않는 토픽으로 데이터를 보낼 때 Kafka가 토픽을 즉시 만들 수 있습니다.
간단한 테스트에서는 편리하지만 토픽명에 오타가 있어도 새로운 토픽이 생성될 수 있고, 의도한 파티션 수와 복제 정책이 적용되지 않을 수도 있습니다.
따라서 토픽 설정도 코드처럼 명시적으로 관리하기로 했습니다.
다만 로컬 환경을 실행할 때마다 CLI로 토픽을 생성하는 방식은 재현성이 떨어집니다.
docker compose up -d 한 번으로 동일한 Kafka 환경을 구성하기 위해 토픽 생성 전용 초기화 서비스를 추가했습니다.
3. kafka-topic-init 서비스 추가
추가한 초기화 서비스는 다음과 같습니다.
kafka-topic-init:
  image: apache/kafka:4.3.1
  container_name: kafka-topic-init
  depends_on:
    - kafka-1
    - kafka-2
    - kafka-3
  entrypoint: ["/bin/bash", "-c"]
  command:
    - |
      echo "Waiting for Kafka brokers..."

      until /opt/kafka/bin/kafka-topics.sh \
        --bootstrap-server kafka-1:19092,kafka-2:19092,kafka-3:19092 \
        --create \
        --if-not-exists \
        --topic vehicle-telemetry-v1 \
        --partitions 12 \
        --replication-factor 3 \
        --config min.insync.replicas=2
      do
        echo "Kafka is not ready yet. Retrying..."
        sleep 3
      done

      echo "Kafka topic initialization completed."
  restart: "no"
실행 순서는 다음과 같습니다.
Docker Volume 생성
→ kafka-volume-init에서 볼륨 권한 설정
→ Kafka Broker 3개 실행
→ Kafka가 요청을 받을 수 있을 때까지 대기
→ vehicle-telemetry-v1 토픽 생성
→ kafka-topic-init 종료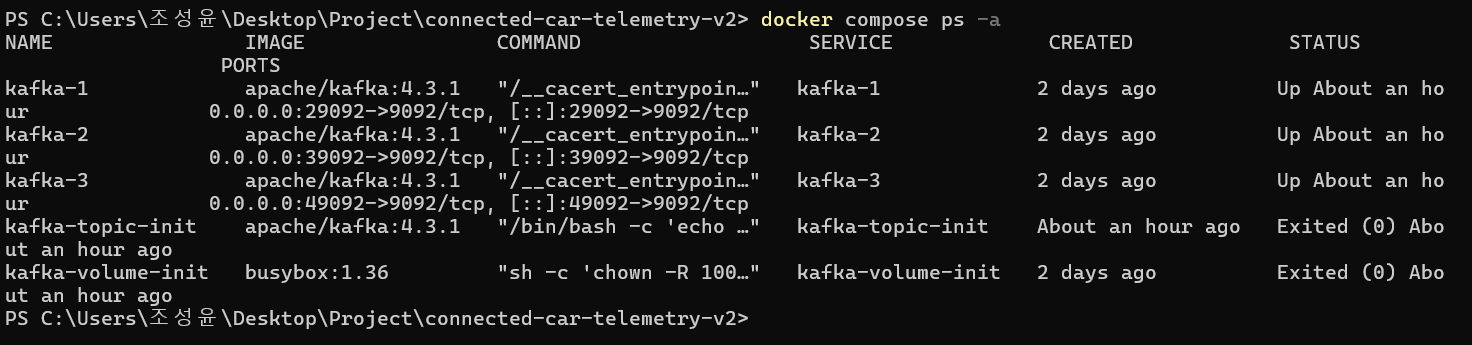
최종적으로 세 Broker는 실행 상태를 유지하고 두 초기화 컨테이너는 작업을 마친 뒤 종료됐습니다.
kafka-1             Up
kafka-2             Up
kafka-3             Up
kafka-topic-init    Exited (0)
kafka-volume-init   Exited (0)
초기화 컨테이너의 Exited (0)은 오류가 아니라 맡은 작업을 정상적으로 끝냈다는 의미입니다.
4. Broker별 Docker Volume 확인
각 Broker는 서로 다른 Docker Named Volume을 Kafka 로그 저장 경로로 사용합니다.
telemetry-kafka-cluster_kafka-1-data
telemetry-kafka-cluster_kafka-2-data
telemetry-kafka-cluster_kafka-3-data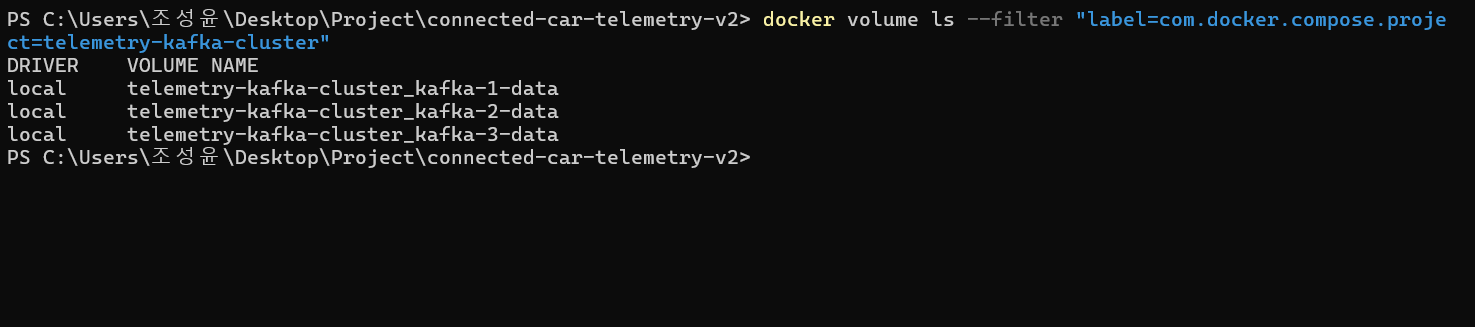
각 Broker가 자신의 파티션 Leader와 Follower Replica 로그를 별도의 볼륨에 저장합니다.
Kafka Broker 1 → kafka-1-data
Kafka Broker 2 → kafka-2-data
Kafka Broker 3 → kafka-3-data
컨테이너가 재시작돼도 동일한 볼륨을 다시 연결하면 기존 로그를 사용할 수 있습니다.
단, docker compose down -v는 Named Volume까지 삭제하므로 데이터 보존이 필요한 상황에서는 사용하지 않아야 합니다.
5. 12 Partition과 Replication Factor 3
이번에 생성한 토픽 설정은 다음과 같습니다.
Topic: vehicle-telemetry-v1
Partition Count: 12
Replication Factor: 3
min.insync.replicas: 2
상태를 확인했습니다.
docker exec kafka-1 /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server kafka-1:19092 \
  --describe \
  --topic vehicle-telemetry-v1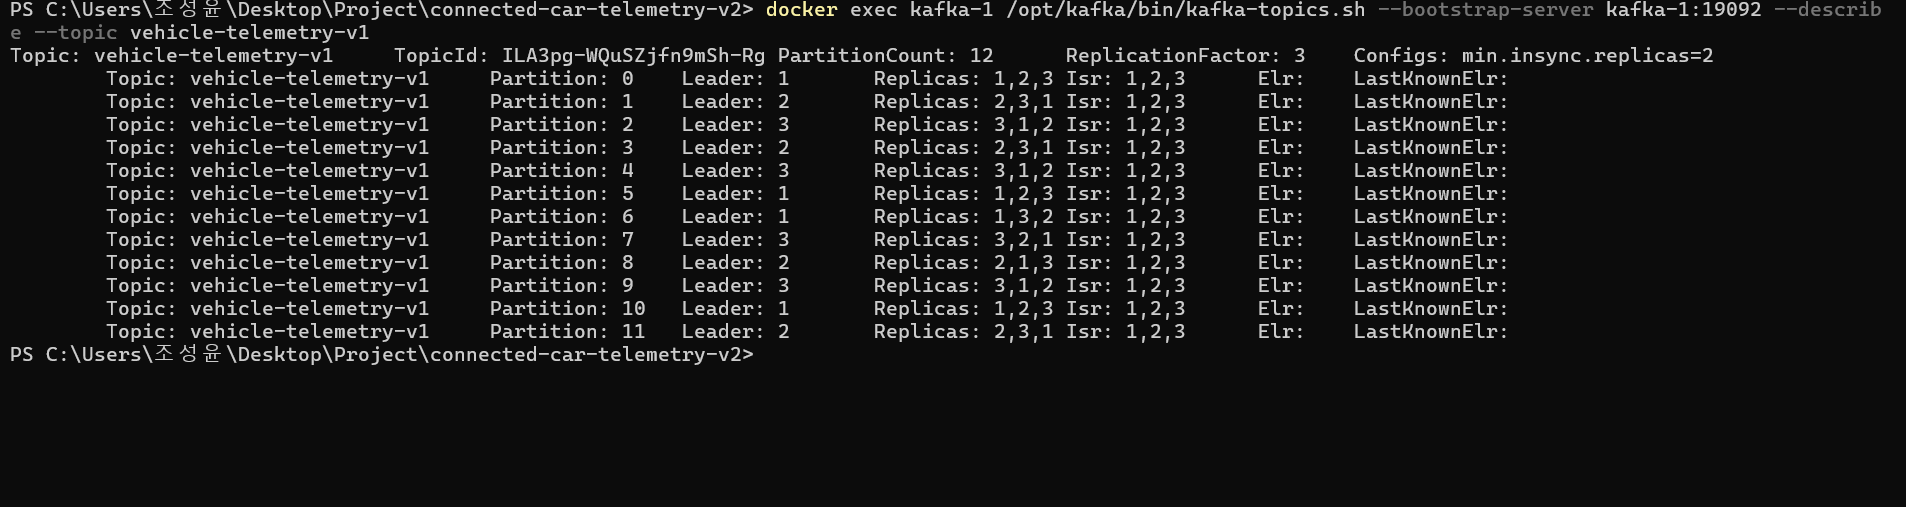
12개 파티션의 Leader가 Broker 세 대에 4개씩 분산됐습니다.
Broker 1 Leader → Partition 0, 5, 6, 10
Broker 2 Leader → Partition 1, 3, 8, 11
Broker 3 Leader → Partition 2, 4, 7, 9
각 파티션의 Replicas와 ISR에는 Broker 세 대가 모두 포함됐습니다.
복제 계수가 3이고 Broker도 정확히 3개이기 때문에 각 Broker에는 12개 파티션의 복제본이 모두 존재합니다.
Broker 1
├─ Leader Partition 4개
└─ Follower Partition 8개

Broker 2
├─ Leader Partition 4개
└─ Follower Partition 8개

Broker 3
├─ Leader Partition 4개
└─ Follower Partition 8개
쓰기 처리는 Leader 역할을 기준으로 분산되고, 실제 데이터는 세 Broker에 복제됩니다.
6. Leader, Replica, ISR 이해하기
각 파티션에는 하나의 Leader와 여러 Follower Replica가 존재합니다.
Partition 0
├─ Broker 1: Leader
├─ Broker 2: Follower
└─ Broker 3: Follower
Producer의 쓰기 요청은 Partition 0의 Leader인 Broker 1이 처리합니다.
Follower인 Broker 2와 Broker 3은 Leader가 기록한 로그를 복제합니다.
여기서 ISR은 In-Sync Replicas의 약자로, 현재 Leader와 정상적으로 동기화된 복제본 목록입니다.
Replicas: 1,2,3
ISR:      1,2,3
위 상태는 세 Broker가 모두 해당 파티션의 데이터를 정상적으로 가지고 있다는 의미입니다.
7. vehicle_id를 기준으로 파티션 분배
Producer는 vehicle_id를 Kafka Message Key로 사용하고 있습니다.
self.producer.produce(
    topic=self.topic,
    key=event["vehicle_id"].encode("utf-8"),
    value=message_value,
    on_delivery=self._delivery_report,
)
Kafka는 Message Key의 해시를 이용해 저장할 파티션을 결정합니다.
partition = hash(vehicle_id) % partition_count차량별 전용 파티션이 만들어지는 것은 아닙니다. 서로 다른 차량이 같은 파티션을 사용할 수 있습니다.
Partition 0
Offset 0 → vehicle_id=veh0
Offset 1 → vehicle_id=veh2
Offset 2 → vehicle_id=veh0
Offset 3 → vehicle_id=veh2
Offset은 차량별 칸이 아니라 파티션 내부에 저장된 레코드의 순번입니다.
파티션 수가 변경되지 않는 동안 같은 vehicle_id는 동일한 파티션으로 전달되므로, 같은 차량의 이벤트 순서를 파티션 내부에서 유지할 수 있습니다.
8. Broker 1을 직접 중단해보기
Producer가 계속 차량 데이터를 보내는 상태에서 Broker 1을 중단했습니다.
docker stop kafka-15초 뒤 Broker 2를 통해 토픽 상태를 확인했습니다.
docker exec kafka-2 /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server kafka-2:19092 \
  --describe \
  --topic vehicle-telemetry-v1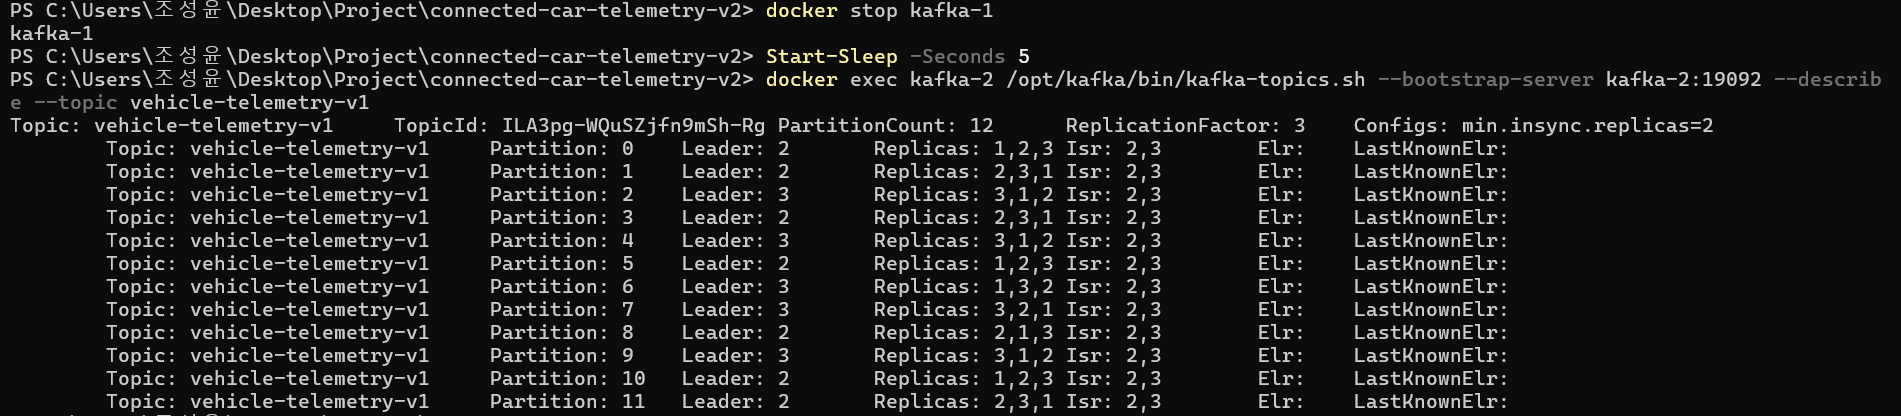
Broker 1이 Leader였던 파티션의 Leader가 Broker 2 또는 Broker 3으로 변경됐습니다.
Partition 0을 기준으로 보면 다음과 같습니다.
장애 전
Leader:   1
Replicas: 1,2,3
ISR:      1,2,3

Broker 1 장애 후
Leader:   2
Replicas: 1,2,3
ISR: 2,3Replicas는 해당 파티션을 저장하도록 지정된 Broker 목록이므로 그대로 유지됩니다.
반면 ISR은 현재 정상적으로 동기화된 복제본 목록이므로 중단된 Broker 1이 제외됐습니다.
Kafka는 ISR에 포함돼 있던 Follower 중 하나를 새로운 Leader로 선출했습니다.
Producer는 Kafka 메타데이터를 다시 확인한 뒤 새 Leader로 전송을 이어갔습니다.
9. 왜 Broker 한 대가 죽어도 쓰기가 계속됐을까
현재 구성에는 다음 설정이 함께 적용돼 있습니다.
Replication Factor: 3
min.insync.replicas: 2
Producer acks: all
enable.idempotence: truemin.insync.replicas=2는 정상 동기화된 복제본이 최소 두 개 있어야 쓰기를 허용한다는 의미입니다.
Broker 1 중단
→ 남은 ISR: Broker 2, Broker 3
→ 현재 ISR: 2개
→ 필요한 최소 ISR: 2개
→ 쓰기 계속 가능acks=all이므로 Leader만 기록한 것으로 성공 처리하지 않고, 현재 필요한 ISR에 복제가 완료돼야 Producer에 성공 응답을 반환합니다.
만약 Broker가 한 대 더 중단돼 ISR이 하나만 남는다면 조건을 만족하지 못합니다.
현재 ISR: 1개
필요한 최소 ISR: 2개
→ 쓰기 요청 성공 처리 불가
이 경우 Kafka는 데이터 유실 가능성이 있는 상태로 쓰기를 계속하기보다 요청을 거부합니다.
즉 현재 설정은 Broker 한 대의 장애까지는 처리를 계속하고, 두 대가 장애 나면 데이터 보호를 위해 쓰기를 중단하는 구성입니다.
10. Broker 1 복구와 ISR 재합류
Broker 1을 다시 실행했습니다.
docker start kafka-110초 뒤 토픽 상태를 다시 확인했습니다.
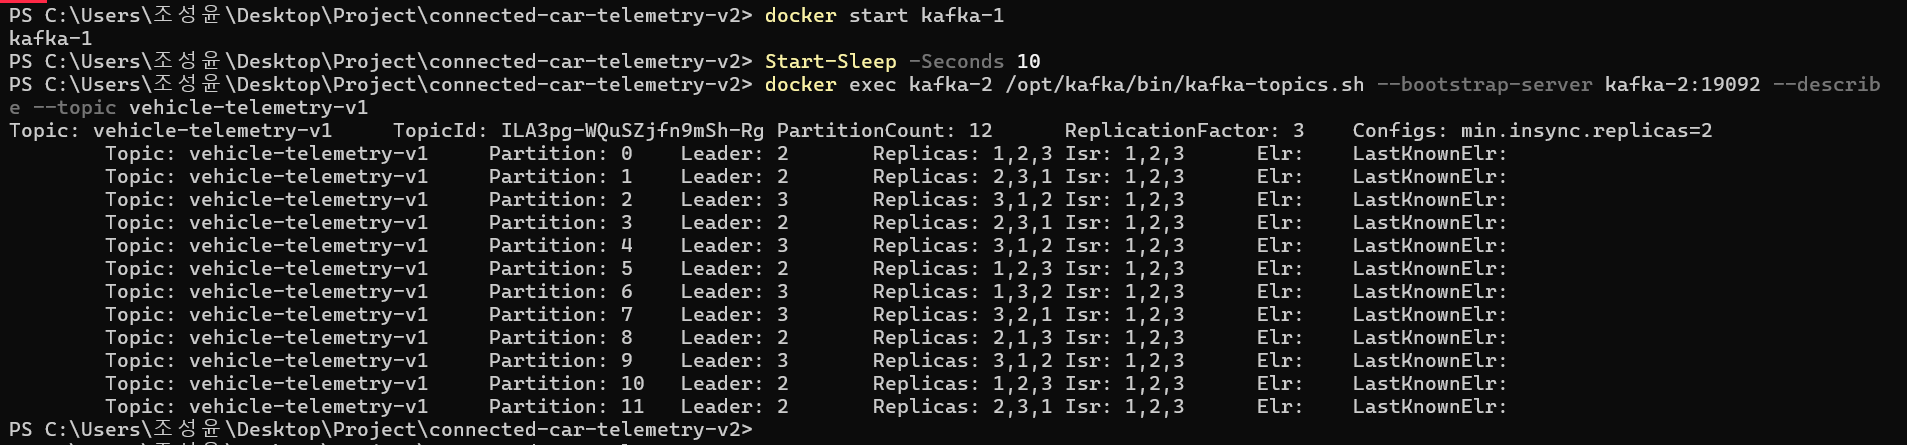
모든 파티션의 ISR이 다시 1,2,3으로 복원됐습니다.
Broker 1 실행
→ 현재 Leader에서 장애 중 누락된 로그 요청
→ 누락된 offset 구간 복제
→ Leader와 동일한 위치까지 추격
→ ISR에 다시 참가
Broker 1이 복구됐다고 해서 Leader 역할이 즉시 Broker 1로 돌아가지는 않았습니다.
Broker 2와 Broker 3이 이미 정상적으로 요청을 처리하고 있었기 때문에 Kafka는 현재 Leader를 유지하면서 Broker 1을 Follower로 다시 합류시켰습니다.
중요한 것은 Leader 역할의 원상 복귀가 아니라, Broker 1이 누락된 데이터를 복제하고 ISR에 정상적으로 복귀했는지입니다.
11. 장애 중에도 Offset은 증가했을까
Broker 중단 전 파티션별 end offset 합계는 5,438이었습니다.
Broker 1을 중단하고 다시 복구한 뒤에는 7,340으로 증가했습니다.
장애 전:       5,438
장애 복구 후:  7,340
증가량:        1,902
Broker 장애와 Leader 변경이 발생한 동안에도 1,902개의 레코드가 추가로 기록됐습니다.
최종적으로 SUMO 데이터 전송이 끝난 뒤 전체 end offset 합계를 계산했습니다.
$offsets = docker exec kafka-1 /opt/kafka/bin/kafka-get-offsets.sh `
  --bootstrap-server kafka-1:19092 `
  --topic vehicle-telemetry-v1

$stored = (
  $offsets |
  ForEach-Object { [long](($_ -split ':')[-1]) } |
  Measure-Object -Sum
).Sum

"Kafka stored records: $stored"
이번 토픽은 새로 생성됐고 earliest offset이 0이므로 파티션별 end offset 합계를 전체 저장 건수로 사용했습니다.
12. 저장된 11,113건을 다시 읽어보기
Kafka에 기록된 데이터를 처음부터 다시 소비했습니다.
docker exec kafka-1 /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server kafka-1:19092 \
  --topic vehicle-telemetry-v1 \
  --from-beginning \
  --max-messages 11113 \
  --property print.key=true \
  --property print.value=false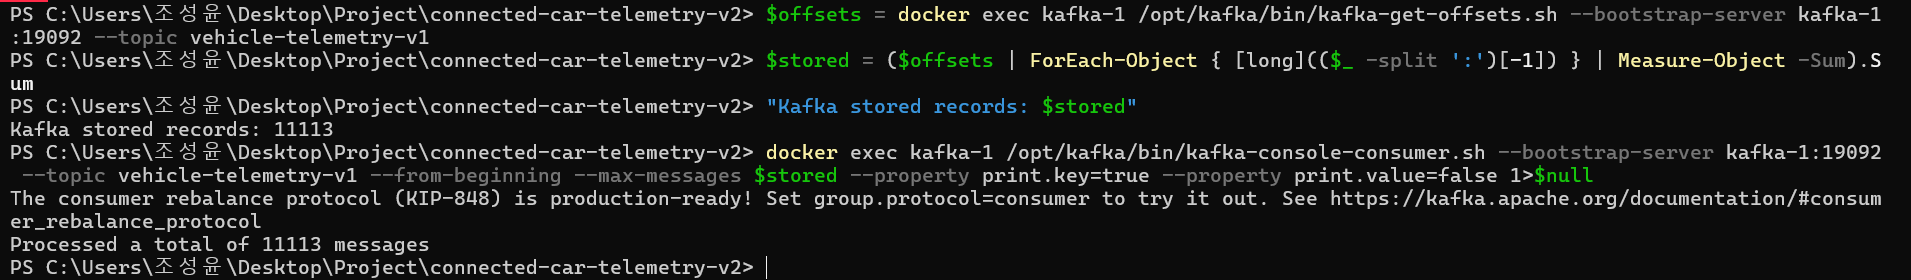
최종 결과는 다음과 같습니다.
Kafka stored records: 11113
Processed a total of 11113 messages
Kafka에 저장된 레코드 수와 처음부터 다시 소비한 레코드 수가 일치했습니다.
Kafka 저장 레코드: 11,113
Kafka 재소비 레코드: 11,113
Broker 장애 중 쓰기: 지속
Broker 복구 후 ISR: 1,2,3
따라서 Kafka가 기록한 11,113개의 레코드는 Broker 한 대의 장애 이후에도 보존됐으며, 모두 다시 읽을 수 있었습니다.
13. 아직 완전한 무손실이라고 단정하지 않는 이유
이번 실험으로 확인한 것은 다음과 같습니다.
Kafka 파티션 복제
Leader Election
Broker 장애 중 쓰기 지속
Broker 복구 후 ISR 복원
Kafka 저장 건수와 재소비 건수 일치
하지만 SUMO가 생성한 모든 이벤트가 Producer의 메모리 버퍼에 들어갔는지, delivery callback에서 최종 성공한 이벤트가 정확히 몇 개인지는 별도로 집계하지 않았습니다.
따라서 이번 결과는 다음과 같이 표현하는 것이 정확합니다.
Kafka가 성공적으로 기록한 11,113개의 레코드는 Broker 한 대의 장애 이후에도 보존됐으며, 전부 다시 소비할 수 있었다.
SUMO의 이벤트 생성 시점부터 완전한 무손실을 증명하려면 다음 값이 필요합니다.
SUMO 생성 이벤트 수
Producer delivery 성공 수
Producer delivery 실패 수
Kafka에서 소비한 고유 event_id 수
재시도 과정에서 애플리케이션 단위의 중복까지 검증하려면 event_id, run_id, sequence_no도 추가해야 합니다.
14. 이번 실험에서 이해한 Kafka의 장애 복구
처음에는 Broker가 세 개라면 데이터를 세 곳에 나눠 저장하는 정도로 생각했습니다.
실제로는 파티션마다 하나의 Leader와 여러 Follower Replica가 존재하고, Broker들이 여러 파티션의 Leader 역할을 나눠 맡습니다.
차량 이벤트 생성
→ vehicle_id로 파티션 결정
→ 해당 파티션의 Leader에 기록
→ Follower Replica로 복제
→ Leader Broker 장애
→ ISR Follower가 새로운 Leader로 승격
→ 기존 Broker 복구
→ 장애 중 누락된 로그 동기화
→ ISR 재합류
Kafka의 장애 복구는 단순히 죽은 프로세스를 다시 실행하는 것으로 끝나지 않았습니다.
이미 동기화된 복제본이 Leader가 되어 처리를 계속하고, 복구된 Broker는 중단된 동안 발생한 차이만 다시 복제했습니다.
그리고 안전하게 복제할 수 있는 Broker 수가 부족해지면 데이터 유실 가능성을 감수하고 쓰는 대신 요청을 거부하도록 구성할 수 있었습니다.
다음 단계
다음 실험에서는 Kafka 내부에 저장된 데이터뿐 아니라 SUMO에서 생성된 시점부터의 무손실 여부를 수치로 검증할 예정입니다.
event_id,run_id,sequence_no,event_time추가- Producer delivery 성공·실패 건수 집계
- Producer Bootstrap Server를 세 Broker로 구성
- Producer 메모리 버퍼와 backpressure 처리
- Broker 두 대 중단 시 쓰기 거부 확인
- 정상 상태와 장애 상태의 처리량 및 지연 비교
- 파티션 6개, 12개, 24개의 처리량 비교
- 실시간 모드와 부하 테스트 모드 분리
이번에는 “Kafka Broker를 세 개 실행했다”에서 끝나지 않고, Broker 한 대를 실제로 중단해 Leader 변경과 ISR 복원을 확인했습니다.
다음 단계에서는 Kafka가 받은 데이터뿐만 아니라 SUMO가 생성한 데이터부터 Producer와 Kafka를 거쳐 최종 소비될 때까지 전체 구간을 추적해보겠습니다.