- Introduction
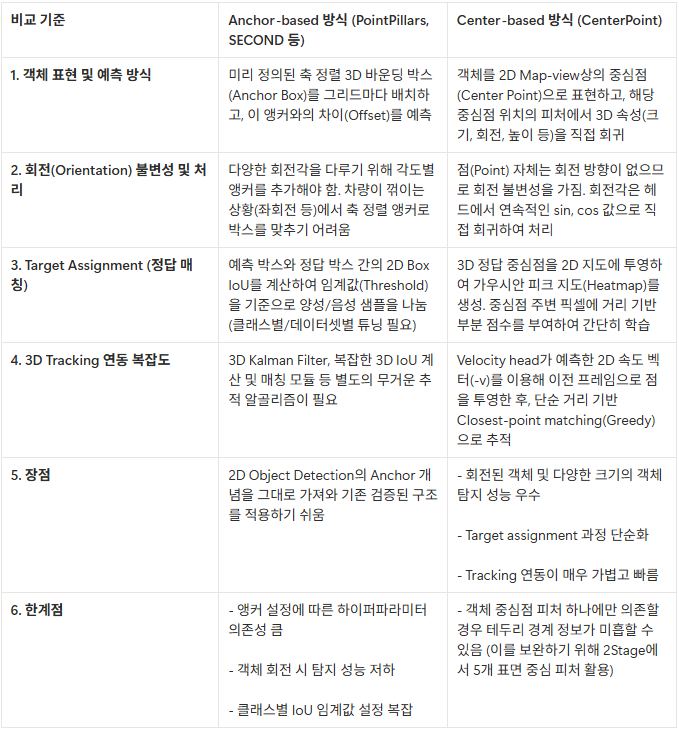
우리가 원래 객체 탐지 추적을 할때 바운딩 박스를 쳐서 하게 되는데 이것은 직선 주행에서는 괜찮지만 좌회전이나 우회전같이 회전을 할때 직사각형의 도형의 특성때문에 객체를 정확하게 탐지해내기가 적합하지 않다는것이다. 그리고 후보 앵커들을 만들고 그것들을 IOU기준으로 분류해 내는것은 연산이 복잡하다는 단점이 있다.
그래서 나온것이 그 객체의 중심점을 찾아서 그것을 중심으로 객체를 추적하자는것이다. 그렇게 되면 회전에 대해서도 상관이 없어지게 되기 때문이다. 또한 2D 바운딩 박스를 3D 바운딩 박스로 변환할때의 이격차이 또한 오류로 이어질수있기 때문에 부적합하다. 그래서 이것의 방법은 2단계로 이루어 지는데 처음에는 우선 VoxelNet이나 PointPillars의 기법을 이용해서 포인트 클라우드로 객체를 표현한 다음에 BEV로 객체를 평탄화시켜 본다. 그런다음에 객체의 중심점을 찾는다. 해당점을 가지고서 3D 정보를 구하고 그 3D 박스를 만든다음에 각면의 중심점들의 차이나 특성을 보고 2단계에서 3D 바운딩박스를 정교화하여 성능을 향상시킨다. 또한 점들끼리의 Greedy closest-point matching를 하여 속도벡터를 이용해서 추적까지 가능하다.
그 결과 Waymo open dataset과 nuScenes dataset에서의 뛰어난 성능을 보였다.
- Head
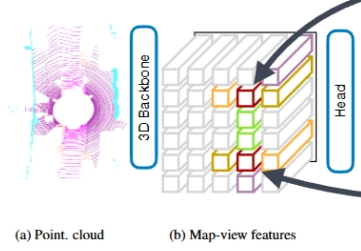
2-1. Center heatmap head
여기서 말하고자 하는것은 이 예측단계에서의 head에서 먼저 정답지를 주고 학습을 시켜야하는데 이 정답지를 만들때 3D 바운딩 박스에서 center의 위치를 2D 가우시안분포로 있을법한 위치에 대한 수치를 기록하는 headmap을 만든다. 이 과정에서 우리는 focal loss를 쓰는데 그 이유는 이 객체의 center point는 극히 공간상에서 일부분만 차지하기 때문에 이 중심점을 찾는 어려운일에 집중을 하기 위해서이다. 그리고우리가 supervision을 해야하는데 채점결과가 잘 나올수있도록 σ = max(f (wl), τ )식을 이용해서 점의 크기를 객체에 따라서 늘려주는 방식을 택했다. 그러고 나서 점수를 매기고 positive supervision으로 채점하여 학습을 시킨다.
2-2. Regression head
앞서 정답지를 만든것과 채점한 결과로 학습을 시키는데 학습을 할때는 정답 중심점만을 이용을 한다. 그 말은 처음에 정답지를 만들때 center heatmap head에서 모델이 학습할때에는 dense prediction을 하였지만 regression head에서 손실을 계산하여 학습을 할때는 정답 중심점만을 이용을 한다는것이다. 그리고 이 학습시에 L1 regression loss을 이용한다. 그 이후에 inference 단계에서는 이 3D 속성들을 가지고서 정답지(heatmap peak)rmsl에서 indexing을 해서 가져오기만 하고 모든 속성을 추출해낸다.
2-3. Velocity head and tracking
추가적으로 회귀 출력으로써 2차원 속도 추정치를 예측하여 현재 및 이전 타임스탭을 입력으로 넣어서 L1 손실 함수 계산으로 지도학습을 한다. 이것을 통해서 점들을 이어 tracking까지 가능하다.
- Two-stage CenterPoint
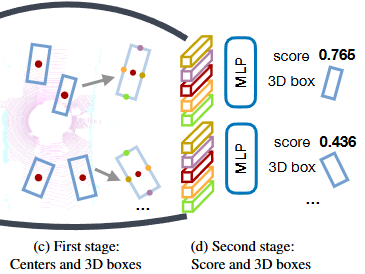
앞에 1단계에서 나온 예측 점들에서 더욱 정확하게 예측하기 위해서 bounding box 각 면에서의 중심점 4개를 추가로 추출한다. 그런 다음에 이것들의 특징을 추출하여 linear interpolation으로 특징을 매끄럽게 해주고 concatenate하여 MLP에 추출된 특징을 넣어준다. 그렇게 되면 최종적으로 1단계에서 예측한 Box가 정답과 얼마나 차이가 나는지에 대한 점수표가 나오게 된다. 해당 수치를 계산하는 식은 아래와 같다.
I = min(1, max(0, 2 × IoUt − 0.5)) (1)
Lscore = −It log( ˆIt) − (1 − It) log(1 − ˆIt) (2)
- Conclusion
본 기법은 2-stage 구조임에도 실시간 속도 측면에서도 뛰어난 성능을 보여주었다. 그 이유는 2D Feature Map M 재활용 및 3D / Raw Data Re-sampling 배제, 그리고 극단적으로 단순화된 특징 추출방식, 경량화된 MLP 사용 때문이었다. prediction, tracking 모두 데이터셋에서 뛰어난 성능을 보여주는 우수한 기법이다.