머신러닝을 학습하던 중 문득 이런 생각이 든 적 있었다.
아니,, 왜 더 학습하고 공부하는데 문제가 발생한다는 거지?
학습을 거듭할수록 더 똑똑하게 분류하고 처리해야하는 거 아니야?
지금부터, 이에 대해 하나씩 알아보고자 한다.
1. 과적합(overfitting) 정의
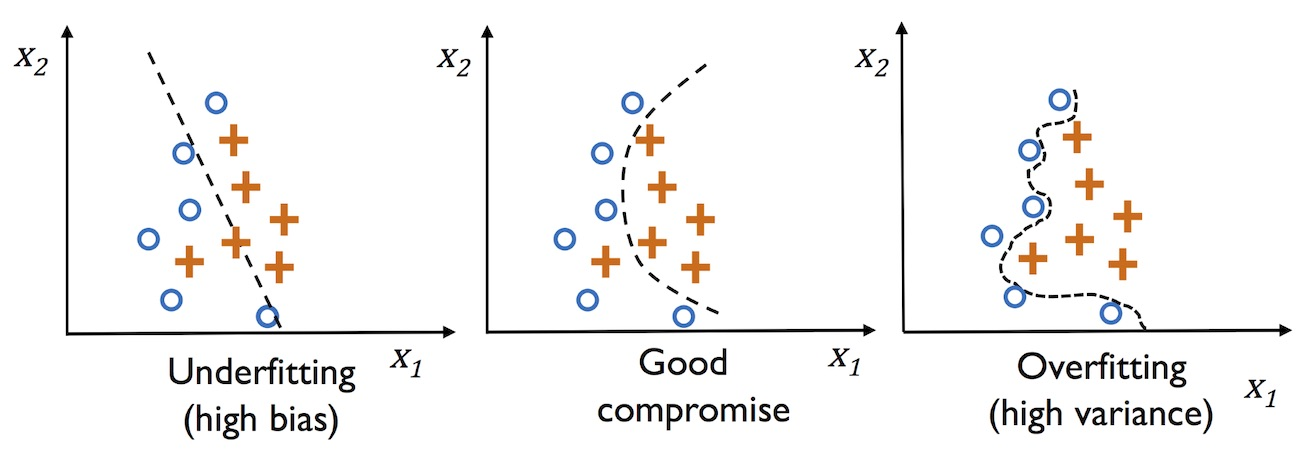
- 모델이 훈련(training) 데이터의 패턴뿐 아니라 노이즈(잡음)나 우연한 특징까지 지나치게 학습해서, 훈련 데이터에서는 높은 정확도, 새로운 데이터(테스트 데이터)에서는 낮은 정확도를 보이는 상태를 뜻한다.
2. 학습 데이터 vs 실제(또는 검증/테스트) 데이터의 괴리
일반적으로 생각하는 괴리라고 한다면 “성능 차이”를 뜻하지만, 조금 더 구체적으로 보면 과적합과 직접적으로 연결되는 세 가지 종류의 괴리가 있다.
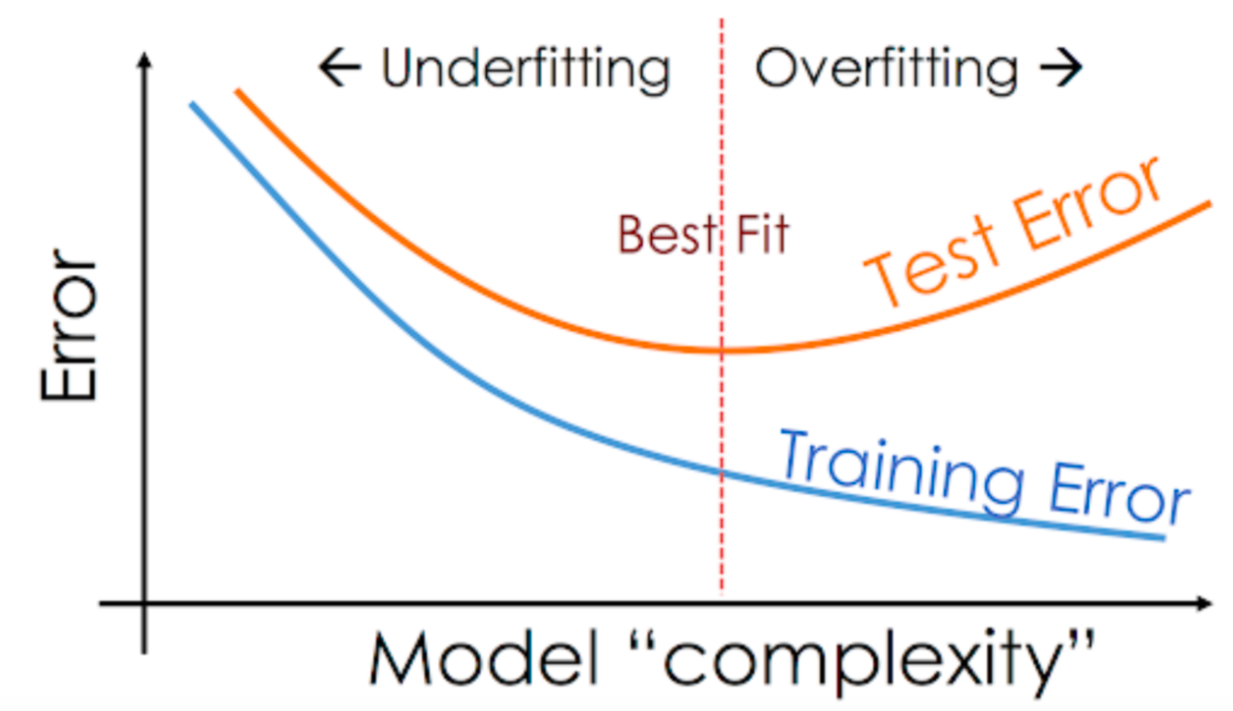
성능 괴리 (Performance Gap)
- 훈련 데이터에서는 정확도(accuracy)나 손실(loss)이 아주 좋은데, 검증 또는 테스트 데이터에서는 성능이 급격히 떨어지는 현상.
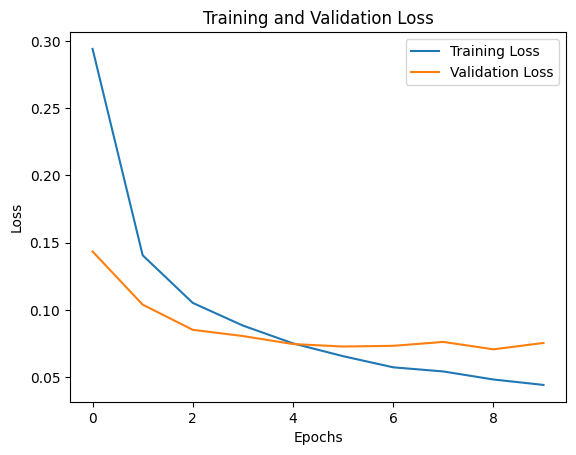
손실 함수 괴리 (Loss Curve Gap)
- 학습 과정에서 훈련 손실(training loss)은 꾸준히 줄어드는데, 검증 손실(validation loss)은 어느 시점부터 다시 증가하기 시작하는 현상.
일반화 괴리 (Generalization Gap)
- 모델이 ‘새로운 상황’에 적용될 때 성능이 얼마나 떨어지는 지를 나타내는 차이.
즉, 모델이 일반화(generalization)를 얼마나 잘했는지를 측정하는 지표.
3. 왜 과적합이 발생하는가(원인)
데이터 부족:
학습 데이터가 너무 적으면, 모델이 전체 패턴을 일반화하지 못함.
모델 복잡도 과도:
신경망 층이나 파라미터가 너무 많을 경우, 훈련 데이터에 과도하게 맞춤.
노이즈 많은 데이터:
불필요한 정보나 이상치가 포함되어 있을 때.
검증 과정 부족:
검증 데이터(validation set)를 따로 두지 않아 학습 중 성능 검증이 어려움.
4. 과적합의 결과:
학습 데이터에는 잘 맞지만 새로운 데이터엔 약함
- 일반화(generalization) 실패, 일반화 성능 저하
- 신뢰성 및 안정성 저하
- 자원 및 운영 비용 증가
- 데이터 왜곡 및 잘못된 인사이트
- 개인정보·보안 리스크 증가
- 데이터 노이즈(Noise)에 민감함
- 모델 복잡도 증가로 인한 해석 불가능성
5. 해결책:
모델 관련
-
정규화(regularization)
- 모델의 복잡도를 억제하기 위해 가중치에 패널티를 부여.
L1 정규화(가중치 절댓값 합), L2 정규화(가중치 제곱합)가 대표적.
수식 예시: L1: λ Σ|w|, L2: λ Σw² -
드롭아웃(dropout)
-학습 중 일부 노드(신경세포)를 무작위로 비활성화시켜 특정 경로에만 의존하지 않도록 함.
“시험공부할 때 매번 다른 문제집을 랜덤하게 푸는 것”과 비슷하며, CNN, RNN 등 딥러닝 모델에서 매우 효과적.
-
모델 단순화(Model Simplification)
- 불필요한 층(layer)이나 파라미터를 줄여 복잡도를 낮춤.
- 작은 모델이 오히려 일반화에는 더 강할 수 있음.
데이터 관련
-
데이터를 더 많이 확보
- 이미지, 텍스트, 음성 데이터 등은 ‘회전, 크기조정, 뒤집기, 잡음 추가’ 등으로 데이터를 늘릴 수 있음.
예) 이미지 분류에서 사진을 회전시키거나 색상 조정으로 학습 다양성 확보. -
데이터 정제
- 이상치 제거, 중복 데이터 제거 등으로 노이즈를 줄임.
훈련과정 관련
-
조기 종료(Early Stopping)
- 검증 데이터의 오류율이 더 이상 줄어들지 않으면 학습을 멈춤.
학습 데이터는 계속 좋아지더라도, 검증 데이터 성능이 나빠지면 ‘과적합 시작’ 신호로 판단. -
교차 검증(Cross Validation)
- 데이터를 여러 부분으로 나누어 번갈아가며 학습·검증을 반복. 데이터가 적을 때 특히 효과적. -
배치 정규화(Batch Normalization)
- 각 층의 입력 분포를 정규화해 안정적인 학습 유도. 드롭아웃과 함께 자주 사용됨.
++추가) 이해를 돕는 그림/그래프
 |  |  |
|---|
AI가 데이터를 잘 외우는 것도 중요하지만, 더 중요한 건 '새로운 상황에서도 실수를 줄이는 능력'이다. 과적합은 ‘암기형 천재’를 ‘응용력 약한 학생’으로 만드는 병이고, 이를 막기 위해 AI에게도 잊는 법과 균형 잡힌 공부법을 가르쳐야 한다고 생각한다.
6개의 댓글

블로그를 쓰게 된 계기가 너무 맘에 드네요. 학습 중 궁금하게 생겨서 찾아보셨다니.. 익숙함에 속아 소중함을 잃지말자는 말이 생각나는군요.,., 정리 감사합니당

저도 처음에는 과적합이라는 말이 이해가 어려웠습니다. 학습을 늘리는데 오히려 성능이 떨어진다는게 전혀 이해할 수 없었습니다. 과적합에 대해서 찾아보니 시험으로 비유한 설명이 가장 이해가 쉬웠습니다. 다들 한번씩은 겪어봤을 경험인 기출 문제를 반복적으로 풀었을 때 어느 순간 문제만 봐도 답이 뭔지 아는 경험입니다. 모델도 이와 같이 계속해서 학습을 해 문제만 봐도 답이 뭔지 알아 훈련 데이터의 정확도는 높지만 테스트 데이터의 정확도는 높지 않은 결과를 내는 과적합이 발생한다는 설명이 이해하기 편했습니다.


간단하게만 지나갔던 과대적합 내용을 더 제대로 이해할 수 있어서 좋았습니다. 우리가 ai모델을 쓰는 이유가 우리가 정확히 알고있는 데이터에만 적용하려는 목적이 아님을 항상 염두에 두어야겠습니다.
저도 동일한 의문점을 가졌던 적이 있었습니다,,, 저도 이해가 안되서 이전 포스트에 '모델이 데이터를 암기만 해버린 결과' 요렇게 이해를 했더니 이해가 잘 되더라구요! 과적합 해결책에 대해서 정리해주신 부분도 좋았습니다!