완전탐색은 가장 단순무식(?)한 방법이지만 알고리즘PS,코테에 있어서 가장 빈출유형이며 한번 배워놓으면 너무나 많이나오기때문에 가장 든든한 유형이다.
완전탐색은 그냥단순 for로 탐색하는 방식도 있지만,
DFS/BFS가 매우 빈출유형이다.
(DP와 함께..)
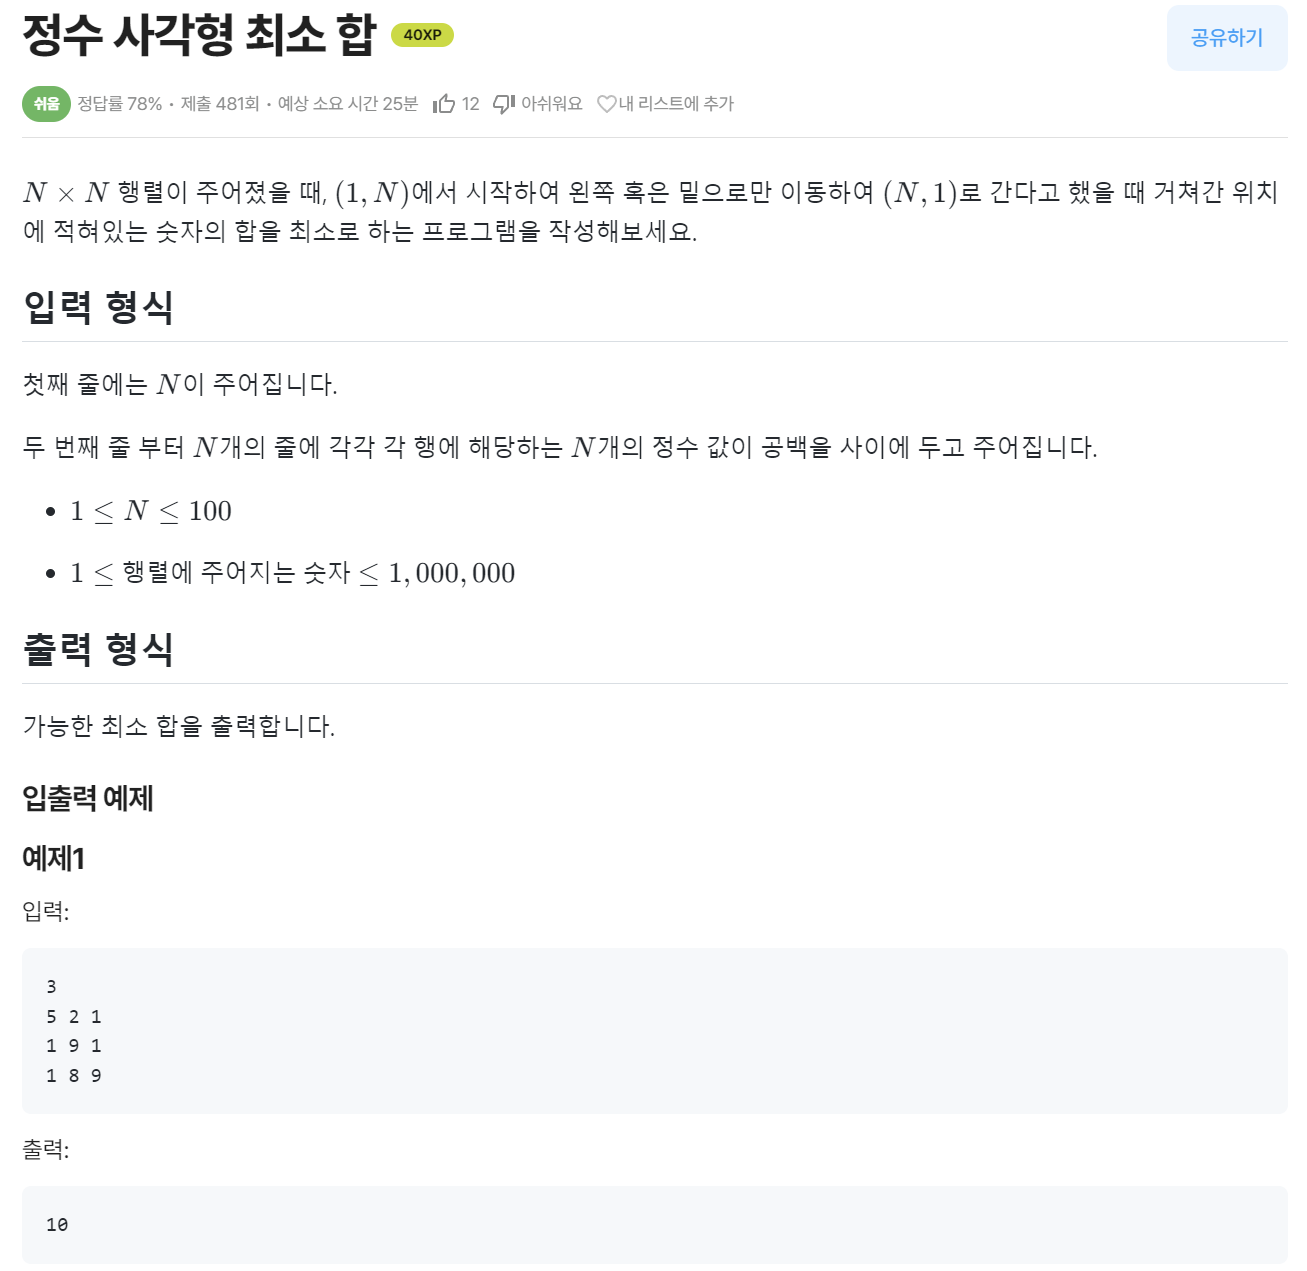
문제
https://www.codetree.ai/missions/2/problems/graph-traversal?&utm_source=clipboard&utm_medium=text
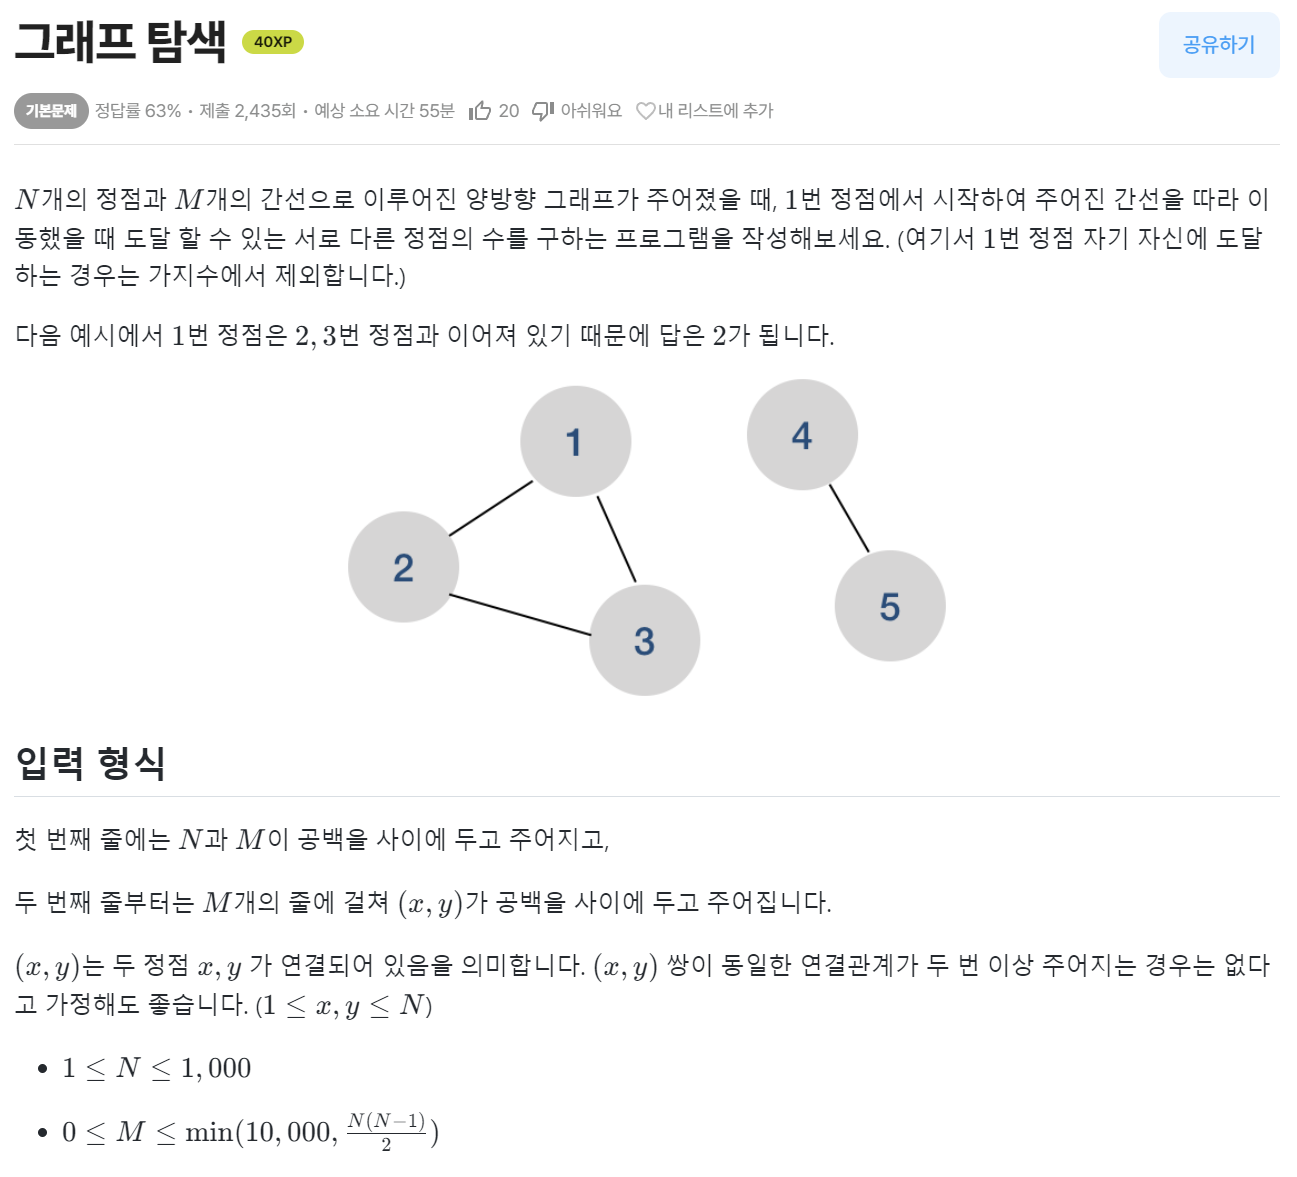
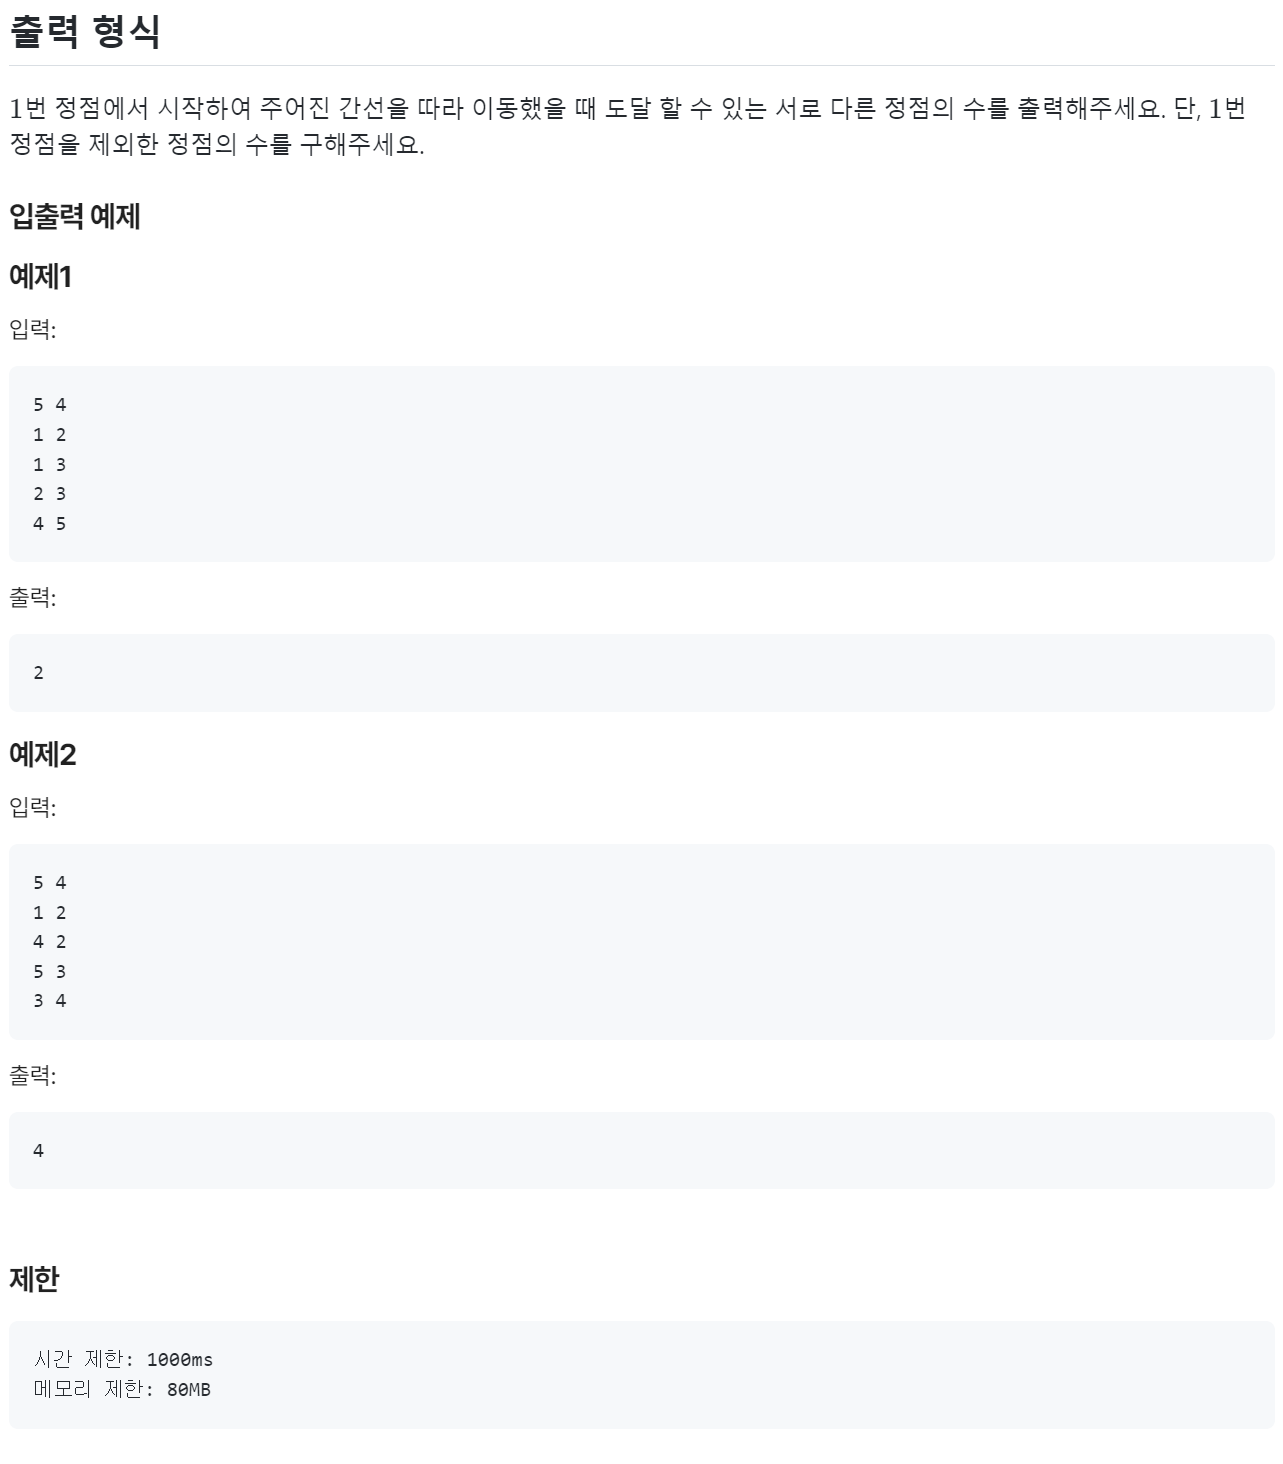
DFS기본 내용
dfs는 모든 녀석을 탐색하기 위한 코드로,
재귀함수와 stack으로 구현할수있지만, 편의상 재귀함수로 구현하는 것을 추천한다.
트리 자료구조와, 그래프 자료구조를 탐색할 수 있다.
트리 자료구조의경우 나를 호출했을때,
내 children들을 순회하면서 dfs( )호출을 하는 방식.
그래프 자료구조를 탐색할경우 같은 방식을 사용하면되나,
갔다가 다시 나에게돌아올수있기때문에 중복을방지하기위해 visited리스트에 플래그를 기록해줘야한다.
그래프의 표현.
인접행렬 (행렬 i,j쌍에 대한 연결여부를 1, 0 으로 표현)과
인접리스트 (i와 연결된 j,... 점들을 리스트형태로 가짐) 방식이 있다.
사실상 거의 모든경우에 인접리스트를 사용하는게 좋다.
코드 구현
import sys

# 입력
input = sys.stdin.readline

N, M = map(int, input().split())

graph = [[] for _ in range(N+1)]
for _ in range(M):
    i, j = map(int, input().split())
    graph[i].append(j) # 인접리스트
    graph[j].append(i)

# dfs
def dfs(i):
    global count
    for j in graph[i]:
        if not visited[j]:
            visited[j] = True
            count += 1
            dfs(j)

# 본문
visited = [False]*(N+1)
visited[1] = True
count = 0
dfs(1)
print(count)
파이썬의 함수는 외부스코프의 변수를 인자로 넘겨주지 않아도 원래 사용이 가능하다.
하지만 값에 할당하고자 할 경우 global 선언을 해주어야 그 변경이 반영된다.
따라서 count는 global 선언해준다.
가치를 빠르고 안전하게 전달하는 개발을 하고 싶습니다.