밑바닥부터 시작하는 딥러닝 깃허브: https://github.com/WegraLee/deep-learning-from-scratch
신경망
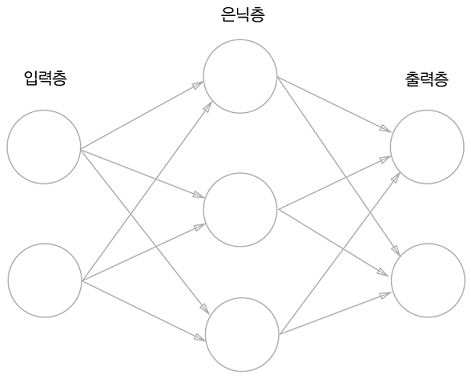
입력층을 0층, 은닉층을 1층, 출력층을 2층이라 한다. 은닉층은 입력층이나 출력층과 달리 사람 눈에 보이지 않는다.
활성화 함수
활성화 함수(activation function): 입력 신호의 총합을 출력 신호로 변환하는 함수. 입력 신호의 총합이 활성화를 일으키는지를 정하는 역할.
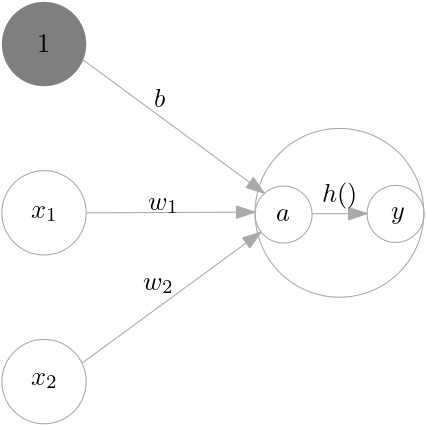
일반적으로 사용하는 활성화 함수
단층 퍼셉트론: 계단 함수
다층 퍼셉트론: 시그모이드 함수
활성화 함수
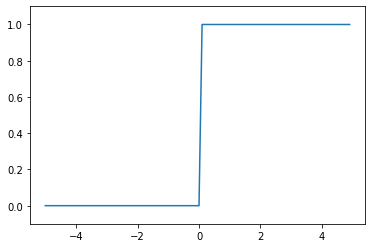
계단 함수
특정 임계값을 넘어가면 1 출력, 안넘어가면 0 출력
- 구현
# 인수로 실수만 받아들임
def step_function(x):
    if x > 0:
    	return 1
    else:
    	return 0

# 인수로 넘파이 배열 지원
def step_function(x):
	y = x > 0
return y.astype(np.int32)- 계단 함수 그래프
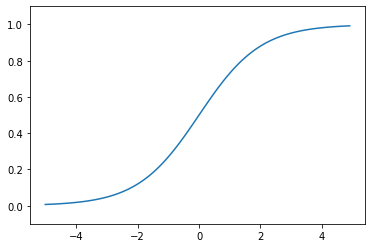
시그모이드 함수
연속적이고 비선형 함수. 주로 신경망의 활성화 함수로 많이 쓰인다.
-
식
-
구현
# 브로드캐스트 기능으로 넘파이 배열 처리 가능
def sigmoid(x):
return 1 / (1 + np.exp(-x))- 시그모이드 함수 그래프
계단 함수와 시그모이드 함수 비교
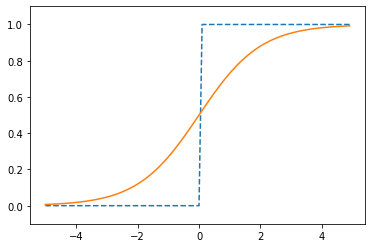
- 공통점
- 입력이 중요하면(입력이 클 때) 큰 값을 출력하고 입력이 중요하지 않으면(입력이 작을 때) 작은 값을 출력한다.
- 입력이 아무리 작거나 커도 출력은 0에서 1 사이이다.
- 비선형 함수이다.
- 차이점
- 계단 함수는 0과 1 중 하나의 값 출력. 시그모이드 함수는 연속적인 실수 값 출력.
활성화 함수로 비선형 함수를 사용하는 이유
선형 함수가 활성화 함수인 신경망은 층을 아무리 깊게 해도 '은닉층이 없는 네트워크'로도 똑같은 기능을 할 수 있기 때문이다.
예) 를 활성화 함수로 사용한 3층 네트워크의 출력은 이다. 즉 에서 으로 나타낼 수 있다.
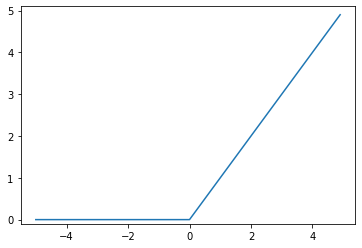
ReLU 함수
입력이 0을 넘으면 그대로 출력, 0 이하면 0을 출력
-
식
-
구현
def relu(x):
return np.maximum(0, x)- ReLu 함수 그래프
다차원 배열 계산
다차원 배열
숫자를 한 줄, 직사각형, 3차원, (일반화한) N차원으로 나열한 것
# 1차원 배열
A = np.array([1, 2, 3, 4])
np.ndim(A) 	# 1
A.shape 	# (4,)

# 2차원 배열
B = np.array([[1,2], [3,4], [5,6]])
np.ndim(B)	# 2
B.shape   	# (3, 2)
넘파이의 np.ndim()함수는 배열의 차원 수를 출력하고, 배열.shape은 배열의 형상을 출력한다.
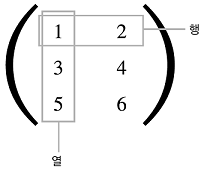
특히 2차원 배열은 행렬(matrix) 라고 부르고, 배열의 가로 방향을 행(row), 세로 방향을 열(column) 이라고 부른다.
행렬 곱
행렬 곱은 왼쪽 행렬의 행과 오른쪽 행렬의 열을 원소별로 곱하고 그 값들을 더해 계산한다.
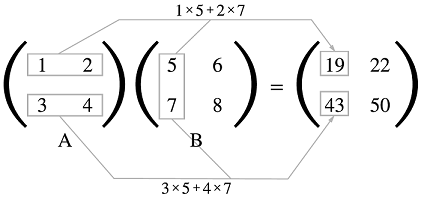
A = np.array([[1,2], [3,4]])
B = np.array([[5,6], [7,8]])
np.dot(A, B)
array([[19, 22],
[43, 50]])넘파이의 np.dot()함수는 입력이 1차원 배열이면 벡터를, 2차원 배열이면 행렬 곱을 계산한다.
np.dot(A, B) 와 np.dot(B, A) 는 다른 값이 될 수 있다.
위 예시는 2X2 형상의 행렬 이다. 만약 크기가 다른 형상의 배열을 곱할 땐 왼쪽 행렬의 1번째 차원의 원소 수(열 수)와 오른쪽 행렬의 0번째 차원의 원소 수(행 수)가 같아야 한다.
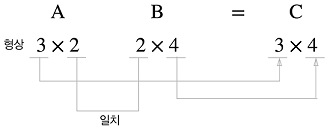
A = np.array([[1,2,3], [4,5,6]])
B = np.array([[1,2], [3,4], [5,6]])
np.dot(A, B) # OK

C = np.array([[1, 2], [3, 4]])
np.dot(A, C) # ERROR
신경망에서의 행렬 곱
편향과 활성화 함수를 생략한 신경망
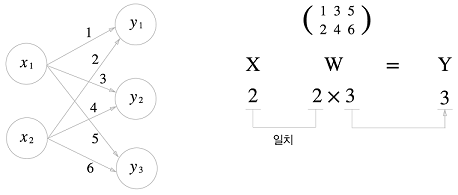
X = np.array([1,2])
X.shape # (2,)

W = np.array([[1,3,5], [2,4,6]])
W.shape # (2,3)

Y = np.dot(X, W)
Y.shape # (3,)
3층 신경망 구현
입력층 2개, 첫 번째 은닉층 3개, 두 번째 은닉층 2개, 출력층 2개의 뉴런으로 이뤄진 3층 신경망을 구현 한다.
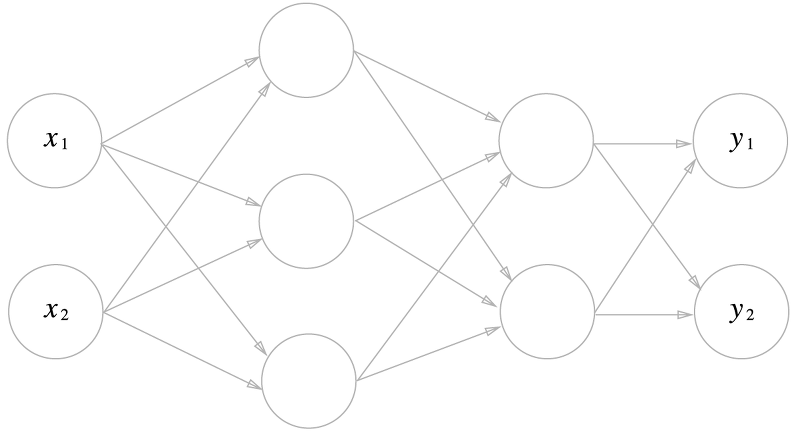
표기법
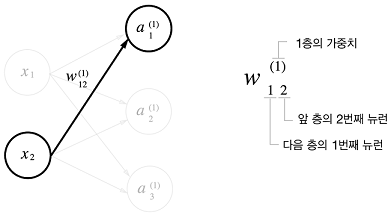
각 층의 신호 전달 구현
0층(입력층) -> 1층
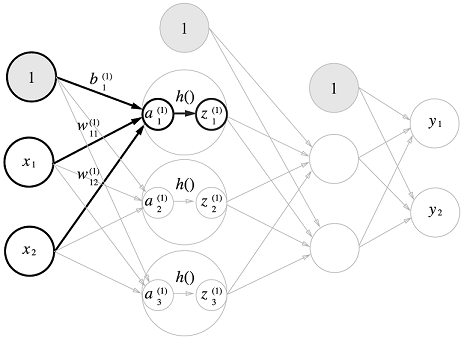
가중치 부분 간소화
각 행렬의 값
X = np.array([1.0, 0.5])
W1 = np.array([[0.1, 0.3, 0.5], [0.2, 0.4, 0.6]])
B1 = np.array([0.1, 0.2, 0.3])

A1 = np.dot(X, W1) + B1

# 활성화 함수로 시그모이드 함수 사용
Z1 = sigmoid(A1)
1층 -> 2층
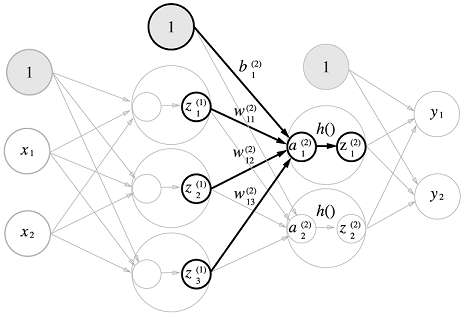
W2 = np.array([[0.1, 0.4], [0.2, 0.5], [0.3, 0.6]])
B2 = np.array([0.1, 0.2])

A2 = np.dot(Z1, W2) + B2

Z2 = sigmoid(A2)
2층 -> 3층(출력층)
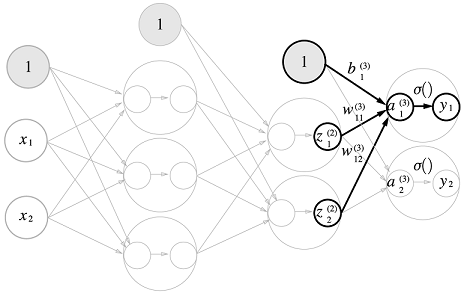
# 출력층 활성화 함수 정의
def identity_function(x):
    return x

W3 = np.array([[0.1, 0.3], [0.2, 0.4]])
B3 = np.array([0.1, 0.2])

A3 = np.dot(Z2, W3) + B3
Y = identity_function(A3)
구현 정리
def init_network(): # 가중치와 편향 초기화
    network = {}
    network['W1'] = np.array([[0.1, 0.3, 0.5], [0.2, 0.4, 0.6]])
    network['b1'] = np.array([0.1, 0.2, 0.3])
    network['W2'] = np.array([[0.1, 0.4], [0.2, 0.5], [0.3, 0.6]])
    network['b2'] = np.array([0.1, 0.2])
    network['W3'] = np.array([[0.1, 0.3], [0.2, 0.4]])
    network['b3'] = np.array([0.1, 0.2])
    return network

def forward(network, x): # 3층 처리과정 구현
    W1, W2, W3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']

    a1 = np.dot(x, W1) + b1
    z1 = sigmoid(a1)
    a2 = np.dot(z1, W2) + b2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, W3) + b3
    y = identity_function(a3)

    return y

network = init_network()
x = np.array([1.0, 0.5])
y = forward(network, x)
print(y) # [ 0.31682708  0.69627909]
처리과정 함수의 이름이 forward인 것은 신호가 순방향(입력 -> 출력)으로 전달됨(순전파)을 알리기 위함이다.
출력층 설계
신경망은 분류와 회귀 모두 사용할 수 있다. 둘의 차이는 출력층의 활성화 함수 차이에서 온다. 일반적으로 회귀엔 항등 함수를, 분류엔 소프트맥스 함수를 사용한다.
항등 함수와 소프트맥스 함수 구현
항등 함수
입력을 그대로 출력
def identity_function(x):
	return x
소프트맥스 함수
# exp에 큰 값이 들어가면 오버플로 문제 발생
def softmax(a):
	exp_a = np.exp(a)
    sum_exp_a = np.sum(exp_a)
    y = exp_a / sum_exp_a

    return y

# 개선 버전
def softmax(a):
	c = np.max(a)
	exp_a = np.exp(a - c) # 오버플로 대책
    sum_exp_a = np.sum(exp_a)
    y = exp_a / sum_exp_a

    return y
특징
- 출력은 0에서 1.0 사이의 실수이다.
- 소프트맥스 함수 출력의 총합은 1이다. '확률'로 해석할 수 있다.
- 소프트맥스 함수를 적용해도 각 원소의 대소 관계는 변하지 않는다. 따라서 신경망을 이용한 분류에선 출력층의 소프트맥스 함수를 생략해도 된다.
출력층 뉴런 수 정하기
분류에선 분류하고 싶은 클래스 수로 설정한다.
손글씨 숫자 인식
학습된 매개변수를 사용하여 학습 과정은 생략하고, 추론 과정만 구현한다. 이 추론과정을 신경망의 순전파(forward propagation)이라고 한다.
MNIST 데이터셋
- 손글씨 숫자 이미지 집합
- 0부터 9까지의 숫자 이미지로 구성
- 28 x 28 크기의 회색조 이미지(1채널), 각 픽셀은 0~255까지 값을 가짐
- 이미지가 실제 의미하는 숫자의 레이블
밑바닥 부터 시작하는 딥러닝 깃허브
MNIST 데이터셋을 내려받아 이미지를 넘파이 배열로 변화해주는 스크립트를 제공
import sys, os
sys.path.append(os.pardir) # 부모 디렉터리의 파일을 가져올 수 있도록 설정
from dataset.mnist import load_mnist

# 처음 한 번은 몇 분 정도 걸린다.
(x_train, t_train), (x_test, t_test) = \
    load_mnist(flatten=True, normalize=False)

# 각 데이터의 형상 출력
print(x_train.shape) 	# (60000, 784)
print(t_train.shape) 	# (60000,)
print(x_test.shape) 	# (10000, 784)
print(t_test.shape) 	# (10000,)
load_mnist()의 인수로 normalize, flatten, one_hot_label 세 세가지를 설정 할 수 있다.
- normalize는 입력 이미지의 픽셀 값을 0.0~1.0 사이의 값으로 정규화할지 정한다.
- flatten은 입력 이미지를 1차원 배열로 만들지 정한다.
( 입력 이미지를 1x28x28의 3차원 배열에서 784의 1차원 배열로 만들어 준다. )- one_hot_label은 레이블을 one-hot encoding형태로 저장할지 정한다.
( [0, 0, 1, 0, 0, 0, 0, 0, 0, 0]처럼 정답을 뜻하는 원소만 1이고 나머진 0인 배열 )
훈련 이미지 출력
# 데이터셋 불러오기
import sys, os
import matplotlib.pyplot as plt

sys.path.append(os.pardir)
from dataset.mnist import load_mnist

(x_train, t_train), (x_test, t_test) = \
	load_mnist(flatten=True, normalize=False)

img = x_train[0].reshape(28, 28)
plt.imshow(img, cmap='gray')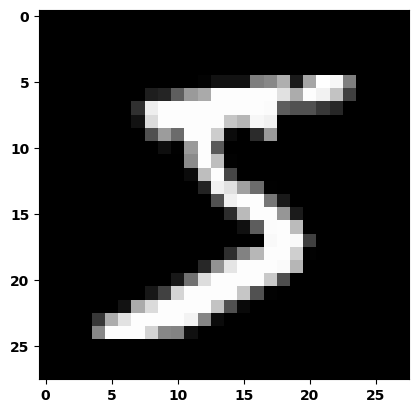
신경망 추론 처리
미리 학습된 매개변수를 이용하여 추론한다. 첫 번째 은닉층에는 50개 뉴런을, 두 번째 은닉층에는 100개의 뉴런을 배치한다. 이 숫자는 임의로 정한 값이다.
import numpy as np
import pickle

from dataset.mnist import load_mnist
from common.functions import sigmoid, softmax

# 작업 처리 해줄 함수
def get_data():
    (x_train, t_train), (x_test, t_test) = \
        load_mnist(flatten=True, normalize=True, one_hot_label=False)
    return x_test, t_test

def init_network():
    with open("./sample_weight.pkl", 'rb') as f:
        network = pickle.load(f)

    return network

def predict(network, x):
    W1, W2, W3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']

    a1 = np.dot(x, W1) + b1
    z1 = sigmoid(a1)
    a2 = np.dot(z1, W2) + b2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, W3) + b3
    y = softmax(a3)

    return y
정확도 평가
x, t = get_data()
network = init_network()

accuracy_cnt = 0
for i in range(len(x)):
    y = predict(network, x[i])
    p = np.argmax(y) # 확률이 가장 높은 원소의 인덱스 반환
    if p == t[i]:
        accuracy_cnt += 1

print("Accuracy:" + str(float(accuracy_cnt) / len(x)))
# Accuracy:0.9352정규화(normalization): 입력 데이터를 특정 범위로 변환하는 처리
전처리(pre-processing): 입력 데이터에 특정 변환을 가하는 것
배치 처리
배치(batch): 입력 데이터의 묶음
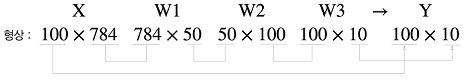
위 식은 이미지 100개를 묶어 처리하는 과정의 형상 추이이다. 이 처럼 하면 이미지 데이터 100장의 출력값이 한번에 나온다.
배치 처리를 해주는 이유
1. 수치 계산 라이브러리 대부분은 큰 배열을 효율적으로 처리할 수 있도록 최적화되어 있다.
2. 데이터 전송이 병목으로 작용하는 경우, 배치 처리 함으로써 버스에 주는 부하를 줄일 수 있다.
x, t = get_data()
network = init_network()

batch_size = 100
accuracy_cnt = 0

for i in range(0, len(x), batch_size):
    x_batch = x[i:i+batch_size]
    y_batch = predict(network, x_batch)
    # 1번째 차원을 구성하는 원소에서 최댓값의 인덱스 반환
    p = np.argmax(y_batch, axis=1)
    accuracy_cnt += np.sum(p == t[i:i+batch_size])

print("Accuracy:" + str(float(accuracy_cnt) / len(x)))