"Garbage In, Garbage Out"EDA(Exploratory Data Analysis)
가공하지 않은 원천의 데이터를 있는 그대로 탐색하고 분석하는 기법
EDA와 데이터 시각화의 차이
-
EDA 단계에서는 데이터 파악을 좀 더 효율적으로 하기 위해 시각화
-> 주로 데이터의 초기 탐색과 이해를 위한 과정 -
데이터 시각화의 궁극적 목적은 분석 결과를 커뮤니케이션 하기 위함
-> 분석 결과를 효과적으로 전달
10.2 공분산과 상관성 분석
왜도 : shew()
첨도 : kurtosis()
공분산 : cov()
상관계수 : corr()
#cov(), corr() 함수는 알아서 문자형 변수를 제외하고 변수 간 상관관계를 계산해준다!
EDA에서 평균, 분산, 왜도, 첨도, 결측치 등 각 변수들의 특성을 파악한 다음 변수 간의 관계를 파악한다.
타깃 변수 Y와 입력변수 X와의 관계는 물론 입력변수 X들 간의 관계도 살펴보아야 한다.
-> 이를 통해 독립변수의 변화에 따른 종속 변수의 변화량을 크게 하여 통계적 정확도를 감소시키는 다중공선성을 방지할 수 있다.
- 공분산 : 서로 공유하는 분산(두 분산의 관계를 뜻함), 변수 간의 상관계수를 수치화한 것
-> 한계 존재 : 각 변수 간의 다른 척도기준이 그대로 반영되어 공분산 값이 지니는 크기가 상관성의 정도를 나타내지 못함
ex) X1 과 X2의 공분산 값이 1300이고, X3 와 X4의 공분산 값이 800이라 할 때 X1 & X2의 상관관계가 X3 & X4의 상관관계보다 크다고 할 수 없다.
-> 이러한 단점을 해결하기 위해 정규화(normalize)를 하여 상관성을 비교하기도 하지만 절대적인 기준이 될 수 없기 때문에 피어슨(Pearson)상관계수를 많이 사용한다.
- 피어슨 상관계수는 X1, X2가 함께 변하는 정도(공분산)를 X1, X2가 변하는 전체 정도로 나눠준 것이다. 함께 변하는 정도는 전체가 변하는 총량을 초과할 수 없기 때문에 (-1<= R <= 1)
corr(method='pearson')
[상관계수]
0.7 이상 : 상관관계가 매우 높음
0.4 이상 : 상관관계가 있음
- 주의할 점 * 산점도의 기울기와 상관계수는 관련이 없다. 분산의 관계성이 같다면, 기울기가 크든 작든 상관계수는 같다.
상관계수가 높다는 것은 X1이 움직일 때 X2가 많이 움직인다는 뜻이 아니라 X2를 예상할 수 있는 정확도, 즉 설명력이 높다는 것이다.
- 상관분석은 두 변수의 선형관계만을 측정할 수 있기 때문에 2차 방정식 그래프와 비슷한 모양이 될 경우 상관계수가 매우 낮게 측정될 수 있다.
10.3 시간 시각화
Time series 시계열 형태는 시간 흐름에 따른 데이터의 변화를 표현하는 것.
이를 통해 전체적인 흐름을 한눈에 확인할 수 있고, 데이터의 트렌드나 노이즈도 쉽게 찾아낼 수 있음.
-
연속형 선그래프 : 시간 간격의 밀도가 높을 때 사용
-> 데이터의 양이 너무 많거나 변동이 심하면 추세선을 삽입하여 데이터 흐름을 안정된 선으로 표현 (ex. 이동평균,Moving average) -
분절형 막대그래프 : 시간 간격의 밀도가 낮고 상대적 차이를 나타내는 것에 유리
10.4 비교 시각화
- 히트맵 차트
- 방사형 차트(Radar chart)
- 평행 좌표 그래프(parallel coordinates)
10.5 분포 시각화
데이터가 처음 주어졌을 때, 변수들이 어떤 요소로 어느 정도의 비율로 구성되어 있는지를 확인하는 단계
- 연속형과 같은 양적 척도인지 (막대그래프, 선그래프, 히스토그램)
-> 구간이 너무 많으면 보기가 어렵고 너무 적으면 정보의 손실이 크기 때문에 시각화의 이점이 사라진
- 명목형과 같은 질적 척도인지에 따라 구분해서 그린다.(구성이 단순한 경우 파이차트, 도넛차트 사용하고 복잡한 경우 트리맵차트, 와플차트를 이용)
10.6 관계 시각화
산점도를 그릴 때는 극단치를 제고하고서 그리는 것이 좋다. 극단치로 인해 주요 분포 구간이 압축되어 시각화의 효율이 떨어지기 때문에..
산점도는 두 개의 변수 간 관계만 표현할 수 있다는 단점이 있지만
버블 차트를 이용하면 세 가지 요소의 상관관계를 표현할 수 있다. 버블의 크기를 통해 한 가지 요소를 추가적으로 볼 수 있는 것. 버블의 색상이나 농도 요소도 추가 가능하지만 한 번에 제공되는 정보가 너무 많으면 해석이 어려워짐.
- 버블차트를 해석할 대는 원의 지름이 아닌 면적을 통해 크기를 판단하도록 주의해야 함 (지름이 2배면 실제 크기는 4배)
10.7 공간 시각화
위치 정보인 위도와 경도 데이터를 지도에 매핑하여 시각적으로 표현
단순 이미지로 표현되는 것이 아닌, 지도를 확대하거나 위치를 옮기는 등의 인터랙티브한 활용이 가능함. 때문에 이러한 이점을 최대한 활용하여 정보를 효과적으로 전달할 수 있도록 거시적에서 미시적으로 진행되는 분석 방향과 같이 스토리라인을 잡고 시각화를 적용하는 것이 좋음. (도트맵, 코로플레스맵, 버블맵, 컨넥션맵)
P.201
-
도트맵, Dot map : 지리적 위치에 동일한 크기의 작은 점을 찍어서 해당 지역의 데이터 분포나 패턴을 표현하는 기법
-> 시각적 개요 파악에 유리 But 정확학 값 전달 어려워 축소해서 보면 숫자로 정확한 수치를 표현하고 확대하면 점으로 표시되도록 하는 기법 사용 -
버블맵, Bubble map : 버블차트를 지도에 옮긴 것
-> 코로플레스맵보다 비율을 비교하는 것이 효과적 But 버블이 지나치케 커서 다른 버블과 겹칠 수 있으니 잘 조절해야함. -
코로플레스맵, Choropleth map : 단계 구분도, 데이터 값의 크기에 따라 색상의 음영을 달리하여 해당 지역에 대한 값을 시각화하는 기법
-> 정확한 수치를 인지하고 비교하는 것이 어려움, 작은 지역들에 비해 큰 지역이 강조되는 인상을 줄 수 있으니 유의 -
커넥션맵, Connection map/ 링크맵, Link map : 지도에 찍힌 점들을 곡선 또는 직선으로 연결하여 지리적 관계를 표현.
-> 일반적으로는 연결선의 분포와 집중도를 통해 지리적 관계의 패턴을 파악하기 위해 사용. 지역간의 무역 관계나 항공 경로나 통신 정보 흐름 등을 표현할 때 사용.
+커넥션 맵과 유사하지만 시작점과 도착점이 함께 표현되는 플로우맵, 각 지역의 면적을 데이터 값에 비례하도록 변형시켜 시각화하는 카토그램 등의 공간 시각화 방법이 있다.
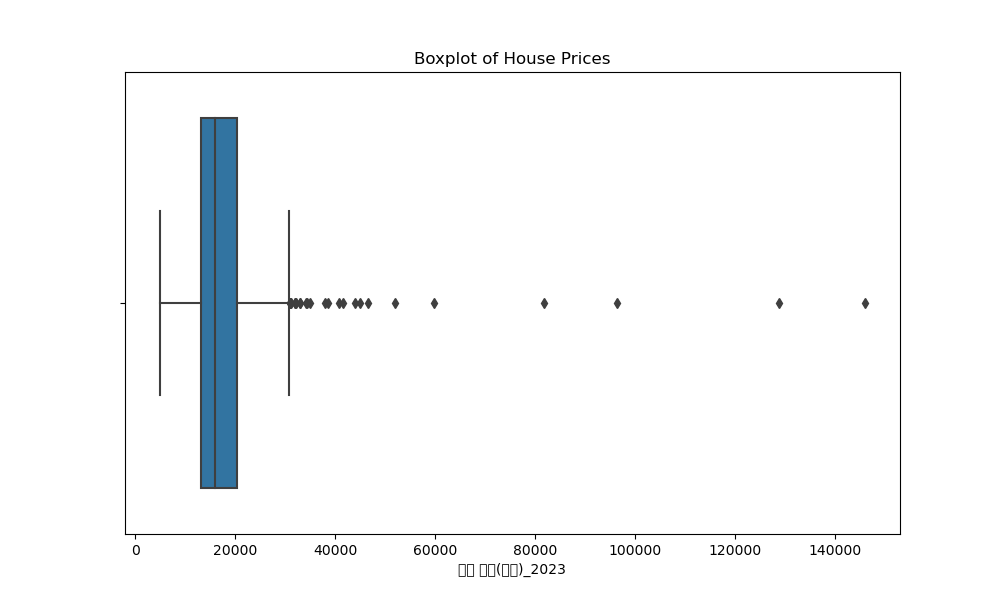
10.8 박스 플롯
박스 플롯은 하나의 그림으로 양적 척도 데이터의 분포 및 평향성, 평균과 중앙값 등 다양한 수치를 보기 쉽게 정리해 준다.
- 최솟값 : 제1사분위에서 1.5 IQR을 뺀 위치
- 제1사분위 : 25% 위치
- 제2사분위 : 50% 위치 중앙값(median)
- 제3사분위 : 75% 위치
- 최댓값 : 제3사분위에서 1.5 IQR을 더한 위치
P.214 그림 삽입
----------예시 프로젝트----------
KHUDA 5기 TOY-Project 1조
"서울특별시 오피스텔 실거래가 분석을 통한 경희대학교 주변 집값 예측"
EDA를 왜 할까?
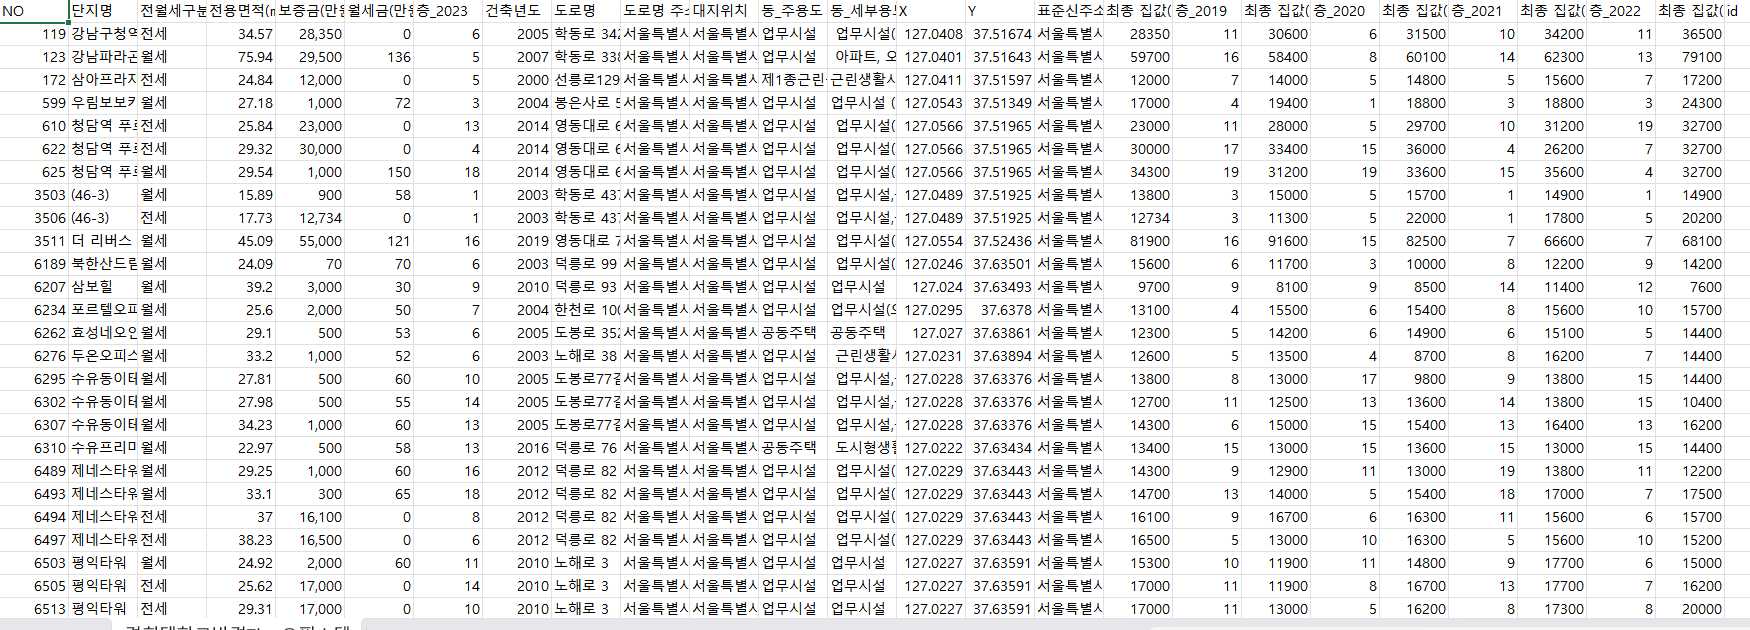
(위는 경희대학교 서울캠퍼스의 7km 반경 내의 오피스텔 데이터이다.)
ㄴ 나열된 데이터를 통해 인사이트를 얻기 어려움
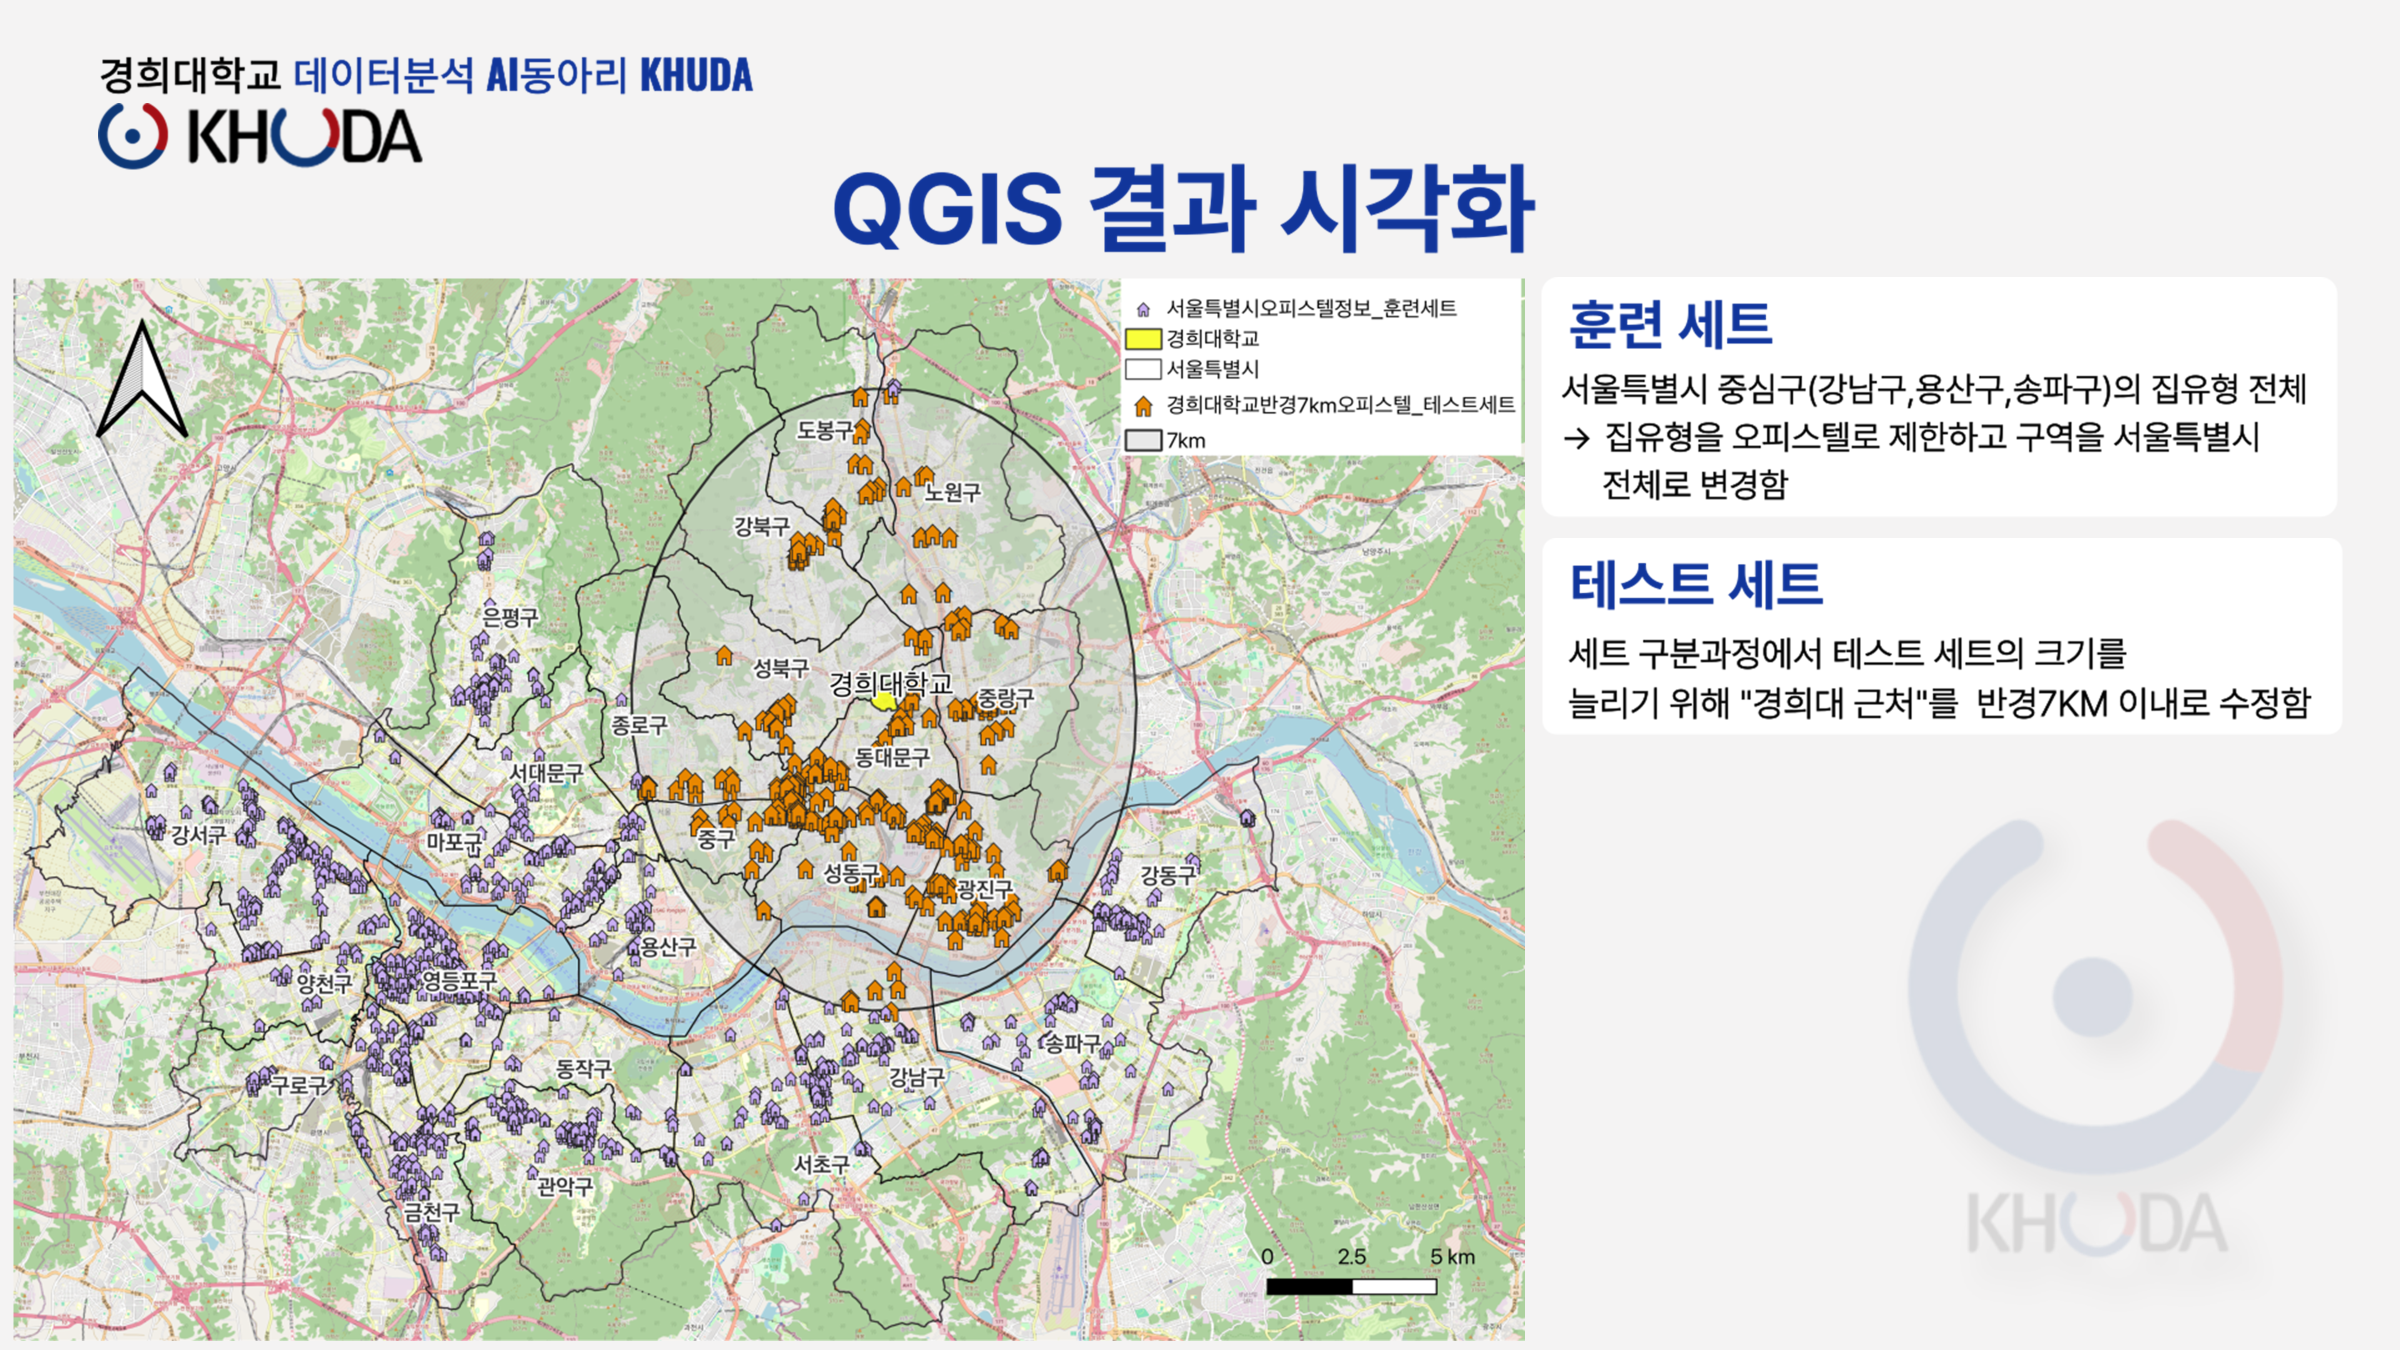
QGIS(Quantum Geographic Information System)와 같은 공간 시각화를 통해 프로젝트의 개요를 시각적으로 확인 가능
ㄴ 추가적인 인사이트가 필요
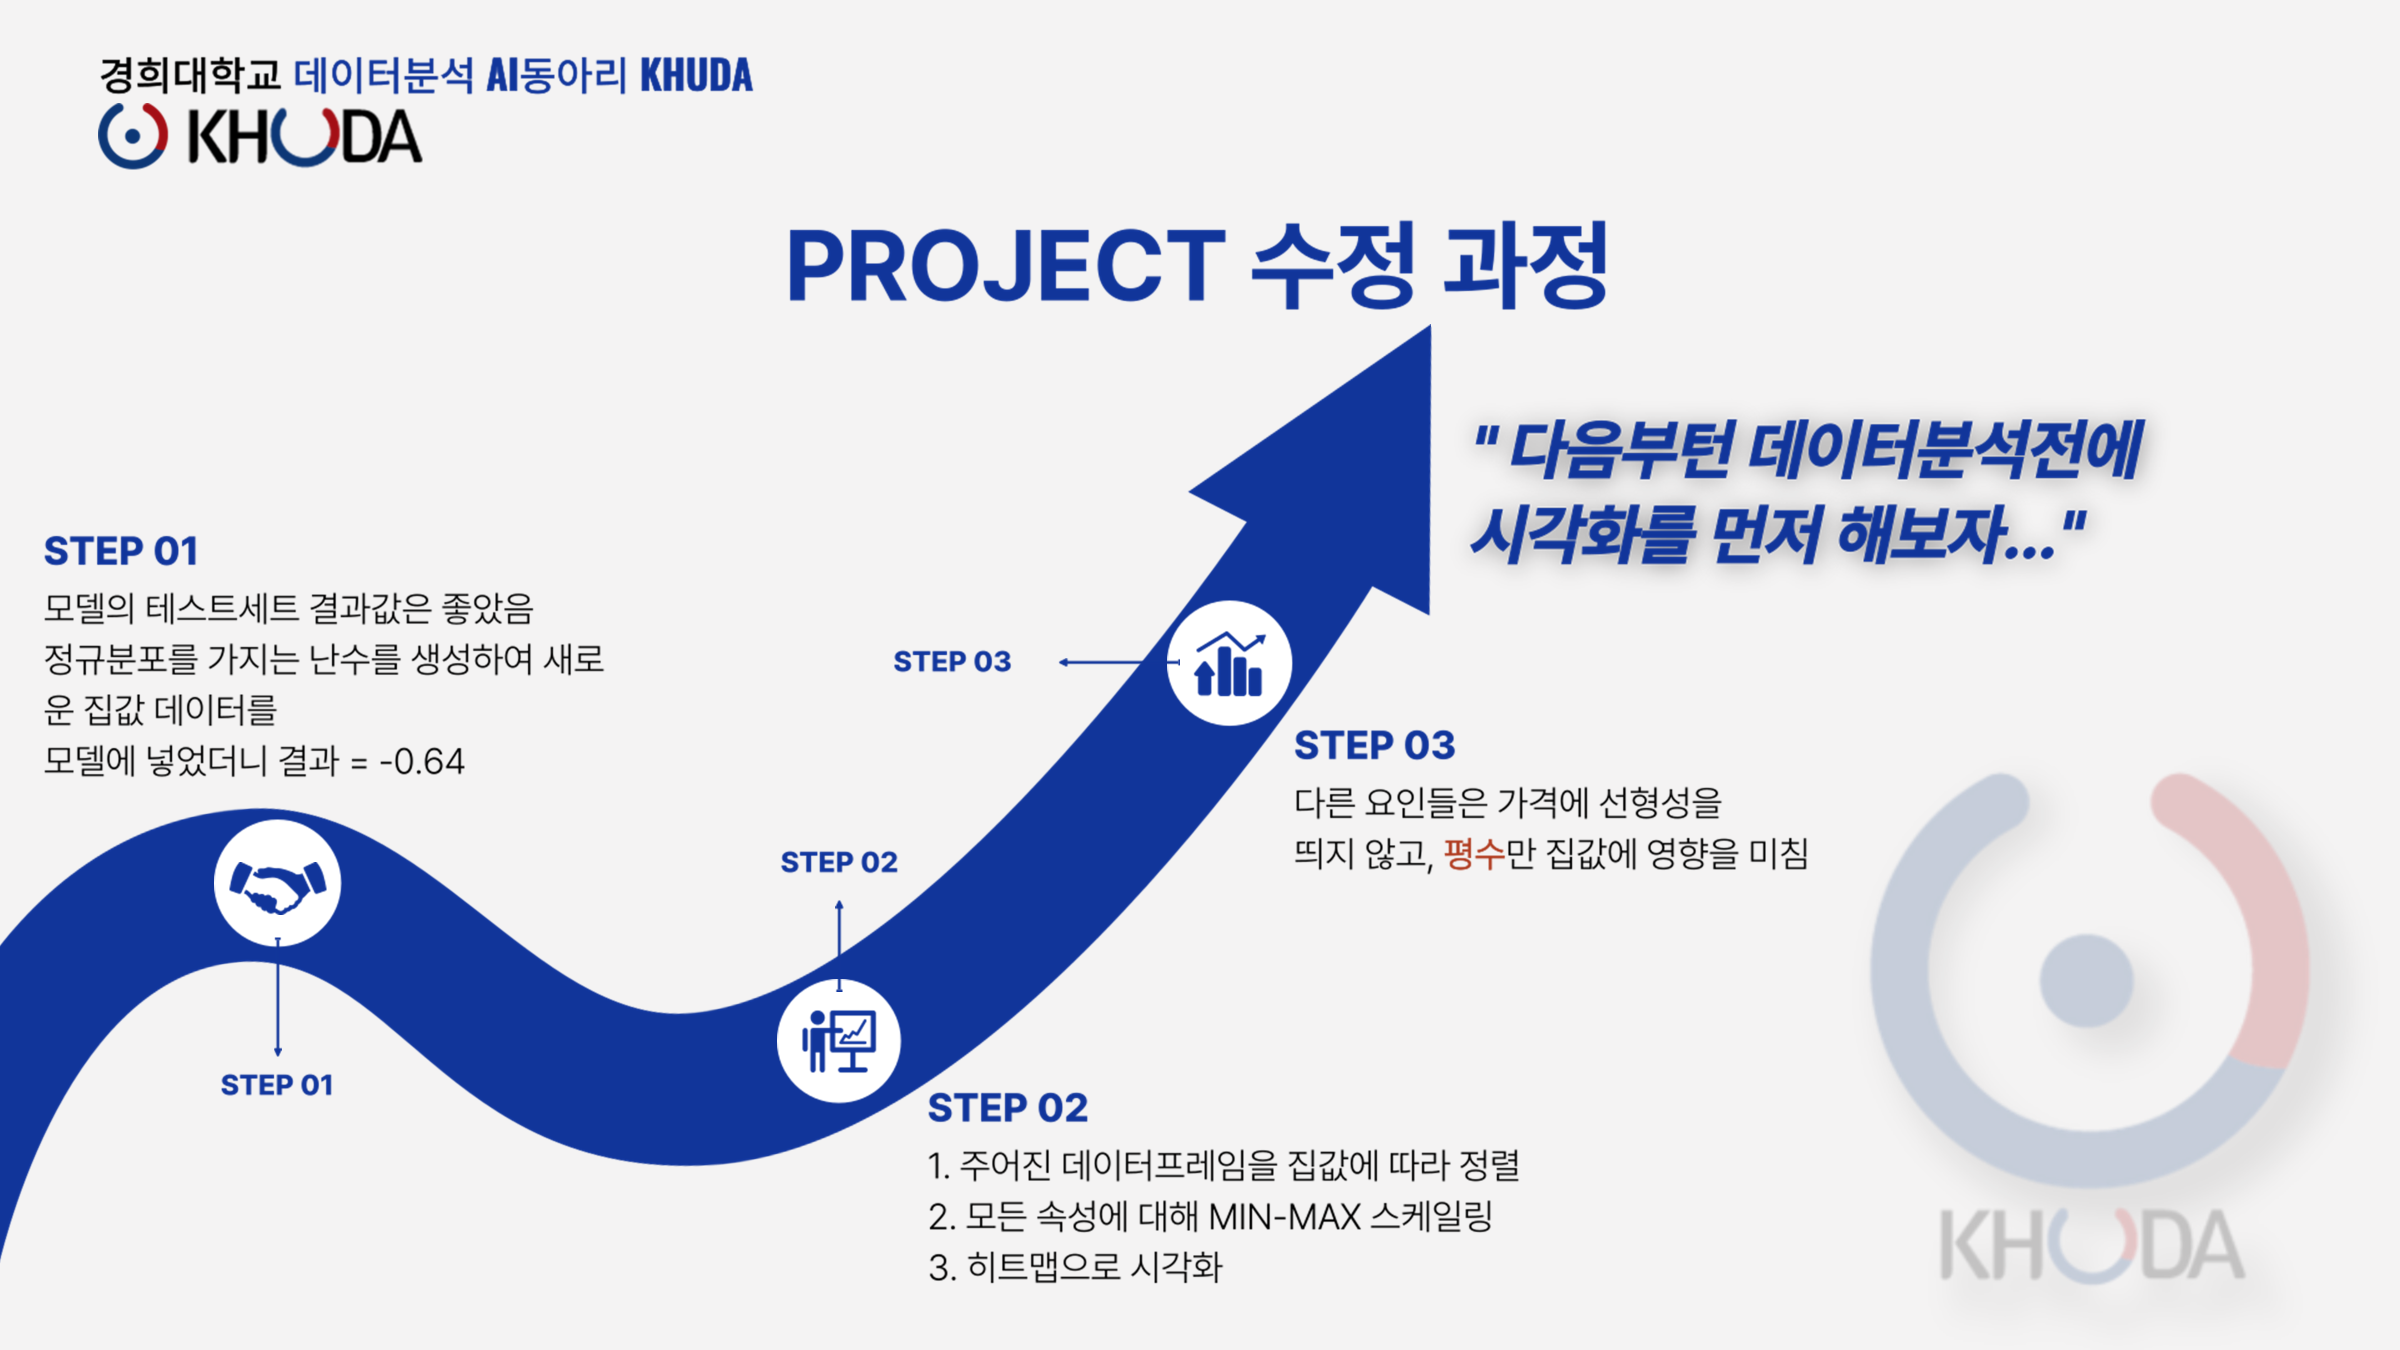
사실 처음 TOY 프로젝트를 진행할 때 데이터를 볼 때 EDA를 거의 하지 않고 Heuristic Techniques에 의존함(그냥 대충 당연히 이러겠지~하고 찍었다는 소리)
ㄴ지나가는 OB : "Plot 찍어봤어?", 이런 단순한 한 마디에 아무도 대답을 못함
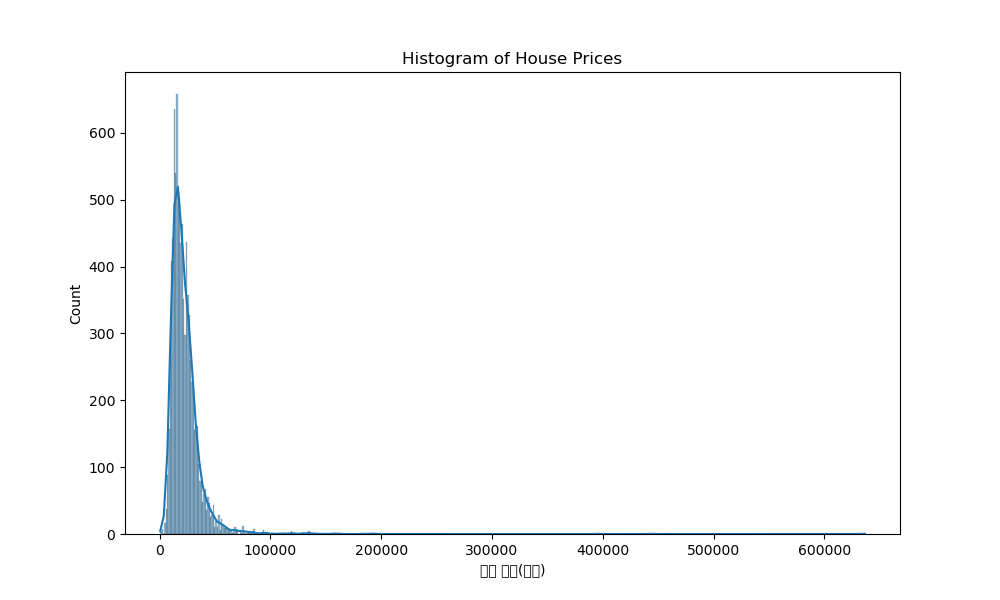
(위는 2019년 집값에 따른 가구 수를 히스토그램으로 표현한 것)
ㄴ 어느 가격대에 많이 형성되어있는지 분포를 확인할 수 있음
ㄴ But, 그래프 비율상 특정 가격대 이상에서는 특이점을 발견하기 어려움
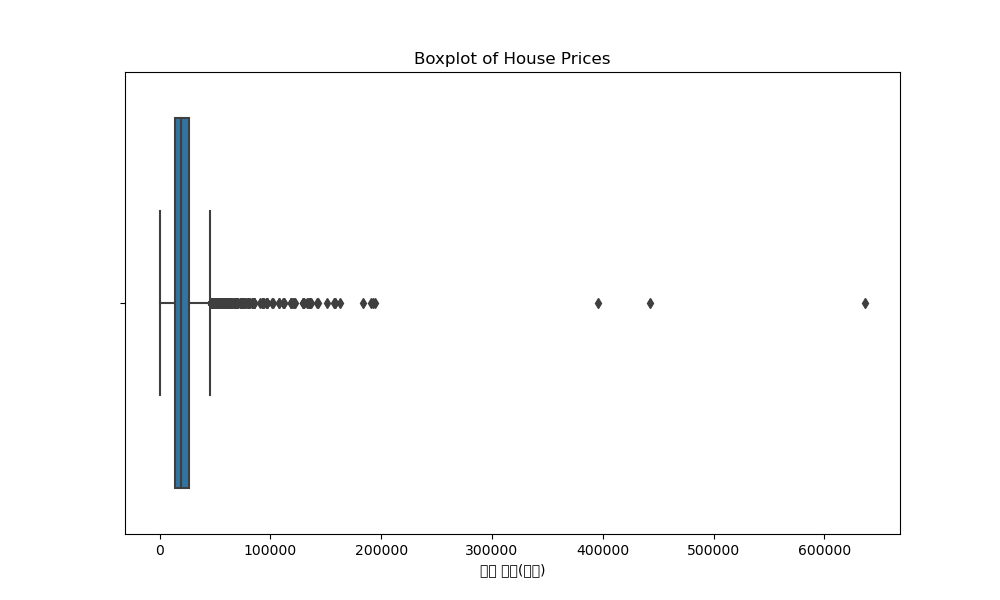
(같은 2019년 집값 데이터를 박스플롯으로 시각화한 것)
같은 데이터였지만 다른 시각화 방법으로 이상치가 존재함을 확인할 수 있음
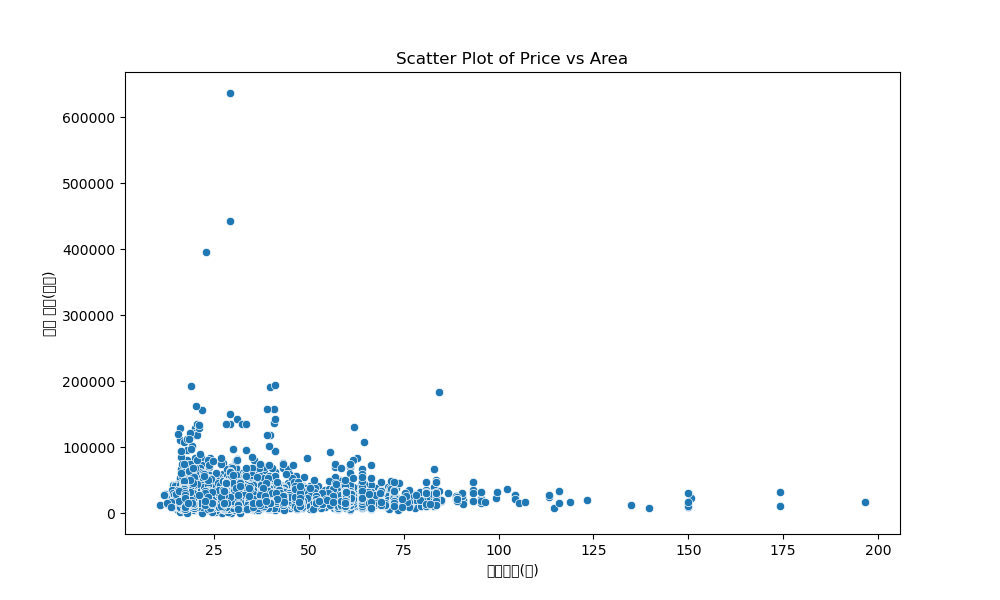
- 산점도 역시 이상치 확인 가능
- X축 : 면적, Y축 : 가격 -> 면적에 따라 가격이 증가할거라고 생각했는데? 예상과 다름
(앞에서와 달리 경희대 주변 7km 내의 오피스텔로 전처리를 진행)
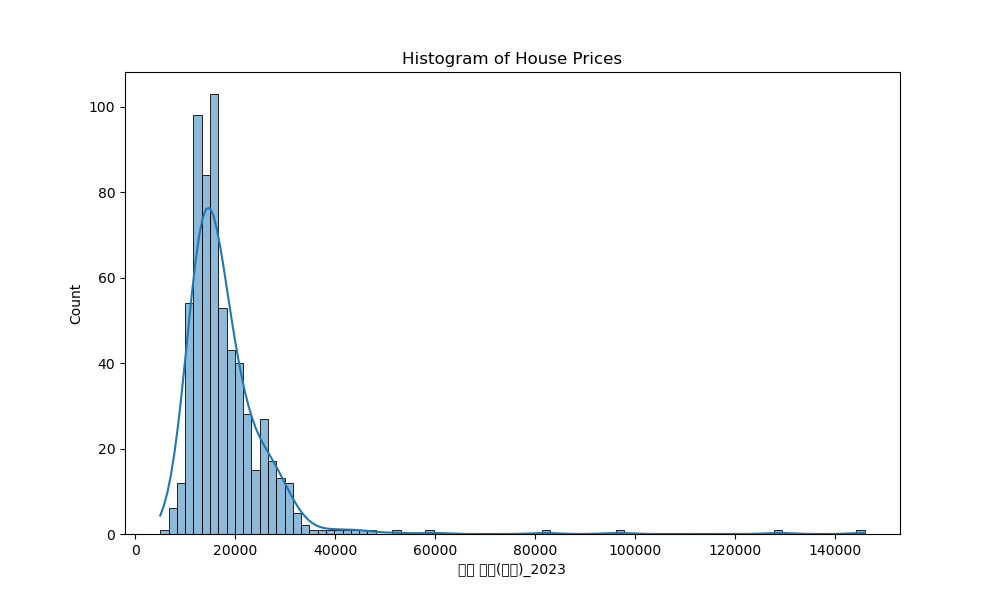
- 그래프 비율이 달라지긴 했지만 이상치보다는 많은 분포를 보이는 데이터에 집중
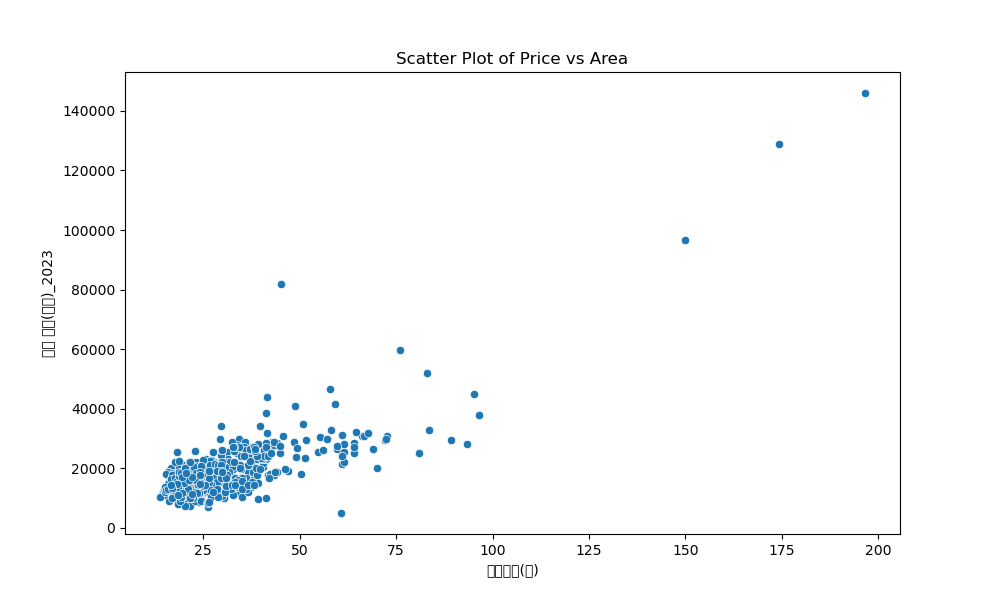
- x축 : 면적, y축 : 집값
- 면적에 따른 집 값이 상관 관계를 보임
같은 데이터에서 다른 시각화 방법을 사용할 때
같은 시각화 방법에서 다른 데이터를 사용할 때 얻는 인사이트가 서로 다름
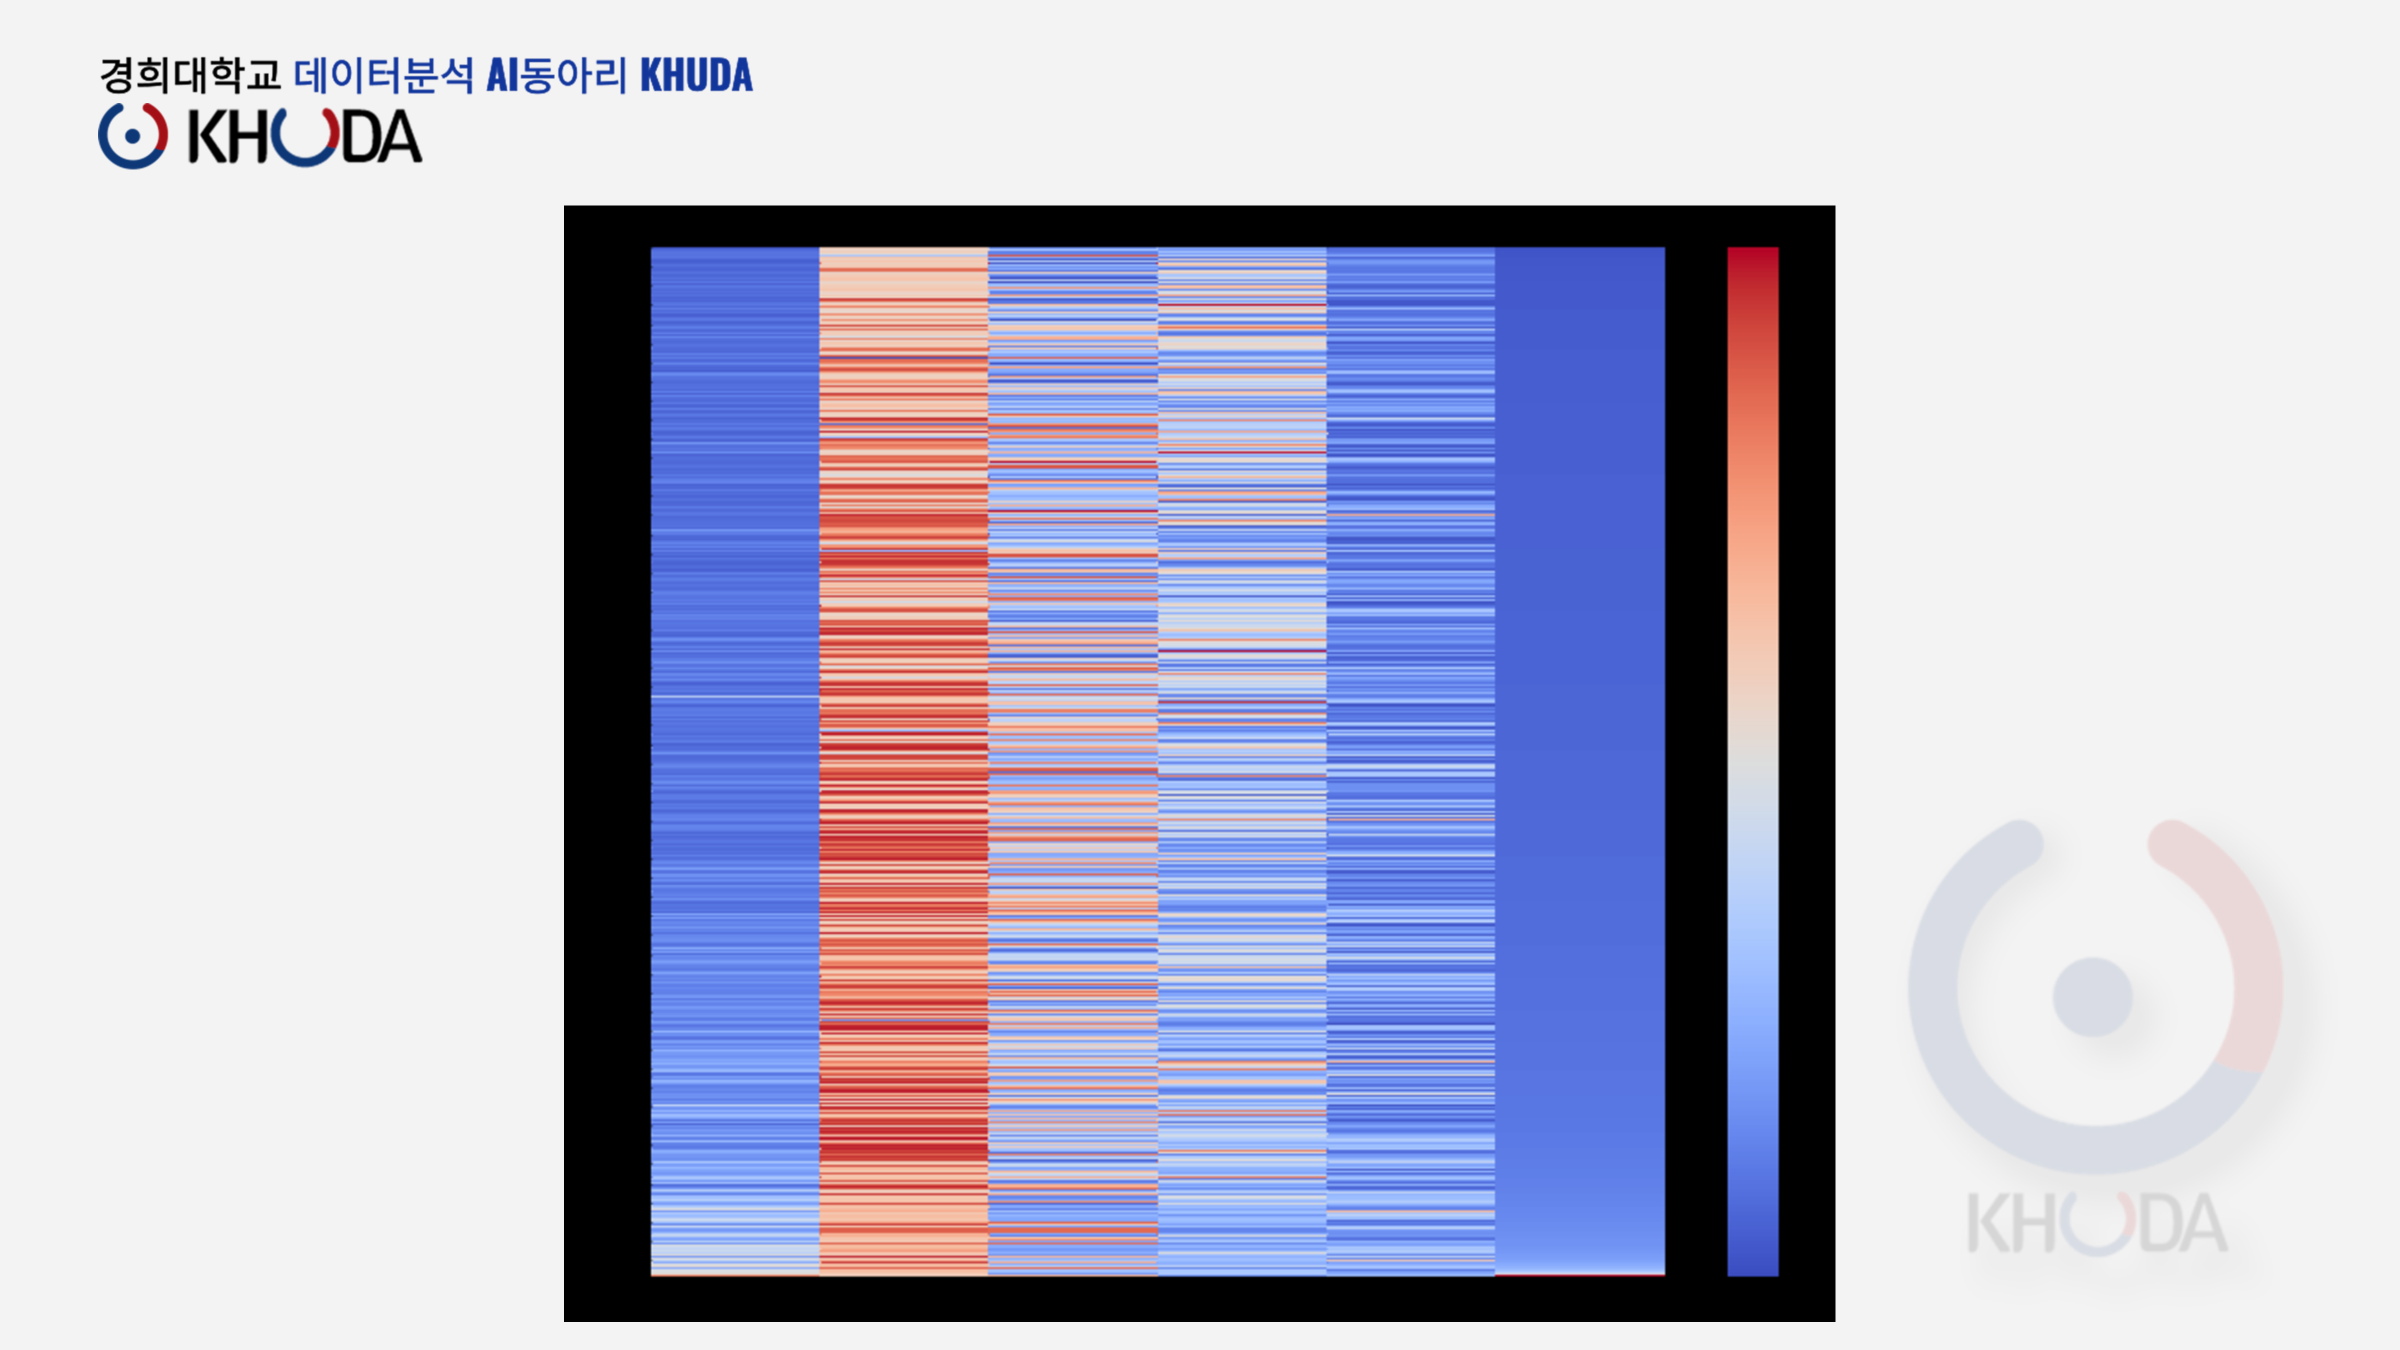
집값과 면적/층/건축년도/위치/지하철까지 거리 등의 상관성 분석 히트맵 결과로
- 빨간색이 상관성이 높음을 의미
- 면적이 집값과의 상관성이 가장 높게 보임
이를 토대로 모델링에 사용할 변수를 다시 설정함
