"사람들은 당신이 과거로부터 미래를 예측할 수 있다고 생각할 정도로 바보 같았다"
15장은 알고리즘 트레이딩 전략을 벡터화된 백테스팅 하는 기술에 초점
15.0 매매 전략
[알고리즘 트레이딩 전략] : 사람의 간섭 없이 알고리즘을 기반으로 매수, 매도 혹은 중립 포지션을 취하도록 설계된 모든 종류의 금융 매매 전략
금융 데이터를 저장하는 NumPy의 ndarray 혹은 pandas의 DataFrame 객체에 벡터화 연산을 수행하면 매매 전략에 쉽게 사용할 수 있음
(또 다른 방법은 '이벤트 기반 백테스팅'이다. 이는 새로운 데이터에 대해 반복문을 사용하여 시장에 새 데이터가 도달하는 것을 시뮬레이션한다.)
머신러닝 & 딥러닝 알고리즘을 알고리즘 트레이딩 전략에 적용
-> 목표 : 과거 데이터로 분류 알고리즘을 학습시켜서 미래의 시장 방향을 예측
-> 이를 위해서 보통은 실숫값인 금융 데이터를 소수의 범주형 값으로 변환해야 함
(실수를 다루면 모든 패턴이 유일하거나 희귀해지므로 패턴 찾기 어려움)
-> 이렇게 하면 알고리즘이 가진 패턴 인식 능력을 활용할 수 있음
목차 (Kick the neck)
- 단순 이동평균
- 랜덤워크 가설
- 선형 회귀분석
- 클러스터링
- 빈도주의 방법론
- 분류 알고리즘
- 심층 신경망
15.1 단순 이동평균
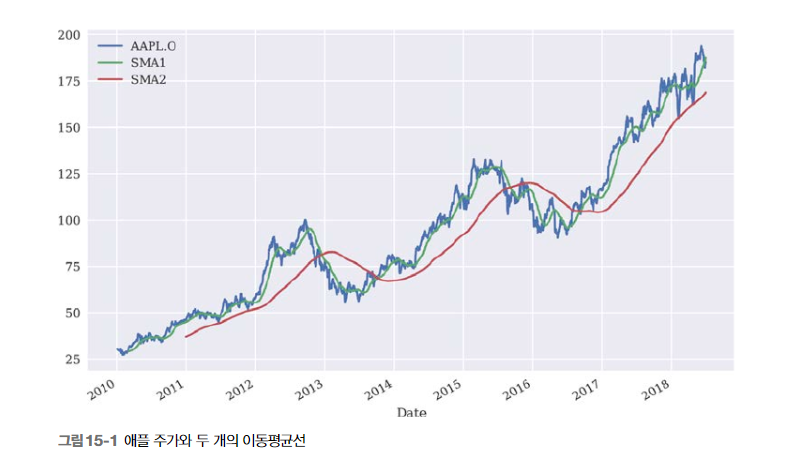
SMA1 : 단기 이동평균선
SMA2 : 장기 이동평균선
잔고 포지션을 계산한 매매 규칙
- 단기 이동평균선이 장기 이동평균선 위에 있으면 매수 포지션(=+1)
- 장기 이동평균선이 단기 이동평균선 위에 있으면 매도(중립) 포지션(=-1)
단기 이평선이 장기 이평선을 상향 돌파하면 상향 추세로 매수 시그널
단기 이평선이 장기 이평선을 하향 돌파하면 하향 추세로 매도 시그널
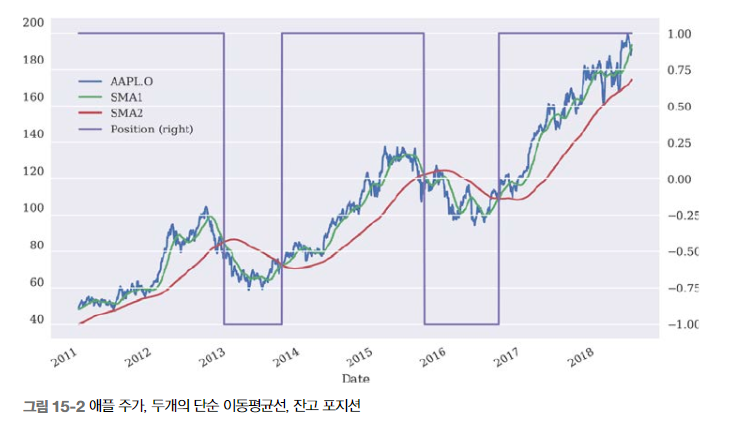
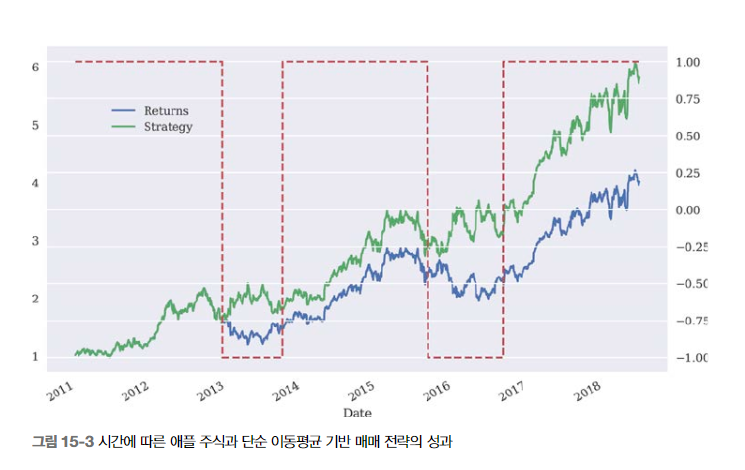
알고리즘 트레이딩 전략의 구현은 두 개의 매도 구간 때문에 단순히 전 기간 동안 매수하여 들고 있던 것보다 더 나은 성과를 보여준다.
벡터화된 백테스팅 구현
- 로그 수익률 계산
- +1 또는 -1로 나타낸 포지션을 수익률에 곱한다
(수익률이 양수인 기간은 매수 수익을 얻고 수익률이 음수인 구간은 매도 수익을 얻는다. - 애플 주가와 알고리즘 트레이딩 수익률을 모두 더한 후 지수함수를 적용하면 최종 성과 계산 가능
연율화 : 투자기간이 서로 다른 경우 비교가 불가능하기 때문에 통상 1년을 기준으로 표준화하여 표시, 즉 기간 수익률을 연 수익률로 바꾸어 주는 것. (재투자를 가정한 복리를 적용해서 계산)
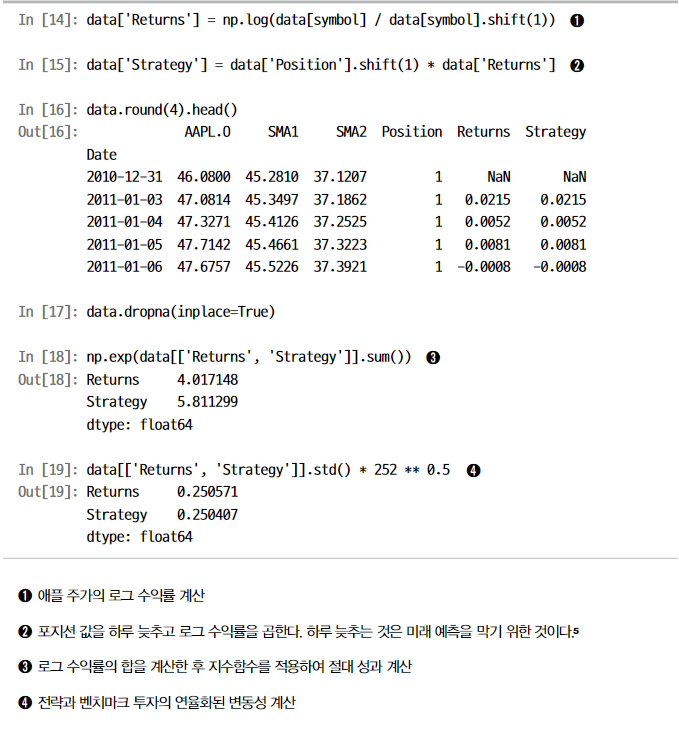
알고리즘 트레이딩 Strategy가 벤치마크 투자나 그냥 들고 있는 것보다 우수하며 위험조정 측면에서 보아도 뛰어나다는 것을 알 수 있다.
최적화
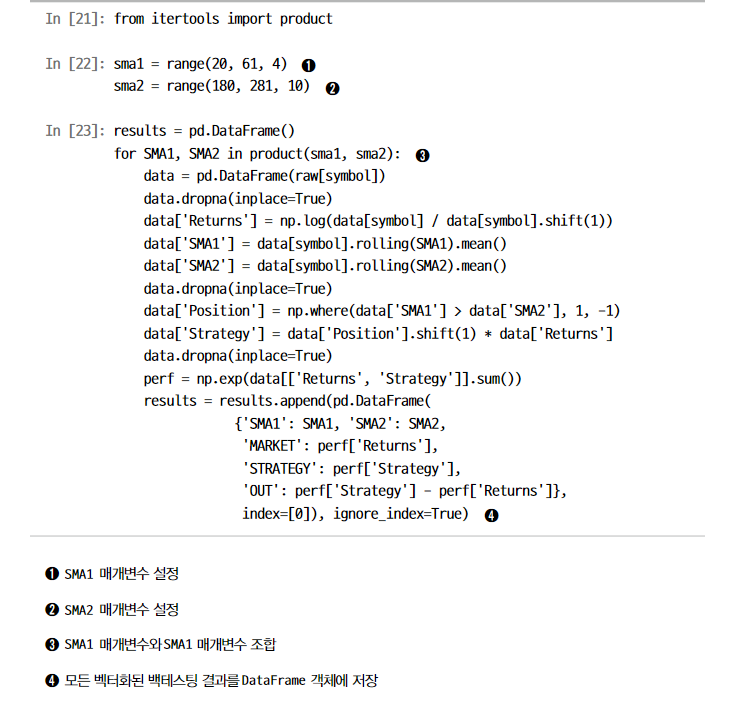
선택한 SMA1=42, SMA2=252가 옳은 값인가를 알기 위해 해당 기간의 수익률을 최대화하는 최적의 값을 찾는 여러 가지 조합을 넣어보고 가장 좋은 수익률을 찾는다.
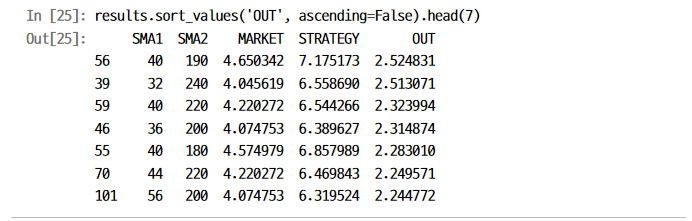
최적 매개변수는 SMA1=40, SMA2=190 이다. 하지만 이는 사용 데이터에 심하게 의존하는 값으로 과최적화, overfitting 되어 있을 가능성이 높음.
(training data로 학습 -> test data로 검증 해야함)
15.2 랜덤워크 가설(RWH)
랜덤워크 가설에 따르면 금융 시장에서 가격은 연속적인 시간에서의 랜덤워크, 즉 방향성이 없는 브라운 운동이다.
방향성이 없는 브라운 운동에서 "미래의 기대 값 = 현재의 값"
(따라서 내일의 주가에 대한 최고의 예측값 = 오늘의 가격)
효율적 시장 가설 : 시장의 현재 가격이 모든 정보를 반영하고 있다고 본다.('모든 정보'의 정의에 따라 약, 강효율적 시장 가설로 나뉨)
랜덤워크 가설은 효율적 시장 가설(EMH)과도 일치함.
수학적, 프로그래밍 목적에서 효율성의 정의 : '만약 어떤 정보 집합 S에 기반하여 매매할 때 수익을 얻을 수 없다면 시장은 이 정보 집합 S에 대해서 효율적이다.'
- 랜덤워크 가설 증명 방법
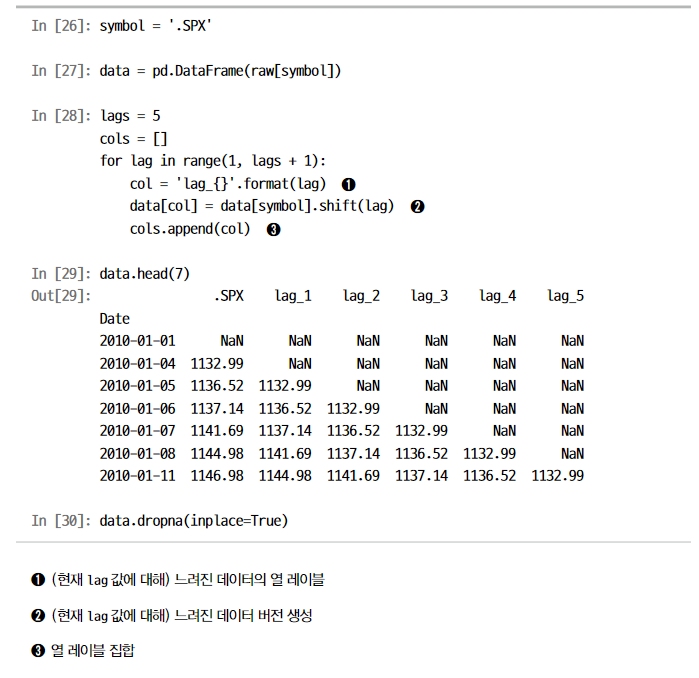
1) 주가의 과거 시계열 데이터를 사용하여 며칠, e.g.5일 느려진(lagged) 시계열을 만듦
2) 이 느려진 시계열 주가를 기반으로 회귀분석을 사용하여 실제 주가를 예측할 수 있는지 검사
(어제의 주가로 4일 뒤의 주가를 예측할 수 있는지 알아보는 것)
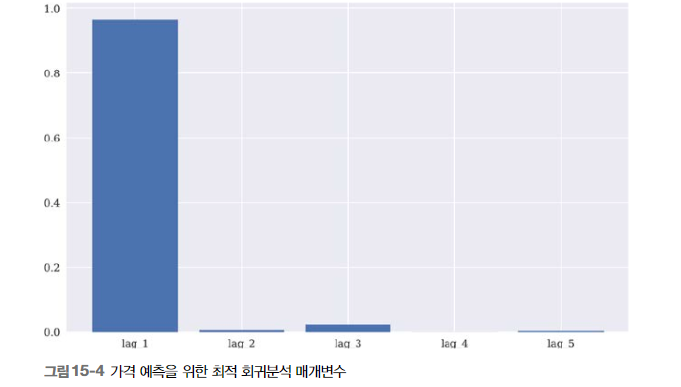
lag_1의 값이 1에 가깝고 나머지는 0에 가까움
-> 예측 역할을 하는 것은 lag_1뿐으로 가장 중요한 매개변수임
-> 시각적으로 말하면 예측선은 원래 데이터를 하루 늦춘 것임
-> 과거의 가격 움직임이 미래의 움직임을 예측하는 데 도움이 되지 않음
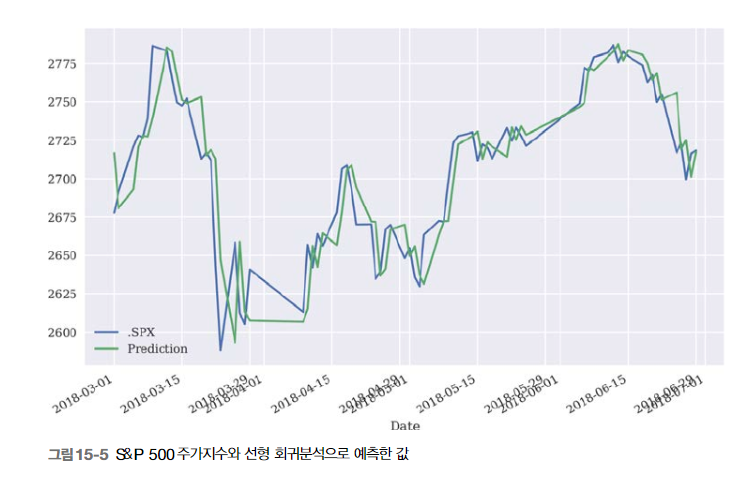
랜덤워크 가설과 효율적 시장 가설은 방대한 실증적 지지를 받고 있는 금융 이론으로 여러 상품이나 다양한 지연값을 사용하는 경우로 쉽게 확장 가능
"우리의 알고리즘 트레이딩 전략"은 랜덤워크 가설이 일반적으로 적용되지 않는다는 것을 증명하여 스스로의 가치를 보여야 함.
15.3 선형 회귀분석
과거의 로그 수익률을 기반으로 시장의 방향성을 예측하는 데 선형 회귀분석을 적용
아래의 특징값을 사용하며
- 시계열상의 하루 전 로그 수익률
- 이틀 전 로그 수익률
가격과 달리 정상 상태인 로그 수익률을 알고리즘에 사용하며 지연 수익률을 사용하는 것은 과거의 수익률로 미래 수익률을 예측할 수 있다는 기본 아이디어임.
e.g. 회귀분석 기술을 응용해 평균회귀 패턴, 모멘텀/추세 패턴 추론을 정량화
선형 회귀분석을 적용하여 데이터 간의 잠재적 선형 관계를 학습하고 특징값에 기반하여 시장 움직임을 예측
-> 로그 수익률 or 로그 수익률의 방향을 종속변수로 사용
-> 예측 결과인 방향을+1, -1 이라는 숫자로 바꾸어 예측 결과의 형식은 달라지지 않음
방향을 예측하는 벡터화된 백테스팅을 적용하여 매매 전략의 성과 판단
가정 1. 거래 비용이 들지 않음
가정 2. 학습 및 검증에 같은 데이터를 사용
-> 패시브 벤치마크 투자의 성과보다 높음
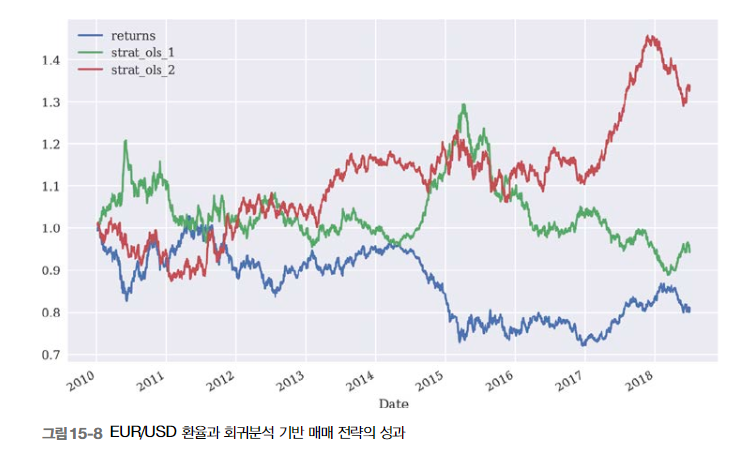
15.4 클러스터링
기본 아이디어는 알고리즘이 '시장의 움직임을 예측할 수 있는 특징값'의 클러스터를 식별하는 것
클러스터 분석: 각 클러스터의 특징을 분석하여 해당 클러스터가 시장에서 어떤 패턴을 보이는지 이해. 예를 들어, 일부 클러스터는 주가가 상승하는 추세를 나타내고, 다른 클러스터는 주가가 하락하는 추세를 나타낼 수 있음.
매매 전략 수립: 각 클러스터에 따라 다른 매매 전략을 수립. 주가가 상승하는 클러스터에는 매수 포지션을 취하고, 주가가 하락하는 클러스터에는 매도 포지션을 취할 수 있습니다.
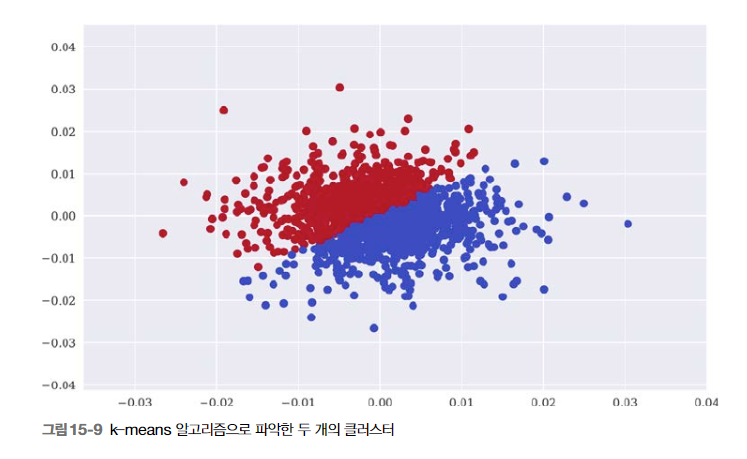
패시브 벤치마크 투자보다 성과가 좋지만 비지도 학습 방법으로 알고리즘의 목표가 명시되지 않고 히트 비율(올바른 예측 수 / 전체 예측 수) 값이 50%가 되지 않음
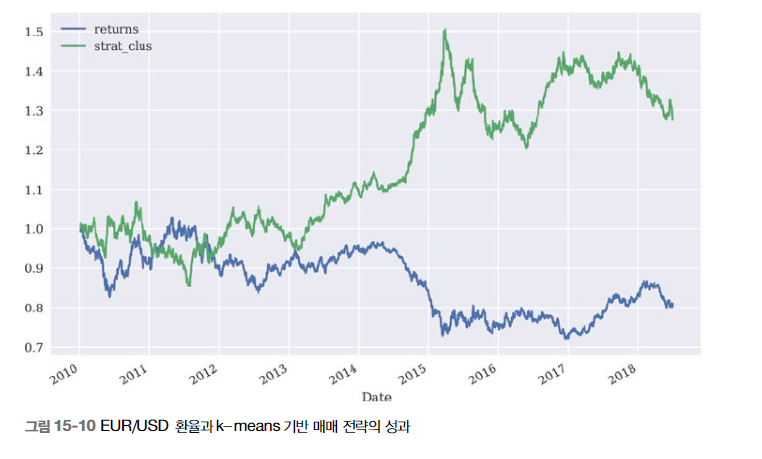
15.5 빈도주의 방법론
단순히 빈도만 사용하여 금융 시장의 방향을 예측
과거 시장의 방향을 두 개의 이진수 조합으로 표현
((0, 0), (0, 1), (1, 0), (1, 1))
15.6 분류 알고리즘
분류 알고리즘을 금융 시장에서의 가격 방향 예측 문제에 적용
(15.6.1) 두 개의 이진수 특징
이진수 특징값에 기반하여 모델을 학습시키고 결과로 나온 포지션 정보를 받는다
-
이진수 형태의 특징값을 사용한다면 각 데이터 포인트는 이진수로 표현된 여러 특징이 있다. (주식 시장에서는 주가, 거래량, 기술적 지표 등을 이진수 형태)
-
라벨링 : 각 데이터 포인트에 대해 해당 포지션 정보를 라벨로 지정. 이진 분류 문제에서는 주식을 보유할지(매수) 또는 보유하지 않을지(매도)를 나타내는 이진 라벨을 사용.
(15.6.2) 다섯 개의 이진수 특징
이진수 특징값을 두 개가 아닌 다섯 개 사용
서포트 벡터 기반 전략 성능은 향상되었지만 로지스틱 회귀와 가우스 나이브 베이즈 기반 전략 성능은 나빠짐.
(SVM은 다양한 특징값을 고려하여 결정 경계를 찾는데 뛰어난 성능을 보일 수 있음. 그러나 로지스틱 회귀나 가우스 나이브 베이즈는 특징값 간의 선형성을 가정하거나 각 특징값이 서로 독립적이라고 가정하기 때문에 다섯 개의 특징값을 잘 다루지 못할 수 있음)
(이외에도 과적합, 특징값 간 상관 관계: 로지스틱 회귀나 가우스 나이브 베이즈 같은 모델은 이를 고려하지 않고 각각의 특징값을 독립적으로 처리)
(15.6.4) 연속적 학습 - 검증 분리
시뮬레이션 시에도 특정 시점까지의 데이터만 사용하여 머신러닝 알고리즘을 학습하는 것.
실제 매매에서 알고리즘은 새로운 데이터를 활용하여 가치를 증명할 수 있어야함.
- 학습용 데이터를 사용하여 알고리즘 학습
- 검증용 데이터를 사용하여 알고리즘 검사
(15.6.5) 무작위 학습 - 검증 분리
특징값 패턴이 미래의 시장 움직임을 예측할 때 맞추는 비율을 50% 이상으로 만들기 위한 것
시간이 지나도 과거의 패턴이 유지된다는 가정 때문에 학습에 사용하는 데이터와 검증에 사용하는 데이터 간에 큰 차이가 있으면 안됨.
15.7 심층 신경망
사람의 뇌를 흉내내어 하나의 입력층, 하나의 출력층, 여러개의 은닉층으로 이루어짐. 복수의 은닉층이 있어야 심층 신경망이라 함.
심층 신경망의 과최적화를 막기 위해 무작위 학습-검증 분리를 적용
