안녕하세요. 오늘은 모아아이의 프로토타입인 패키지아이를 소개하려고 합니다. 프로젝트는 택배물류현장 CCTV 영상으로 컨베이어를 지나는 택배를 카운팅하는 시스템입니다. 데이터셋 수집부터 모델학습 결과까지 개발과정을 순서대로 말씀드리겠습니다.
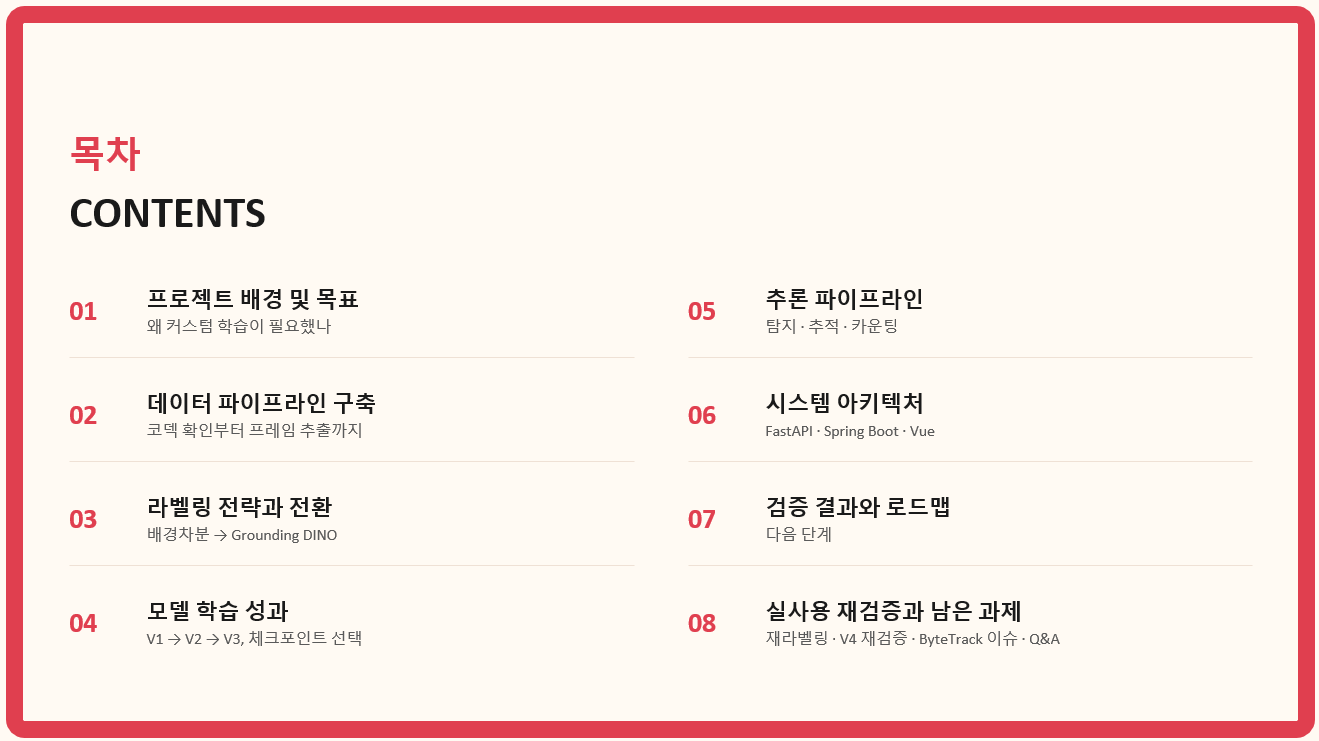
목차입니다. 각 진행마다 어떤 선택을 했는지를 중점적으로 말씀드리겠습니다.
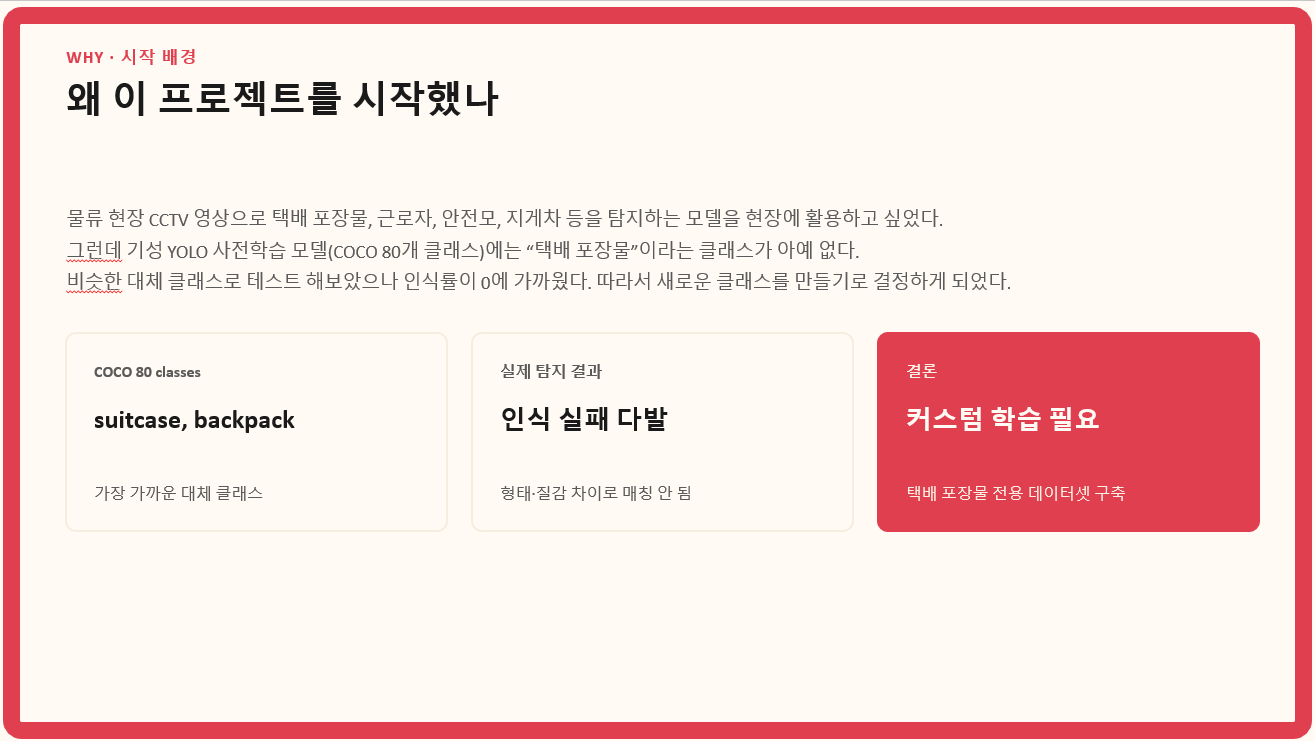
딥러닝 모델을 활용하여 택배, 근로자, 안전장비 같은 걸 탐지하여 활용하고 싶었는데, 기성모델에는 택배와 같은 클래스가 없었습니다. 백팩같은 비슷한 클래스로 테스트 해보았으나 인식율이 0에 가까웠습니다.
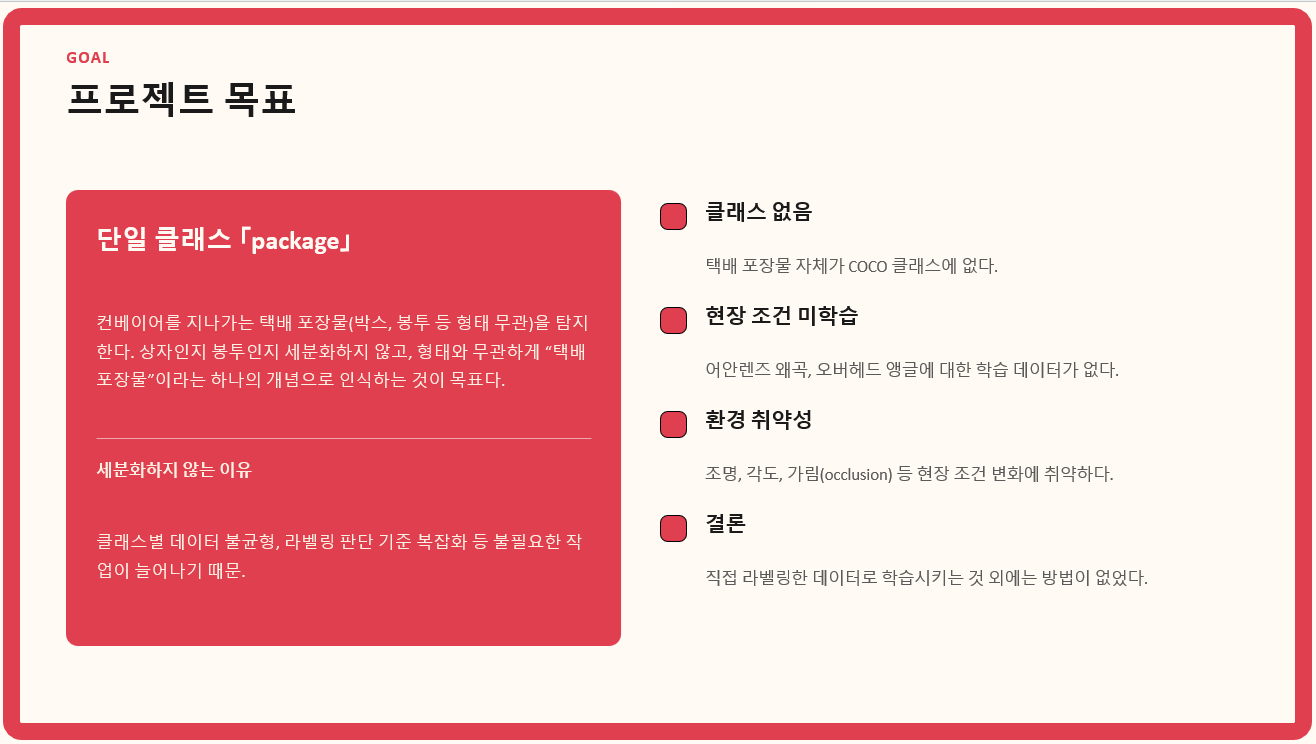
단일클래스 패키지로, 종이 택배상자든 비닐포장이든 형태와 무관하게 '택배'라는 하나의 개념으로 인식하는 것을 목표로 삼았습니다. 세분화하지 않은 이유는 클래스별 데이터 불균형이나 판단기준이 복잡해져 오히려 정확도가 저하되기 때문입니다.
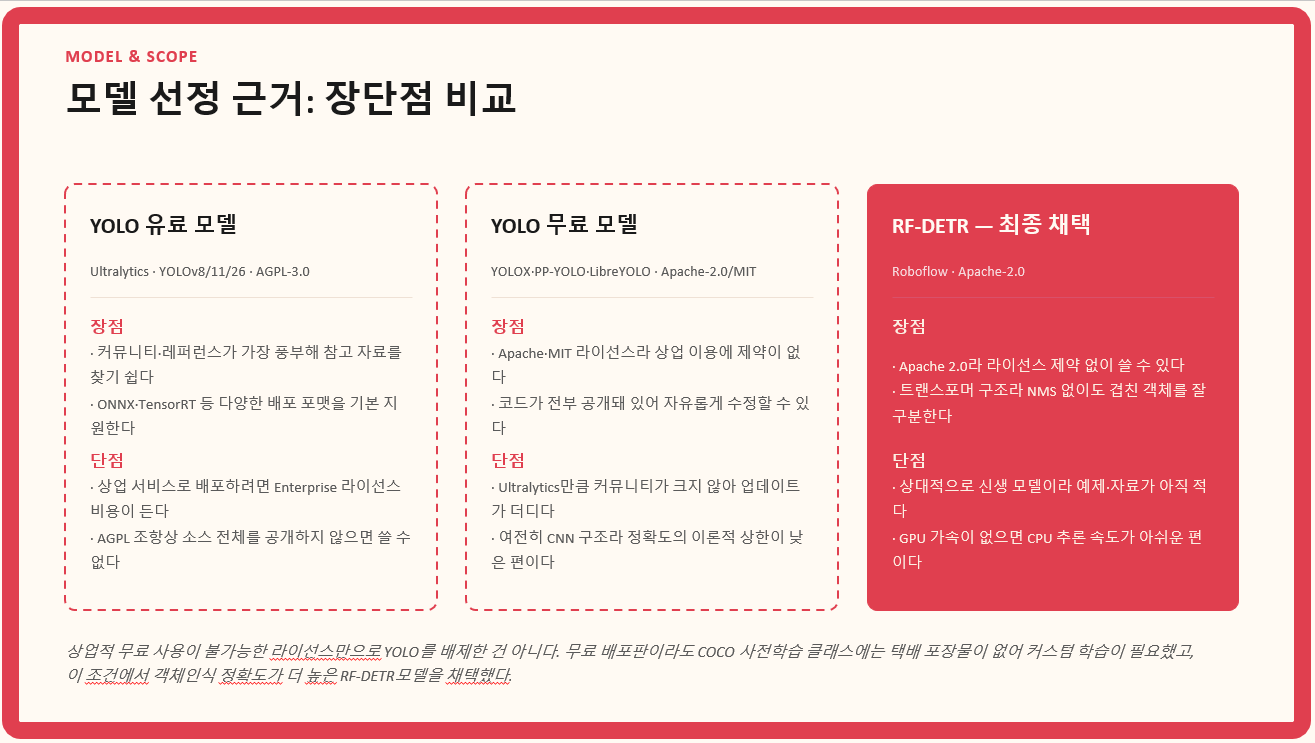
RF-DETR을 최종 채택했습니다. 상업적으로 무료 사용 가능한 라이센스면서 CNN 구조가 아닌 트랜스포머 기반 최신 모델 트렌드를 따르고, 결과도 더 좋아서 선택했습니다.
CNN 방식은 이미지를 작은 구역으로 나눠 슬라이딩 창으로 훑으며 "여기도 택배 같고, 저기도 택배 같다"는 식으로 여러 후보를 만들고, NMS로 신뢰도가 가장 높은 후보만 남기는 규칙 기반 후처리 방식입니다.
트랜스포머 방식은 이미지 전체를 패치로 나눠서 하나의 패치가 다른 모든 패치와의 관계를 계산하는 방식이라, 물체가 여러 개 가까이 있거나 겹치는 복잡한 장면에서 더 잘 구별합니다.
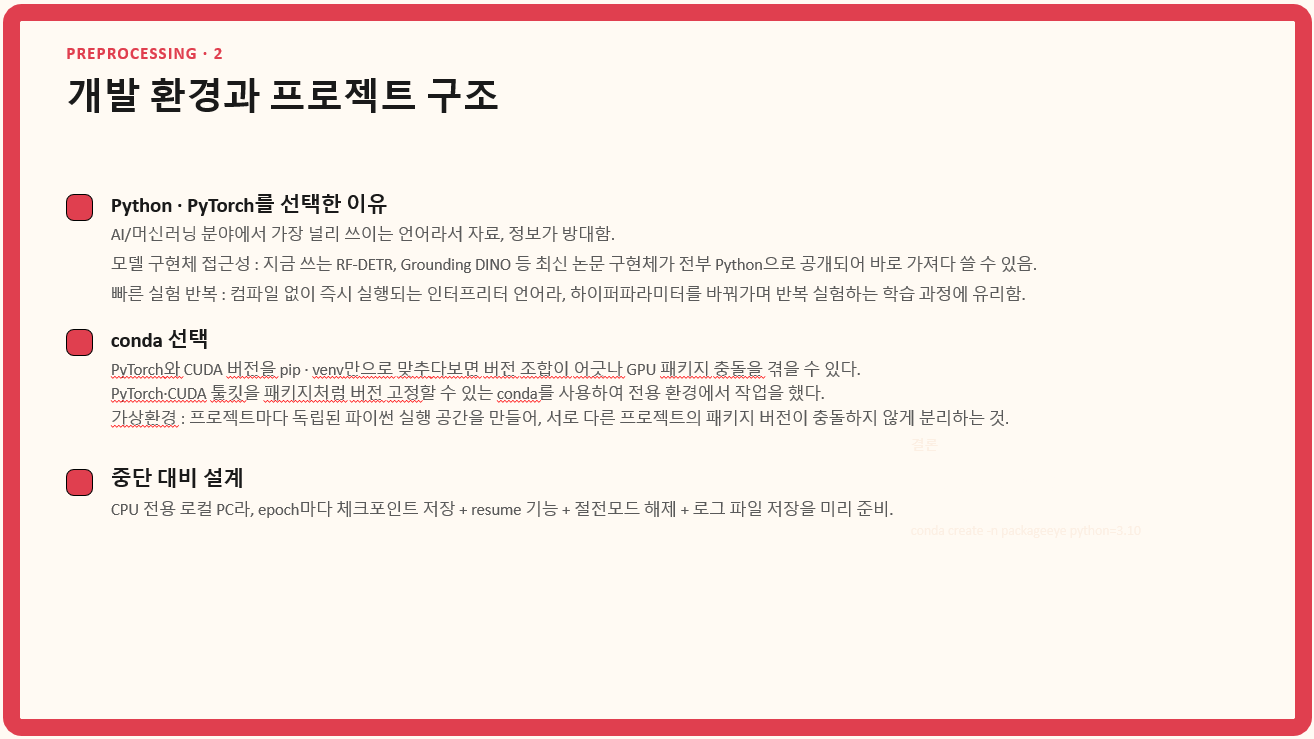
RF-DETR이나 DINO 같은 논문 구현체가 파이썬으로 공개되어 있어 접근성이 좋아 사용했습니다. 콘다로 환경을 세팅하여 파이토치와 CUDA 버전을 맞췄고, CPU 텐서로만 쓰니 긴급 대비를 위해 체크포인트를 사용했습니다.
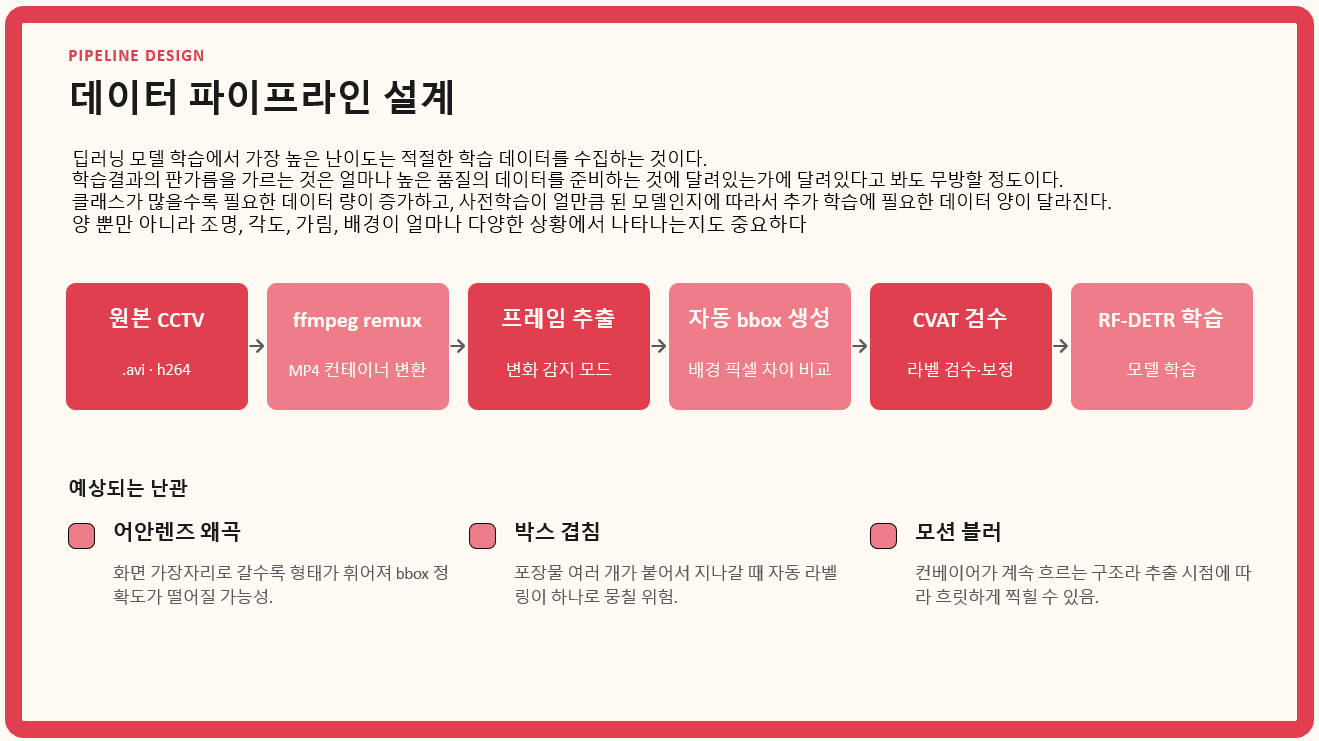
데이터 파이프라인 전체 구조입니다. 원본 CCTV를 mp4로 변환하고 모션감지로 의미있는 프레임만 추출한 뒤, 배경차분으로 1차 라벨링 하고 CVAT툴로 검수, 수정작업을 하였습니다.
딥러닝 모델 학습에서 가장 난이도가 높은 작업이 학습 데이터를 준비하는 것이고, 학습결과에 영향을 주는만큼 꼼꼼히 준비했습니다.
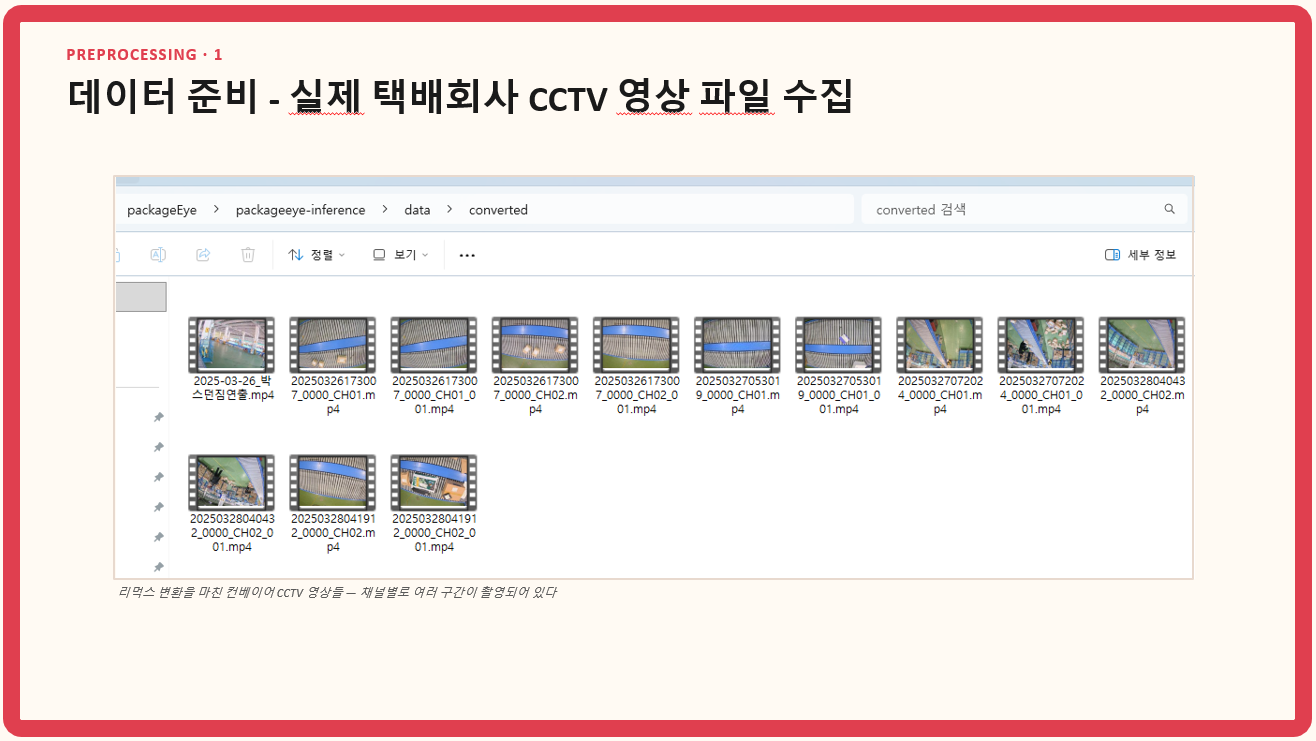
학습에 사용된 데이터는 실제 현장에서 촬영된 CCTV 영상을 대표님께 전달받았습니다.
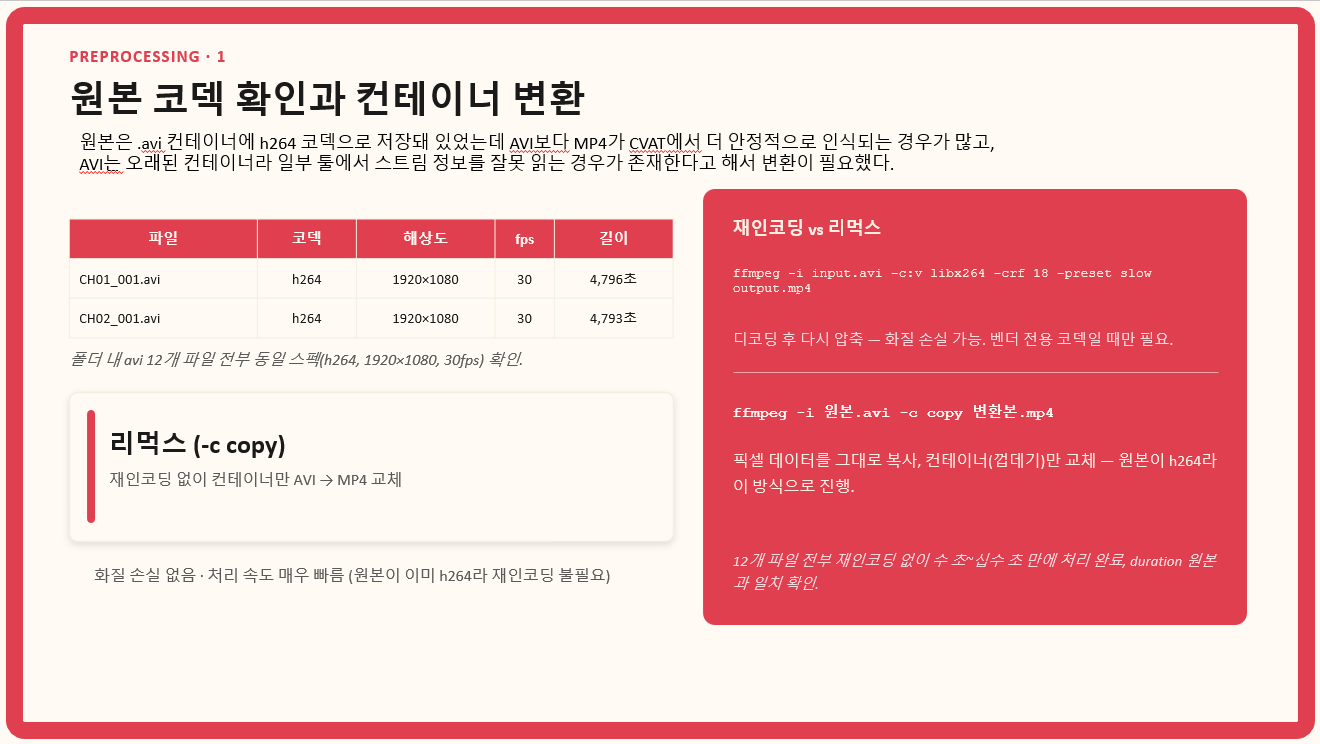
CCTV 원본 코덱은 h264, avi 컨테이너였는데, mp4가 더 안정적이라 화질 손실 없이 리먹스로 변환했습니다.
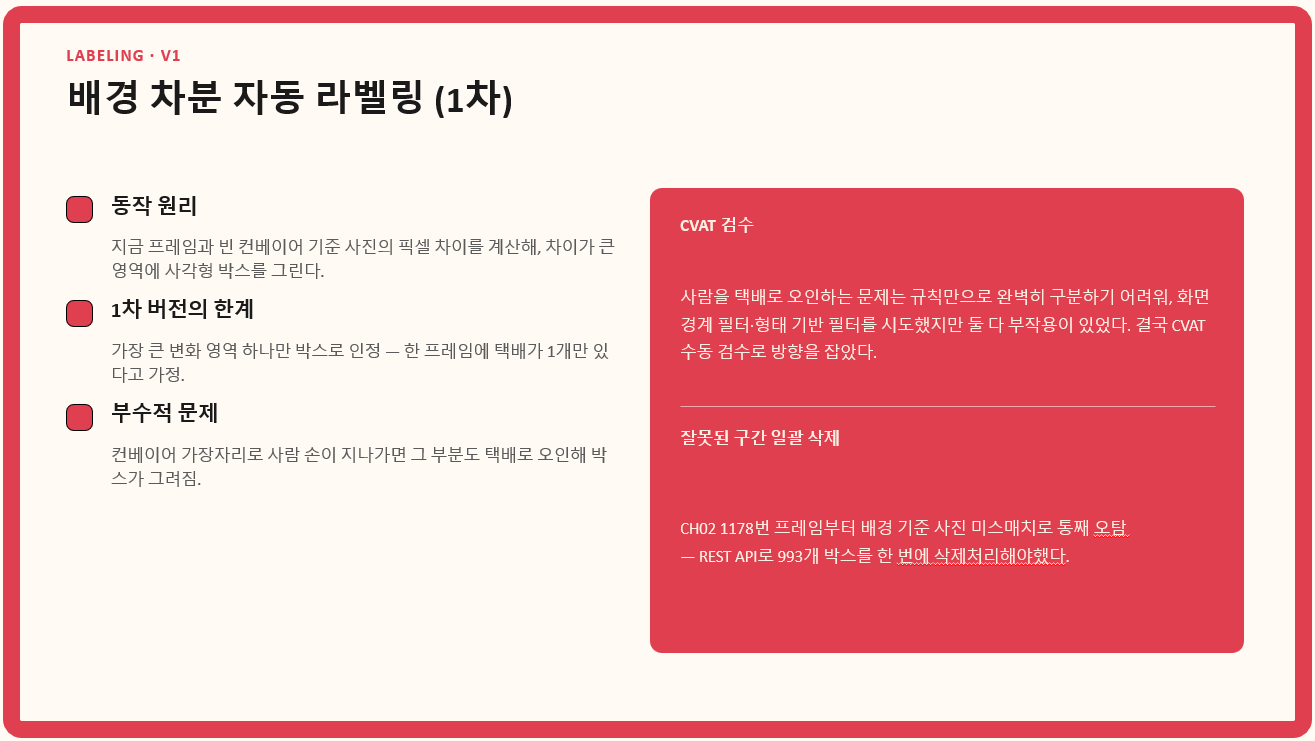
첫 라벨링은 배경차분 방식으로 했습니다. 택배도 사람도 없는 빈 컨베이어일때의 프레임을 기준 이미지로 삼아 픽셀 차이로 박스를 그리는 원리였습니다.
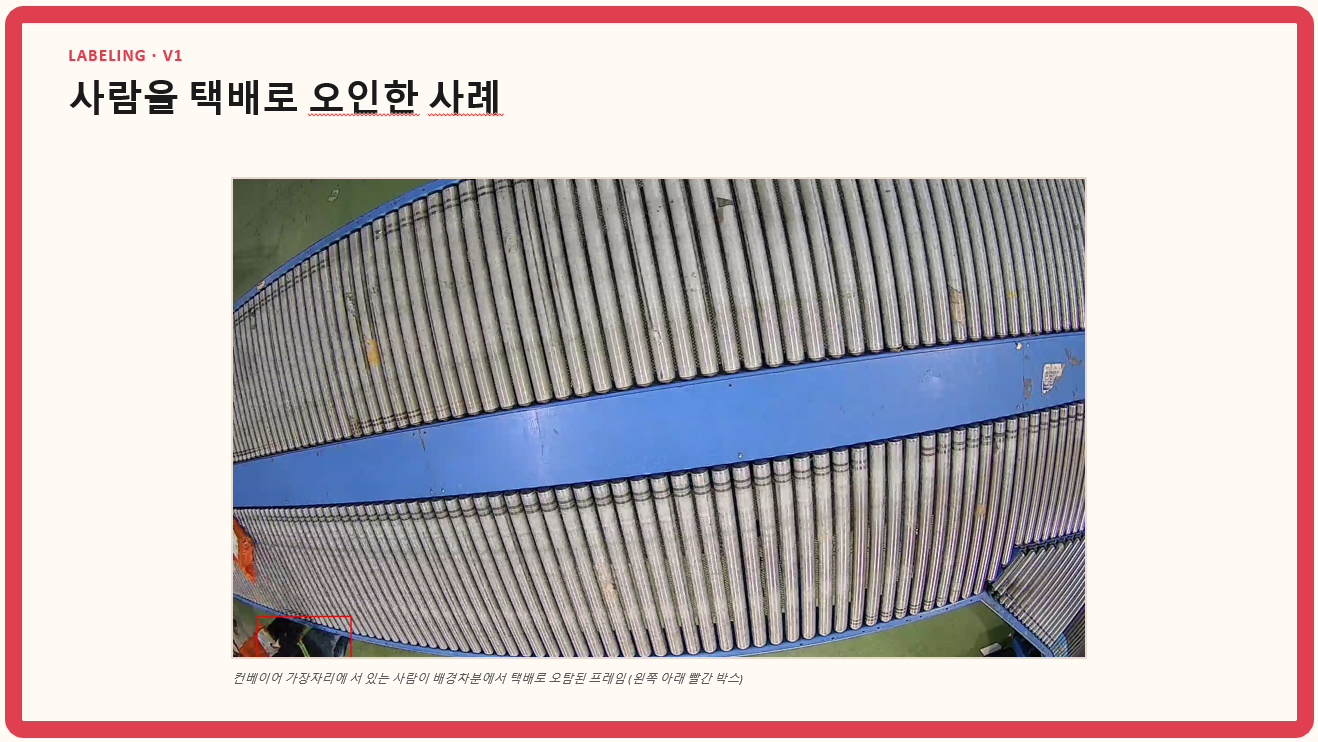
실제 배경차분 방식으로 라벨링 한 화면입니다. 사람도 택배로 오인식하는 경우가 있어 CVAT으로 수동 삭제 작업이 필요했습니다.
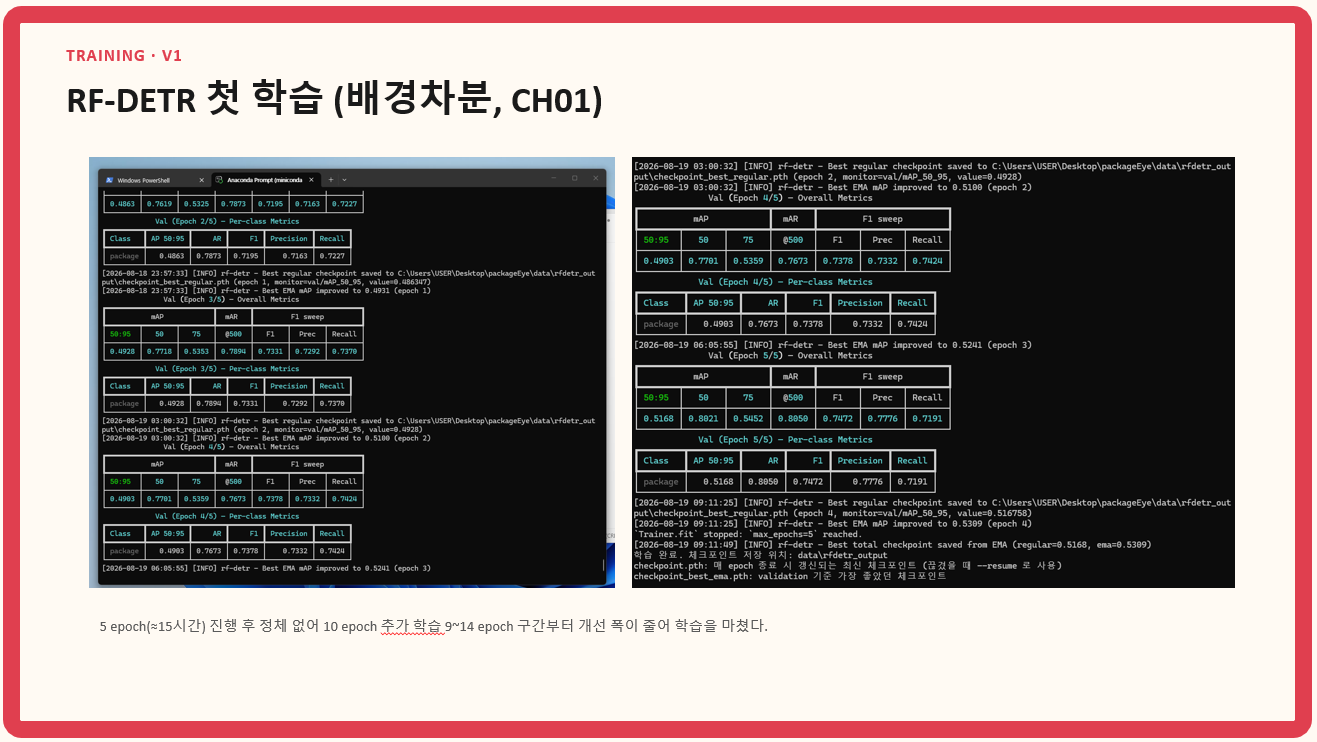
학습중인 모습입니다.
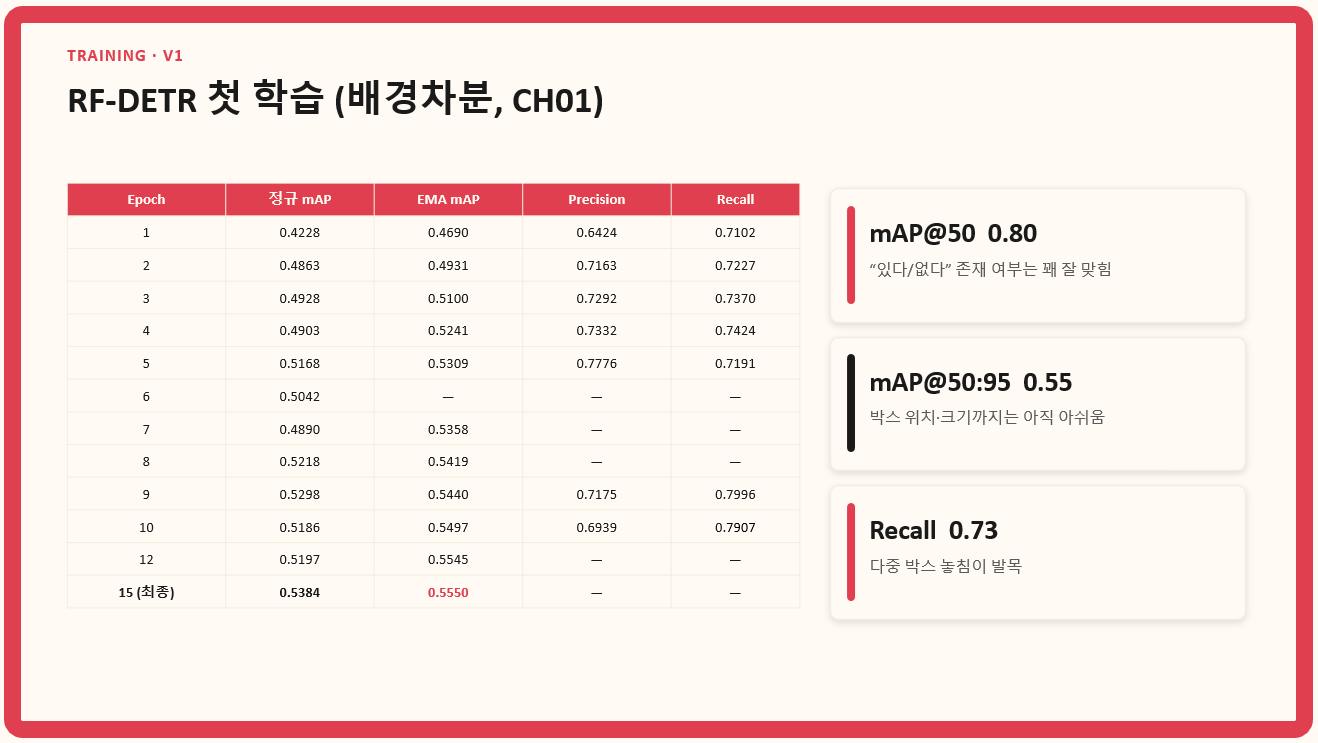
검수를 마친 후 첫 학습 결과입니다. 다양한 기준에서의 정밀도와 재현율을 평균화한 값인 mAP 50:95의 값이 0.55, 택배 유무 판단은 잘 맞췄지만 리콜이 0.73으로 여러 박스 중 1개만 탐지하고 나머지는 놓치는 게 문제였습니다.
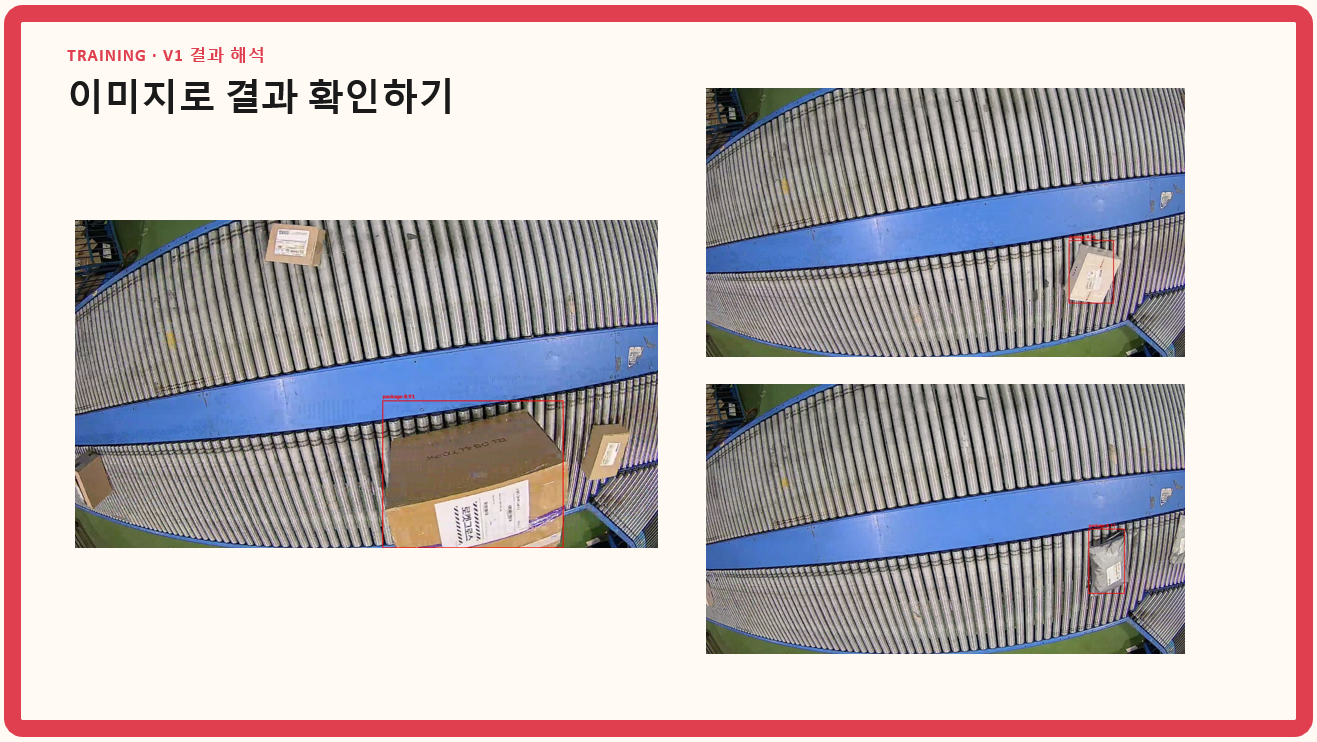
결과 이미지입니다.
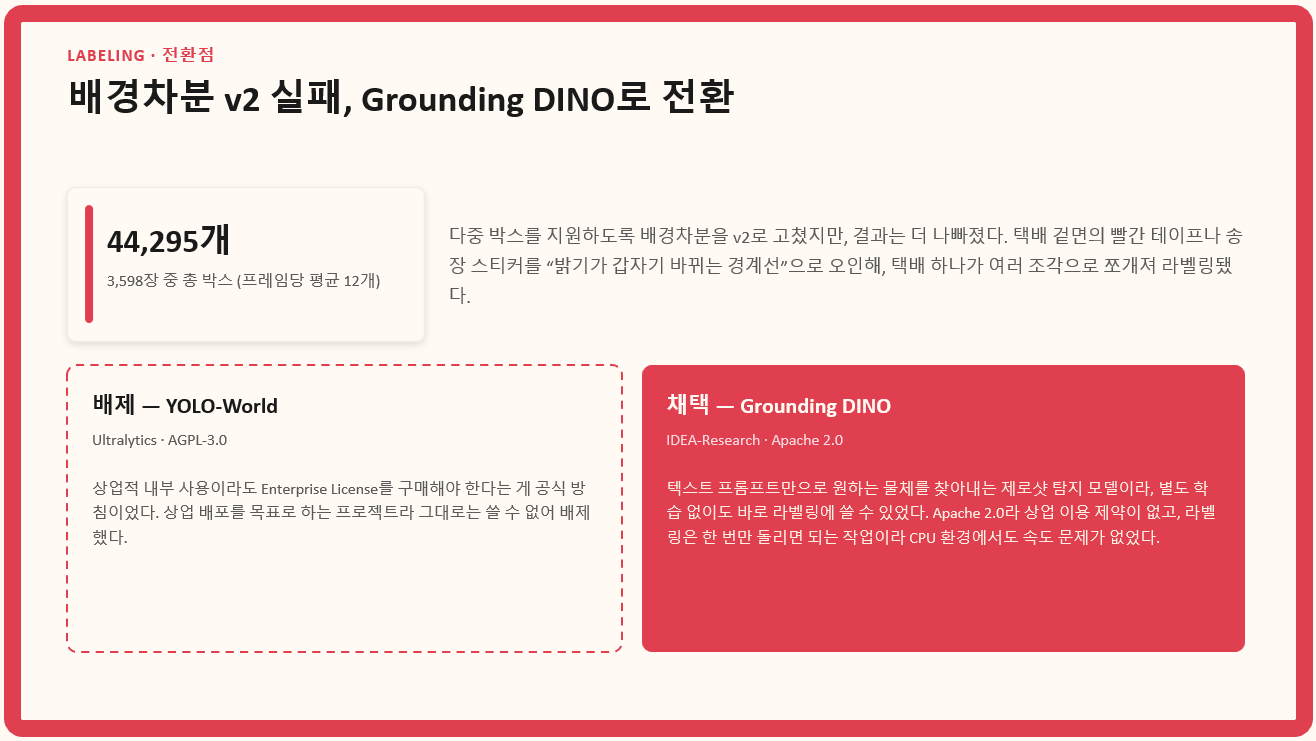
확인해보니 단독 택배는 정확히 잡는데 여러 개 있을 때 놓치는 게 문제로 파악되어 커널 사이즈를 조정해 해결하려 했지만, 노이즈나 테이프·이음선이 경계로 인식되어 박스가 잘게 나뉘는 현상이 생겼고, 이를 이어붙이는 시도도 실패했습니다.
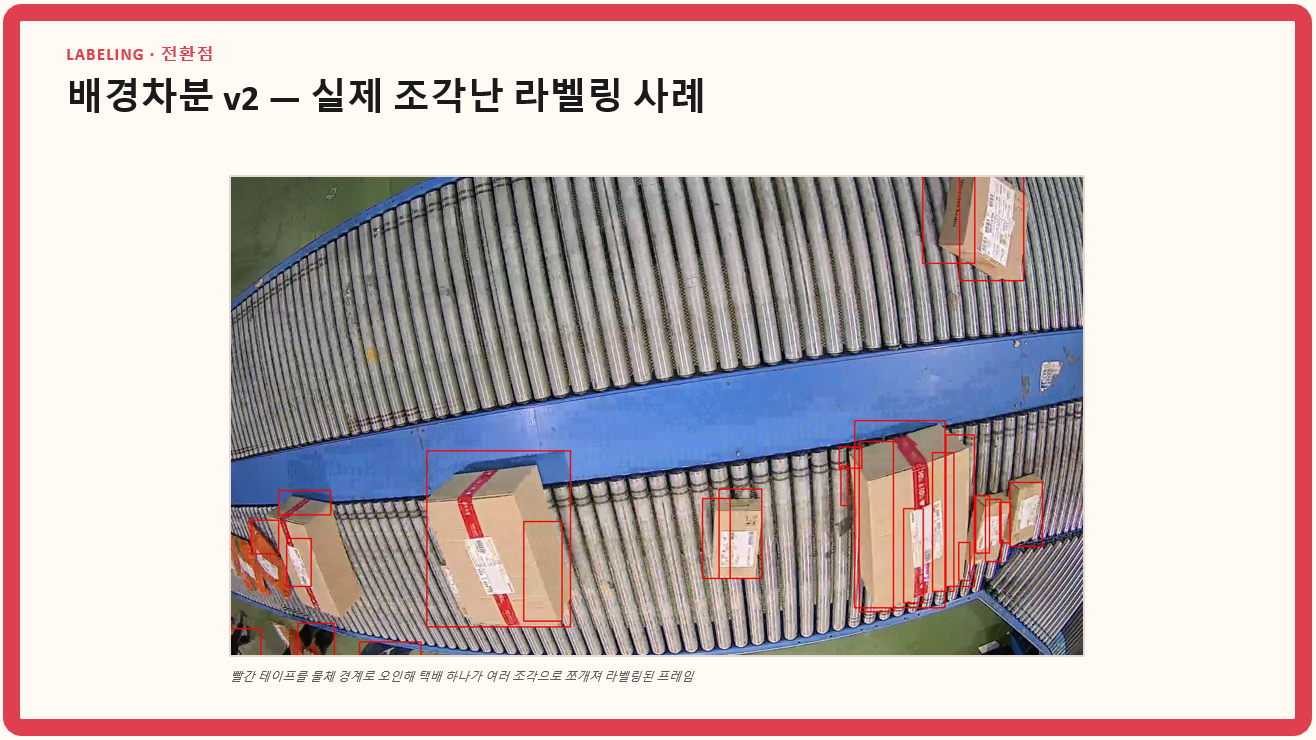
라벨링 실패 이미지 입니다.
이에 배경차분 방식 대신 Grounding DINO로 라벨링 모델을 전환했습니다. Grounding DINO는 텍스트 프롬프트로 객체를 찾는 탐지 모델입니다.
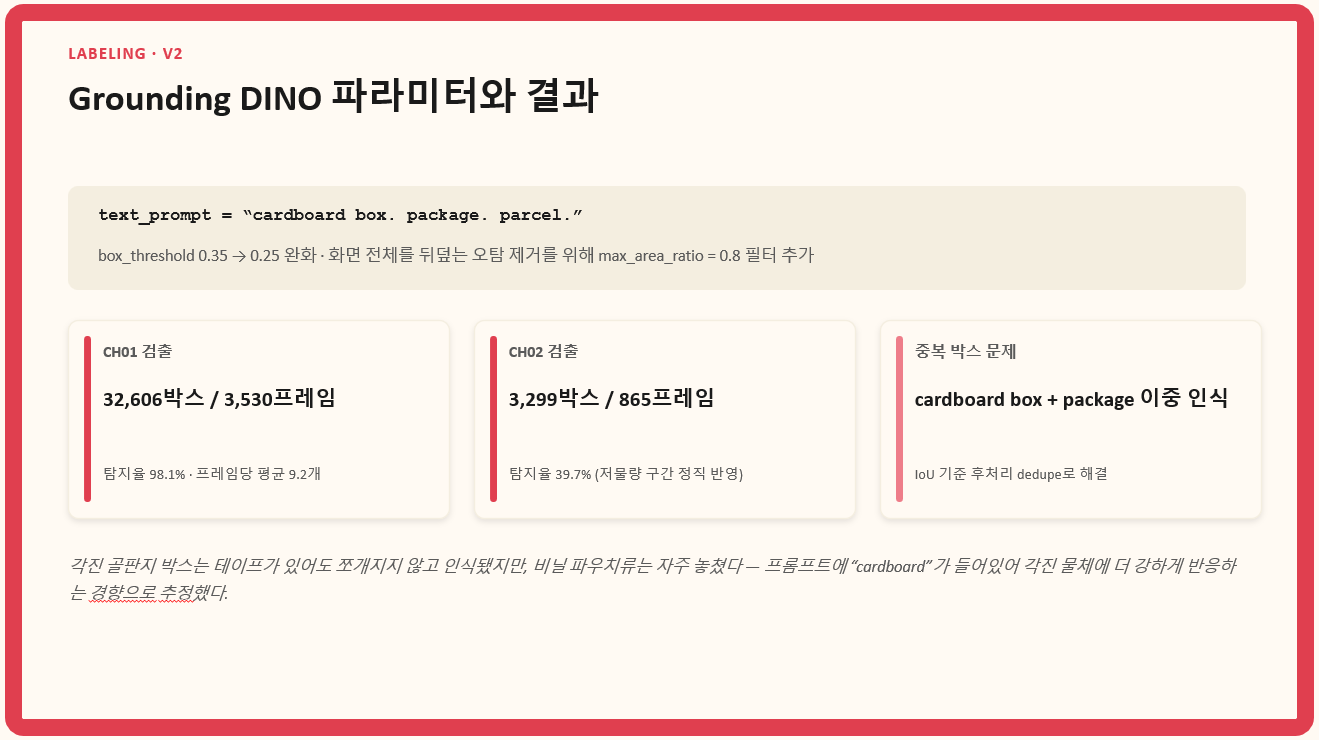
YOLO 같은 클로즈드 셋 모델은 미리 정해둔 클래스를 인식하는데, Grounding DINO는 이미지와 텍스트 관계를 함께 학습하는 방식이라서 카드보드박스·패키지·파슬 같은 유사어도 담아냈습니다. 구조적으로는 백본에서 특징을 뽑고, 넥에서 텍스트와 재조합한 뒤 헤드가 분류하여 예측하는 트랜스포머 구조입니다.
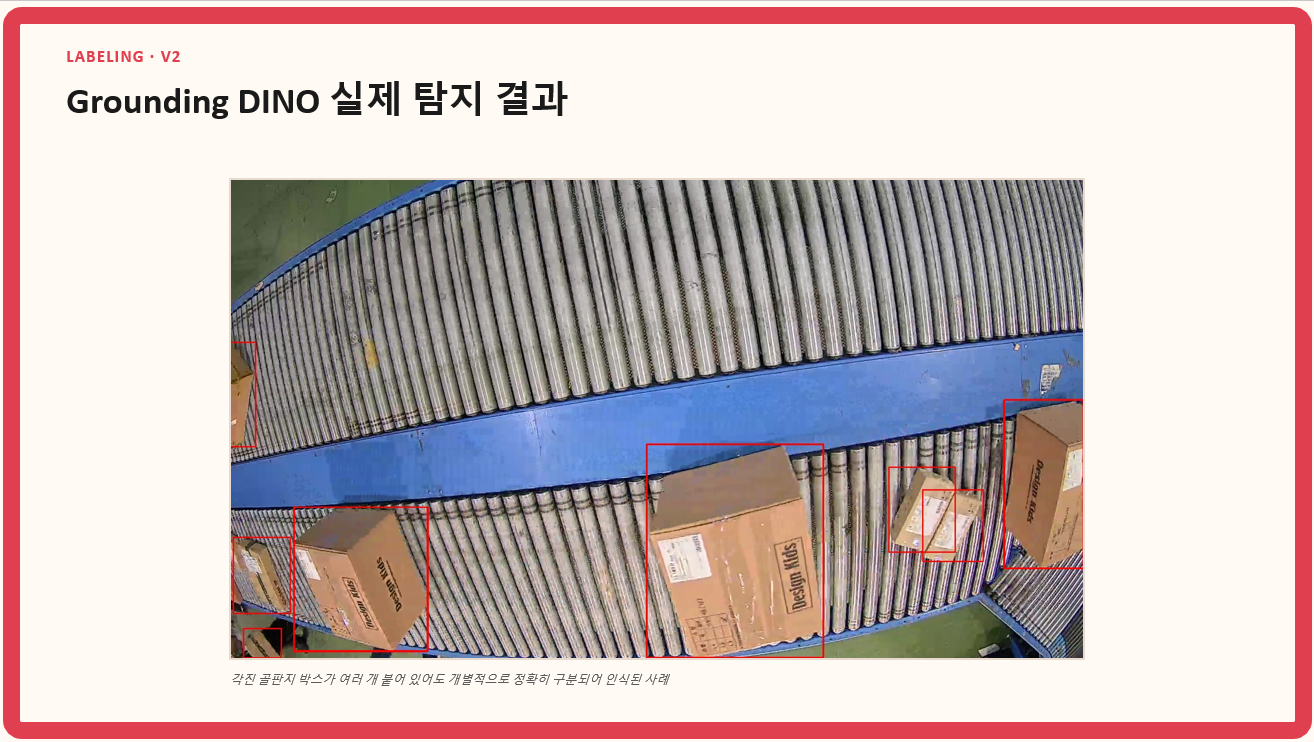
탐지 결과를 보니 골판지박스는 거의 100프로 인식하지만 비닐 파우치류는 놓칠 때도 있었습니다. 프롬프트에 있는 키워드 때문에 각진 물체에 더 강하게 반응하는 경향으로 예상됩니다.
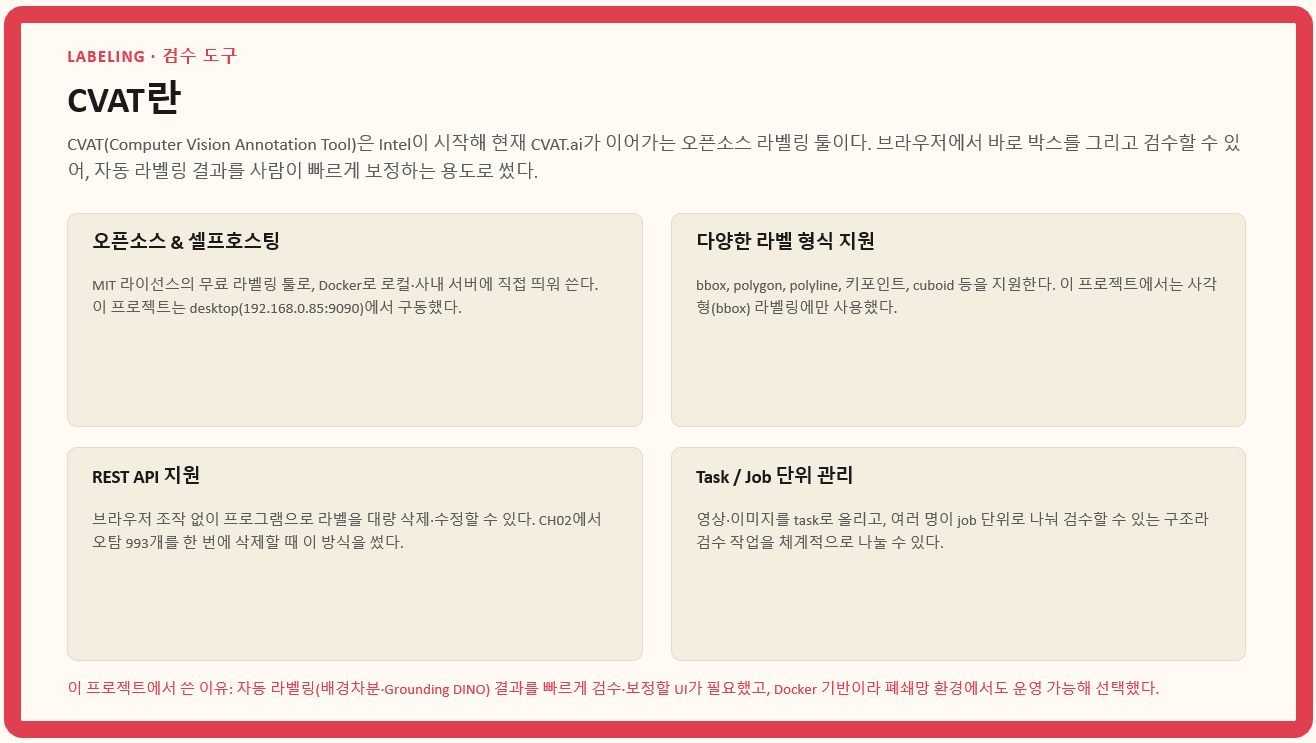
검수에는 CVAT이라는 오픈소스 라벨링 툴을 사용하였습니다.
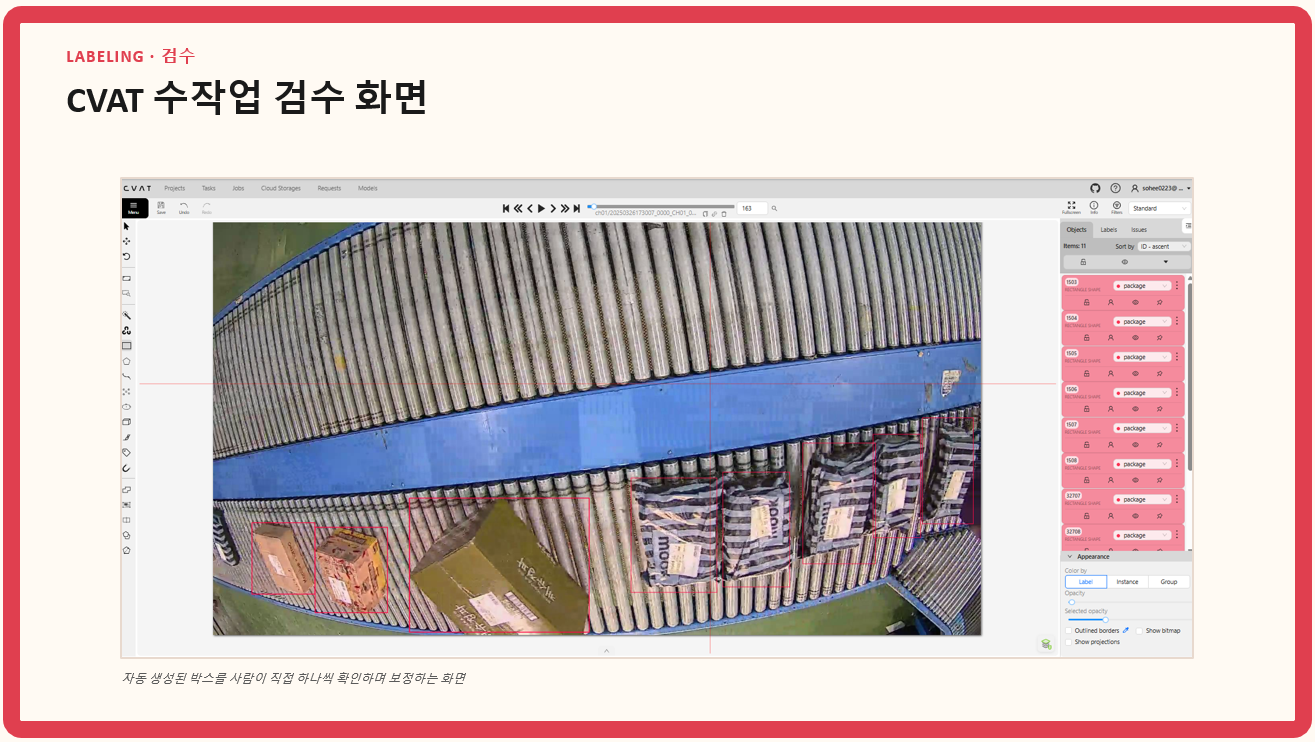
유명 데이터셋도 사람이 작업하다보니 몇 퍼센트 정도는 라벨 오류가 있다는 걸 감안하고도, 최대한 깨끗한 데이터로 학습시키고 싶어서 4시간이나 라벨 검수에 공을 들였습니다.
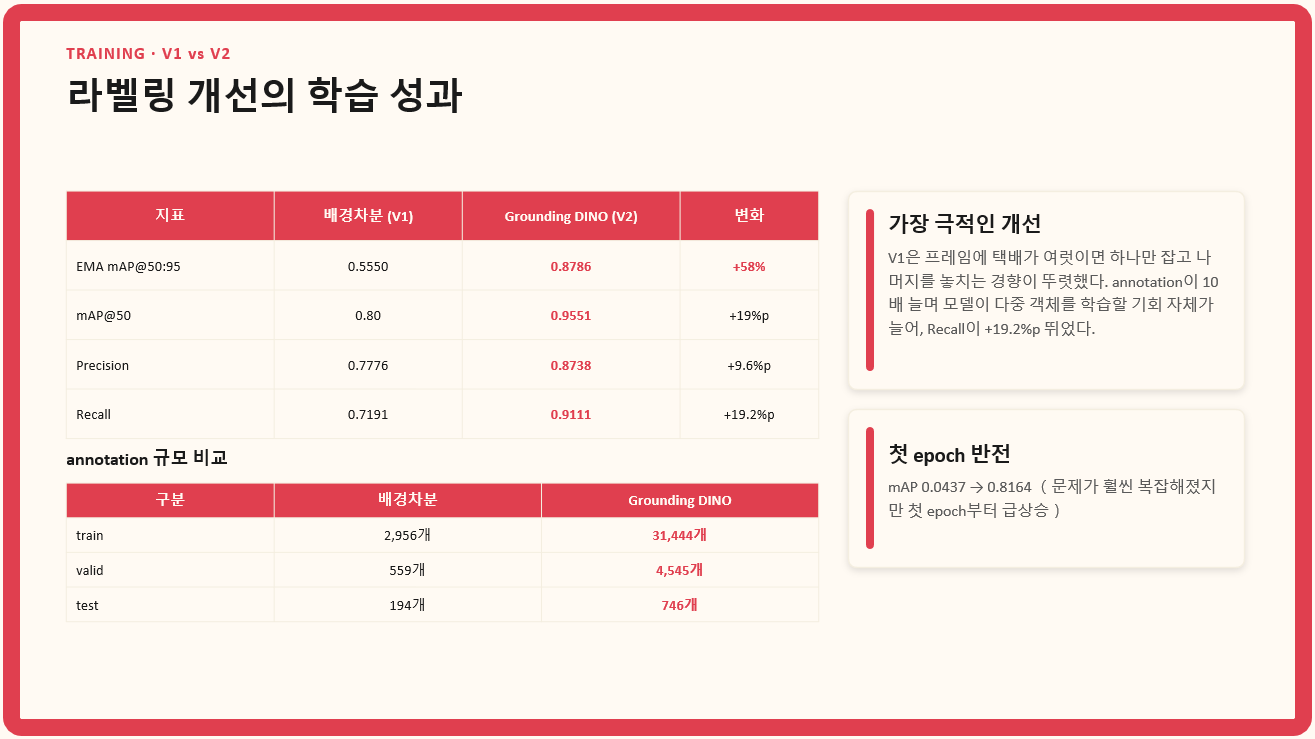
버전2의 학습결과를 비교하면 mAP50-90 기준 0.555에서 0.877로 58% 더 개선되었습니다.
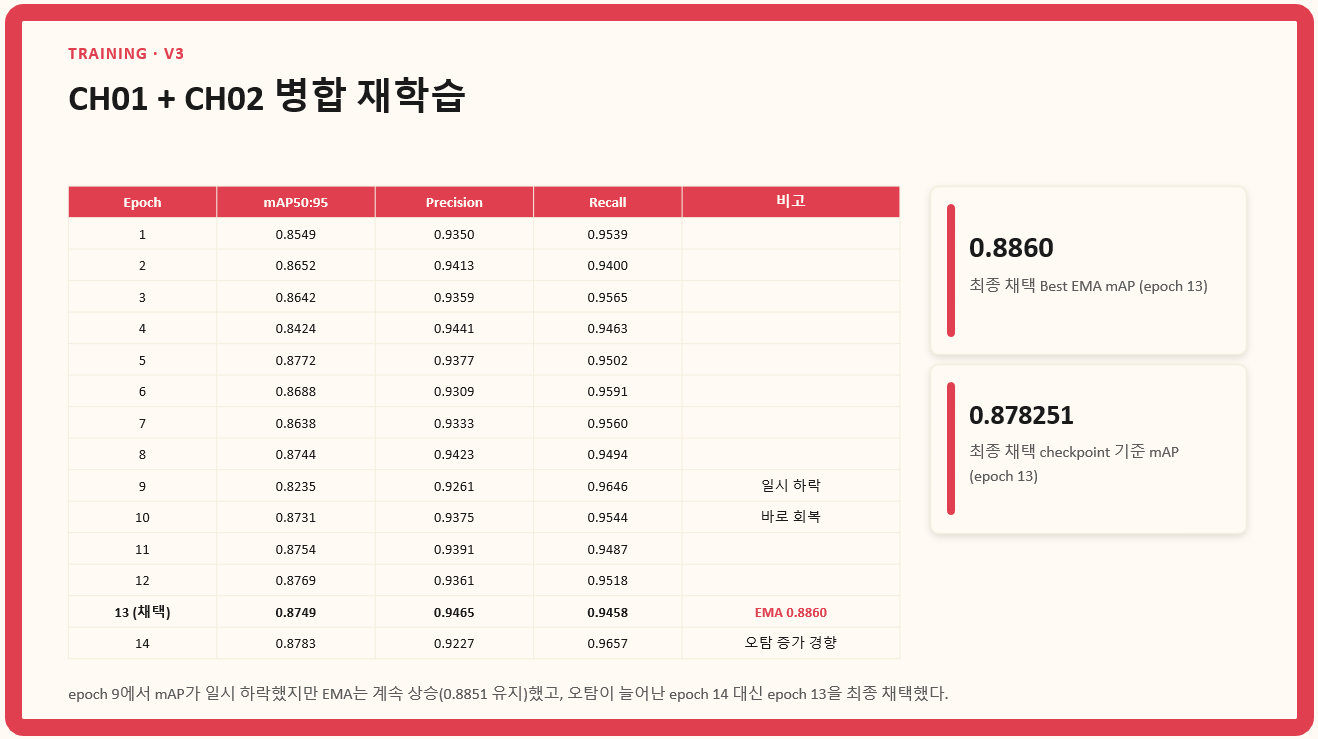
다른 장소에서 촬영된 2개의 데이터셋을 병합하여 재학습한 버전3에서는 9에폭에서 잠시 오버피팅 즉 과적합이 있었으나, 지수이동평균은 상승했기에 안정된 이후인 13에폭 가중치를 채택했습니다.
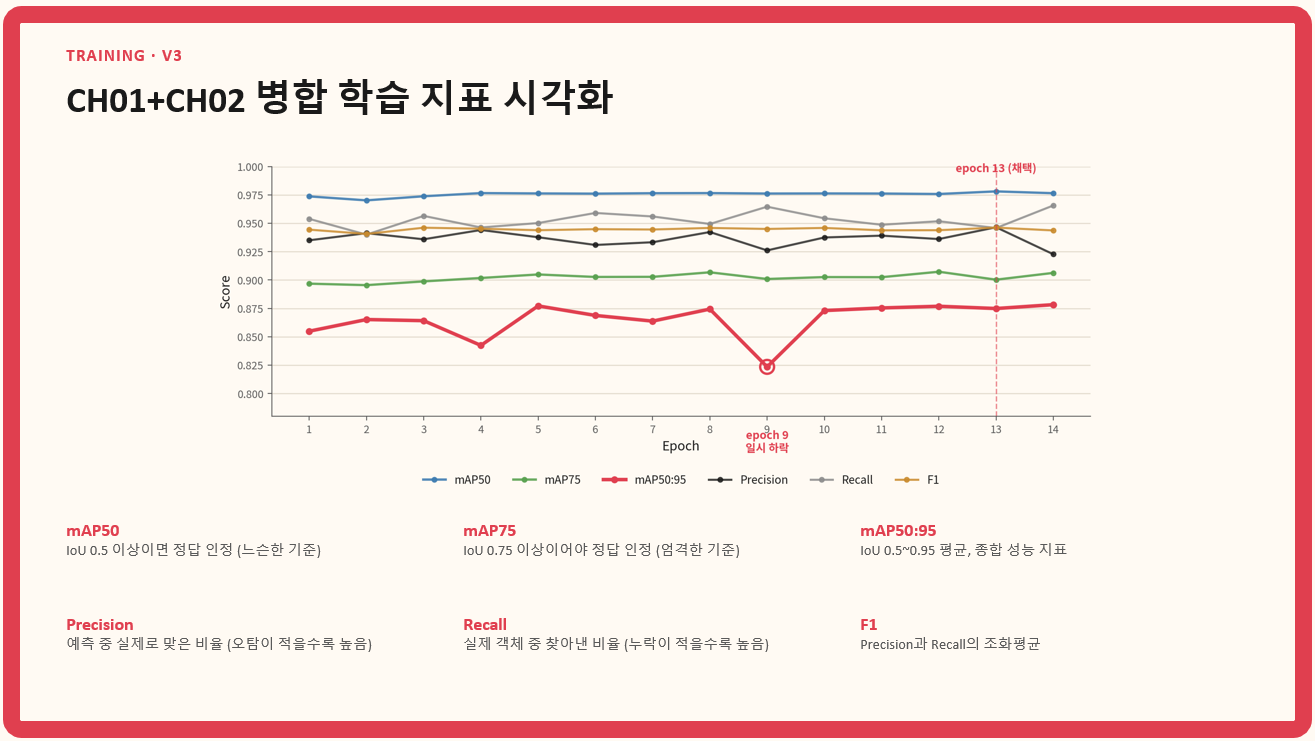
여섯 가지 지표를 시각화한 차트입니다.
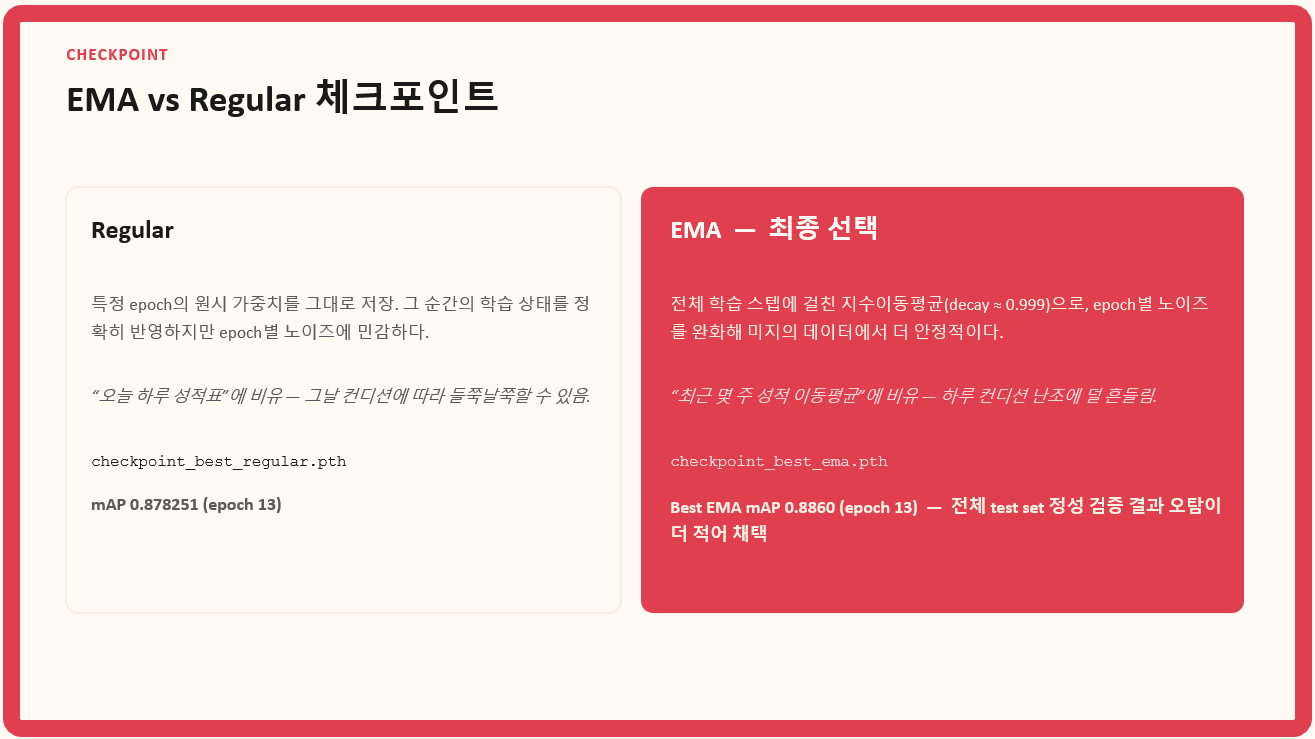
13에폭 학습 가중치 중에서도 Regular와 EMA를 비교해보니 EMA가 결과가 더 좋았습니다. Regular는 특정 에폭 위주 가중치이고, EMA는 지수이동평균이라 이전 데이터에서 더 안정적으로 노이즈 영향을 흡수할 수 있습니다.
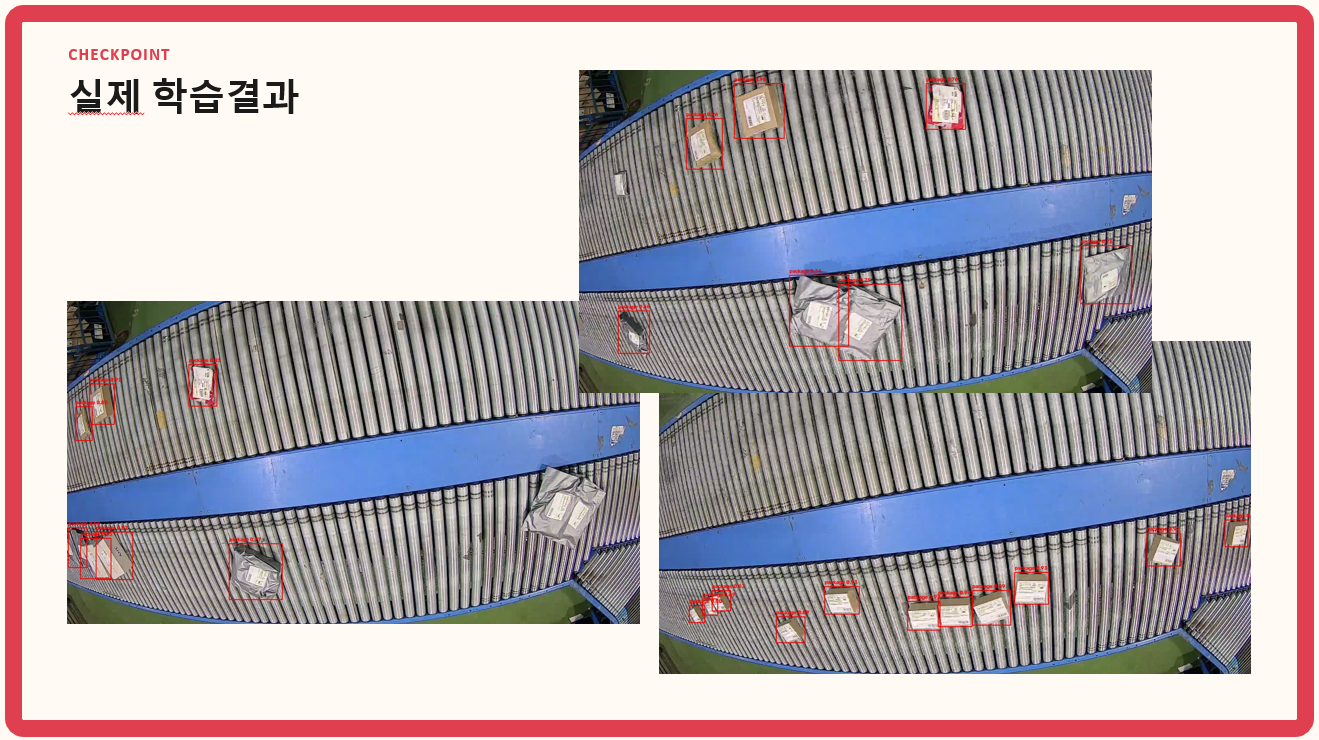
데모플레이 화면입니다. 충분히 좋은 성능으로 해당 현장에서 활용 가능한 수준입니다. 영상으로도 확인해보겠습니다.
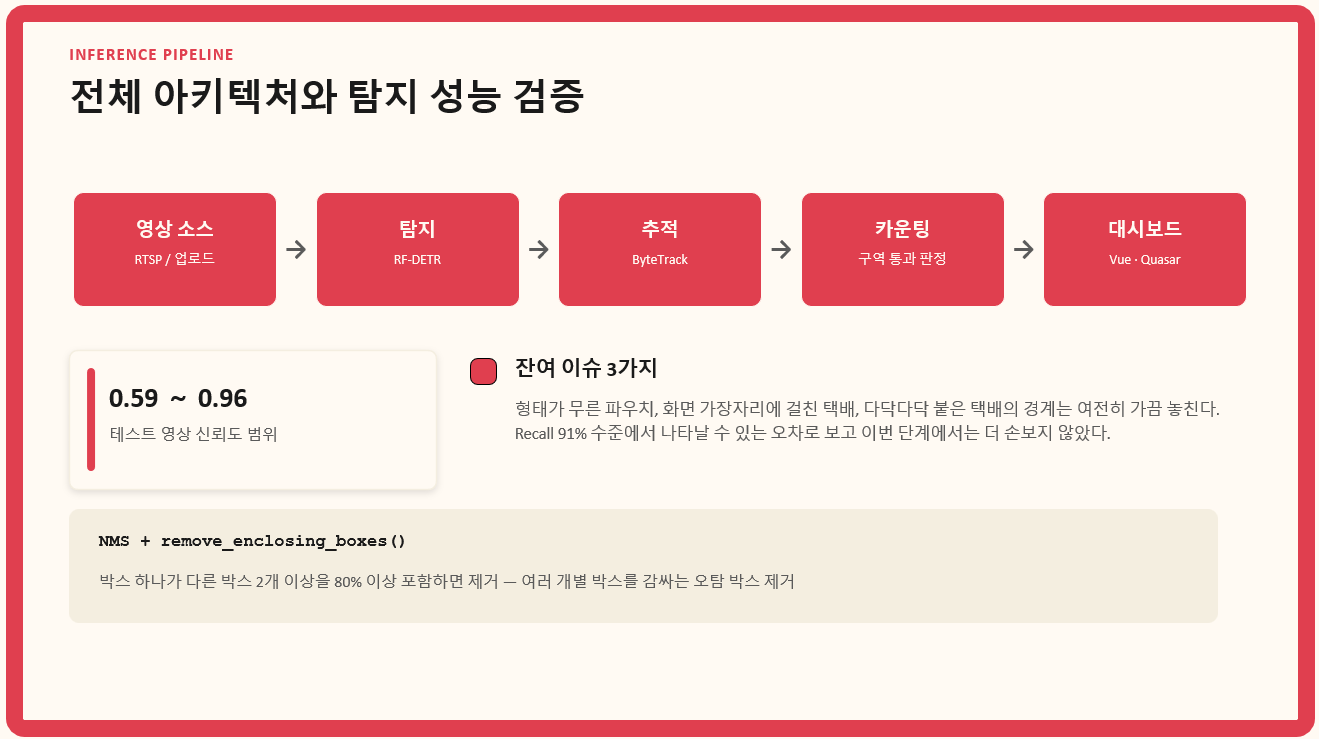
전체 아키텍처는 영상소스에서 탐지, 추적, 카운팅, 대시보드로 이어집니다. 택배 탐지는 RF-DETR 모델, 추적은 ByteTrack, 카운팅은 규칙 기반 방식입니다.
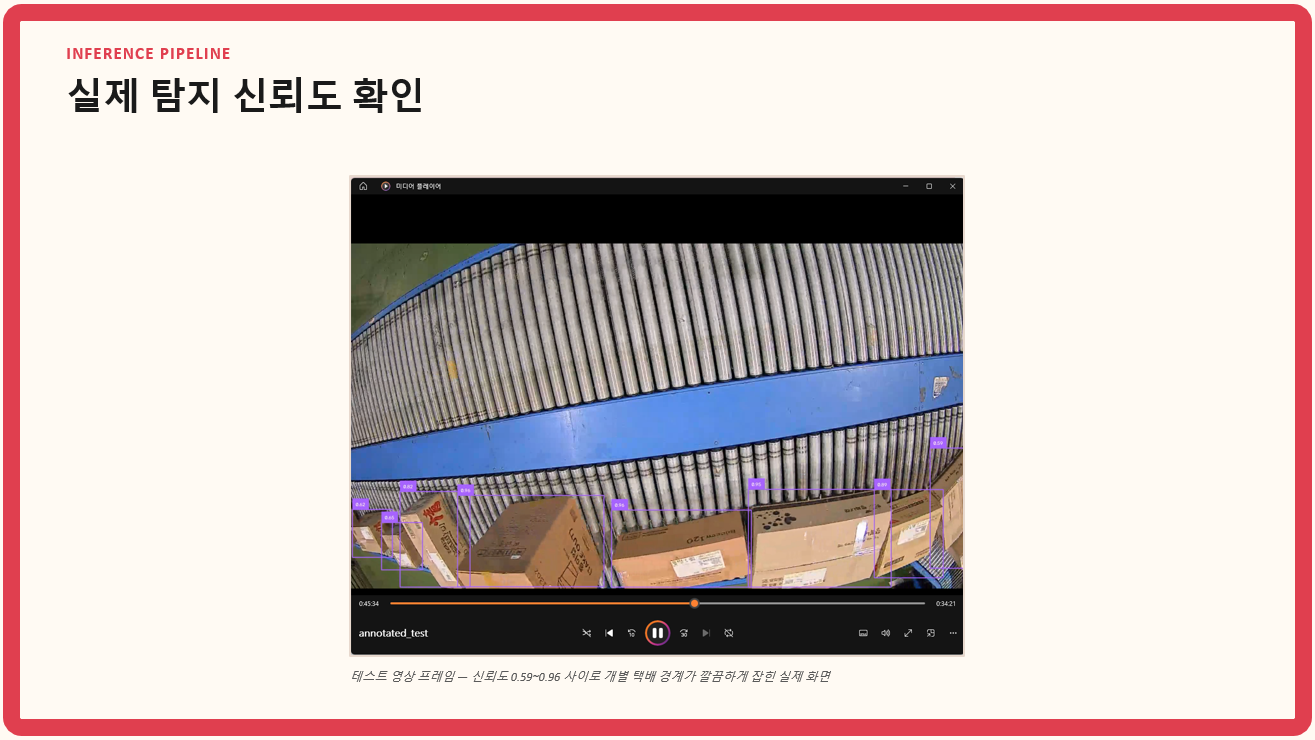
버전 3으로 테스트한 영상을 같이 살펴보겠습니다. 본컴퓨터 Tracked_test 파일 재생
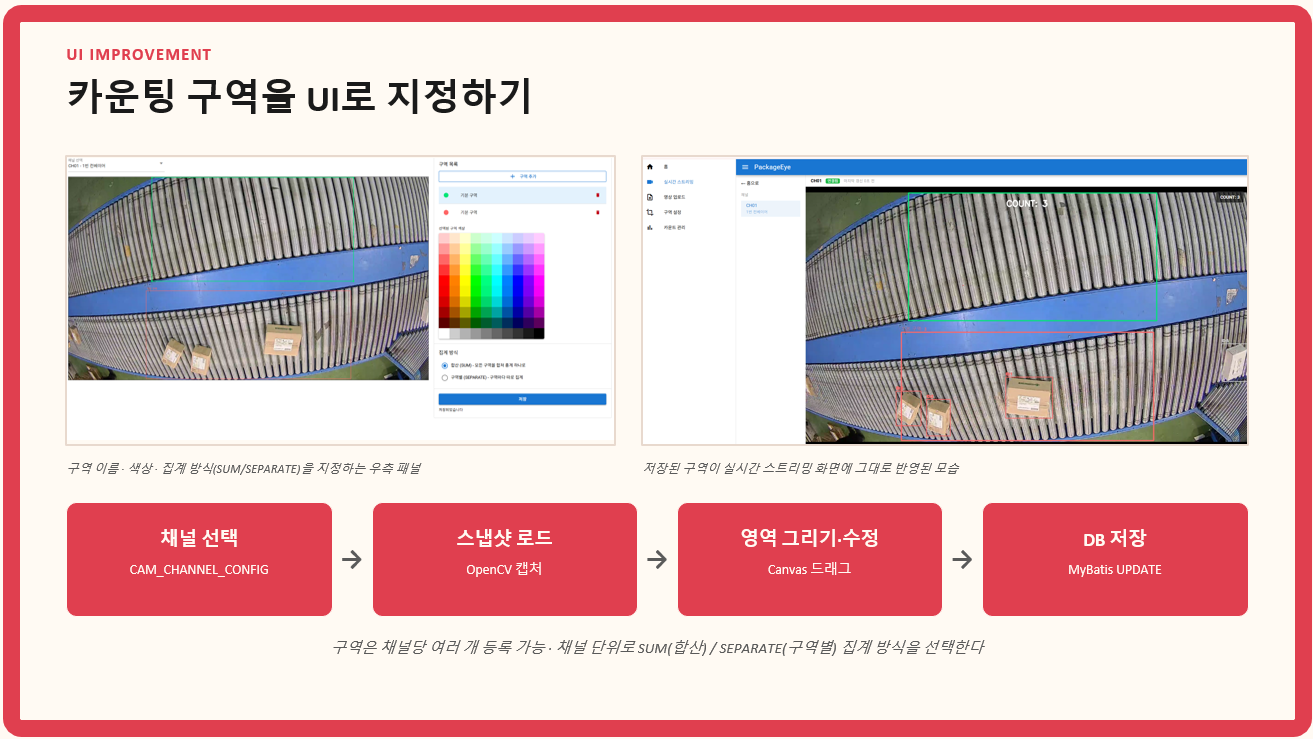
CCTV 영상마다 카운팅 영역을 지정할 수 있게 UI를 구성해 보았습니다. (시연)
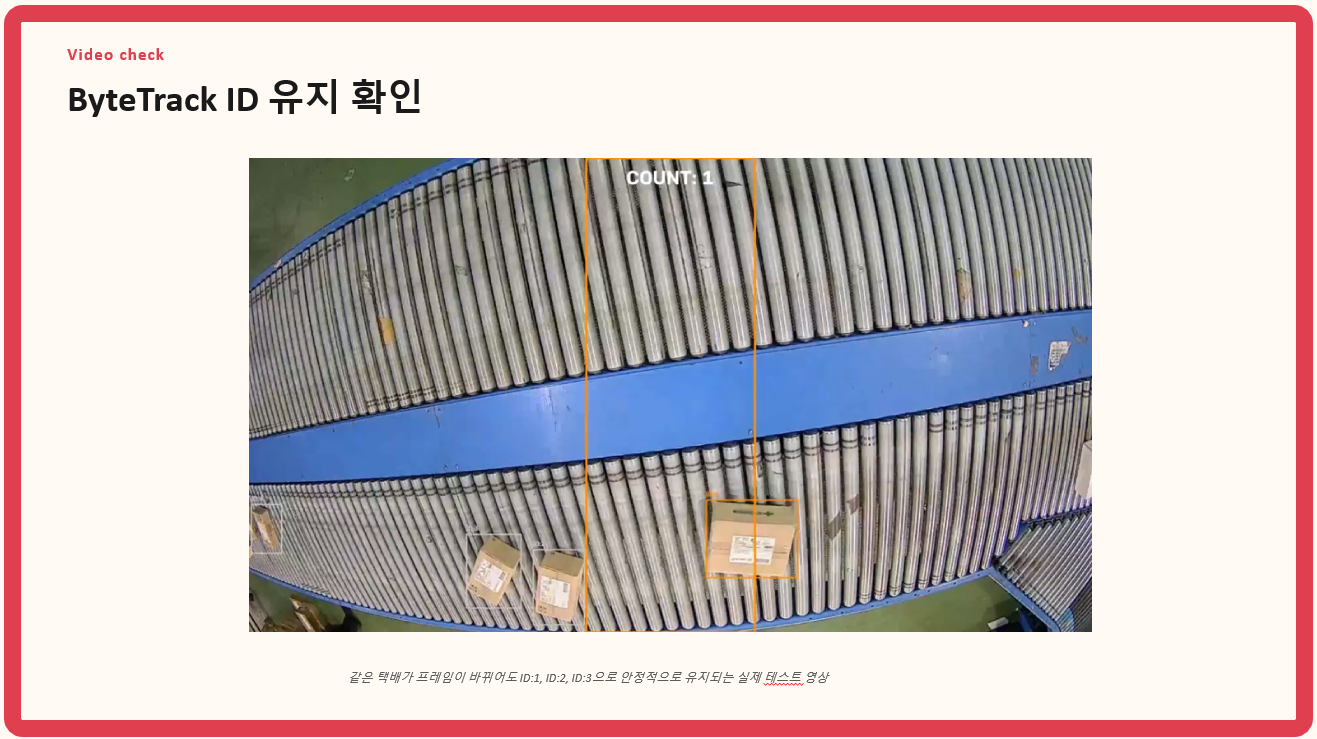
ByteTrack으로 같은 택배가 프레임이 바뀌어도 같은 트랙 아이디를 유지하도록 하며, 한번 카운팅 된 트랙 아이디는 다시 세지 않게끔 했습니다.
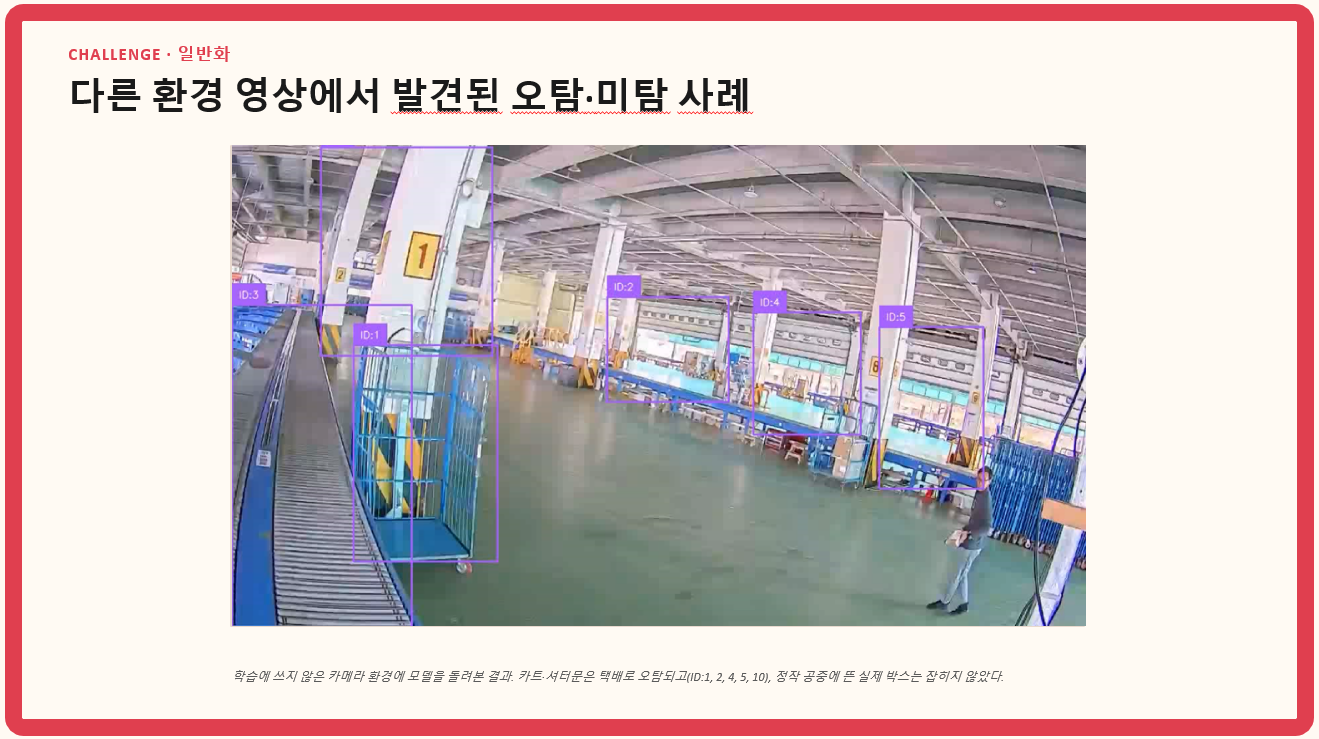
한 번도 학습에 쓴 적 없는 새로운 환경의 택배 영상을 돌려보니 구조물이나 카트를 오인식하는 문제를 발견했습니다. 택배가 아닌 온전한 네거티브 샘플 객체를 학습해본 기회가 적어서 생긴 문제로 보아, 파인튜닝을 진행했습니다.
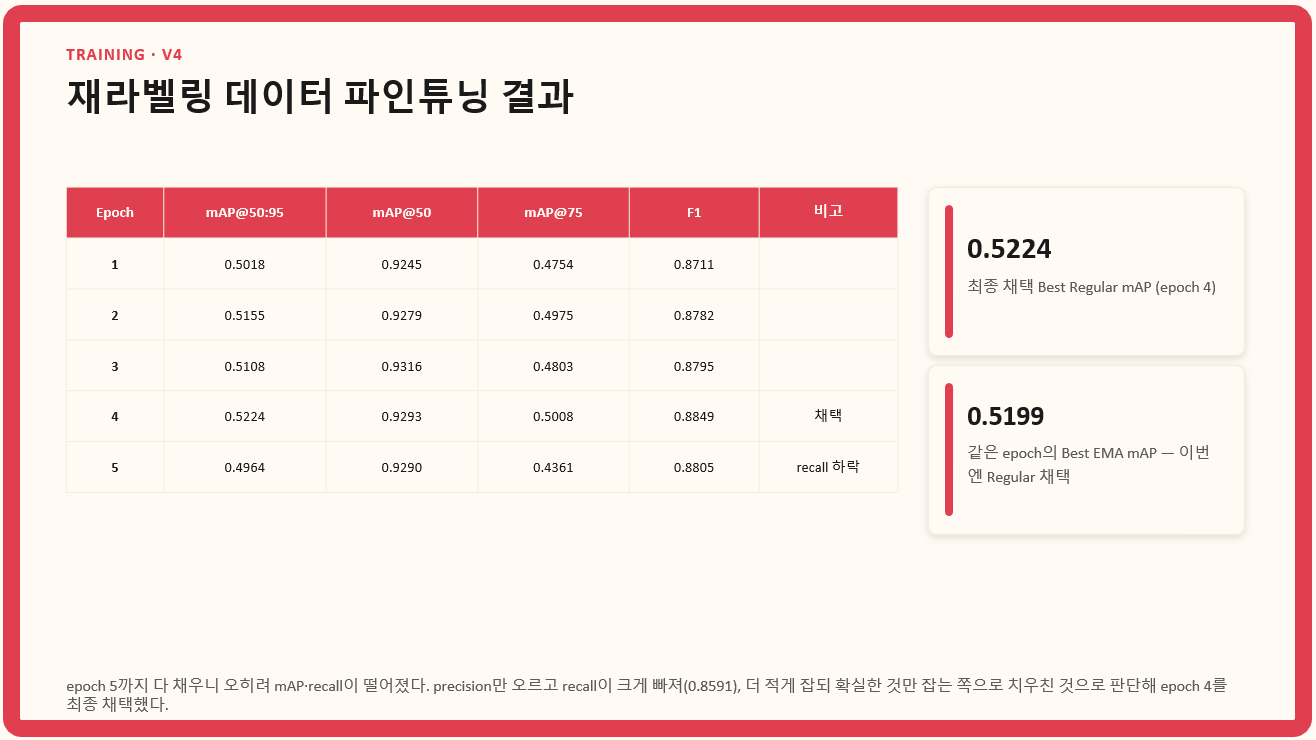
기준이 엄격해지다 보니 5에폭부터 리콜이 크게 떨어지는 지점이 있어, 4에폭을 최종 가중치로 선정했습니다.
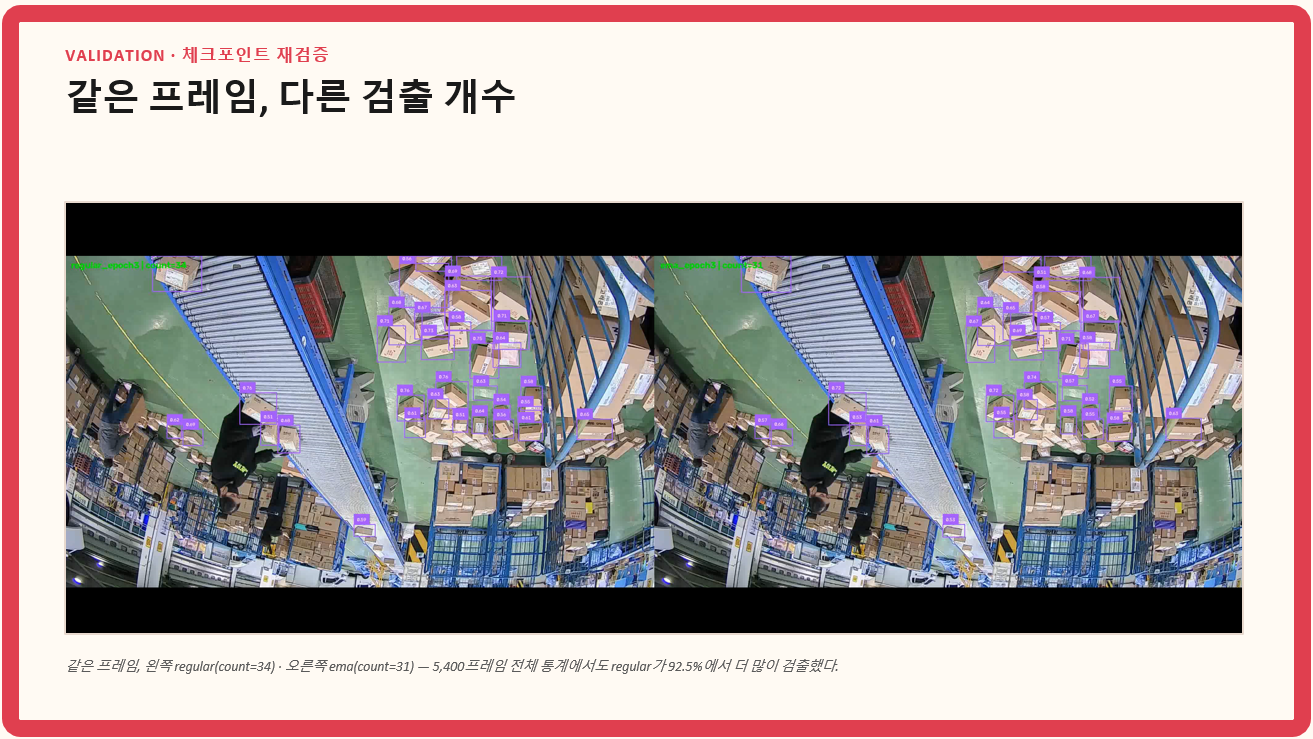
체크포인트를 다시 골라야 했는데, 이번에는 Regular가 EMA보다 더 좋은 컨피던스(신뢰도)로 검출해서 그것으로 재택했습니다.
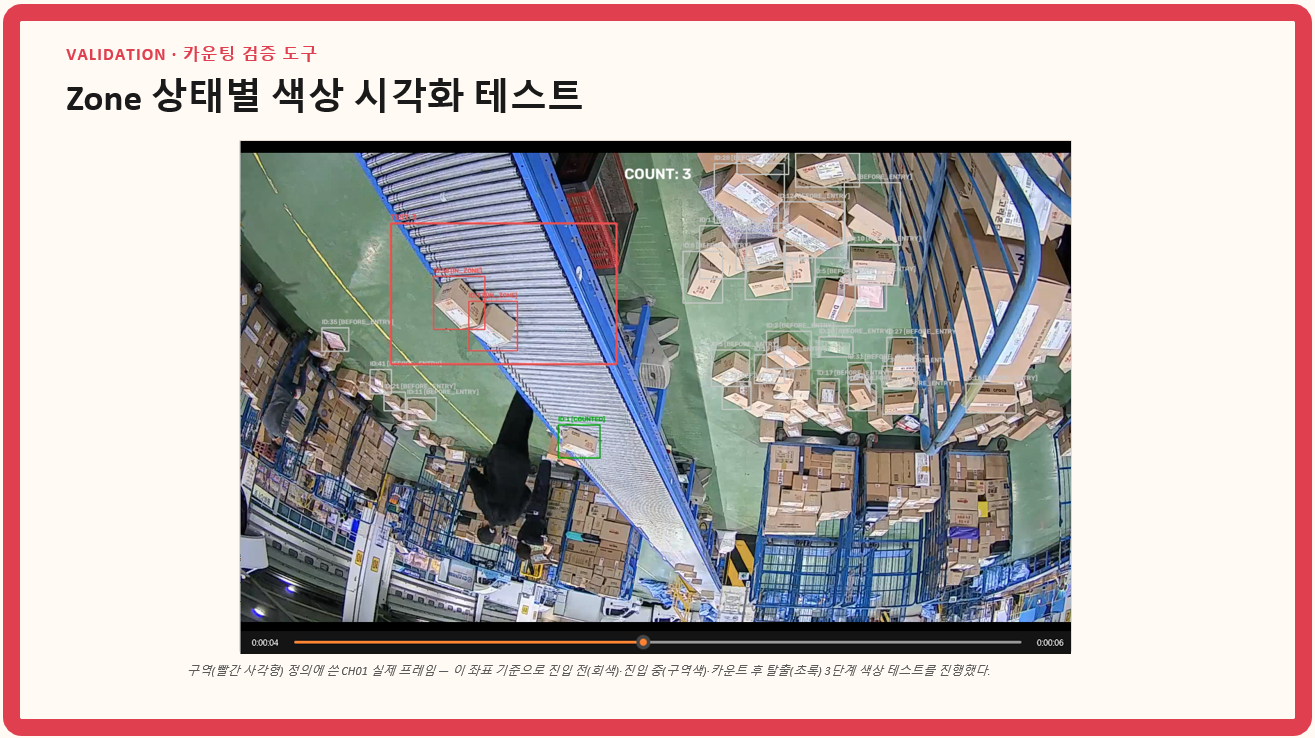
다시 한번도 학습한적 없는 영상으로 테스트해보았는데 바닥에 복잡하게 택배가 널부러져 있는 상황에서 중간중간 인식이 끊길때도 있지만 1개씩 추적하고 있는 것을 확인할 수 있습니다. 추후에는 이중에서 파손되는 경우를 탐지할 수 있다면 유용하게 쓰일 수 있을 것 같습니다.
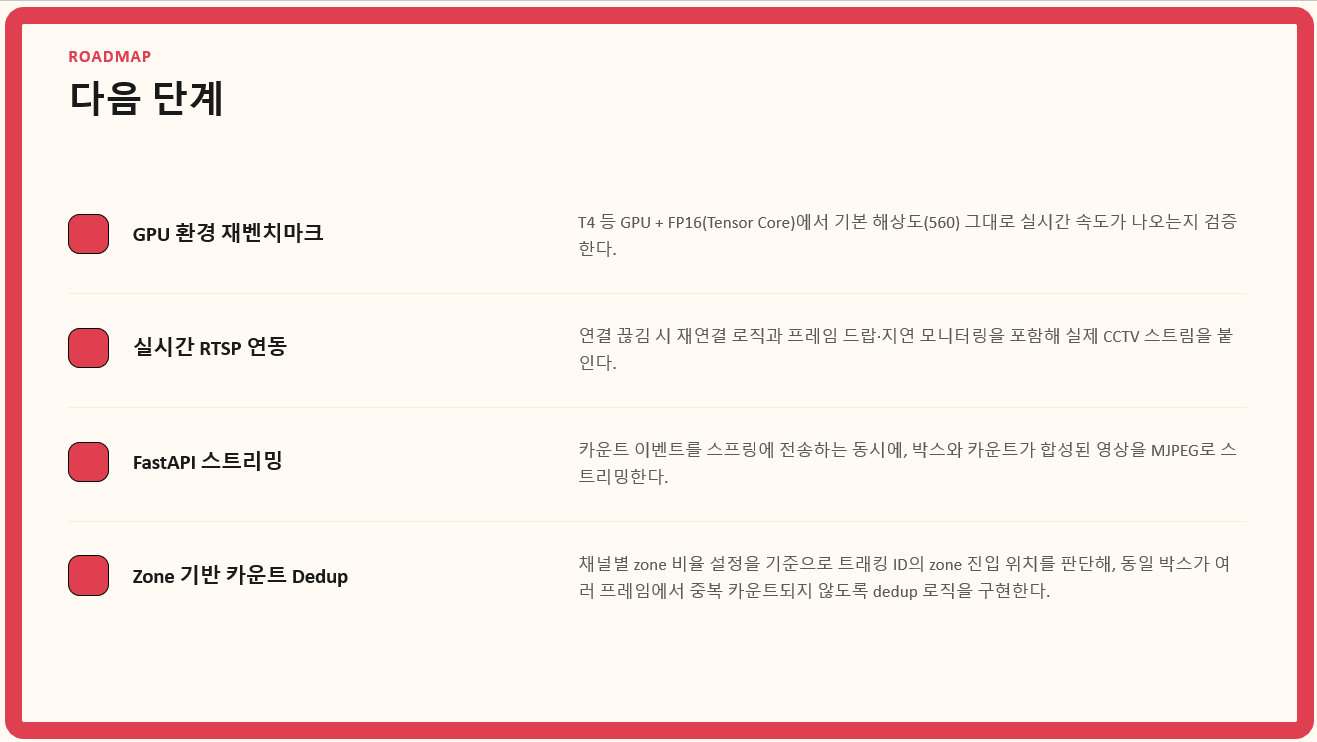
아직 개선할 수 있는 여지가 있는 부분이 많이 존재하고 있습니다.
준비한 발표는 여기까지입니다. 들어주셔서 감사합니다.