문제 상황
GPU PC에서 백엔드/프론트를 세팅하고 실시간 스트리밍 화면을 열어보니 영상이 몇 초에 한 번씩은 멈추는 현상이 있었다.
- 손을 흔들면 몇 초 뒤에야 화면에 반영됨
- 카운팅 로직 특성상, 끊기는 구간 안에서 택배가 구역을 통과해버리면 아예 못 셀 수도 있는 구조
원인 추정 1: GPU를 안 쓰고 있었다
이 PC엔 RTX 3070 Ti가 꽂혀 있었는데, torch.cuda.is_available()은 True가 나왔다. rfdetr 라이브러리도 내부적으로 _detect_device()라는 함수로 GPU를 자동 인식한다고 되어 있었다.
그런데 실제로 모델을 로드해서 확인해보니 model.device가 cpu였다.
d = PackageDetector(inference_config.MODEL_CHECKPOINT_PATH, 0.5)
print(d.model.model.device)  # -> cpu
원인은 단순했다. rfdetr의 RFDETR.from_checkpoint()는 자동 감지한 DEVICE 상수를 자기가 알아서 써주는 게 아니라, 호출할 때 device= 파라미터로 명시적으로 넘겨줘야 했다. 우리 코드(inference/detector.py)는 이 파라미터를 넘기지 않고 있었다.
# 수정 전
self.model = RFDETR.from_checkpoint(checkpoint_path)

# 수정 후
from rfdetr.config import DEVICE
self.model = RFDETR.from_checkpoint(checkpoint_path, device=DEVICE)
프레임당 추론 시간이 0.6초 → 0.026초로 줄었다 (약 23배). 그런데 실제로 스트리밍 화면을 다시 열어보니, 끊김은 여전했다.
원인 추정 2가 아니었다 — 탐지 파이프라인은 무죄
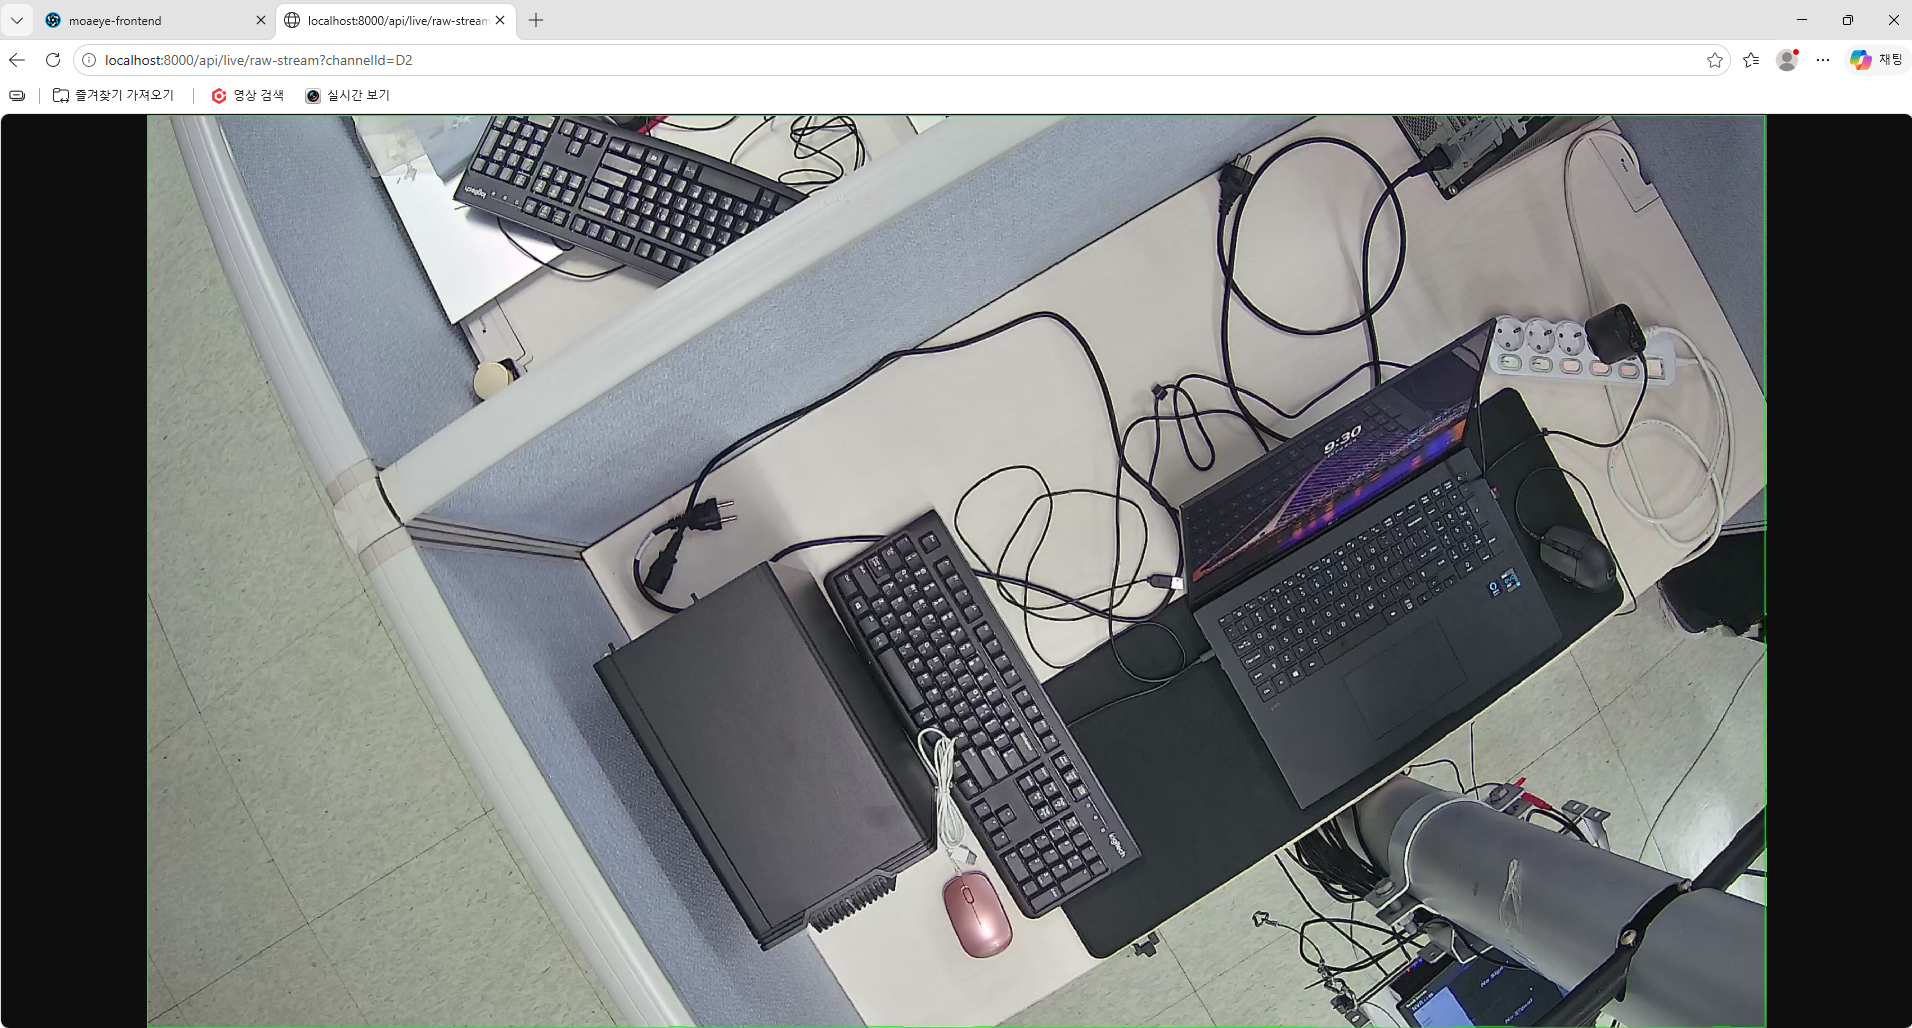
"그럼 아직도 어디선가 느린가?"를 확인하려고, 탐지/트래킹을 아예 안 거치고 카메라 원본만 그대로 MJPEG로 재전송하는 진단용 엔드포인트를 하나 만들었다.
def _raw_mjpeg_generator(cam_url):
    cap = open_capture(cam_url)
    while True:
        ret, frame = cap.read()
        ok, buf = cv2.imencode(".jpg", frame, [cv2.IMWRITE_JPEG_QUALITY, 80])
        yield b"--frame\r\nContent-Type: image/jpeg\r\n\r\n" + buf.tobytes() + b"\r\n"
이것도 똑같이 끊겼다. 즉 우리 GPU/탐지 코드는 범인이 아니었고, 카메라나 네트워크 쪽 문제였다는 뜻이다.
원인 추정 3: 해상도 때문에 디코딩이 느린가?
프레임 하나 읽는 데 걸리는 시간을 직접 찍어봤다.
for i in range(150):
    t0 = time.time()
    ret, frame = cap.read()
    dt = (time.time() - t0) * 1000
    if dt > 150:
        print(f"frame {i}: {dt:.0f}ms")
카메라 MAIN 화질(2880×1624) 기준, 150프레임 중 6번이 530~750ms씩 튀었다. 간격이 대략 25프레임마다 한 번 — 카메라의 키프레임(I-frame) 주기와 일치했다. "고해상도 키프레임을 소프트웨어로 디코딩하느라 느린가 보다"라고 판단하고, 카메라가 지원하는 저해상도 서브스트림(SUB, 704×576)으로 바꿨더니 최대 지연이 640ms → 180ms로 줄었다.
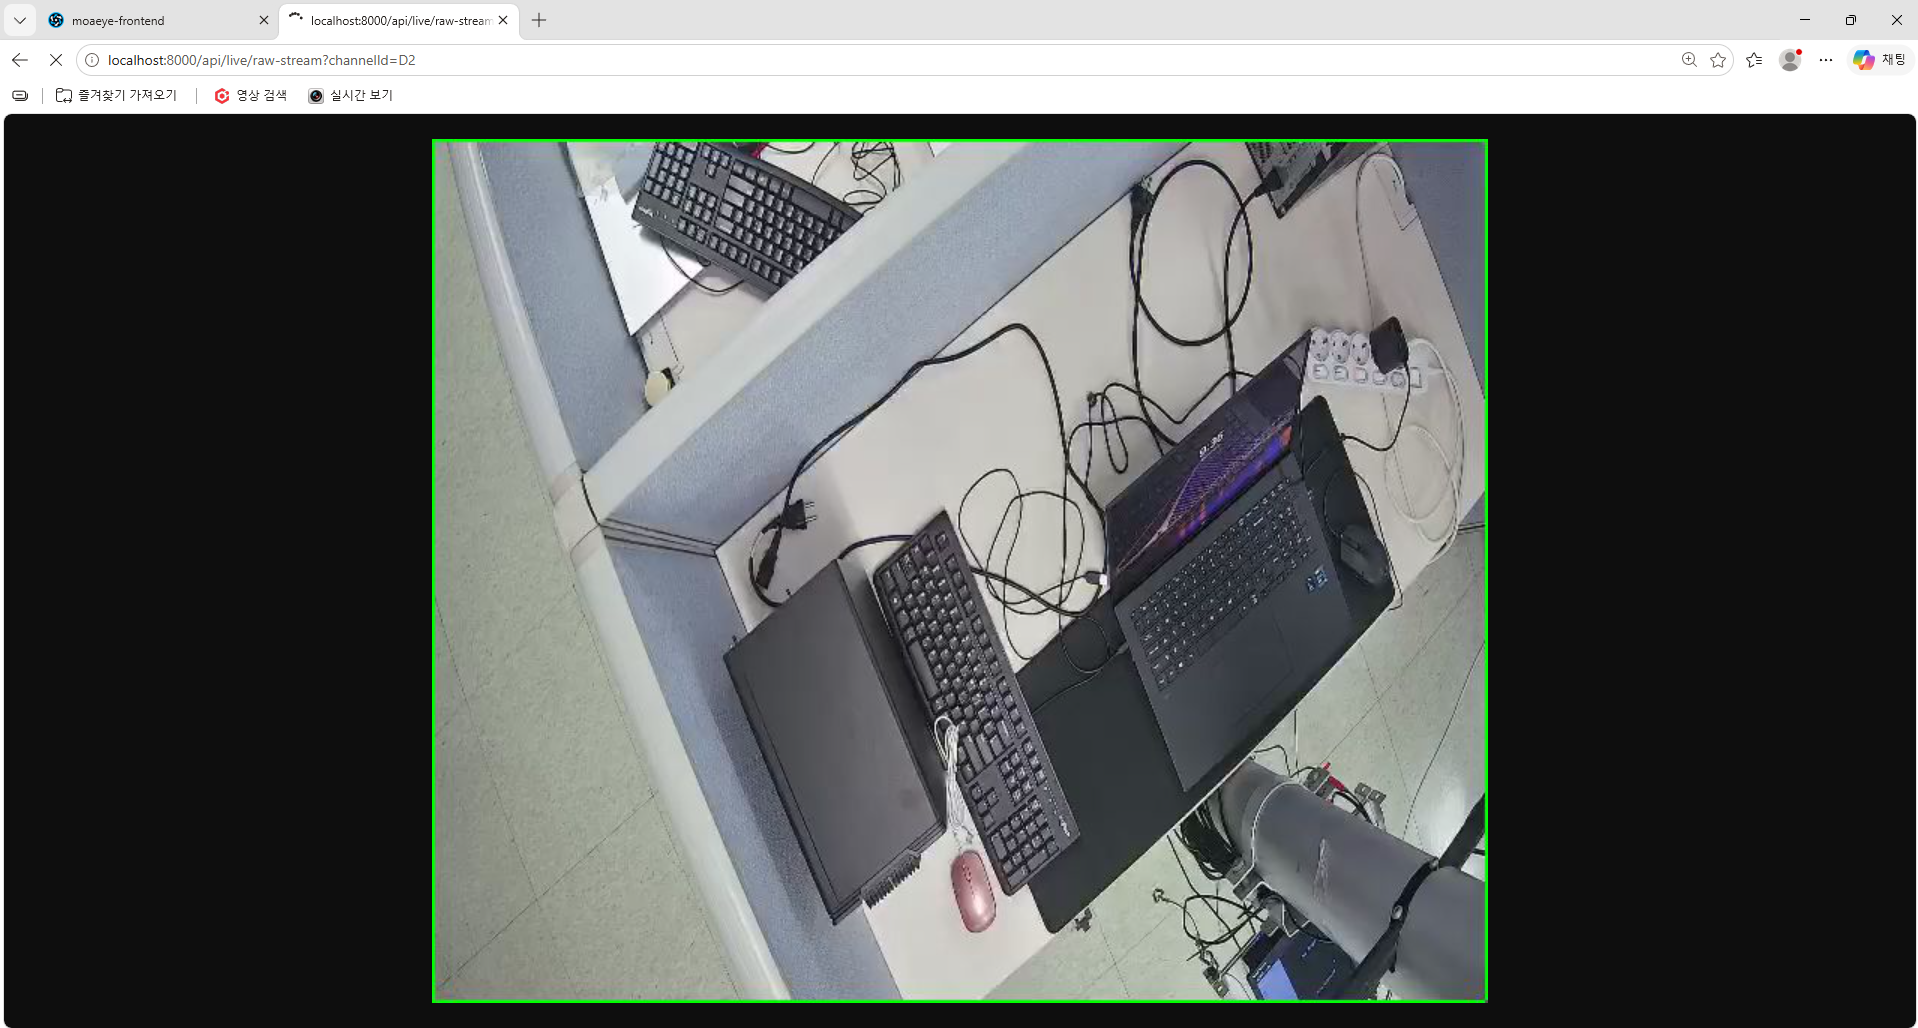
다만 SUB는 MAIN과 화면 비율 자체가 달라서(2880×1624 vs 704×576, 거의 정사각형에 가까움) 화각이 좁아 보이는 문제가 생겼다. GPU 하드웨어 디코딩으로 해상도를 유지한 채 고쳐보려 했지만, 이 환경의 OpenCV 빌드는 하드웨어 가속을 지원하지 않았다.
원인 추정 4: 디코딩이 아니라 네트워크인가?
"그래도 SUB에서마저 가끔 끊기는 게 찜찜한데?"라는 생각에, CPU 점유율을 같이 재보기로 했다. time.time()(총 소요시간)과 time.process_time()(CPU가 실제로 일한 시간)을 같이 찍어서 비율을 봤다.
wall_dt = (time.time() - wall0) * 1000
cpu_dt = (time.process_time() - cpu0) * 1000
# cpu_dt / wall_dt 비율이 낮을수록 "디코딩"이 아니라 "대기"가 원인
결과는 명확했다. 끊기는 구간에서 CPU는 전체 시간의 2~30%만 일하고 있었다. 나머지 70~98%는 그냥 데이터가 도착하기를 기다리는 시간이었다. 그래서 디코딩이 느린 게 아니라 큰 키프레임 데이터가 네트워크로 늦게 도착하는 것이라고 판단했다.
이 PC에서 카메라 쪽으로 나가는 인터페이스를 확인해보니 USB-이더넷 동글(100Mbps) 이었다. 이게 병목이라고 생각했는데, 팀장님이 "100Mbps면 영상 스트림 하나 받는 데 부족할 정도는 아닐 텐데?"라고 하셔서, 정말 네트워크가 맞는지 다시 확인해보기로 했다.
왜 고화질 파이프라인을 카운팅에 바로 합치면 안 되는가
네트워크를 당장 바꾸기는 어려운 상황이라, 우선은 저화질(SUB)로 부드럽게 카운팅을 돌리고 고화질(MAIN)은 별도로 보여주기로 했다. 그런데 "고화질도 탐지를 돌리자"는 요구가 나오면서 한 가지 짚고 넘어가야 했다 — 같은 물리적 택배 하나를 두 파이프라인이 각자 감지하게 되므로, 둘 다 "오늘 총 카운트"에 반영하면 카운트가 그대로 두 배가 된다.
그래서 package_count 테이블에 source 컬럼을 추가해서 구분했다.
ALTER TABLE package_count
  ADD COLUMN source VARCHAR(10) NOT NULL DEFAULT 'sub'
COMMENT '어느 화질 파이프라인이 기록했는지 (sub=저화질/공식, main=고화질/비교용)';source='sub': 공식 집계, "오늘 총 카운트"·실시간 웹소켓 알림에 반영source='main': 화면 표시 + DB 기록은 하되, 공식 집계/알림에는 안 섞음
def register_count(channel_id, zone_id, track_id, source="sub"):
    ...
    if source == "sub":
        event["todayTotal"] = get_today_total()
        manager.broadcast(event)
    return event
지금 상태
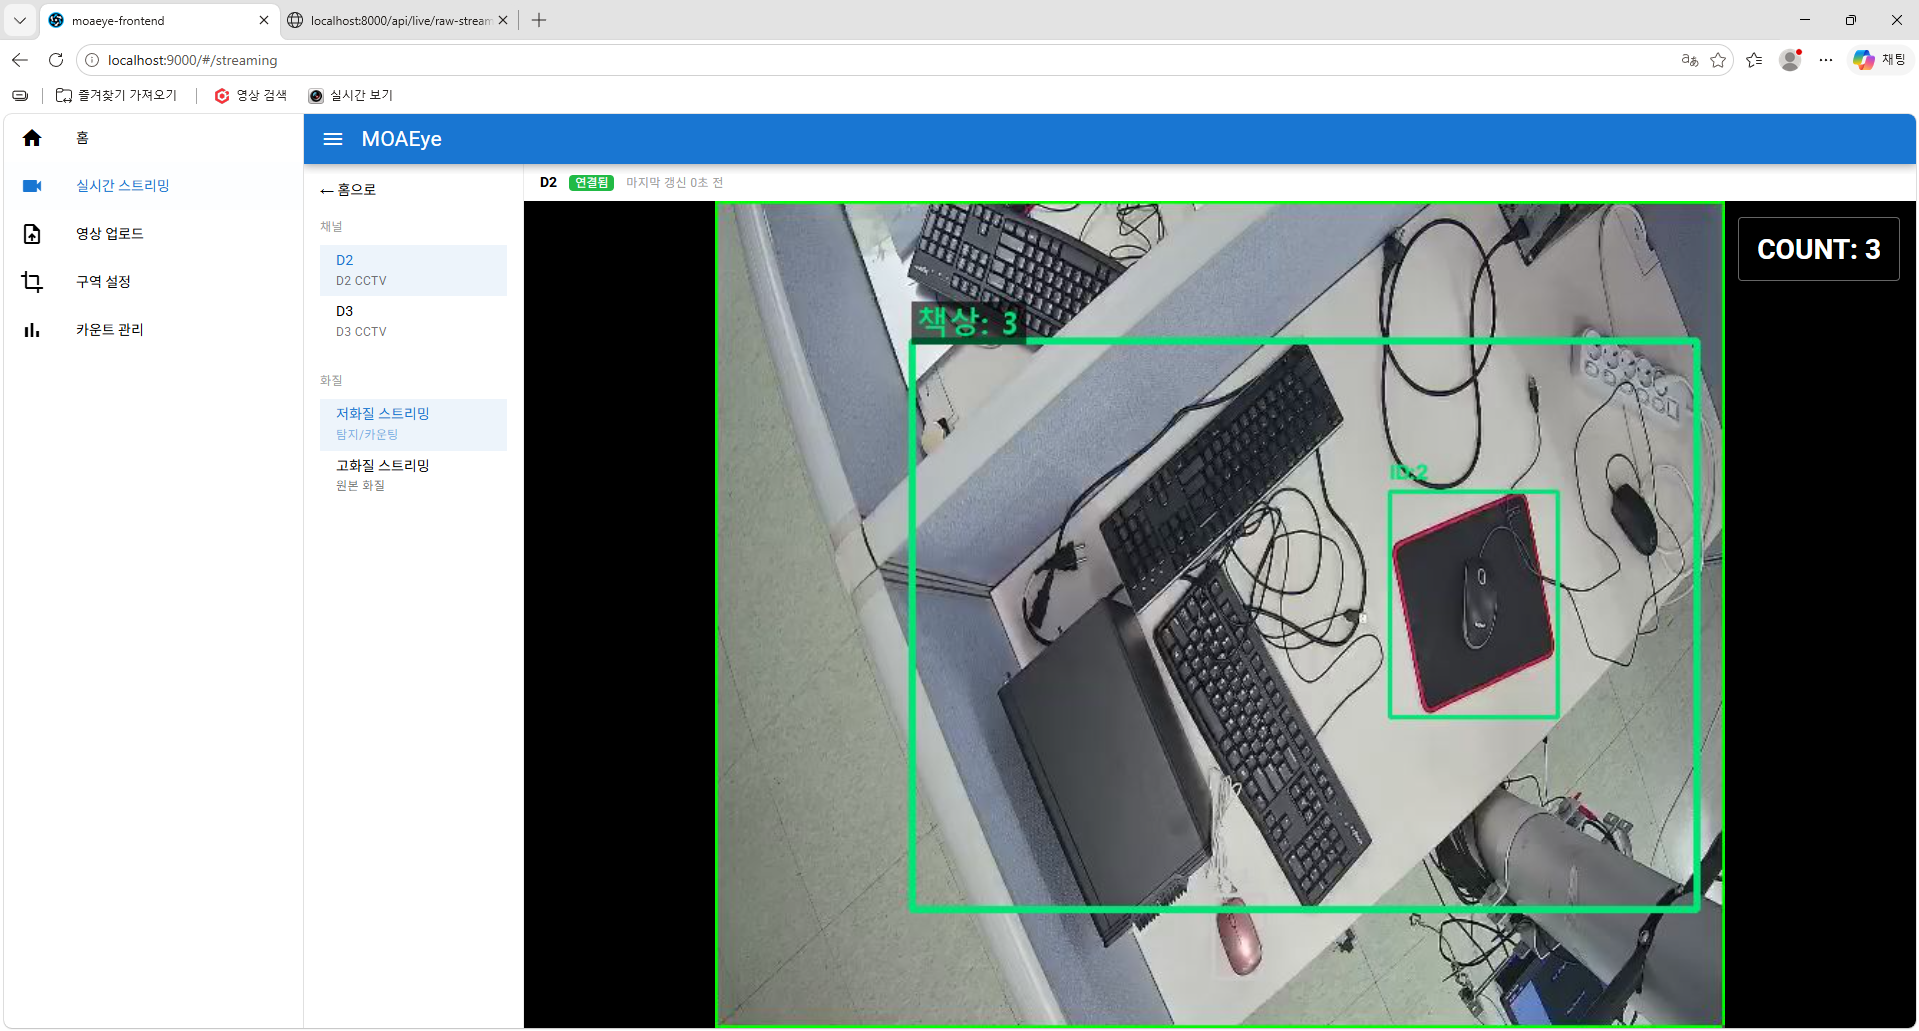
- 저화질(SUB) 탭: 실제 카운팅용, 부드러움
- 고화질(MAIN) 탭: 같은 채널을 원본 화질로 병행 탐지, DB에는
source='main'으로 별도 기록 GET /api/counts/comparison으로 언제든 두 값 대조 가능
VLC로 확인해보니: 네트워크도 아니었다
팀장님 말씀대로 정말 네트워크가 문제인지 확인하려고, 같은 RTSP 주소를 VLC로 직접 열어봤다. 그런데 — 전혀 안 끊겼다. 네트워크나 카메라 자체가 문제였다면 VLC도 똑같이 끊겨야 하는데 아니었다. 즉 병목은 카메라도, 네트워크도 아니라 저희 코드가 프레임을 읽는 방식 그 자체에 있었다.
VLC는 화면에 보여주는 시점보다 몇 프레임 앞서 미리 읽어두는 재생 버퍼가 있어서, 순간적으로 한 번 막혀도 이미 쌓아둔 프레임으로 계속 부드럽게 재생한다. 반면 저희 코드는 cap.read()를 매번 동기적으로 호출해서 그 자리에서 기다리는 구조였다 — 카메라가 막히면 코드도 같이 멈췄다.
해결: VLC처럼 미리 읽어두는 버퍼 스레드
별도 스레드가 쉬지 않고 cap.read()만 반복해서 큐에 쌓아두고, 실제 소비(탐지/화면 표시)는 그 큐에서 꺼내 쓰도록 바꿨다.
class BufferedFrameReader:
    def __init__(self, cap):
        self._cap = cap
        self._queue = queue.Queue(maxsize=BUFFER_FRAMES)  # 15fps 기준 약 2초치
        self._thread = threading.Thread(target=self._reader_loop, daemon=True)
        self._thread.start()

    def _reader_loop(self):
        while not self._stop_event.is_set():
            ret, frame = self._cap.read()
            if not ret:
                self._queue.put((False, None))
                return
            try:
                self._queue.put((True, frame), timeout=1)
            except queue.Full:
                pass

    def read(self):
        return self._queue.get()
적용하고 나니 프레임 진행이 끊김 없이 꾸준해졌다. 그런데 이번엔 새로운 부작용이 생겼다 — 밀렸던 프레임을 GPU가 순식간에 처리해버려서, 화면이 마치 빨리감기처럼 "순간이동"하는 현상이 나타났다.
순간이동 문제: 따라잡는 속도를 실제 촬영 속도로 제한
밀린 프레임을 몰아서 보여주지 않도록, 화면에 내보내는 속도를 카메라의 실제 촬영 속도(1배속)로 못박았다. 밀린 만큼은 화면이 그만큼 늦게 나오는 지연으로 남지만, 움직임 자체는 끊기거나 튀지 않고 매끄럽다.
if min_display_interval:
    elapsed = time.monotonic() - last_display_time
    if elapsed < min_display_interval:
        time.sleep(min_display_interval - elapsed)
    last_display_time = time.monotonic()
그럼 지연이 계속 쌓여서 실시간과 격차가 점점 벌어지지 않을까는 우려가 됐었는데, 카메라가 평균적으로 보내는 속도와 우리가 화면에 내보내는 속도가 결국 같기 때문에 지연은 어느 정도 선에서 더 늘어나지 않고 멈춘다. 혹시 몰라서 큐 크기(2초치)보다 더 밀리면 오래된 프레임부터 버리는 안전장치도 넣어서, 최악의 경우에도 지연이 2초 넘게는 안 쌓이게 막아뒀다.
저화질/고화질을 다시 하나로 합쳤다
여기까지 고치고 나니, 애초에 SUB로 화질을 낮췄던 이유(끊김) 자체가 사라졌다. 그래서 저화질 파이프라인을 잠깐 꺼보고 고화질(MAIN)만 단독으로 테스트해봤는데, 훨씬 더 부드럽게 나왔다. 알고 보니 그동안 남아있던 끊김 중 일부는 저화질/고화질 두 파이프라인이 같은 카메라에 동시에 붙어서 연결을 나눠 쓰고 있었기 때문이기도 했다.
결국 저화질 파이프라인이랑, sub/main을 나눠서 DB에 두 번 기록하던 로직, 화질 비교 탭까지 전부 없애고 MAIN 화질 하나만 쓰기로 정리했다. 처음부터 진짜 문제는 네트워크도 해상도도 아니라 "프레임을 하나씩 순서대로 기다려서 읽는 방식"이었고, 그게 풀리니 화질을 두 개로 나눠서 복잡하게 관리할 이유도 없어졌다.
최종 상태
- 실시간 스트리밍: MAIN 화질(2880×1624) 원본 그대로, 끊김도 순간이동도 없이 매끄럽게 재생
- 카운팅 파이프라인도 하나로 단순화 (이중 기록/비교 로직 제거)
- 결론: 병목은 네트워크나 해상도가 아니라 동기적 프레임 읽기 방식이었다