Iris 시각화
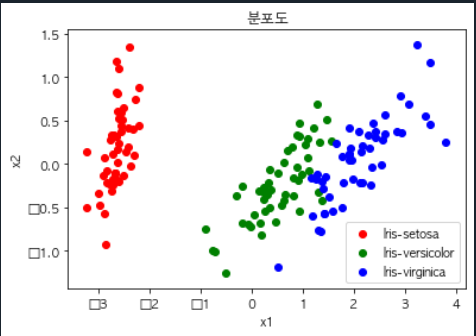
아이리스의 품종은
Iris-virginica
Iris-setosa
Iris-versicolor
등이 있습니다. 이를 이용하여
아이리스(iris) 데이터는 붓꽃의 꽃받침과 꽃잎의 길이와 폭을 측정한 데이터로, 분류 문제에서 많이 사용되는 대표적인 데이터셋입니다. 이 데이터셋을 시각화하는 방법 중에는 Scatter plot, Pair plot, Heatmap 등이 있습니다.
One Hot encoding
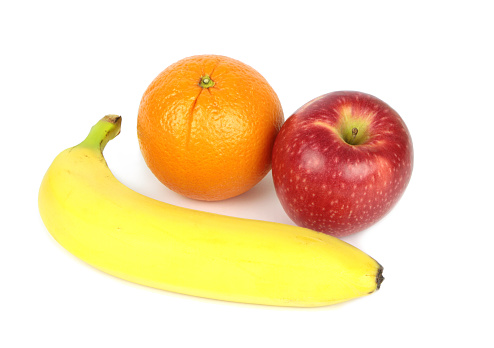
원 핫 인코딩(One-Hot Encoding)은 카테고리형 데이터를 수치형 데이터로 변환하는 방법 중 하나입니다. 이 방법은 카테고리에 대한 이진 플래그(binary flag)를 만들어 해당하는 값에 1을 부여하고, 나머지 값은 0으로 채우는 방법입니다.
예를 들어, "사과", "바나나", "오렌지"라는 3개의 과일 종류를 나타내는 변수가 있다면, 원 핫 인코딩을 적용하면 다음과 같이 변환됩니다.
"사과" : [1, 0, 0]
"바나나" : [0, 1, 0]
"오렌지" : [0, 0, 1]
즉, 각각의 카테고리 값이 새로운 차원으로 확장되고, 해당하는 값에만 1이 부여되고 나머지는 0으로 채워지게 됩니다. 이 방법은 머신러닝 분류 알고리즘에서 입력 변수로 사용하기 위해 많이 사용되며, 자연어 처리에서 단어나 문장을 수치화하는 과정에서도 사용됩니다.
Softmax
소프트맥스(Softmax)는 입력 값을 클래스에 대한 확률 분포로 변환하는 함수입니다. 소프트맥스 함수는 출력값이 0과 1 사이의 값이며, 모든 출력값의 합이 1이 되도록 만들어집니다. 이러한 특성은 분류 문제에서 출력값을 클래스에 대한 확률로 해석할 수 있도록 합니다.
수식으로 나타내면, 소프트맥스 함수는 다음과 같이 정의됩니다.
여기서 는 입력값 중 i번째 요소를 나타내며, 는 전체 입력값의 개수입니다. 소프트맥스 함수의 출력값은 차원 벡터이며, 각 차원은 클래스에 대한 확률값을 나타냅니다.
소프트맥스 함수는 다중 클래스 분류 문제에서 출력층에 적용되는 일반적인 함수 중 하나입니다. 주로 딥러닝에서 활성화 함수로 사용됩니다. 비용 함수로 크로스 엔트로피(Cross-Entropy)를 사용하면 소프트맥스 함수와 함께 많이 사용됩니다.
Iris 결과값
Iris(붓꽃) 데이터셋은 세 종류의 붓꽃(iris) 품종(setosa, versicolor, virginica)에 대한 꽃받침 길이(sepal length), 꽃받침 폭(sepal width), 꽃잎 길이(petal length), 꽃잎 폭(petal width) 총 4개의 특성(feature)을 갖는 데이터셋입니다.
Iris 데이터셋을 활용한 머신러닝 모델의 결과값은 모델의 성능과 사용한 알고리즘에 따라 달라질 수 있습니다. 분류 알고리즘의 경우, 모델의 정확도(accuracy)나 혼동 행렬(confusion matrix) 등이 평가 지표로 사용됩니다.
예를 들어, 분류 알고리즘을 사용하여 Iris 데이터셋을 분류하는 경우, 데이터를 학습용과 테스트용으로 나누어 학습과 예측을 수행한 후, 모델의 정확도를 평가합니다. 예를 들어, 학습용 데이터셋에서 95%의 정확도를 보이고, 테스트용 데이터셋에서도 95%의 정확도를 보인다면, 해당 모델의 정확도는 95%입니다. 또는 혼동 행렬을 통해 각 클래스에 대한 정확도와 오분류율 등을 계산할 수도 있습니다.
하지만, 결과값은 항상 모델의 성능, 알고리즘, 하이퍼파라미터 등에 따라 다르므로, 결과값을 평가하기 전에는 모델의 성능을 고려하여 적절한 평가 지표를 선택하고, 데이터셋을 적절하게 분할하여 모델을 학습하고 평가해야 합니다.