데이터셋 종류
훈련
모델을 학습하기 위해 사용되는 데이터셋으로, 모델이 최적화되도록 가중치와 편향을 조정합니다. 이 데이터셋은 일반적으로 모델의 학습에 가장 많은 영향을 미치는 데이터셋입니다.
테스트
모델의 성능을 평가하기 위해 사용되는 데이터셋으로, 학습 데이터셋과 검증 데이터셋과는 별개의 데이터셋입니다. 모델이 새로운 데이터에 대해 얼마나 잘 작동하는지를 측정하기 위해 사용됩니다.
검증
모델 학습 과정에서 과적합(overfitting)을 방지하기 위해 사용되는 데이터셋으로, 학습 데이터셋으로 모델을 학습한 후 검증 데이터셋으로 모델의 성능을 평가합니다. 이를 통해 모델이 학습 데이터셋에만 지나치게 적합하지 않도록 조절할 수 있습니다.
과적합이란?
기계 학습 모델이 학습 데이터셋에 지나치게 적합(fit)되어 새로운 데이터에 대한 일반화(generalization) 성능이 저하되는 현상을 말합니다.
기계 학습 모델이 학습 데이터셋을 과하게 학습하면, 모델은 학습 데이터셋의 노이즈(noise)까지도 학습하여능력이 저하됩니다. 이러한 모델은 학습 데이터셋에 대해서는 매우 정확한 결과를 내지만, 새로운 데이터에 대해서는 예측력이 낮아지는 문제가 발생할 수 있습니다.
그래프로 과적합 확인 방법보기
과적합을 확인하는 가장 일반적인 방법 중 하나는 모델의 학습 데이터셋과 검증 데이터셋의 손실(loss) 값의 변화를 그래프로 나타내는 것입니다. 이 그래프를 학습 곡선(learning curve)이라고 합니다.
아래는 학습 곡선의 예시입니다.
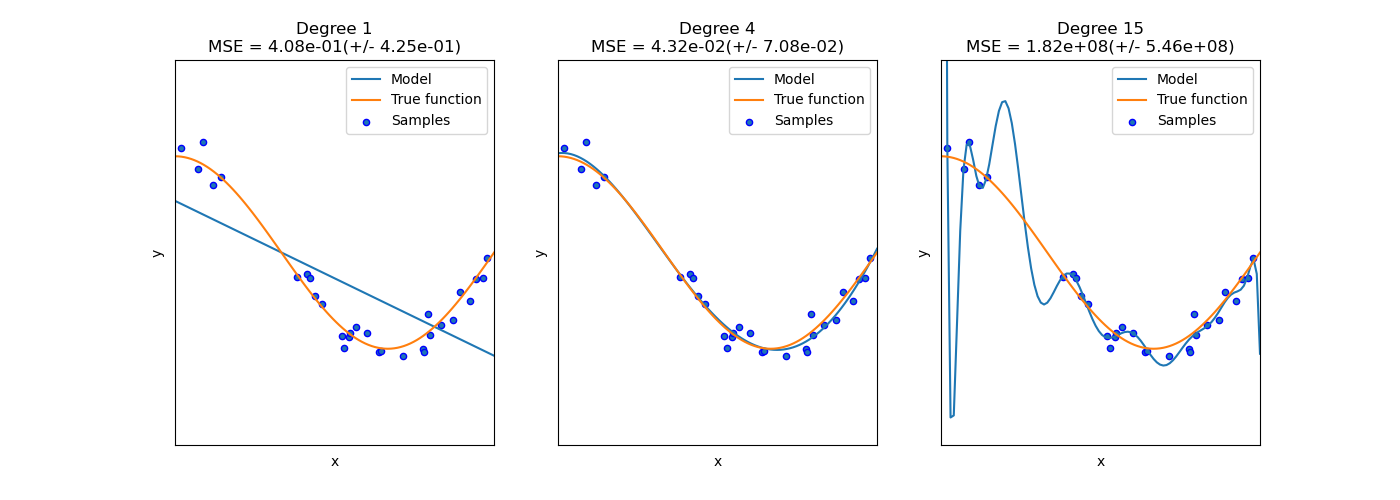
그래프에서 x축은 학습 데이터셋의 크기이고, y축은 손실 값입니다. 빨간색 선은 학습 데이터셋의 손실 값이고, 파란색 선은 검증 데이터셋의 손실 값입니다.
과적합이 일어난 경우, 학습 데이터셋의 손실 값은 점점 낮아지지만, 검증 데이터셋의 손실 값은 일정 수준 이상에서 높아지는 경향이 있습니다. 따라서 학습 데이터셋의 손실 값과 검증 데이터셋의 손실 값이 큰 차이가 나는 경우, 과적합이 일어났다고 판단할 수 있습니다.
그래프를 통해 과적합이 일어나는 시점을 파악하고, 이를 방지하기 위해 모델의 복잡도를 낮추는 등의 조치를 취할 수 있습니다.
과적합 방지로 학습 자동 중단 하는법
과적합 방지를 위한 하나의 방법으로는 조기 종료(early stopping)가 있습니다. 조기 종료란, 모델의 학습을 일찍 중단하여 과적합을 방지하는 방법입니다. 모델의 학습이 일찍 중단되기 때문에, 연산 시간과 리소스를 줄일 수 있습니다.
조기 종료는 검증 데이터셋의 손실 값이 더 이상 개선되지 않을 때 학습을 중단합니다. 검증 데이터셋의 손실 값이 개선되는 동안에는 계속 학습하며, 검증 데이터셋의 손실 값이 개선되지 않는 구간이 일정 기간 이상 지속되면 학습을 중단합니다.
아래는 조기 종료를 구현하는 코드의 예시입니다.
from tensorflow.keras.callbacks import EarlyStopping

# 조기 종료 콜백 함수 생성
early_stop = EarlyStopping(monitor='val_loss', patience=5)

# 모델 학습 시 콜백 함수 적용
history = model.fit(train_x, train_y, epochs=100, batch_size=32,
                    validation_data=(val_x, val_y), callbacks=[early_stop])
위 코드에서 EarlyStopping 클래스를 사용하여 검증 데이터셋의 손실 값(val_loss)을 모니터링하고, 일정 기간동안(patience) 손실 값이 개선되지 않을 경우 학습을 중단합니다.
조기 종료를 통해 모델의 학습을 일찍 중단하여 과적합을 방지하면서도, 모델의 일반화 성능을 유지할 수 있습니다.