이미지 종류 - True color, Grey scale
True color, 또는 24비트 색상,는 빨강, 초록, 파랑 세 가지 색상 채널을 사용하여 모든 색상을 표현합니다. 이 모드에서 각 색상 채널은 8비트로 구성되며, 2의 8승인 256가지 색상 값을 표현할 수 있습니다. 따라서 True color는 총 16,777,216(256의 3승)가지의 색상을 표현할 수 있습니다. 이 모드는 사진 및 그래픽 디자인에서 주로 사용됩니다.
그레이 스케일은 검은색과 흰색을 포함한 회색조의 단일 색상 채널로 구성됩니다. 이 모드에서 각 픽셀은 단일 색상 채널 값으로 나타내어지며, 이 값은 0에서 255 사이의 범위 내에서 표현됩니다. 따라서 그레이 스케일은 256가지 서로 다른 밝기 값을 가질 수 있으며, 흑백 이미지나 그래픽에서 사용됩니다.
Convolution 신경망 (CNN)
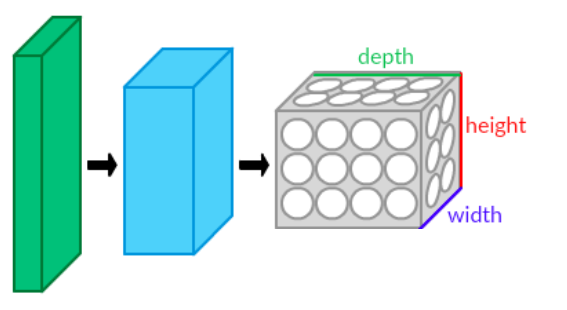
CNN을 사용하는 이유
CNN(Convolutional Neural Network)은 딥러닝의 한 종류로서, 주로 이미지, 음성 및 비디오 데이터와 같은 고차원 입력 데이터를 처리하는 데 사용됩니다. 이 모델은 이미지 인식, 객체 감지, 얼굴 인식 등 다양한 컴퓨터 비전 작업에서 뛰어난 성능을 발휘합니다.
CNN은 입력 데이터의 로컬 패턴을 탐지하기 위해 합성곱(Convolution) 연산을 사용하고, 이를 통해 입력 이미지의 특징 맵(Feature map)을 추출합니다. 이 특징 맵은 풀링(Pooling) 연산을 통해 다운샘플링하여 각 특징의 위치 정보를 줄이고, 네트워크가 복잡한 특징을 학습할 수 있도록 합니다.
CNN은 또한 이미지의 변형(회전, 크기 변경 등)에 대한 불변성(invariance)을 가질 수 있습니다. 예를 들어, CNN은 이미지의 일부가 잘린 경우에도 해당 객체를 인식할 수 있습니다.
CNN에서 convolution layer 동작원리
Convolution 연산은 다음과 같은 단계로 이루어집니다.
- 입력 데이터와 커널 사이에서 element-wise 곱을 수행합니다.
- 곱의 결과를 모두 더합니다.
- 결과값을 특징 맵에 저장합니다.
pooliong layer 동작원리
Pooling layer는 Convolutional Neural Network(CNN)에서 Convolution layer로부터 출력된 Feature map을 다운샘플링(down-sampling)하여 출력 크기를 줄이는 역할을 합니다. 이를 통해 학습 모델의 크기를 줄이고, 불필요한 데이터를 제거하여 연산 속도를 향상시킬 수 있습니다.
Pooling layer에서는 일반적으로 Max pooling과 Average pooling 두 가지 종류가 있습니다. 이 두 종류의 pooling 방법은 각각 다음과 같은 방식으로 동작합니다.
-
Max pooling
Max pooling은 입력 데이터를 일정한 크기의 윈도우(window)로 나누고, 각 윈도우 내에서 가장 큰 값을 선택하여 출력하는 방법입니다. 이를 통해 입력 데이터의 중요한 특징만을 추출하여 출력하는 효과가 있습니다. Max pooling은 주로 이미지 분류나 객체 감지에서 사용되며, 이미지 내에서의 특징 위치의 변화에 대한 불변성을 제공합니다. -
Average pooling
Average pooling은 입력 데이터를 윈도우로 나누고, 각 윈도우 내에서 평균값을 계산하여 출력하는 방법입니다. 이를 통해 입력 데이터의 전반적인 정보를 유지하면서 출력 크기를 줄일 수 있습니다. Average pooling은 주로 CNN에서 Feature map의 차원을 줄이는 용도로 사용됩니다.
flatten 이란?
Flatten은 Convolutional Neural Network(CNN)에서 마지막 Convolution layer나 Pooling layer의 출력을 1차원 배열로 변환하는 연산입니다. 이를 통해 1차원 벡터로 변환된 Feature map을 Fully Connected layer에 입력할 수 있습니다.
CNN 예제 코드 작성 및 첨부
MNIST 숫자 이미지 데이터셋을 사용하여 숫자 분류 문제를 해결하는 모델을 만드는 것을 목표로 합니다.
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers

# 데이터셋 로드
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()

# 이미지 전처리
x_train = x_train.astype("float32") / 255.0
x_test = x_test.astype("float32") / 255.0

# 모델 구성
model = keras.Sequential(
    [
        # Convolution layer 1
        layers.Conv2D(32, kernel_size=(3, 3), activation="relu", input_shape=(28, 28, 1)),
        layers.MaxPooling2D(pool_size=(2, 2)),
        # Convolution layer 2
        layers.Conv2D(64, kernel_size=(3, 3), activation="relu"),
        layers.MaxPooling2D(pool_size=(2, 2)),
        # Flatten
        layers.Flatten(),
        # Fully Connected layer 1
        layers.Dense(128, activation="relu"),
        # Output layer
        layers.Dense(10, activation="softmax"),
    ]
)

# 모델 컴파일
model.compile(loss="sparse_categorical_crossentropy", optimizer="adam", metrics=["accuracy"])

# 모델 학습
model.fit(x_train.reshape(-1, 28, 28, 1), y_train, batch_size=128, epochs=5, validation_split=0.1)

# 모델 평가
model.evaluate(x_test.reshape(-1, 28, 28, 1), y_test)
CNN 활용 예제 조사 및 작성
- 이미지 분류
CIFAR-10: 32x32 크기의 컬러 이미지로 구성된 10개의 클래스를 분류하는 문제
ImageNet: 224x224 크기의 컬러 이미지로 구성된 1,000개의 클래스를 분류하는 문제 - 객체 감지
YOLO (You Only Look Once): 이미지에서 다수의 객체를 탐지하고, 객체의 위치와 크기를 바운딩 박스로 예측하는 딥 러닝 모델
Faster R-CNN (Region-based Convolutional Neural Network): 이미지에서 객체를 탐지하고, 객체의 위치와 크기를 바운딩 박스로 예측하는 딥 러닝 모델 - 음성 인식
WaveNet: 딥 러닝 기반 음성 합성 기술로, 인간의 음성과 유사한 자연스러운 음성을 생성하는 모델
DeepSpeech: 딥 러닝 기반 음성 인식 기술로, 영어 음성 데이터를 텍스트로 변환하는 모델 - 자연어 처리
BERT (Bidirectional Encoder Representations from Transformers): 딥 러닝 기반 자연어 처리 모델로, 언어 모델과 문장 분류 등 다양한 자연어 처리 작업에 활용됩니다.
GPT (Generative Pre-trained Transformer): 딥 러닝 기반 자연어 처리 모델로, 주어진 문맥에서 다음 단어를 예측하고, 문장 생성 등 다양한 자연어 처리 작업에 활용됩니다.