문제 개요
오름차순으로 정렬된 두 개의 연결리스트가 주어졌을 때 이들을 오름차순의 새로운 연결리스트로 합병하는 알고리즘에 대해 구현해보았다.
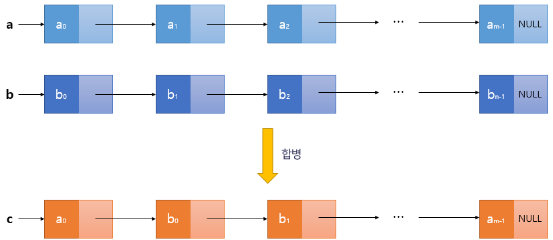
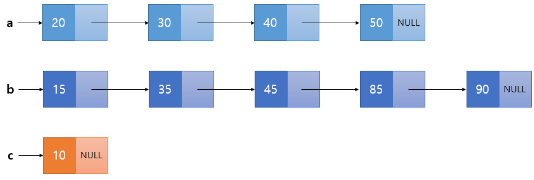
위의 그림에서 볼 수 있듯이, 오름차순으로 정렬된 값을 갖는 각각 m개와 n개의 노드로 구성된 연결리스트 a와 b가 있다. 위 두 연결리스트를 새로운 하나의 연결리스트 c로 합병한다. 이 때 하나로 합병된 연결리스트 c 또한 오름차순으로 값이 정렬될 수 있도록 합병 과정에서 a의 노드 값과 b의 노드 값을 비교하는 과정이 필요하다.
자료구조 및 알고리즘 설계
문제를 해결하기 위해 필요한 자료구조는 크게 두 가지가 있다. 노드에 대해서는 이전 포스트에 기재한 노드의 구조를 그대로 활용하도록 한다.

typedef struct node {
	data, link
} Node
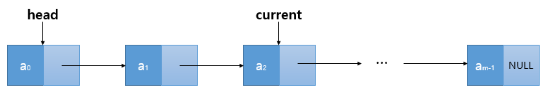
두 번째로는 합병 작업을 진행하는 데 있어 필요한 연결리스트 자체의 구조이다. 각 리스트마다 필요한 헤더 포인터(head)와 원활한 합병 과정 진행을 위한 커렌트 포인터(current)로 이루어져 있다.
typedef struct list {
	head, current
} List
아래의 내용은 알고리즘 설계와 관련한 내용이다.
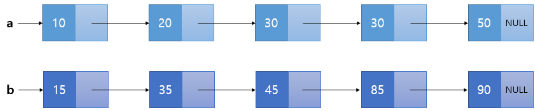
두 개의 연결리스트 a, b를 하나의 연결리스트 c로 합병하기 위해 리스트 a,b의 노드의 값을 비교한다. 위의 그림에서 확인할 수 있듯이 a와 b는 이미 오름차순으로 주어졌기 때문에 각 연결리스트의 헤더 노드부터 비교하기 시작하여 두 값 중에서 작은 값을 c로 넘겨준다.
위의 그림은 첫 번째 합병이 이루어진 후의 모습이다. a의 헤더 값은 10, b의 헤더 값은 15로 a의 헤더 노드의 data 값이 더 작기 때문에 해당 값이 c의 노드로 추가되었음을 볼 수 있다. 또한 합병 과정이 진행되었기 때문에 a의 헤더 노드는 기존의 헤더 노드의 link 부분이 가리켰던 노드를 가리키는 것으로 바뀌었음을 확인할 수 있다.
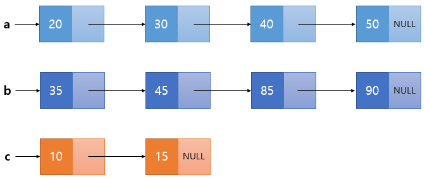
위의 그림은 두 번째 합병이 이루어진 후의 모습이다. a의 헤더 값은 20, b의 헤더 값은 15로 b의 헤더 노드의 data 값이 더 작기 때문에 해당 값이 c의 노드로 추가되었음을 볼 수 있다. 이 때 c의 커렌트 노드의 link가 새로 합병된 노드를 가리키고 있음을 확인할 수 있다. 마찬가지로 합병 과정이 진행되었기 때문에 b이 헤더 노드는 기존의 헤더 노드의 link 부분이 가리켰던 노드를 가리키는 것으로 바뀌었음을 알 수 있다. c의 커렌트 포인터 또한 새로 합병된 노드로 이동하였다. 이러한 과정을 a, b에서 마지막 노드까지 반복하면 오름차순으로 합병된 c를 확인할 수 있다.
아래의 알고리즘은 오름차순으로 정렬된 두 개의 연결리스트가 주어질 경우 이를 합병하기 위한 과정을 가상코드로 기술한 알고리즘이다.
1. Algorithm List_Merge(list_a, list_b, list_c)
2. Input: 오름차순으로 정렬된 두 개의 연결리스트(list_a, list_b)와 위 두 리스트를 오름차순으로 합병할 새로운 연결리스트(list_c)
3. Output: list_a와 list_b를 오름차순으로 합병한 list_c
4. Struct { data, link } Node
5. Struct { head, current } List
6. while (list_a.head != NULL && list_b.head != NULL) do {
7. 	newnode <- memory_alloc(sizeof(Node))
8. 	if (list_c.head = NULL) {
9. 		if (list_a.head.data < list_b.head.data_ {
10.			newnode.data <- list_a.head.data
11.			list_c.head <- newnode
12.			list_c.current <- list_c.head
13.			list_a.head <- list_a.head.link }
14.		else {
15.			newnode.data <- list_b.head.data
16.			list_c.head <- newnode
17.			list_c.current <- list_c.head
18.			list_b.head <- list_b.head.link }
19.	}
20.	else {
21.		if (list_a.head.data < list_b.head.data) {
22.			newnode.data <- list_a.head.data
23.			list_c.current.link <- newnode
24.			list_c.current <- newnode
25.			list_a.head <- list_a.head.link }
26.		else {
27.			newnode.data <- list_b.head.data
28.			list_c.current.link <- newnode
29.			list_c.current <- newnode
30.			list_b.head <- list_b.head.link }
31.	}
32. 	list_c.current.link <- NULL }
33. while (list_a.head != NULL || list_b.head != NULL) do {
34.	newnode <- memory_alloc(sizeof(Node))
35.	if (list_a.head != NULL) {
36.		newnode.data <- list_a.head.data
37.		list_c.current.link <- newnode
38.		list_c.current <- newnode
39.		list_a.head <- list_a.head.link }
40.	else if (list_b.head != NULL) {
41.		newnode.data <- list_b.head.data
42.		list_c.current.link <- newnode
43.		list_c.current <- newnode
44.		list_b.head <- list_b.head.link }
45.	list_c.current.link <- NULL }
알고리즘에서 입력은 main에서 초기화한 단순 연결리스트들이다. list_a와 list_b는 오름차순으로 정렬된 연결리스트이며, list_c는 앞선 두 연결리스트들을 합병할 새로운 연결리스트이다. 출력은 오름차순으로 정렬된 list_c가 된다. 6~32번 줄은 list_a, list_b의 헤더 값이 모두 NULL이 아닐 때 진행되는 합병과 관련된 반복문이다. 가장 먼저 list_c가 초기화 한 상태 그대로일 경우, 헤더 값을 지정해주기 위해 list_a와 list_b의 헤더 노드의 data값들을 비교하여 더 작은 값을 가진 노드를 list_c에 합병한 후 list_c의 헤더 노드이자 커렌트 노드로 지정한다. 이후 동일하게 list_a와 list_b의 헤더 data값 비교 후 더 작은 값을 list_c에 넘겨주고, list_c의 커렌트 노드의 link는 새로 합병된 노드를 가리킬 수 있도록 한다. 그리고 list_c의 커렌터 포인터를 새로운 노드로 이동시킨다. 33~45번 줄은 list_a 또는 list_b의 잔여 항이 남아 있을 경우 이를 list_c로 추가하는 부분이다. 그러면 최종적으로 list_c는 오름차순으로 data 값들이 정렬된다.
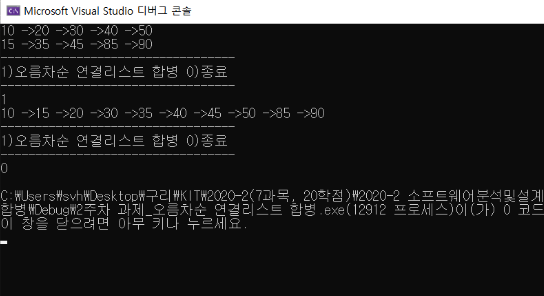
프로그램 구현 및 실행 결과
논의 사항
오름차순의 두 연결리스트를 새로운 연결리스트로, 마찬가지로 오름차순으로 합병하기 위한 알고리즘을 구상해보았다. 반복문을 사용하여 두 개의 오름차순 연결리스트의 헤더 포인터 값을 비교하여 작은 값부터 새로운 연결리스트에 삽입하였다. 삽입 시에는 기존에 동적 할당한 노드를 그대로 가져오는 것이 아닌, data 값만을 가져와서 새로운 할당한 동적 노드의 data에 해당 값을 넣어주었다. 이 과정을 두 연결리스트의 헤더가 모두 NULL이 될 때까지 반복하였고, 연결리스트를 구성하는 노드의 개수에 따라 수행시간은 O(m+n)임을 알 수 있었다.
코드
자세한 코드는 Github에서 확인할 수 있다.