1편에서는 빠른 입력이 누적될수록 스프레이 렌더링 경로의 부담과 프레임 누락이 커지고, 에셋 모션을 꺼도 회복되지 않는다는 사실을 확인했다. 2편에서는 같은 디자인을 유지한 채 렌더링 경로를 세 단계로 바꾸고, 운영 배포 환경에서 Before/After를 비교한다.
결론부터: 같은 화면을 더 적은 작업으로 그렸다
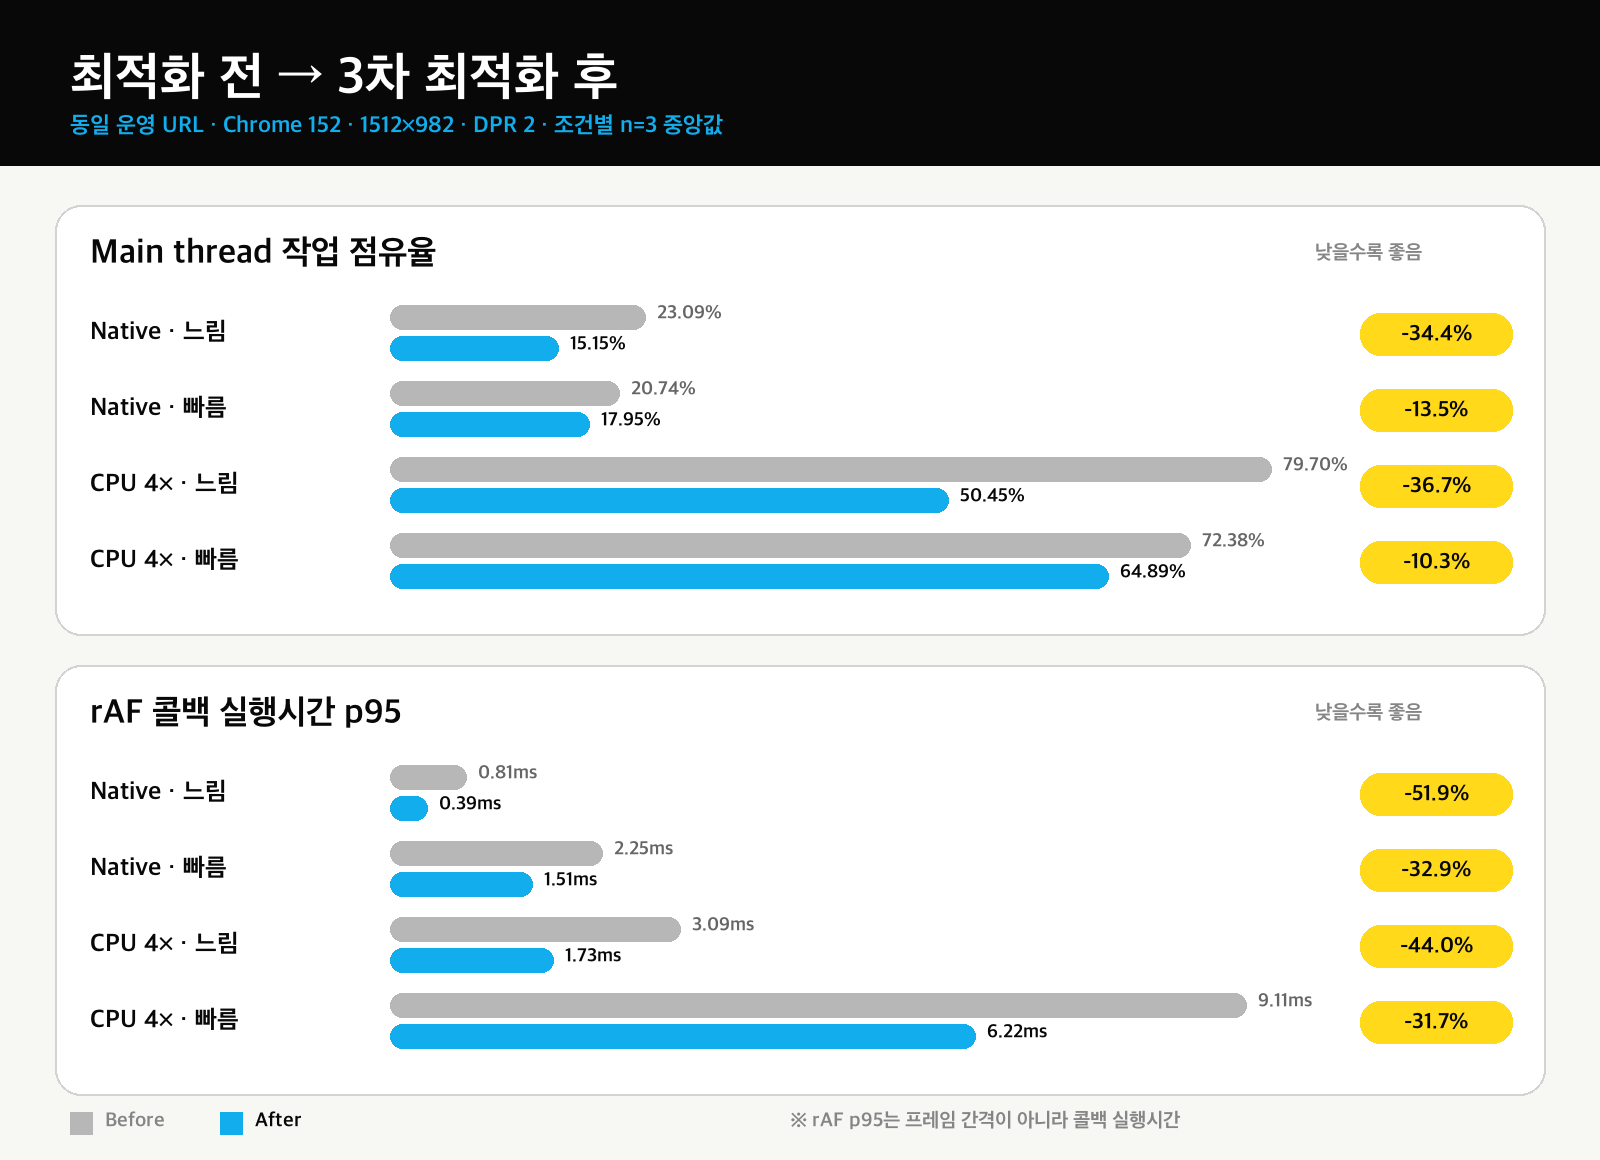
운영 배포 환경의 기준선과 3차 최적화까지 적용한 최종값. 각 조건은 4회 실행 후 첫 실행을 제외한 3회의 중앙값이며, 두 지표 모두 낮을수록 좋다.
| 조건 | Main 작업 점유 | 변화 | rAF 콜백 p95 | 변화 |
|---|---|---|---|---|
| Native · 느린 드래그 | 23.09% → 15.15% | -34.4% | 0.81ms → 0.39ms | -51.9% |
| Native · 빠른 드래그 | 20.74% → 17.95% | -13.5% | 2.25ms → 1.51ms | -32.9% |
| 4× CPU · 느린 드래그 | 79.70% → 50.45% | -36.7% | 3.09ms → 1.73ms | -44.0% |
| 4× CPU · 빠른 드래그 | 72.38% → 64.89% | -10.3% | 9.11ms → 6.22ms | -31.7% |
최종적으로 Main 작업 점유는 조건에 따라 10.3~36.7%, rAF 콜백 p95는 31.7~51.9% 줄었다. 특히 느린 드래그와 정적인 유지 구간에서 개선 폭이 컸다.
단, rAF 콜백 p95는 FPS가 아니라 콜백 한 번의 실행 시간이다. Main 작업 점유도 운영체제의 CPU 사용률이 아니라 trace의 Main thread 작업 비율이다. 숫자의 의미를 넓혀 해석하지 않았다.
먼저 고정한 것: 디자인은 최적화 대상이 아니었다
가장 쉬운 방법은 빠른 입력에서 자국 간격을 넓히거나 입자 수와 잔상 시간을 줄이는 것이다. 하지만 그러면 이미 승인된 스프레이의 인상이 달라진다.
그래서 다음 조건은 끝까지 유지했다.
- 이동 거리 기준의 자국 간격과 입자 밀도
- 거친 질감, 불규칙한 농도와 색상
- 비산 입자와 드립
- 5.4초 유지 + 1.2초 fade, 총 6.6초 수명
- 로고·사자·폭발 에셋 모션
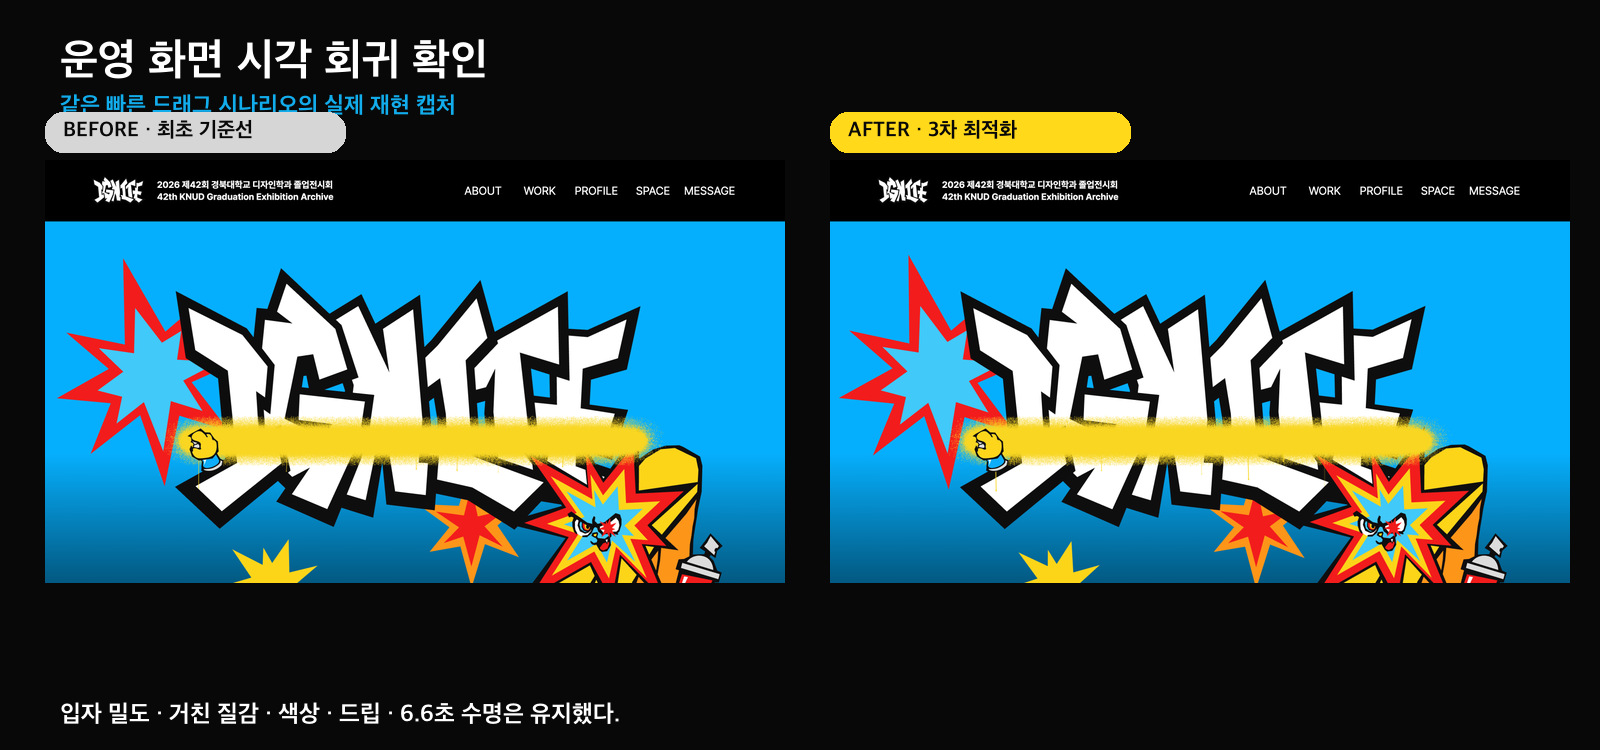
동일한 빠른 드래그 시나리오를 실제 운영 화면에서 재생했다. 최적화 전후에도 입자 밀도·거친 질감·색상·드립·수명을 유지했다.
핵심 질문은 “덜 그려도 비슷하게 보이게 만들 수 있는가?”가 아니라 “같은 결과를 왜 매 프레임 처음부터 다시 계산하고 있는가?”였다.
1차 — Canvas 텍스처를 ImageBitmap으로 승격
기존 구현도 입자 텍스처를 Canvas에 한 번 만들고 재사용하고 있었다. 하지만 매 자국마다 mutable Canvas를 drawImage의 원본으로 계속 사용했다.
1차에서는 초기 생성이 끝난 텍스처를 비동기로 ImageBitmap으로 승격했다.
const canvasTexture = createSprayTexture(seed)
const bitmap = await createImageBitmap(canvasTexture)

// 지원하지 않거나 변환에 실패하면 기존 Canvas를 사용
return bitmap ?? canvasTexture- 승격은 텍스처마다 한 번만 수행
- 준비 전·실패 환경은 기존 Canvas fallback
- 해제 시 ImageBitmap.close()와 Canvas 버퍼 정리
- 동일 seed, 500개 자국, DPR 2 조건에서 RGBA diff 0 확인
격리된 preview 실험에서 느린 드래그의 Main RunTask는 11.6%, rAF p95는 30.9% 줄었고 Canvas Snapshot은 83,473회에서 30회로 감소했다. 하지만 빠른 드래그의 프레임 회복은 충분하지 않았다.
즉 텍스처 원본의 형태는 개선했지만, 살아 있는 모든 자국을 매 프레임 다시 순회하고 합성하는 구조는 그대로였다.
2차 — 안정된 자국 32개를 한 번 합성해 재사용
두 번째로 자국의 생명주기를 이용했다. 생성 직후부터 fade 전까지는 대부분 픽셀이 변하지 않는다. 드립도 없고 불투명한 자국이라면 매 프레임 32번 drawImage 할 이유가 없다.
연속된 32개 자국이 모두 안정 상태일 때만 하나의 offscreen surface로 묶었다.
if (group.every(stamp => stamp.isOpaque && !stamp.hasDrip)) {
  drawCachedGroup(group)
} else {
  releaseGroup(group)
  drawStampsIndividually(group)
}
fade나 드립이 시작되면 즉시 캐시를 해제하고 기존 개별 렌더링으로 돌아간다. 그리기 순서와 겹침을 보존했고, 캐시는 16MiB 픽셀 예산과 4096px 최대 변을 넘지 않도록 제한했다.
고정 fixture에서는 192개 자국이 다음 프레임부터 6개의 캐시 surface로 그려졌고 재합성은 0회였다. 1·2차 누적 운영 측정에서는 Canvas Snapshot이 조건별로 다음과 같이 줄었다.
| 조건 | 기준선 | 2차 누적 | 변화 |
|---|---|---|---|
| Native · 느린 드래그 | 83,185 | 2,024 | -97.6% |
| Native · 빠른 드래그 | 134,329 | 2,403 | -98.2% |
| 4× CPU · 느린 드래그 | 82,716 | 2,117 | -97.4% |
| 4× CPU · 빠른 드래그 | 139,266 | 2,247 | -98.4% |
이 값은 1·2차 누적 결과이므로 2차만의 기여도로 해석하지 않았다. 또한 8-bit 중간 surface 합성 때문에 RGBA가 완전히 동일하지는 않았다. 기록된 비교에서 평균 채널 오차는 약 0.135/255 이하, 최대는 약 4.6/255 이하였고 실제 디자인 QA에서 차이를 발견하지 못해 채택했다.
3차 — 픽셀이 변하지 않으면 rAF를 멈췄다
그룹 캐시를 적용해도 renderer는 화면이 그대로인 5.4초 유지 구간에서 requestAnimationFrame을 계속 호출했다. 그릴 결과가 바뀌지 않는데도 루프는 깨어 있었다.
마지막 단계에서는 “매 프레임 실행”을 기본값으로 두지 않고 다음 변화 시점에만 renderer를 깨웠다.
- 새 포인터 입력이 들어온다.
- 드립이 성장한다.
- fade가 진행된다.
- resize, visibility, reduced-motion 상태가 바뀐다.
그 외의 불투명 유지 구간에는 가장 이른 드립·fade 시점까지 timer로 잠들고, 변화가 시작되면 rAF를 다시 연결한다. 모든 자국이 만료되면 다시 멈춘다.
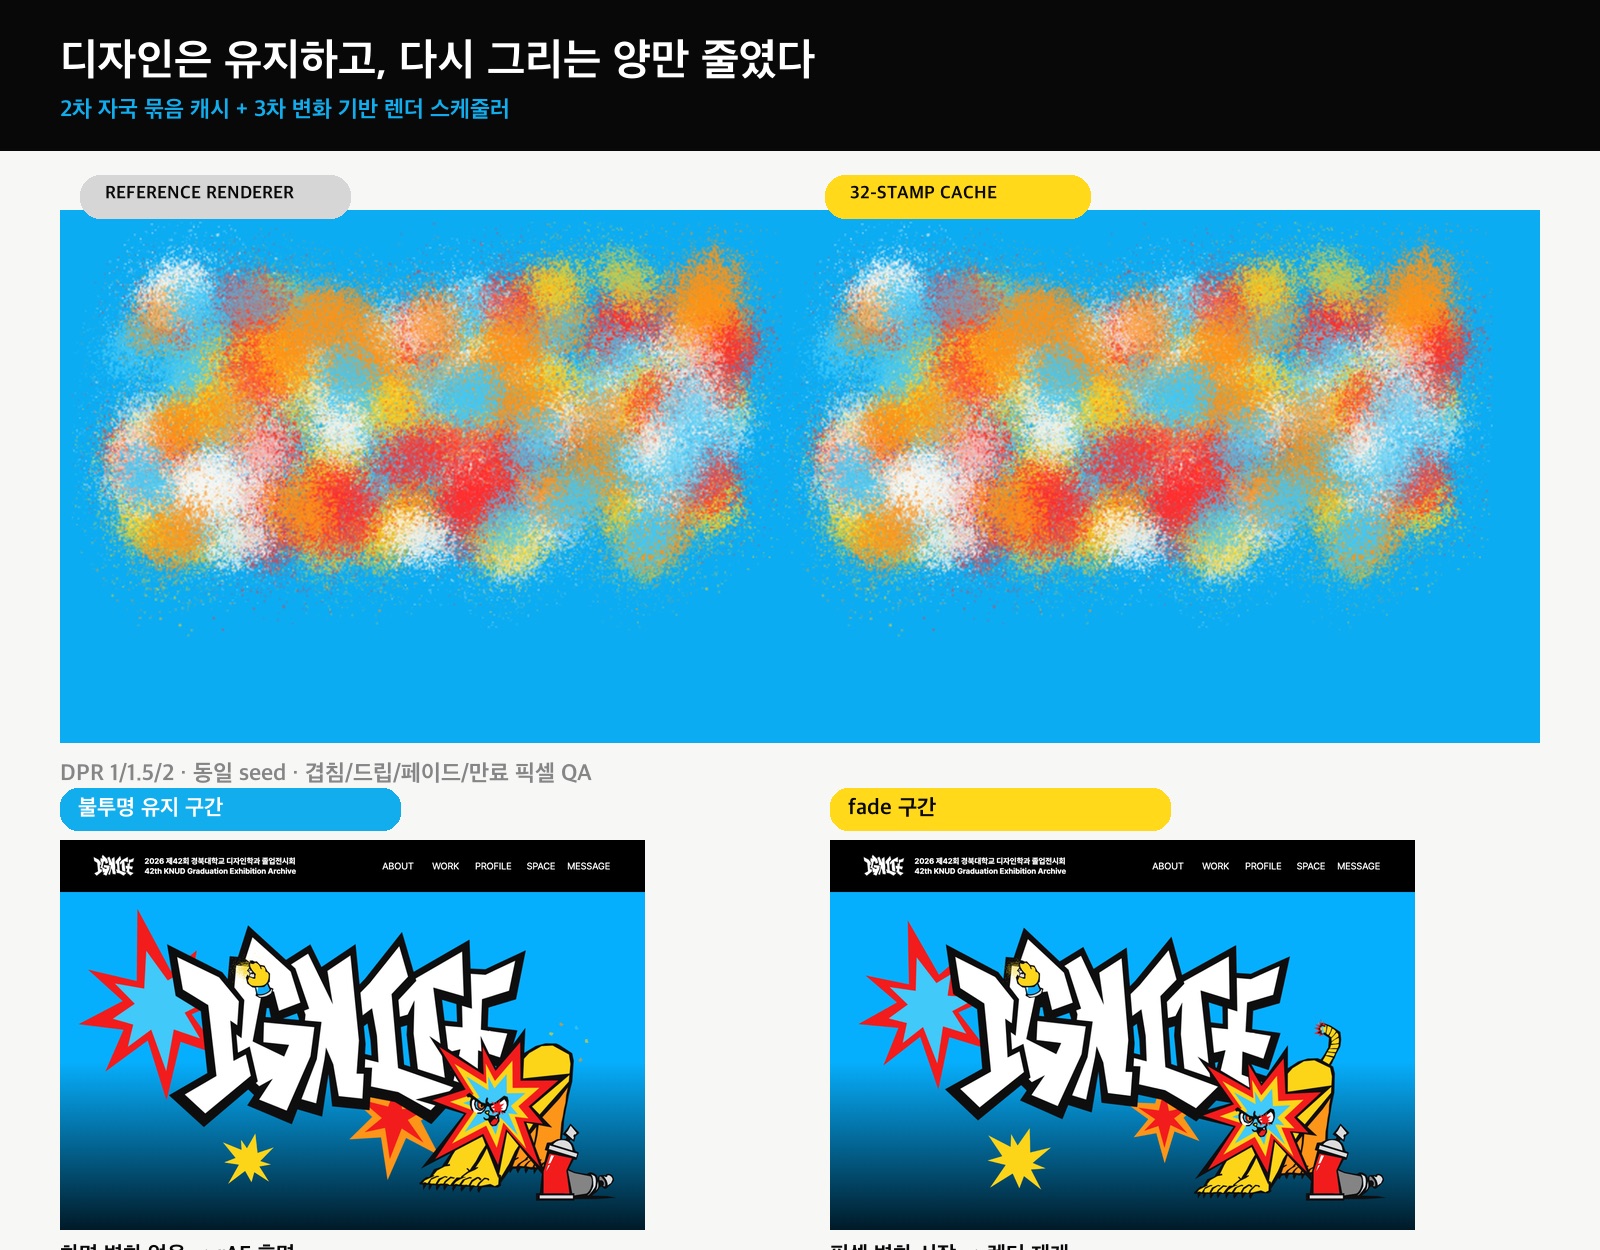
위: 참조 renderer와 32-stamp 캐시 결과 비교. 아래: 짧은 입력 후 유지 구간에는 rAF가 0회이고, fade가 시작될 때만 다시 실행되는 상태를 실제 화면과 로그로 확인했다.
짧은 자국 하나로 상태 전이를 검증했을 때 결과는 명확했다.
| 구간 | render callback |
|---|---|
| 0.2~5.2초 · 불투명 유지 | 0회 |
| 약 5.3~6.75초 · fade | 156~158회 |
| 만료 후 | 0회 |
3차만의 효과를 보기 위해 2차 누적 배포와도 비교했다.
| 조건 | Main 작업 점유 변화 | render callback 수 | rAF p95 |
|---|---|---|---|
| Native · 느린 드래그 | -10.6% | -9.8% | 0.39ms → 0.39ms |
| Native · 빠른 드래그 | -5.2% | -5.4% | -1.3% |
| 4× CPU · 느린 드래그 | -18.5% | -8.4% | -8.9% |
| 4× CPU · 빠른 드래그 | -0.2% | -3.7% | +0.2% |
예상대로 idle 비중이 큰 느린 드래그에서 효과가 컸다. 반면 4× CPU 빠른 드래그에서는 새 입력과 drip·fade가 계속 존재해 renderer가 잠들 수 없었고, 3차의 추가 개선은 사실상 없었다.
같은 운영 환경에서 다시 측정했다
최적화 후보마다 preview에서 기능·픽셀 비교를 통과시킨 뒤 별도 브랜치와 PR로 기록하고, main에 병합해 운영 배포한 다음 다시 측정했다.
- 대상: KNUD 실제 운영 사이트
- 기기: Apple M3, 24GB / macOS 14.6
- 브라우저: Chrome 152.0.7977.83, ANGLE Metal
- viewport 1512×982, DPR 2
- 느린 드래그: 10초 동안 5회 왕복
- 빠른 드래그: 10초 동안 20회 왕복
- 입력 종료 후 8초 관찰
- Native와 4× CPU 감속, 각 4회 실행 후 warm-up 1회 제외
AI Agent는 정해진 좌표와 예정 시각을 브라우저 입력으로 재생하고 trace를 저장했다. 결과를 그대로 믿지는 않았다. 배포 asset SHA, trace data loss, focus·visibility, 페이지 오류, 입력 전송 지연과 실제 pointer event를 함께 검사해 조건을 벗어난 실행을 제외했다.
구현 기록은 다음 PR에 분리했다.
무엇이 좋아졌고, 무엇이 남았나
이번 최적화의 결과는 “Canvas가 빨라졌다” 한 문장보다 세 가지로 정리하는 편이 정확하다.
- ImageBitmap으로 텍스처 재사용 경로를 단순화했다.
- 안정된 자국의 반복 합성을 32개 단위 결과 재사용으로 바꿨다.
- 픽셀이 변하지 않는 시간에는 렌더 루프 자체를 멈췄다.
그 결과 디자인을 줄이지 않고도 네 조건 모두에서 rAF p95가 31% 이상 감소했고, 느린 입력에서는 Main 작업 점유도 약 34~37% 줄었다.
다만 4× CPU 빠른 드래그의 Main 점유는 64.89%, rAF p95는 6.22ms로 여전히 가장 무거운 조건이다. 계속 생성되는 자국과 동시에 진행되는 drip·fade 때문에 캐시와 sleep이 제한된다. 이 조건까지 큰 폭으로 줄이려면 자국 간격이나 입자 수처럼 시각 결과에 영향을 주는 정책, 또는 더 큰 렌더링 구조 변경이 필요하다.
이번 범위에서는 숫자를 위해 디자인을 바꾸지 않았다. 승인된 경험을 지키면서 반복 합성과 불필요한 실행을 제거했고, 개선이 작아지는 경계까지 같은 조건으로 확인한 지점에서 마무리했다.
마무리
처음에는 입자가 많아서 느린 문제라고 생각했다. 실제 병목은 입자 수 하나가 아니라 같은 픽셀을 다시 합성하고, 변하지 않는 시간에도 루프를 유지하는 방식에 있었다.
1편에서 재현 가능한 문제와 검증 가능한 기준선을 만들었기 때문에, 2편에서는 후보를 하나씩 배포하며 결과를 비교할 수 있었다. 최적화는 기법의 이름보다 무엇을 보존하고, 어떤 비용을 없앴으며, 어디까지 개선되지 않았는지를 설명할 수 있어야 했다.
References