로깅(Loggin)이란?
로깅을 어디에 어떻게 남겨야하는지를 알기 위해 "로깅"의 의미를 이해해야한다고 생각합니다. 제가 이해한 로깅은 다음과 같습니다.
- 애플리케이션에서 발생하는 특정 이슈들을 기록해 놓는것
- 개발이나 운영환경에서 발생하는 문제점을 추적하는것
- 운영서버(혹은 개발서버 등)의 상태를 모니터링하기 위해 작성하는 코드
로그를 남겨야하는 이유
- 운영서버나 개발서버에서 디버깅을 할 수 있는 강력한 도구이기 때문입니다.
- 운영중인 웹 애플리케이션에서 문제가 발생했을 경우, 그 문제의 원인을 파악하려면 문제가 발생한 상황의 정보가 필요합니다.
- 즉 예외가 발생하거나, 핵심 비즈니스 로직이 실행되는 부분에 로그를 적절하게 남겨야합니다.
- 로깅을 통해 우리 애플리케이션에 문제가 발생했을때 빠르고 효율적으로 해결할 수 있을 것입니다.
로깅 코드 작성
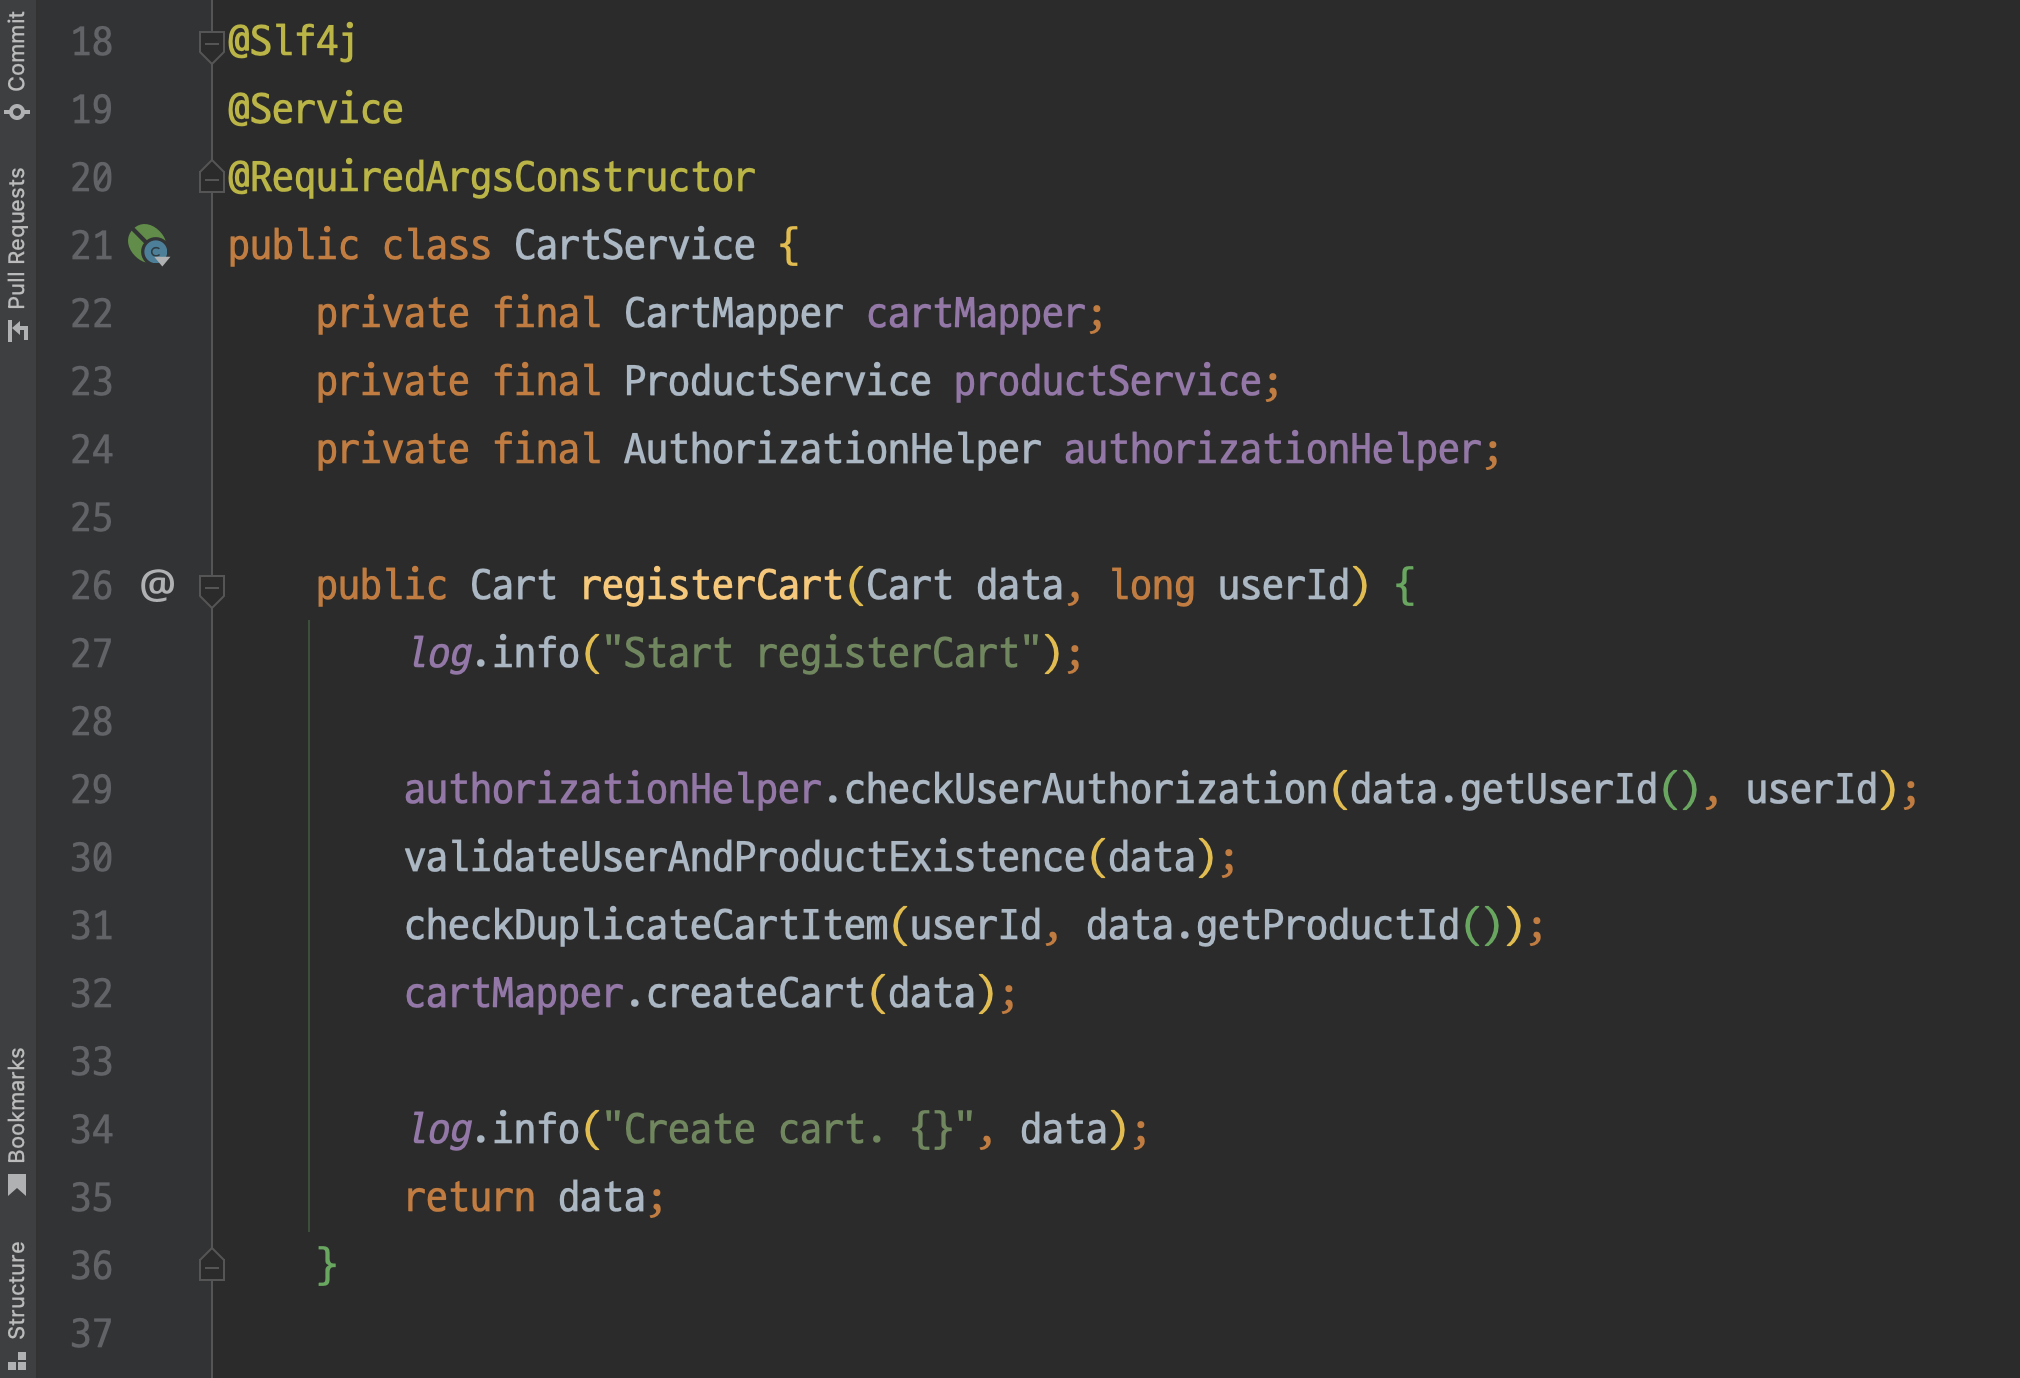
롬복의 @Slf4j 어노테이션을 사용하여 로그를 남겼습니다.
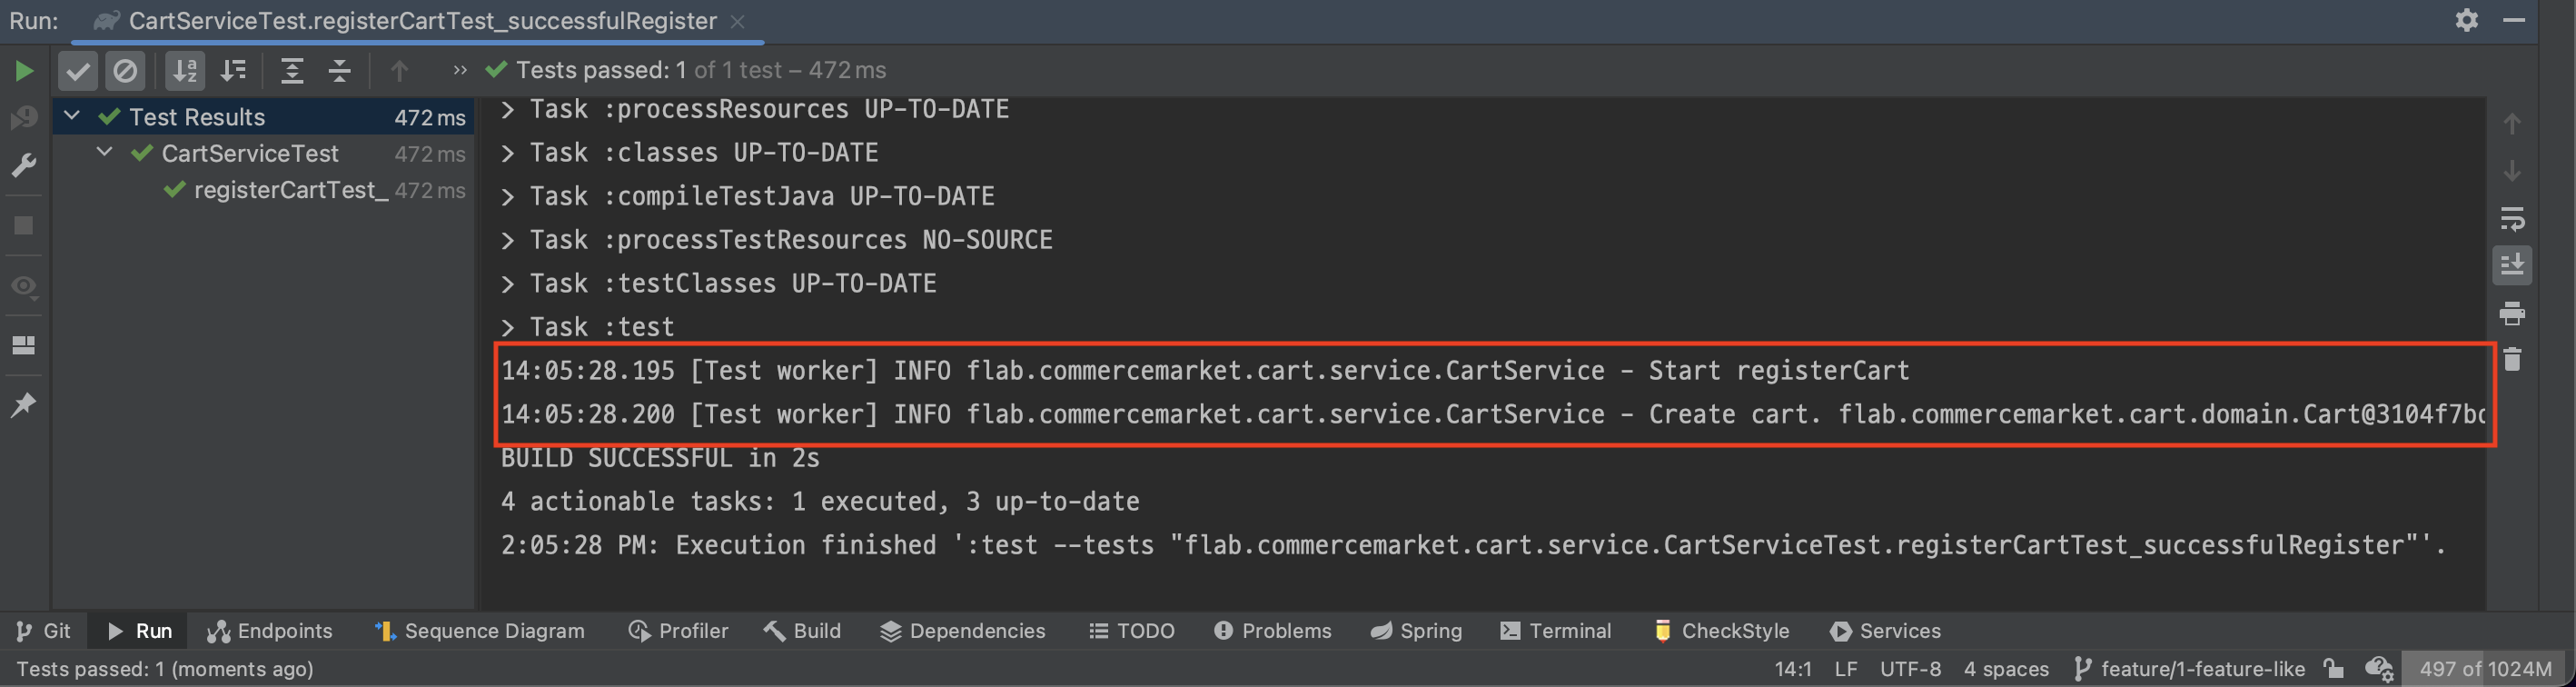
이전에 작성해 놓은 테스트케이스를 실행시키면 로그가 잘 출력됩니다.
    @Test
    @DisplayName("상품 등록")
    public void registerProductTest() throws Exception {
        // given
        Product product = makeProductFixture(1);

        // when
        Product registerProduct = productService.registerProduct(product);

        // then
        assertThat(registerProduct).isNotNull();
        assertThat(product.getName()).isEqualTo(registerProduct.getName());
        assertThat(product.getPrice()).isEqualTo(registerProduct.getPrice());
        assertThat(product.getImageUrl()).isEqualTo(registerProduct.getImageUrl());
        assertThat(product.getDescription()).isEqualTo(registerProduct.getDescription());
        assertThat(product.getStockAmount()).isEqualTo(registerProduct.getStockAmount());

        verify(productMapper).insertProduct(product);
    }
System.out.println을 사용하면 안되는 이유
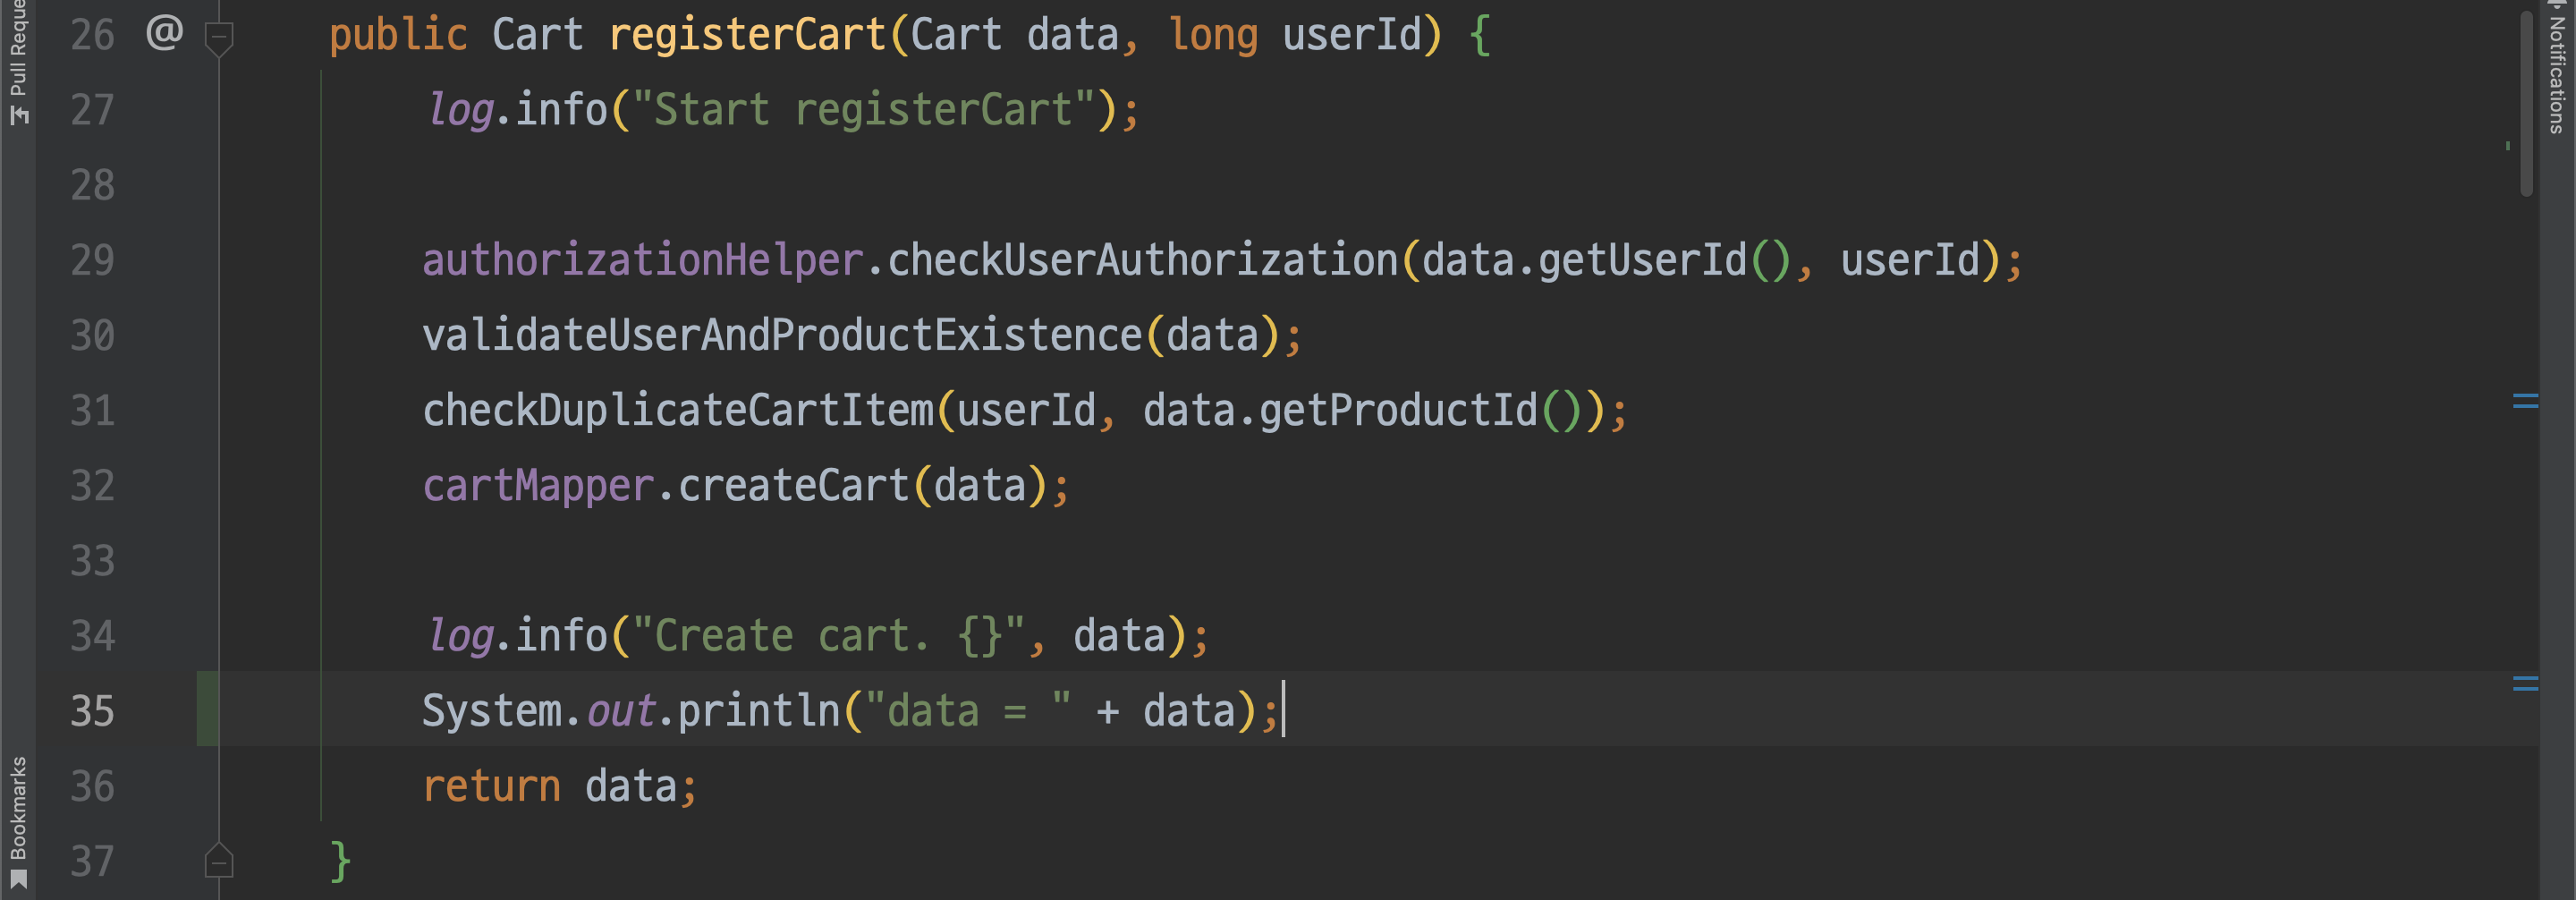
1. System.out.println()은 디버깅을 위한 충분한 정보를 담지 못한다.
로그는 메서드가 호출된 시간, 워커스레드, 로그레벨 등 여러가지 정보를 담아 출력한다.
14:15:02.329 [Test worker] INFO flab.commercemarket.cart.service.CartService - Create cart. flab.commercemarket.cart.domain.Cart@3104f7bd
System.out.println()은 객체에 대한 정보만 출력한다.
data = flab.commercemarket.cart.domain.Cart@3104f7bd
2. System.out.println()은 성능이슈가 발생할 수 있다.
public void println() {
    newLine();
}


private void newLine() {
    try {
        synchronized (this) {
            ensureOpen();
            textOut.newLine();
            textOut.flushBuffer();
            charOut.flushBuffer();
            if (autoFlush)
                out.flush();
        }
    }
    catch (InterruptedIOException x) {
        Thread.currentThread().interrupt();
    }
    catch (IOException x) {
        trouble = true;
    }
}
println() 내부에는 synchronized 키워드가 존재합니다. 우리가 개발하고 있는 웹애플리케이션은 항상 멀티스레드 환경에서 동작합니다. 즉, println() 을 사용하면 멀티스레드 환경에서 해당 메서드를 처리하는 동안 다른 스레드에 블록이 걸리고 애플리케이션 성능 저하의 원인으로 이어질 수 있습니다.
SLF4J에 적용된 디자인 패턴
로깅에 사용되는 SLF4J는 Simple Logging Facade for Java의 약자입니다. "자바에서 간단하게 사용하는 로깅 퍼사드" 정도로 번역할 수 있을까요?
로깅을 사용할 때 퍼사드를 사용한다는 의미인것 같은데, 먼저 퍼사드(Facade)가 무슨뜻인지부터 이해해야 할 것 같습니다.
퍼사드패턴이란?
퍼사드 패턴의 정의는 다음과 같습니다.
퍼사드 패턴은 "건물의 정면"을 의미하는 단어로 어떤 소프트웨어의 다른 커다란 코드 부분에 대하여 간략화된 인터페이스를 제공해주는 디자인 패턴을 의미합니다. (이후생략)
저는 퍼사드 패턴을 다음과 같이 이해했습니다.
- 구체적인 구현을 감추고 단순한 메서드를 제공하는것
- 내부 시스템의 복잡도를 감추고 단순한 메서드만 제공하는것
- 즉 거대한 코드덩어리를 감추고 간단한 인터페이스만 제공하여 모듈을 추상화 하는것
SLF4J의 구현체는 logback과 log4j
SLF4J는 "로깅 인터페이스"입니다. 인터페이스에서 구체적인 기능을 제공할 수 있을까요? default 메서드를 사용하면 불가능하진 않겠지만, 굳이 default 메서드까지 사용해가며 구현할 필요는 없을것 같습니다.
SLF4J는 인터페이스입니다. 즉 SLF4J 자체로는 로깅 기능을 제공하지 않습니다. 이를 위해 SLF4J를 구현한 여러가지 구현체가 존재합니다. 다시말해 실제로 로깅 작업을 처리하는 구체적인 구현이 담긴 어떤 클래스들을 제공하는 것입니다.
그중에서 가장 대표적인 구현체는 logback과 log4j입니다. 최근에는 여러가지 이유로 logback을 사용하는 것이 일반적이라고 합니다.
스프링에서 제공하는 SLF4J
스프링부트는 기본적으로 SLF4J를 제공합니다. 또한 logback 구현체를 사용하여 로그기능을 제공합니다. 따라서 스프링부트를 사용한다면 별도의 의존성을 추가하지 않아도 자체적으로 SLF4J를 사용하여 로깅을 처리할 수 있습니다.
이외에도 SLF4J는 다른 로깅 시스템과의 연결을 지원하기 때문에 요구사항에 맞는 구현체를 사용할 수 있습니다.
추상화를 통해 얻을수 있는 장점은?
지금까지 내용을 정리해보겠습니다.
- SLF4J는 퍼사드 패턴을 적용하여 추상화된 인터페이스를 제공한다.
- 로깅 기능을 구현한 다양한 구현체가 존재한다.
- 최근에는
logback을 주로 사용하는 추세이며, 스프링 프레임워크에서 기본적으로 제공하는 구현체 역시logback이다.
그런데 구체클래스인 logback을 직접 사용하면 안되는 것일까요?
스택오버플로우에서는 "이론적으로 logback API를 직접 사용할수는 있지만 권장되는 방법이 아니다."라고 설명합니다.
Logback natively implements the SLF4J API. This means that if you are using logback, you are actually using the SLF4J API. You could theoretically use the internals of the logback API directly for logging, but that is highly discouraged. All logback documentation and examples on loggers are written in terms of the SLF4J API.
이렇게 퍼사드 패턴을 사용하여 내부 구현을 숨기고 추상화된 인터페이스를 사용하면 얻을 수 있는 이점은 무엇일까요? 뻔한 이야기이지만 특정 프레임워크나 라이브러리에 의존하지 않아도 된다는 것입니다.
과거 log4j에 보안 취약점이 발견 된 적이 있었습니다. 그래서 당시 어떤 회사에서는 개발자들에게 현재 사용하고 있는 Log4j를 걷어내고 logback으로 교체하는 업무를 부여했다고 가정해보겠습니다.
그 과정은 아래와 같을 것입니다.
빌드툴에서 Log4j의 의존성을 삭제하고, 이후 logback의존성을 추가하고, 코드에 import된 log4j를 제거하고 다시 logback을 import하고 logback 구현체에 맞는 메서드를 사용하도록 변경하고... 자세히는 모르겠지만 상당히 번거로운 일이 될것 같습니다.
그런데 log4j와 logback의 기능을 추상화 시킨 SLF4J를 사용한다면 어떨까요? 이런 비생산적인 일을 하지 않아도 될 것 입니다. 이미 만들어진 API만 잘 찾아서 넣어주기만 하면 같은 코드로 여러가지 구현체를 골라 사용할수 있을 것입니다. 즉, SLF4J를 사용함으로써 특정 라이브러리에 종속적일 필요가 없게 되는 것입니다.
logback 로그 레벨
로그와 관련된 레퍼런스를 찾아보면서 대부분의 문서에서 info 레벨을 가장 자주 사용하는것 같았습니다. 다른 사람들이 많이 사용하는 방법을 그냥 따라하는것도 나쁘지만은 않지만, 이유를 알고 사용하는것과 모르고 사용하는것에는 많은 차이가 있다고 생각합니다.
어떤 로그레벨을 사용해야할까?
로깅을 사용할때 고려해야하는 것은 성능, 간결성, 설명가능성의 균형을 지키는것이라고 합니다.
모든 로직에 대한 기록을 상세하게 로그로 남겨놓으면 설명가능성은 높아지겠지만 성능과 간결성은 낮아지겠죠. 반대로 너무 적은 로그정보를 기록하면 간결성은 높아지겠지만 설명가능성이 낮아질 것입니다. 어렵네요 ㅎㅎ
이런 문제를 해결하기 위해 사용하는 것이 로그 레벨이고 대부분의 경우 아래와 같은 규칙을 따른다고 합니다.
error: 시스템에 문제가 있고 사용자들이 영향을 받고 있거나 수정 작업에 개발자의 개입이 필요한 경우. 이때 2AM 규칙이 적용된다. 만약 새벽 2시에 깨어나서 이 문제를 해결해야할 정도로 심각하다면 이를 error로 기록하고 적절한 조치를 취해야 한다.
warn: 예상치 못한 기술적 이벤트가 발생한 상황이다. 사용자들이 영향을 받을 수 있지만 즉각적으로 대응이 필요한 상황은 아니다. 하지만 개발자들은 이 문제를 가능한 빨리 검토하여 대응해야한다. 즉, 즉시 개입할 필요는 없지만 추적이 필요한 모든 문제들을 나타낸다.
info: 문제를 분석해야 할 때 확인하고자 하는 정보를 기록한다. 시스템 생명주기(시스템 시작, 종료 등), 세션(로그인, 로그아웃), 데이터베이스나 API 호출, 비즈니스로직에서 발생하는 예외사항 등을 기록한다. 해당 로그 정보를 이벤트들을 기록하고 모니터링하여 운영 환경에서 적절한 문제 대응을 할 수 있다.
debug: info 수준에 포함되지 않는 대부분의 사항들을 포함시킨다. 주로 개발 및 QA 단계에서 시스템의 흐름을 추적하는 메세지들이다. 복잡한 메서드의 진입/종료와 메서드 내부에서 중요한 이벤트나 결정 지점을 표시하는데 해당 레벨을 사용한다.
trace: 거의 사용하지 않는다. 일반적인 개발중에는 활성화하지 않고 특정한 문제 해결이나 성능 분석 등에 사용한다. 예를들면, 볼륨이 큰 루프에서 상태를 기록하거나 전테 객체 계등을 로그로 남기는 경우이다.
해당 내용은 스택오버플로우를 참고하여 작성한 내용입니다.