해당 스터디는
데이터 중심 애플리케이션 설계 (Designing Data-Intensive Applications)
https://www.wikibook.co.kr/data-intensive/
를 기반으로 진행한 내용입니다.
DDIA 2주차 - 02장. 데이터 모델과 질의 언어
1. 데이터 모델은 왜 중요한가
데이터 모델은 소프트웨어가 어떻게 작성됐는지뿐만 아니라, 해결하려는 문제를 어떻게 생각해야 하는지에도 지대한 영향을 미친다.
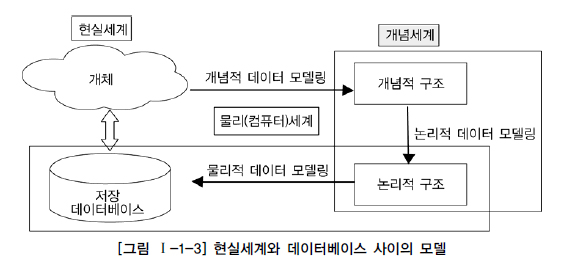
대부분의 애플리케이션은 하나의 데이터 모델 위에 다른 데이터 모델을 계층으로 쌓아 만든다.
-
애플리케이션 개발자: 현실(사람, 조직, 상품, 행동, 자금 흐름, 센서)을 객체나 데이터 구조로 모델링한다. 보통 애플리케이션에 특화돼 있다
-
저장 계층: 그 데이터 구조를 JSON/XML 문서, 관계형 테이블, 그래프 같은 범용 데이터 모델로 표현한다
-
DB 엔지니어: 그것을 메모리, 디스크, 네트워크 상의 바이트 단위로 표현하는 방법을 결정한다
-
하드웨어 엔지니어: 전류, 빛의 파동, 자기장으로 바이트를 표현한다
각 계층은 명확한 데이터 모델을 제공해 하위 계층의 복잡성을 숨긴다. 이 추상화 덕분에 DB 벤더의 엔지니어와 애플리케이션 개발자처럼 서로 다른 그룹이 효율적으로 함께 일할 수 있다.
그리고 각 데이터 모델은 사용 방법에 대한 가정을 담고 있다. 어떤 사용법은 쉽고 어떤 동작은 아예 지원하지 않으며, 어떤 연산은 빠르지만 어떤 연산은 매우 느리다.
2. 관계형 모델과 문서 모델
2-1. 관계형 모델의 역사와 NoSQL
-
1970년 Edgar Codd가 관계형 모델을 제안했다.
-
데이터는 관계(relation, SQL의 Table)로 구성되고, 관계는 순서 없는 튜플(tuple, SQL의 Row) 모음이다.
-
당시엔 효율적 구현이 가능하냐는 의문이 많았지만, 1980년대 중반 RDBMS와 SQL이 정규화된 구조로 데이터를 저장하고 질의할 필요가 있는 사람들 대부분이 선택하는 도구가 됐다
-
관계형 데이터베이스의 우위는 약 25~30년간 지속됐다
경쟁자들은 모두 밀려났다.
| 시기 | 경쟁 모델 | 결과 |
|---|---|---|
| 1970~80년대 초 | 네트워크 모델, 계층 모델 | 관계형 모델이 우위를 차지 |
| 1980년대 후반~90년대 초 | 객체 데이터베이스 | 나타났다가 사라짐 |
| 2000년대 초반 | XML 데이터베이스 | 매우 적게 채택됨 |
관계형 DB는 본래 영역(비즈니스 데이터 처리)을 넘어 폭넓게 보편화됐다.
온라인 게시물, 토론, 소셜 네트워크, 전자 상거래, 게임, SaaS 생산성 애플리케이션 등 오늘날 웹에서 볼 수 있는 대부분의 서비스가 여전히 관계형 DB로 제공된다.
NoSQL
2010년대의 NoSQL은 관계형 모델의 우위를 뒤집으려는 가장 최신 시도다.
원래 NoSQL은 특정 기술을 가리키는 이름이 아니었고, 이후 Not Only SQL로 재해석됐다.
-
확장성: 대규모 데이터셋이나 매우 높은 쓰기 처리량을 관계형 DB보다 쉽게 달성할 필요
-
오픈소스 선호: 상용 DB 제품보다 무료 오픈소스 소프트웨어에 대한 선호도 확산
-
특수 질의 동작: 관계형 모델에서 지원하지 않는 질의
-
표현력: 관계형 스키마의 제한에 대한 불만과 더 동적이고 표현력 풍부한 데이터 모델에 대한 바람
어플리케이션은 저마다 요구사항이 다르므로, 각 상황에 맞는 최적의 기술을 선택하여야한다.
가까운 미래에 관계형 DB는 다양한 비관계형 데이터스토어와 함께 사용될 것이며, 이를 다중 저장소 지속성이라 한다.
2-2. 객체 관계형 불일치
오늘날 대부분의 애플리케이션은 객체지향 언어로 개발한다. 그런데 데이터를 관계형 테이블에 저장하려면 애플리케이션 코드와 DB 모델 객체(테이블, 로우, 칼럼) 사이에 거추장스러운 전환 계층이 필요하다.
이 분리를 임피던스 불일치(impedance mismatch)라 부른다.
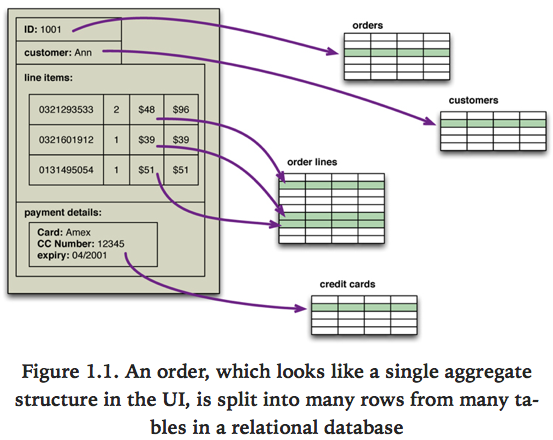
ActiveRecord나 Hibernate 같은 ORM은 전환 계층에 필요한 상용구 코드의 양을 줄이지만, 두 모델 간의 차이를 완벽히 숨길 수 없다.
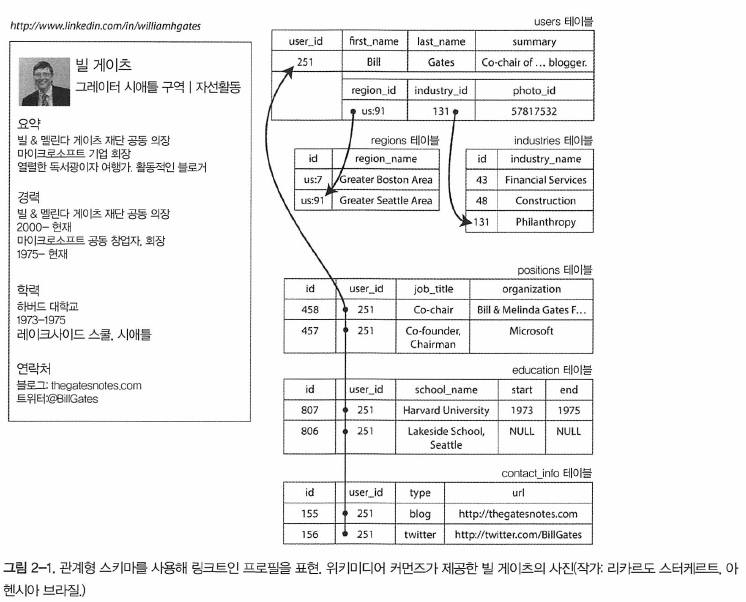
책은 링크트인 이력서를 예로 든다. first_name, last_name은 사용자당 하나씩이라 users 테이블 칼럼으로 충분하다. 하지만 경력, 학력, 연락처는 사용자와 일대다 관계다.
일대다를 표현하는 세 가지 방법
-
정규화 (SQL:1999 이전의 일반적 방식): 직위, 학력, 연락처를 개별 테이블에 넣고 외래 키로
users를 참조한다 -
구조화된 데이터타입 / XML, JSON 칼럼: SQL 표준의 마지막 버전이 추가한 방식.
단일 로우에 다중 값을 저장하고 문서 내 질의와 색인이 가능하다. -
텍스트 칼럼에 통째로 저장: JSON/XML로 부호화해 넣고 애플리케이션이 구조와 내용을 해석한다. 해당 방식은 일반적으로 부호화된 칼럼의 값을 DB로 질의할 수 없다
2-3. 일대다 관계와 문서 모델의 지역성
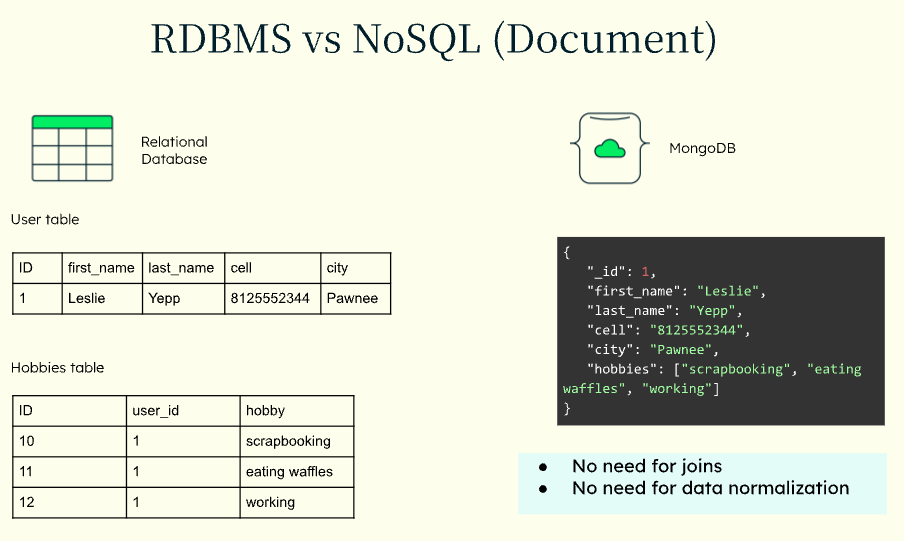
이력서처럼 모든 내용을 갖추고 있는 데이터 구조는 JSON 표현에 매우 적합하다.
MongoDB, RethinkDB, CouchDB, Espresso 같은 문서 지향 DB가 JSON 데이터 모델을 지원한다.
{
  "user_id": 251,
  "first_name": "Bill",
  "last_name": "Gates",
  "summary": "Co-chair of the Bill & Melinda Gates... Active blogger.",
  "region_id": "us:91",
  "industry_id": 131,
  "positions": [
    {"job_title": "Co-chair", "organization": "Bill & Melinda Gates Foundation"},
    {"job_title": "Co-founder, Chairman", "organization": "Microsoft"}
  ],
  "education": [
    {"school_name": "Harvard University", "start": 1973, "end": 1975},
    {"school_name": "Lakeside School, Seattle", "start": null, "end": null}
  ],
  "contact_info": {
    "blog": "http://thegatesnotes.com",
    "twitter": "http://twitter.com/BillGates"
  }
}
JSON 표현은 다중 테이블 스키마보다 더 나은 지역성을 갖는다.
관계형 예제에서 프로필을 가져오려면 다중 질의(각 테이블에 user_id로 질의)를 하거나 난잡한 다중 조인을 수행해야 한다. 하지만, JSON 표현에서는 모든 관련 정보가 한 곳에 있어 질의 하나로 충분하다
2-4. 다대일과 다대다 관계
앞의 JSON에서 region_id와 industry_id가 평문 "그레이터 시애틀 구역", "자선활동"이 아니라 ID로 주어진 점에 주목해야 한다.
표준 목록에서 선택하게 하고 ID로 참조하면 얻는 것
-
모호함 회피: 이름이 같은 여러 도시가 있는 경우
-
갱신의 편의성: 이름이 한 곳에만 저장되므로 전반적으로 갱신하기 쉽다
-
현지화 지원: 표준 목록을 현지화해 사이트를 보는 사람의 언어로 표시할 수 있다
-
더 나은 검색: 지역 목록에 "시애틀이 워싱턴에 있다"는 사실을 부호화할 수 있다. 문자열 "그레이터 시애틀 구역"만으로는 "워싱턴"을 식별하지 못한다
-
일관성: 프로필 간 일관된 스타일과 철자
ID의 핵심 장점은 ID 자체에 아무 의미가 없어서 변경할 필요가 없다는 점이다. 식별 정보가 바뀌어도 ID는 그대로 유지된다.
반대로 의미를 가지는 값이라면 언젠가 바꿔야 하고, 정보가 중복돼 있으면 모든 중복 항목을 변경해야 한다. 여기엔 쓰기 오버헤드와 불일치 위험(일부만 갱신되는 상황)이 따른다.
이런 중복을 제거하는 일이 데이터베이스 정규화 이면에 놓인 핵심 개념이다.
그런데 다대일 관계는 문서 모델에 적합하지 않다
중복을 정규화하려면 다대일(many-to-one) 관계가 필요하다. 많은 사람이 한 지역에 살고, 많은 사람이 한 업계에서 일한다.
-
관계형 DB에서는 조인이 쉽기 때문에 ID로 다른 테이블의 로우를 참조하는 방식이 일반적이다
-
문서 DB는 일대다 트리 구조에는 조인이 필요 없지만, 조인 지원 자체가 보통 약하다
-
DB가 조인을 지원하지 않으면 애플리케이션 코드에서 다중 질의로 조인을 흉내 내야 한다. 조인을 만드는 작업이 DB에서 애플리케이션 코드로 옮겨간다. -> 따라서, 개발자에게 그 몫이 넘어가게 된다.
더 큰 문제는 데이터가 점점 상호 연결된다는 점이다
초기 버전이 조인 없는 문서 모델에 적합하더라도, 기능을 추가하면서 데이터는 점차 상호 연결되는 경향이 있다.
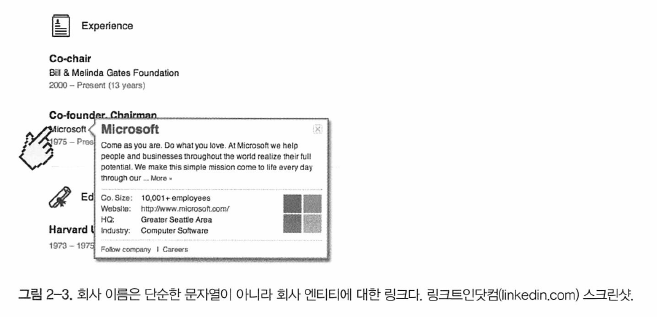
-
조직과 학교를 엔티티로:
organization,school_name이 문자열이 아니라 엔티티 참조라면, 각 이력서에서 조직 페이지로 링크하고 로고, 뉴스 피드 같은 추가 정보를 포함할 수 있다 -
추천서 기능: 추천서에는 추천인의 이름과 사진이 함께 보여진다. 추천인이 사진을 갱신하면 그가 작성한 모든 추천서에 새 사진이 반영돼야 한다. 따라서 추천서는 작성자 프로필을 참조해야 한다
이런 기능은 다대다(many-to-many) 관계를 필요로 하고, 질의할 때 조인이 필요해진다.
3. 문서 데이터베이스는 역사를 반복하고 있나
다대다 관계를 어떻게 표현할 것인가 하는 논쟁은 NoSQL보다 훨씬 오래됐다. 사실상 가장 초기의 전산화 데이터베이스 시스템까지 거슬러 올라간다.
3-1. 계층 모델 : IBM IMS
-
1970년대 비즈니스 데이터 처리에 가장 많이 쓰인 DB는 IBM의 IMS(Information Management System)다. 1968년 상업 출시됐고 오늘날에도 IBM 메인프레임에서 사용 및 유지보수되고 있다.
-
IMS는 계층 모델을 사용했다. 모든 데이터를 레코드 내에 중첩된 레코드 트리로 표현한다. 문서 DB의 JSON 모델과 비슷하다.
IMS도 일대다 관계에서는 잘 동작했지만, 다대다 관계 표현이 어려웠고 조인을 지원하지 않았다.
개발자는 데이터를 비정규화해서 중복할지, 아니면 레코드 간 참조를 수동으로 해결할지 결정해야 했다.
1960~70년대의 이 문제는 오늘날 문서 데이터베이스로 작업하는 개발자가 풀어야 할 문제와 매우 비슷하다.
3-2. 네트워크 모델 : 코다실과 접근 경로
계층 모델의 한계를 풀기 위해 두 해결책이 경쟁했다.
관계형 모델과 네트워크 모델이며, 두 진영의 논쟁은 1970년대 내내 이어졌다.
네트워크 모델은 코다실(CODASYL) 위원회가 표준화해 코다실 모델이라고도 부른다.
-
코다실은 계층 모델을 일반화한다. 계층 모델에서 모든 레코드는 부모가 정확히 하나지만, 네트워크 모델에서 레코드는 다중 부모를 가질 수 있다. 그래서 다대일과 다대다를 모델링할 수 있다.
-
레코드 간 연결은 외래 키보다 프로그래밍 언어의 포인터에 가깝다
레코드에 접근하는 유일한 방법은 최상위 레코드에서부터 연속된 연결 경로를 따르는 것이다.
이를 접근 경로라 한다.
-
하지만 다대다의 세계에서는 다양한 경로가 같은 레코드로 이어지고, 프로그래머는 이 경로들을 계속 추적해야 한다
-
코다실 위원회조차 이 방식이 n차원 데이터 공간을 항해하는 것과 같다고 인정했다
데이터가 어떻게 연결돼 있나
테이블과 외래 키도 없으며, 레코드가 포인터로 줄줄이 엮여 있는 형태이다.
 [지역: 그레이터 시애틀 구역]          ← 최상위 레코드(root)
            │
            │ 첫 멤버 포인터
            ▼
    [사용자: Bill] ──────▶ [사용자: Alice] ──────▶ [사용자: Carol] ──▶ (끝)
            │                    다음 멤버 포인터
            │ 첫 직업 포인터
            ▼
    [직업: Microsoft] ──▶ [직업: Gates 재단] ──▶ (끝)
그래서 질의는 이렇게 생겼다
"시애틀에 사는 사람 중 Microsoft에서 일한 적 있는 사람 찾기"를 코다실에서 하면, 애플리케이션 코드가 커서를 직접 움직여야 한다.
  커서 위치                         애플리케이션 코드가 해야 하는 일
  ────────────────────────────────────────────────────────────────
① [지역: 시애틀]                    진입점을 코드에 직접 지정한다
②  └▶ [사용자: Bill]                첫 멤버로 커서를 옮긴다
③      └▶ [직업: Microsoft]         그 사용자의 첫 직업으로 또 옮긴다
④          organization == ?        값을 직접 비교한다 → 일치, 수집
⑤      └▶ [직업: Gates 재단]        다음 직업으로 옮겨 ④를 반복
⑥          (직업 목록 끝)           사용자 레벨로 되돌아간다
⑦  └▶ [사용자: Alice]               다음 멤버로 옮겨 ③부터 반복
⑧      ...                          지역의 멤버가 끝날 때까지 계속
무엇을 원하는가가 아니라 어디로 어떻게 걸어갈 것인가를 전부 코드로 쓴 것이다. 오늘날의 WHERE region = '시애틀' AND org = 'Microsoft' 한 줄이 위의 8단계 순회로 손에 들려 있었다.
수동 접근 경로 선택은 1970년대의 제한된 하드웨어인 탐색이 매우 느린 테이프 드라이브를 가장 효율적으로 쓰는 방법이었다.
하지만 원하는 데이터에 대한 경로가 없으면 어려운 상황에 놓인다.
접근 경로를 바꾸려면 아주 많은 수작업 질의 코드를 살펴보고 재작성해야 했으며, 애플리케이션의 데이터 모델을 바꾸는 작업이 매우 어려운 일이었다.
3-3. 관계형 모델 : 접근 경로를 자동으로 만든다
대조적으로 관계형 모델이 하는 일은 알려진 모든 데이터를 그냥 배치하는 것이다.
관계(Table)는 단순히 튜플(Row)의 컬렉션이 전부다.
-
얽히고설킨 중첩 구조가 없고, 따라가야 할 복잡한 접근 경로도 없다
-
임의 조건과 일치하는 로우를 선택해 읽을 수 있고, 일부 칼럼을 키로 지정해 특정 로우를 읽을 수 있다
-
외래 키 관계를 신경 쓰지 않고 임의 테이블에 새 로우를 삽입할 수 있다
관계형 데이터베이스에서 질의 최적화기(query optimizer)는 질의의 어느 부분을 어떤 순서로 실행할지를 결정하고 사용할 색인을 자동으로 결정한다.
이 선택은 실제로 접근 경로이다. 큰 차이점은 접근 경로를 애플리케이션 개발자가 아니라 질의 최적화기가 자동으로 만든다는 점이다. 그래서 접근 경로를 따로 생각할 필요가 없다.
-
새로운 방식으로 질의하고 싶으면 새 색인을 선언하기만 하면 된다. 질의는 자동으로 가장 적합한 색인을 사용하며, 새 색인을 쓰려고 질의를 바꿀 필요가 없다.
-
관계형 DB의 질의 최적화기는 복잡해서 수년 간의 연구와 개발 노력을 필요로 한다
-
질의 최적화기가 없다면 범용 최적화기를 만들기보다 특정 질의를 위한 접근 경로를 직접 코딩하는 게 쉽지만, 장기적으로는 범용 솔루션이 유리하다
주목할 점은 질의 최적화기를 한번 만들면 그 DB를 사용하는 모든 애플리케이션이 혜택을 받는다는 것이다.
3-4. 문서 데이터베이스와의 비교
문서 DB는 한 가지 측면에서 계층 모델로 되돌아갔다.
별도 테이블이 아닌 상위 레코드 내에 중첩된 레코드(positions, education, contact_info 같은 일대다 관계)를 저장한다.
하지만 다대일과 다대다를 표현할 때 관계형 DB와 문서 DB는 근본적으로 다르지 않다.
-
둘 다 관련 항목을 고유한 식별자로 참조한다.
-
관계형에서는 외래 키, 문서 모델에서는 문서 참조라 부른다
-
이 식별자는 조인이나 후속 질의를 사용해 읽기 시점에 확인한다
즉, 현재까지는 문서 데이터베이스가 코다실의 전철을 밟지 않고 있다.
4. 관계형과 문서, 오늘날의 비교
두 모델을 비교할 때 고려할 차이는 많지만, 2장은 데이터 모델의 차이만 본다.
| 문서 모델 | 관계형 모델 | |
|---|---|---|
| 강점 | 스키마 유연성, 지역성, 애플리케이션 데이터 구조와의 근접성 | 조인, 다대일, 다대다 관계 |
| 적합한 데이터 | 일대다 트리를 한 번에 통째로 적재 | 상호 연결이 많음 |
4-1. 어떤 모델이 코드를 더 간단하게 하는가
데이터가 문서처럼 생겼다면 문서 모델이 코드를 단순하게 만든다. 이걸 억지로 여러 테이블로 찢으면 다루기 힘든 스키마와 불필요하게 복잡한 코드가 나온다.
문서 모델의 제한은 두 가지다.
-
문서 내 중첩 항목을 직접 참조할 수 없다. "사용자 251의 직위 목록의 두 번째 항목"처럼 위치로 지정해야 한다. 코다실 모델의 접근 경로와 같은 방식이다
-
조인 지원이 미흡하다. 다만 이벤트 로그를 쌓는 분석 애플리케이션처럼 다대다가 아예 없는 경우라면 문제되지 않는다
다대다를 쓰는 순간부터 계산이 달라진다.
-
비정규화로 조인을 줄일 수는 있지만, 그 대신 애플리케이션이 일관성 유지를 떠안는다.
-
다중 요청으로 조인을 흉내 내면 복잡도가 애플리케이션으로 넘어올 뿐 아니라, DB 안에서 도는 조인보다 느리다
결국 어떤 모델이 낫냐는 데이터 항목 사이에 어떤 관계가 있느냐에 달렸다.
상호 연결이 많은 데이터라면 문서 모델은 곤란하고, 관계형은 무난하며, 그래프 모델은 매우 자연스럽다.
4-2. 스키마 유연성 (읽기 스키마와 쓰기 스키마)
대부분의 문서 DB와 관계형 DB가 지원하는 JSON은 문서의 데이터에 어떤 스키마도 강요하지 않는다.
임의의 키와 값을 문서에 추가할 수 있고, 읽을 때 클라이언트는 그 필드가 있는지 보장받지 못한다.
그래서 문서 DB를 종종 Schemaless라 부르지만, 이 용어에는 오해의 소지가 있다. 데이터를 읽는 코드는 보통 구조의 유형을 어느 정도 가정하기 때문이다.
즉 암묵적인 스키마는 있고, DB가 그것을 강요하지 않을 뿐이다. 조금 더 정확한 용어가 읽기 스키마와 쓰기 스키마다.
-
쓰기 스키마: 관계형 DB의 전통적인 접근 방식으로, 스키마가 명시적이고 쓰여진 모든 데이터가 스키마를 따르고 있음을 DB가 보장한다
-
읽기 스키마: 데이터 구조가 암묵적이고, 데이터를 읽을 때만 해석되며, 문서 DB가 여기에 해당한다.
프로그래밍 언어에 빗대면 읽기 스키마는 동적(런타임) 타입 확인과, 쓰기 스키마는 정적(컴파일 타임) 타입 확인과 유사하다.
정적 타입과 동적 타입 지지자들이 열띤 논쟁을 하는 것처럼, DB에서 스키마를 강제하는 문제도 일반적으로 옳고 그른 정답은 없다.
차이는 필드를 바꿀 때 드러난다
전체 이름 필드를 성과 이름으로 분리한다고 하자.
// 읽기 스키마 — 새 필드로 쓰기 시작하고, 읽는 쪽에서 예전 문서를 처리한다
if (user && user.name && !user.first_name) {
  // 2013년 12월 8일 이전에 쓴 문서는 first_name이 없음
  user.first_name = user.name.split(" ")[0];
}
-- 쓰기 스키마 — 마이그레이션을 수행한다
ALTER TABLE users ADD COLUMN first_name text;
UPDATE users SET first_name = split_part(name, ' ', 1); -- PostgreSQL
UPDATE users SET first_name = substring_index(name, ' ', 1); -- MySQL마이그레이션이 느리고 위험하다는 평판은 절반만 맞다.
-
대부분의 관계형 DB는
ALTER TABLE을 수 밀리초에 끝낸다 -
MySQL은 예외다.
ALTER TABLE시 전체 테이블을 복사하기 때문에 큰 테이블이면 수 분에서 수 시간이 걸린다 (회피 도구는 존재한다) -
진짜 오래 걸리는 쪽은
UPDATE이며, 모든 로우를 재작성해야 한다. 감당이 안 되면first_name을 NULL로 두고 읽는 시점에 채우면 된다.
읽기 스키마가 유리한 상황
컬렉션 안의 항목이 애초에 같은 모양이 아닐 때다.
- 유형이 여러 가지인데 각각을 별도 테이블로 만드는 게 실용적이지 않을 때
- 데이터 구조를 외부 시스템이 정하고, 그쪽이 언제든 바꿀 수 있을 때
반대로 모든 레코드가 같은 구조라면 스키마는 제약이 아니라 문서화 수단이다.
4-3. 질의를 위한 데이터 지역성
문서는 보통 단일 연속 문자열로 저장된다. JSON, XML, 또는 MongoDB의 BSON 같은 이진 변형이다.
한 덩어리로 붙어 있으니 통째로 읽을 때 빠르다. 다중 테이블이라면 같은 내용을 모으는 데 여러 번의 색인 검색과 디스크 탐색이 필요하다.
문제는 이 이점에 조건이 붙는다는 것인데, 한 번에 문서의 많은 부분을 쓸 때만 이득이다.
-
필드 하나만 필요해도 DB는 문서 전체를 적재하므로, 문서가 크면 그만큼 낭비다.
-
갱신할 때도 보통 문서 전체를 다시 쓴다.
-
그래서 문서를 작게 유지하고 크기가 커지는 쓰기를 피하라고 권장하는데, 해당 제약 때문에 문서 DB가 유리한 상황이 생각보다 좁아진다
또한, 지역성은 문서 모델만의 것도 아니며, 관계형 쪽에도 같은 아이디어가 있다.
| 시스템 | 기능 |
|---|---|
| 구글 Spanner | 부모 테이블 안에 자식 로우를 중첩 배치하도록 선언하는 스키마 |
| Oracle | 다중 테이블 색인 클러스터 테이블 (multi-table index cluster table) |
| Bigtable (Cassandra, HBase) | 칼럼 패밀리 (column-family) |
4-4. 두 모델은 서로 닮아가고 있다
-
관계형 DB는 문서를 받아들였다.
- MySQL을 뺀 대부분이 2000년대 중반부터 XML을, PostgreSQL 9.3 / MySQL 5.7 / DB2 10.5부터 JSON을 지원한다. 문서 내부를 색인하고 질의할 수도 있다
-
문서 DB는 조인을 들여왔다.
- RethinkDB는 질의 언어에서 관계형 조인을 지원하고, MongoDB 드라이버는 DB 참조를 자동으로 따라간다
각자 부족한 쪽을 채우는 중이고, 책은 이 혼합 모델이 앞으로 갈 길이라고 본다.
5. 데이터를 위한 질의 언어
5-1. 선언형과 명령형
SQL은 선언형 질의 언어인 반면, IMS와 코다실은 명령형 코드로 데이터베이스에 질의했다.
// 명령형 — 어떻게 할지를 지시한다
function getSharks() {
  var sharks = [];
  for (var i = 0; i < animals.length; i++) {
    if (animals[i].family === "Sharks") {
      sharks.push(animals[i]);
    }
  }
  return sharks;
}
-- 선언형 — 무엇을 원하는지만 지정한다
SELECT * FROM animals WHERE family = 'Sharks';관계 대수로는 sharks = σ(family="Sharks")(animals)로 쓴다. σ(시그마)는 선택 연산자이고, SQL은 이 관계 대수의 구조를 상당히 유사하게 따랐다.
-
명령형 언어: 특정 순서로 특정 연산을 수행하게끔 컴퓨터에 지시한다. 한 줄씩 실행하고, 조건을 평가하고, 변수를 갱신하고, 루프를 더 돌지 결정한다
-
선언형 언어: 목표 달성 방법이 아니라 결과가 충족해야 할 조건과 변환 방식(정렬, 그룹화, 집계)만 지정한다
어떤 색인을 쓸지, 어떤 조인 함수를 쓸지, 질의의 어느 부분을 어떤 순서로 실행할지는 전부 질의 최적화기가 결정한다.
선언형이 나은 이유 세 가지
-
간결하다: 명령형 API보다 쓰고 읽기 쉽다
-
구현이 숨겨져 있다: 질의를 고치지 않고도 DB가 빨라질 수 있다
-
명령형 코드는 결과가 특정 순서로 나온다. DB가 디스크 공간을 회수하려고 레코드를 옮기면 그 순서가 바뀌는데, 코드가 순서에 의존하는지를 DB는 알 수 없다
-
SQL은 애초에 순서를 보장하지 않으므로 자유롭게 옮길 수 있다. 기능이 제한적이라는 점이 오히려 최적화 여지를 만든다
-
-
병렬 실행에 적합하다: 오늘날 CPU는 클록 속도보다 코어 수로 빨라지고 있다
-
명령형은 명령어 순서를 못 박기 때문에 다중 코어로 쪼개기 어렵다
-
선언형은 알고리즘이 아니라 결과의 패턴만 지정하므로 DB가 알아서 병렬화할 수 있다
-
5-2. 웹에서의 선언형 질의
선언형 질의 언어의 장점은 DB에만 국한되지 않는다. 책은 완전히 다른 환경인 웹 브라우저를 예로 든다.
바다 동물 사이트의 메뉴가 <li><p>Sharks</p>...</li>, <li><p>Whales</p>...</li> 구조이고, 현재 선택된 항목에만 class="selected"가 붙어 있다고 하자. 선택된 항목의 제목을 파란 배경으로 강조하고 싶다.
/* 선언형 — CSS */
li.selected > p {
  background-color: blue;
}
선택자 li.selected > p는 스타일을 적용할 엘리먼트의 패턴을 선언한다. selected 클래스를 가진 <li>가 <p>의 부모여야 한다는 뜻이다.
-
<p>Sharks</p>: 부모<li>에class="selected"가 있으므로 일치 -
<p>Whales</p>: 부모에 클래스가 없으므로 불일치
같은 일을 명령형으로, 자바스크립트 DOM API를 써서 하면 이렇게 된다.
// 명령형 — DOM API
var liElements = document.getElementsByTagName("li");
for (var i = 0; i < liElements.length; i++) {
  if (liElements[i].className === "selected") {
    var children = liElements[i].childNodes;
    for (var j = 0; j < children.length; j++) {
      var child = children[j];
      if (child.nodeType === Node.ELEMENT_NODE && child.tagName === "P") {
        child.setAttribute("style", "background-color: blue");
      }
    }
  }
}
코드량이 엄청날 뿐 아니라 심각한 문제가 두 가지 있다.
-
상태 변화를 따라가지 못한다:
selected클래스가 삭제돼도 코드를 재실행하면 파란색이 지워지지 않아 전체 페이지가 다시 로딩될 때까지 하이라이트가 남는 반면, CSS는 규칙이 더 이상 적용되지 않는 것을 브라우저가 자동으로 감지해 즉시 지운다. -
성능 개선을 누리려면 코드를 재작성해야 한다:
getElementsByClassName이나document.evaluate()같은 새 API의 장점을 취하려면 코드를 고쳐야 하지만, 브라우저 벤더는 호환성을 깨뜨리지 않고 CSS와 XPath의 성능을 향상할 수 있다
웹 브라우저에서 선언형 CSS를 쓰는 편이 자바스크립트로 스타일을 다루는 것보다 훨씬 낫듯, 데이터베이스에서도 SQL 같은 선언형 질의 언어가 명령형 질의 API보다 훨씬 좋다고 나타났다.
5-3. 맵리듀스 질의
맵리듀스는 많은 컴퓨터에서 대량 데이터를 처리하기 위한 프로그래밍 모델로 구글이 널리 알렸다.
MongoDB와 CouchDB 등 일부 NoSQL 저장소가 제한된 형태로 지원하고, 많은 문서를 대상으로 하는 읽기 전용 질의에 쓴다.
맵리듀스는 선언형 질의 언어도 완전한 명령형 질의 API도 아닌 그 중간에 있으며, 질의 로직을 처리 프레임워크가 반복적으로 호출하는 조각 코드로 표현한다.
이름은 함수형 언어의 map(collect)과 reduce(fold, inject)에서 왔다.
해양 생물학자가 되어 한 달에 상어를 얼마나 자주 발견하는지 보고서를 만든다고 하자.
-- PostgreSQL
SELECT date_trunc('month', observation_timestamp) AS observation_month,
       sum(num_animals) AS total_animals
FROM observations
WHERE family = 'Sharks'
GROUP BY observation_month;
// MongoDB 맵리듀스
db.observations.mapReduce(
function map() {
var year = this.observationTimestamp.getFullYear();
var month = this.observationTimestamp.getMonth() + 1;
emit(year + "-" + month, this.numAnimals);
},
function reduce(key, values) {
return Array.sum(values);
},
{
query: { family: "Sharks" }, // 상어만 거르는 필터 (MongoDB 특화 확장)
out: "monthlySharkReport" // 최종 출력 컬렉션
}
);읽는 순서는 이렇다.
-
map:query로 걸러진 모든 문서에 대해 한 번씩 호출된다.this가 문서 객체로 설정된다 -
emit: 키("2013-12" 같은 연도와 월로 구성된 문자열)와 값(관측치의 동물 수)을 방출하며, 같은 키를 가진 쌍들이 모여reduce를 한 번 호출한다 -
reduce: 그 달의 모든 관측치에서 동물 수를 합쳐out이 가리키는 컬렉션에 기록한다
map과 reduce는 입력으로 전달된 데이터만 사용하고 추가 DB 질의를 수행할 수 없으며 부수 효과가 없는 순수 함수여야 한다.
제약처럼 보이지만, 덕분에 DB가 이 함수를 임의 순서로 어디서나 실행할 수 있고 장애가 발생해도 재실행할 수 있다.
맵리듀스를 두고 흔히 하는 오해도 정리해 둔다.
-
분산 질의의 독점권: SQL 같은 고수준 질의 언어도 맵리듀스 연산의 파이프라인으로 구현할 수 있지만, 맵리듀스를 사용하지 않은 분산 SQL 구현 역시 많다
-
질의 중간의 자바스크립트: 고급 질의가 가능한 훌륭한 기능이지만 맵리듀스에만 해당하는 것은 아니며, 일부 SQL DB도 자바스크립트 함수로 확장될 수 있다
그리고 MongoDB는 선언형으로 돌아왔다
맵리듀스의 사용성 문제는 연계된 자바스크립트 함수 두 개를 신중하게 작성해야 한다는 점인데, 이는 종종 하나의 질의를 작성하는 것보다 어렵다.
더욱이 선언형 질의 언어라야 질의 최적화기가 성능을 높일 기회를 얻는다.
이런 이유로 MongoDB 2.2는 집계 파이프라인(aggregation pipeline)이라는 선언형 질의 언어 지원을 추가했다.
db.observations.aggregate([
  { $match: { family: "Sharks" } },
  { $group: {
      _id: {
        year:  { $year:  "$observationTimestamp" },
        month: { $month: "$observationTimestamp" }
      },
      totalAnimals: { $sum: "$numAnimals" }
  }}
]);
문법은 JSON 기반이지만 표현력은 SQL의 부분 집합과 비슷하다. 책의 표현을 빌리면, NoSQL 시스템이 뜻하지 않게 SQL을 재발견하고 있는 셈이다.
6. 정리
6-1. 다대다 관계를 어떻게 표현할 것인가
-
일대다: 문서 모델이 유리하다. 트리 구조가 그대로 드러나고 지역성 덕에 질의 한 번으로 끝난다.
-
다대다: 중복을 없애려면 참조가, 참조를 따라가려면 조인이 필요한데 문서 DB는 조인이 약하다.
-
결과: 조인이 DB에서 애플리케이션 코드로 넘어온다.
-
선례: 1960~70년대 IMS가 같은 문제를 먼저 겪었고, 비정규화해서 중복하거나 참조를 손으로 해결하거나 선택지까지 똑같았다.
다만 다대일, 다대다를 표현하는 방식 자체는 관계형과 문서가 다르지 않다. 둘 다 고유 식별자로 참조하고(외래 키 / 문서 참조) 읽기 시점에 해석한다.
6-2. 접근 경로를 누가 만들 것인가
| 접근 경로를 만드는 주체 | |
|---|---|
| 계층 모델(IMS), 네트워크 모델(코다실) | 개발자가 손으로. 경로가 없으면 질의 코드를 전부 재작성 |
| 관계형 모델 | 질의 최적화기가 자동으로. 색인만 선언하면 질의는 그대로 |
선언형 질의 언어가 명령형 API보다 나은 이유도 결국 여기로 모인다. 결과의 패턴만 지정하면 구현을 숨긴 채 성능을 개선할 수 있고 병렬 실행까지 열린다.
6-3. 그래서 무엇을 고를 것인가
어떤 모델이 나은지는 일반적으로 말할 수 없고, 데이터 항목 사이의 관계 유형에 따라 갈린다.
-
문서 모델: 일대다 트리를 통째로 읽고, 문서끼리 참조가 거의 없으며, 항목 구조가 제각각일 때
-
관계형 모델: 다대다가 일상적이고, 레코드 구조가 예상 가능하며, 새로운 질의가 계속 추가될 때
처음 판단이 맞았더라도 서비스가 자라면 전제가 바뀐다. 문자열이 엔티티가 되거나, 한 번의 갱신이 여러 문서로 번지거나, 애플리케이션에 조인 코드가 쌓이기 시작하면 다시 볼 때다.
둘 중 하나만 골라야 하는 것도 아니다. 관계형 테이블에 JSON 칼럼을 두는 혼합 모델이 실용적인 답이 되는 경우가 많다.