해당 스터디는
데이터 중심 애플리케이션 설계 (Designing Data-Intensive Applications)
https://www.wikibook.co.kr/data-intensive/
를 기반으로 진행한 내용입니다.
DDIA 3주차 - 02장. 데이터 모델과 질의 언어 (그래프형 데이터 모델)
1. 그래프형 데이터 모델
애플리케이션이 주로 일대다 관계이거나 레코드 간 관계가 없다면 문서 모델이 적합하다.
하지만 다대다 관계가 매우 일반적이고 데이터 간 연결이 복잡해지면 그래프로 모델링하는 편이 자연스럽다.
그래프는 두 유형의 객체로 이뤄진다.
-
정점(vertex): 노드, 엔티티라고도 한다
-
간선(edge): 관계, 호(arc)라고도 한다
| 그래프 | 정점 | 간선 |
|---|---|---|
| 소셜 그래프 | 사람 | 사람들이 서로 알고 있음 |
| 웹 그래프 | 웹 페이지 | 다른 페이지에 대한 HTML 링크 |
| 도로/철도 네트워크 | 교차로 | 교차로 간 도로나 철로 |
이런 그래프 위에서 동작하는 알고리즘도 잘 알려져 있어서, 자동차 내비게이션은 도로 네트워크에서 두 지점 간 최단 경로를 검색하고 페이지랭크는 웹 그래프로 웹 페이지의 인기와 검색 순위를 결정한다.
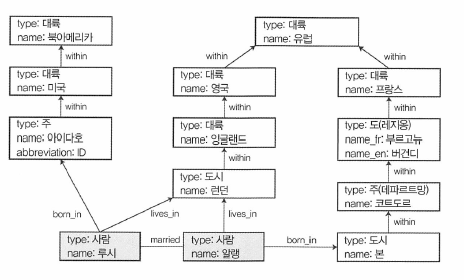
그래프는 동종 데이터에 국한되지 않는다.
페이스북은 사람, 장소, 이벤트, 체크인, 코멘트를 모두 정점으로 두고 친구 관계, 체크인 위치, 코멘트 작성자, 이벤트 참석 여부를 간선으로 표현하는 단일 그래프를 유지한다.
그래프를 구조화하고 질의하는 모델은 크게 두 가지다.
-
속성 그래프 모델: Neo4j, Titan, InfiniteGraph
-
트리플 저장소 모델: Datomic, AllegroGraph
질의 언어로는 선언형인 사이퍼, 스파클, 데이터로그를 다루며, 이 밖에 명령형 그래프 질의 언어인 Gremlin과 그래프 처리 프레임워크인 Pregel도 있다.
2. 속성 그래프
-
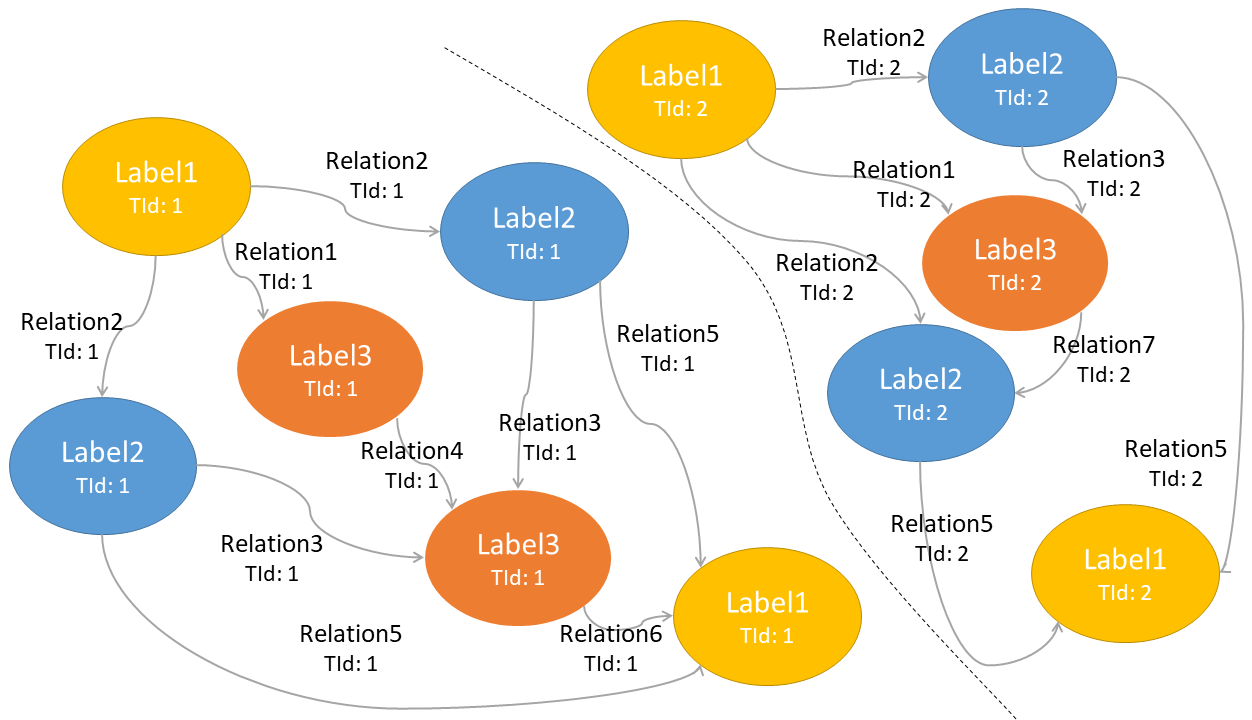
정점: 고유한 식별자, Outgoing 간선 집합, Incoming 간선 집합, 속성 컬렉션(키-값 쌍)
-
간선: 고유한 식별자, 간선이 시작하는 꼬리 정점, 간선이 끝나는 머리 정점, 관계 유형을 나타내는 레이블, 속성 컬렉션(키-값 쌍)
관계형 테이블 두 개로 표현하면 이렇다.
CREATE TABLE vertices (
  vertex_id  integer PRIMARY KEY,
  properties json
);

CREATE TABLE edges (
  edge_id     integer PRIMARY KEY,
  tail_vertex integer REFERENCES vertices (vertex_id),
  head_vertex integer REFERENCES vertices (vertex_id),
  label       text,
  properties  json
);

CREATE INDEX edges_tails ON edges (tail_vertex);
CREATE INDEX edges_heads ON edges (head_vertex);
정점과 간선의 속성은 PostgreSQL의 json 타입 칼럼에 담고, 머리와 꼬리 정점은 간선마다 저장한다.
어떤 정점의 유입 및 유출 간선 집합이 필요하면 edges 테이블을 head_vertex나 tail_vertex로 질의한다.
-
연결 제약이 없다: 어떤 정점이든 다른 어떤 정점과 간선으로 연결될 수 있고, 이를 제한하는 스키마가 없다
-
양방향으로 순회할 수 있다: 정점의 유입과 유출 간선을 효율적으로 찾아 그래프를 순회할 수 있으며, 마지막 두
CREATE INDEX가 이를 위한 것이다 -
레이블로 관계를 구분한다: 관계마다 다른 레이블을 쓰면 단일 그래프에 서로 다른 유형의 정보를 저장하면서도 모델을 깔끔하게 유지할 수 있다
이 유연성 덕분에 국가마다 다른 지역 구조나 제각각인 데이터 입도처럼 관계형 스키마로 표현하기 어려운 데이터도 담을 수 있다.
또한, 그래프는 발전성도 좋아서 기능을 추가할 때 데이터 구조 변경을 쉽게 수용한다.
예를 들어 알레르겐을 정점으로 두고 사람과 알레르겐을 간선으로 이어 음식 알레르기를 표현하고, 어떤 음식에 어떤 물질이 들어 있는지 보여주는 정점 집합과 알레르겐을 연결하면 각 사람이 먹을 수 있는 안전한 음식을 찾는 질의도 작성할 수 있다.
3. 사이퍼 질의 언어
사이퍼(Cypher)는 Neo4j를 위해 만들어진 속성 그래프용 선언형 질의 언어다.
CREATE
  (NAmerica:Location {name:'North America', type:'continent'}),
  (USA:Location      {name:'United States', type:'country'}),
  (Idaho:Location    {name:'Idaho',         type:'state'}),
  (Lucy:Person       {name:'Lucy'}),
  (Idaho) -[:WITHIN]->  (USA) -[:WITHIN]-> (NAmerica),
  (Lucy)  -[:BORN_IN]-> (Idaho)
화살표 표기로 간선을 만들며, (Idaho) -[:WITHIN]-> (USA)는 꼬리 정점이 Idaho이고 머리 정점이 USA인 WITHIN 레이블 간선이다.
미국에서 태어나 유럽으로 이민 온 사람의 이름을 찾는 질의는 이렇게 쓴다.
MATCH
  (person) -[:BORN_IN]->  () -[:WITHIN*0..]-> (us:Location {name:'United States'}),
  (person) -[:LIVES_IN]-> () -[:WITHIN*0..]-> (eu:Location {name:'Europe'})
RETURN person.name-
BORN_IN조건: person의 출생지에서WITHIN간선을 따라 올라가면 "United States"에 도달해야 한다 -
LIVES_IN조건: 같은 person의 거주지에서WITHIN간선을 따라 올라가면 "Europe"에 도달해야 한다 -
*0..: 0회 이상 따라가라는 의미로, 정규 표현식의*연산자와 같다
실행 방법은 여러 가지다. 모든 사람을 훑으며 출생지와 거주지를 확인할 수도 있고, name에 색인이 있다면 미국과 유럽 정점에서 시작해 WITHIN 유입 간선을 거꾸로 따라가며 사람을 찾을 수도 있다.
선언형 질의 언어라서 이런 수행 방식을 지정할 필요가 없고, 질의 최적화기가 가장 효율적이라고 예측한 전략을 자동으로 선택한다.
4. SQL의 그래프 질의
그래프 데이터를 관계형 테이블에 넣어도 SQL로 질의할 수는 있지만 어렵다.
관계형 질의는 필요한 조인을 미리 알고 있는 반면, 그래프 질의는 원하는 정점을 찾기 전에 몇 개의 간선을 지나야 할지 모르기 때문에 조인 수를 미리 고정할 수 없다.
LIVES_IN 간선이 도시를 바로 가리킬 수도 있고, 거리를 가리켜서 거리 → 도시 → 군 → 주 → 국가로 여러 단계를 올라가야 할 수도 있다.
SQL:1999 이후로는 재귀 공통 테이블 식(WITH RECURSIVE)으로 이 가변 순회를 표현할 수 있다.
WITH RECURSIVE
  -- 미국 내 모든 지역의 정점 ID
  in_usa(vertex_id) AS (
      SELECT vertex_id FROM vertices WHERE properties->>'name' = 'United States'
    UNION
      SELECT edges.tail_vertex FROM edges
        JOIN in_usa ON edges.head_vertex = in_usa.vertex_id
        WHERE edges.label = 'within'
  ),
  -- 유럽 내 모든 지역의 정점 ID
  in_europe(vertex_id) AS (
      SELECT vertex_id FROM vertices WHERE properties->>'name' = 'Europe'
    UNION
      SELECT edges.tail_vertex FROM edges
        JOIN in_europe ON edges.head_vertex = in_europe.vertex_id
        WHERE edges.label = 'within'
  ),
  -- 미국에서 태어난 모든 사람
  born_in_usa(vertex_id) AS (
    SELECT edges.tail_vertex FROM edges
      JOIN in_usa ON edges.head_vertex = in_usa.vertex_id
      WHERE edges.label = 'born_in'
  ),
  -- 유럽에 사는 모든 사람
  lives_in_europe(vertex_id) AS (
    SELECT edges.tail_vertex FROM edges
      JOIN in_europe ON edges.head_vertex = in_europe.vertex_id
      WHERE edges.label = 'lives_in'
  )
SELECT vertices.properties->>'name'
FROM vertices
  JOIN born_in_usa     ON vertices.vertex_id = born_in_usa.vertex_id
JOIN lives_in_europe ON vertices.vertex_id = lives_in_europe.vertex_id;-
in_usa,in_europe: 이름이 "United States", "Europe"인 정점에서 시작해within유입 간선을 재귀적으로 따라가며 하위 지역을 모두 모은다 -
born_in_usa,lives_in_europe: 그 지역들로 들어오는born_in,lives_in간선을 따라가 사람을 구한다 -
마지막
SELECT: 두 집합을 조인해 교집합을 구한다
해당 질의문으로 보았듯이, 같은 질의를 사이퍼는 4줄, SQL은 29줄로 작성해야 한다.
따라서, 데이터 모델마다 만족시키려는 사용 사례가 다르고, 그래서 애플리케이션에 맞는 데이터 모델을 고르는 일이 중요하다.
5. 트리플 저장소와 스파클
5-1. 트리플 저장소
트리플 저장소는 속성 그래프와 거의 동등한 모델을 다른 용어로 설명한다.
모든 정보를 (주어, 서술어, 목적어)의 세 부분 구문으로 저장하며, (짐, 좋아하다, 바나나)에서 짐이 주어, 좋아하다가 서술어, 바나나가 목적어다.
주어는 그래프의 정점에 해당하고, 목적어가 무엇이냐에 따라 서술어를 읽는 방법이 달라진다.
-
목적어가 원시 데이터타입 값일 때: 문자열이나 숫자 같은 값이면 서술어는 주어 정점의 속성 키, 목적어는 그 속성 값이 된다
-
목적어가 다른 정점일 때: 서술어는 두 정점을 잇는 간선의 레이블이 되고, 주어는 꼬리 정점, 목적어는 머리 정점이 된다
(루시, 나이, 33) → [lucy]  { age: 33 }
                  속성 키 :  속성 값

(루시, 결혼하다, 알랭) → [lucy] ───  결혼하다 ───▶ [alain]
                      꼬리 정점   간선 레이블     머리 정점
터틀(Turtle) 형식
터틀은 Notation3(N3)의 부분 집합으로, 한 줄이 곧 트리플 하나(주어 서술어 목적어.)다.
@prefix : <urn:example:>.

_:lucy     a        :Person.
_:lucy     :name    "Lucy".
_:lucy     :bornIn  _:idaho.
_:idaho    a        :Location.
_:idaho    :name    "Idaho".
_:idaho    :type    "state".
_:idaho    :within  _:usa.
_:usa      a        :Location.
_:usa      :name    "United States".
_:usa      :type    "country".
_:usa      :within  _:namerica.
_:namerica a        :Location.
_:namerica :name    "North America".
_:namerica :type    "continent".
위의 두 경우는 목적어의 모양으로 구분해서 읽는다.
-
목적어가 문자열 리터럴이면 서술어는 속성이다:
_:usa :name "United States".는 정점 usa의name속성 값이 "United States"라는 뜻이다 -
목적어가 정점이면 서술어는 간선이다:
_:idaho :within _:usa.는 idaho에서 usa로 가는within간선이라는 뜻이다 -
_:이름: 파일 외부의 무언가를 뜻하지 않으며, 여러 트리플이 같은 정점을 가리킨다는 것을 나타내기 위한 로컬 식별자다
이때, 같은 주어를 매 줄 반복하는 건 번거로우므로, 세미콜론으로 같은 주어에 대한 여러 서술어를 묶어 쓸 수 있다.
@prefix : <urn:example:>.

_:lucy     a :Person;   :name "Lucy";          :bornIn _:idaho.
_:idaho    a :Location; :name "Idaho";         :type "state";   :within _:usa.
_:usa      a :Location; :name "United States"; :type "country"; :within _:namerica.
_:namerica a :Location; :name "North America"; :type "continent".
5-2. 시맨틱 웹과 RDF
트리플 저장소는 시맨틱 웹과 독립적이지만 자주 함께 언급된다.
-
시맨틱 웹: 웹 사이트가 사람이 읽는 텍스트뿐 아니라 기계가 판독 가능한 데이터로도 정보를 게시하자는 개념이다.
-
RDF(Resource Description Framework): 서로 다른 웹 사이트가 일관된 형식으로 데이터를 게시하는 방법으로, 다른 사람의 데이터와 결합할 때 이름이 충돌하지 않도록 주어, 서술어, 목적어에
<http://my-company.com/namespace#within>같은 URI를 쓴다.
시맨틱 웹 자체는 널리 실현되지 않았지만, 트리플은 애플리케이션의 내부 데이터 모델로도 충분히 쓸 만하다.
5-3. 스파클
스파클(SPARQL)은 RDF 데이터 모델을 쓰는 트리플 저장소 질의 언어로, 사이퍼보다 먼저 나왔고 사이퍼가 스파클의 패턴 매칭을 차용해서 둘은 매우 비슷하다.
PREFIX : <urn:example:>

SELECT ?personName WHERE {
  ?person :name ?personName.
  ?person :bornIn  / :within* / :name "United States".
  ?person :livesIn / :within* / :name "Europe".
}
변수는 ?로 시작하며, RDF는 속성과 간선을 구분하지 않고 서술어만 쓰기 때문에, :name "United States" 같은 속성 매칭도 간선 순회와 같은 구문으로 쓴다.
6. 초석 : 데이터로그
데이터로그(Datalog)는 스파클, 사이퍼보다 훨씬 오래된 언어로 1980년대 학계에서 광범위하게 연구됐고, 이후 질의 언어의 기반이 됐다.
데이터 모델은 트리플 저장소와 비슷하되 (주어, 서술어, 목적어) 대신 서술어(주어, 목적어)로 쓴다.
name(namerica, 'North America').
type(namerica, continent).

name(usa, 'United States').
type(usa, country).
within(usa, namerica).

name(idaho, 'Idaho').
type(idaho, state).
within(idaho, usa).

name(lucy, 'Lucy').
born_in(lucy, idaho).

within_recursive(Location, Name) :- name(Location, Name).          /* 규칙 1 */
within_recursive(Location, Name) :- within(Location, Via),         /* 규칙 2 */
                                    within_recursive(Via, Name).

migrated(Name, BornIn, LivingIn) :- name(Person, Name),            /* 규칙 3 */
                                    born_in(Person, BornLoc),
                                    within_recursive(BornLoc, BornIn),
                                    lives_in(Person, LivingLoc),
                                    within_recursive(LivingLoc, LivingIn).

?- migrated(Who, 'United States', 'Europe'). /* Who = 'Lucy' */-
규칙:
:-오른편의 서술어가 모두 대응되면 왼편이 DB에 추가된다. 규칙은 다른 규칙을 참조하거나 자기 자신을 재귀 호출할 수 있다 -
변수: 대문자로 시작하는 단어이며,
name(Location, Name)은name(namerica, 'North America')와 대응될 때Location = namerica,Name = 'North America'가 된다 -
재귀 적용: 규칙 1이
within_recursive(namerica, 'North America')를 만들고, 규칙 2가 이를within(usa, namerica)와 결합해within_recursive(usa, 'North America')를, 다시within(idaho, usa)와 결합해within_recursive(idaho, 'North America')를 만든다
사이퍼와 스파클이 SELECT로 바로 질의하는 것과 달리, 데이터로그는 규칙을 정의하며 한 번에 조금씩 나아간다.
간단한 일회성 질의에는 불편하지만, 규칙을 결합하고 재사용할 수 있어 데이터가 복잡할수록 효과적이다.
7. 정리
역사적으로 데이터를 하나의 큰 트리인 계층 모델로 표현하려 했지만 다대다 관계에 적합하지 않아 관계형 모델이 고안됐고, 관계형 모델에도 맞지 않는 애플리케이션을 위해 NoSQL이 두 갈래로 등장했다.
-
문서 데이터베이스: 데이터가 문서 자체에 포함돼 있고 문서 간 관계가 거의 없는 사용 사례
-
그래프 데이터베이스: 모든 것이 잠재적으로 관련 있는 사용 사례
한 모델을 다른 모델로 흉내 낼 수는 있지만 결과는 대부분 엉망이며, 이러한 문제가 결국 단일 만능 솔루션이 아니라 목적에 맞는 시스템을 골라야 하는 이유다.
문서 DB와 그래프 DB는 스키마를 강제하지 않아 요구사항 변화에 유연하지만, 애플리케이션은 여전히 데이터 구조를 가정하므로 결국 스키마가 명시적(쓰기 스키마)이냐 암시적(읽기 스키마)이냐의 차이다.