1. CPU burst와 I/O burst
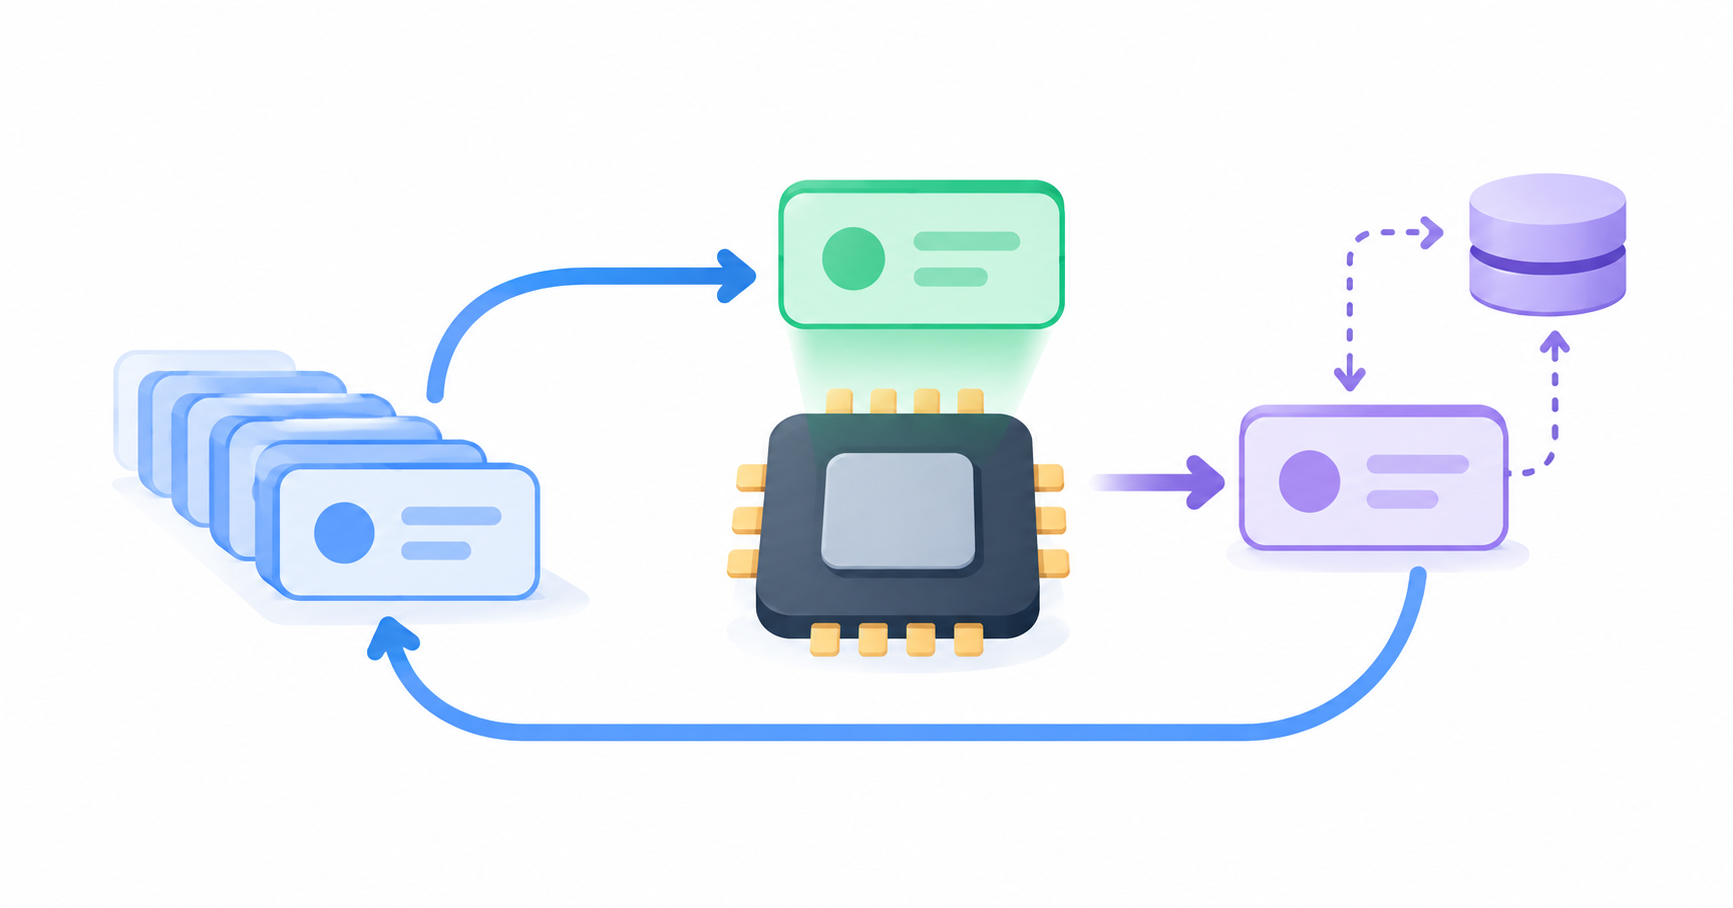
프로그램은 CPU만 쓰지도, I/O만 하지도 않습니다. CPU를 쓰는 구간(CPU burst)과 I/O를 기다리는 구간(I/O burst)이 번갈아 나옵니다.
CPU burst 시간의 분포를 보면 짧은 것이 아주 많고 긴 것이 드뭅니다. 이 분포는 프로그램의 성격이 갈리기 때문에 생깁니다.
- I/O bound job: 짧은 CPU burst를 여러 번 가짐. 사람과 상호작용하는 프로그램이 대개 여기 속함
- CPU bound job: 긴 CPU burst를 적게 가짐. 계산 위주 프로그램
한 시스템에 둘이 섞여 있다는 점이 핵심입니다. 긴 계산 작업에 CPU를 먼저 다 내주면, 키 입력 하나 처리하면 될 프로그램이 한참 밀립니다. 사용자는 컴퓨터가 멈췄다고 느낍니다. 그래서 순서를 정하는 규칙이 필요합니다.
2. 스케줄러와 디스패처
CPU scheduler는 Ready 상태의 프로세스 중 누구에게 CPU를 줄지 고릅니다. dispatcher는 실제로 넘겨주는 쪽으로, 문맥 교환을 수행하고 사용자 모드로 전환한 뒤 그 프로그램의 실행 위치로 점프합니다.
스케줄링이 필요한 시점은 네 가지입니다.
| 상황 | 예 | 성격 |
|---|---|---|
| Running → Blocked | I/O 요청 | 자진 반납 |
| Running → Terminated | 프로세스 종료 | 자진 반납 |
| Running → Ready | 타이머 인터럽트 | 강제로 빼앗음 |
| Blocked → Ready | I/O 완료 인터럽트 | 강제로 빼앗을 수 있음 |
앞의 둘만 있으면 비선점형(nonpreemptive)입니다. CPU를 잡은 프로세스가 스스로 놓기 전에는 아무도 못 뺏습니다. 뒤의 둘까지 허용하면 선점형(preemptive)입니다. 현대 시스템은 선점형입니다.
3. 무엇을 잘한다고 할 것인가
성능 척도는 보는 입장에 따라 다릅니다.
| 입장 | 척도 | 의미 |
|---|---|---|
| 시스템 | 이용률 (CPU utilization) | 전체 시간 중 CPU가 일한 비율 |
| 시스템 | 처리량 (throughput) | 주어진 시간에 끝낸 작업 수 |
| 프로그램 | 소요시간 (turnaround time) | 들어와서 끝날 때까지 걸린 전체 시간 |
| 프로그램 | 대기시간 (waiting time) | Ready 큐에서 기다린 시간의 총합 |
| 프로그램 | 응답시간 (response time) | 들어와서 처음 CPU를 얻기까지 걸린 시간 |
대기시간과 응답시간은 헷갈리기 쉽습니다. 선점형에서는 한 프로세스가 여러 번 기다리므로 그 조각들을 모두 더한 것이 대기시간이고, 그중 첫 번째 조각만 본 것이 응답시간입니다. 비선점형에서는 기다리는 횟수가 한 번뿐이라 둘이 같아집니다.
아래 예제는 모두 이 작업 집합을 씁니다. 세 프로세스가 동시에 도착했고, CPU burst는 P1이 24, P2가 3, P3이 3입니다.
4. FCFS와 convoy effect
FCFS(First-Come First-Served)는 먼저 온 순서대로 처리합니다. 은행 번호표와 같습니다.
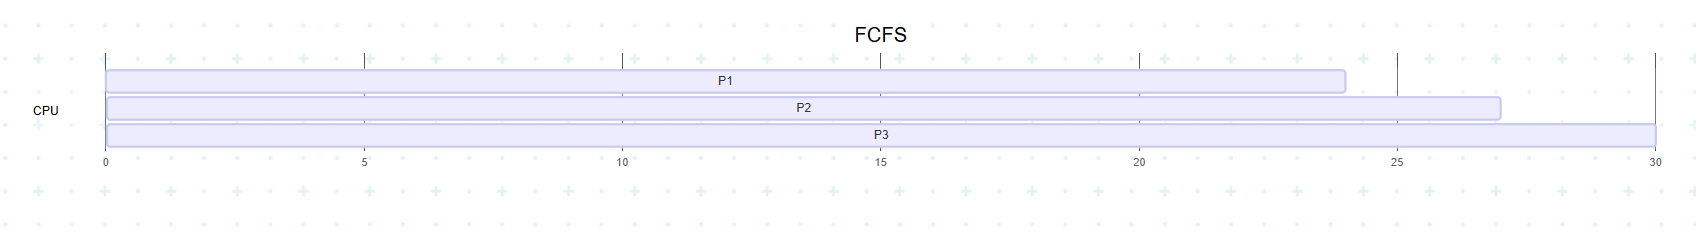
대기시간은 P1이 0, P2가 24, P3이 27이므로 평균 17입니다. 3짜리 작업 둘이 24짜리 하나 뒤에 줄을 섰다는 이유만으로 오래 기다렸습니다. 이렇게 긴 작업 하나가 앞에 서서 뒤의 짧은 작업들을 모두 지연시키는 현상을 convoy effect라고 합니다.
5. SJF와 예측
SJF(Shortest Job First)는 CPU burst가 가장 짧은 것부터 처리합니다. P2 → P3 → P1 순서가 되어 대기시간은 0, 3, 6이고 평균 3입니다. SJF는 주어진 작업 집합에 대해 평균 대기시간을 최소로 만드는 것이 증명된 알고리즘입니다.
선점 여부로 두 가지 변형이 있습니다. 비선점형은 한번 시작하면 끝까지 두고, 선점형(SRTF)은 더 짧은 작업이 도착하면 즉시 빼앗습니다.
문제는 둘입니다. 첫째, 짧은 작업이 계속 들어오면 긴 작업은 영원히 CPU를 못 받습니다. 이것이 기아(starvation)입니다. 둘째, 다음 CPU burst가 얼마나 길지는 실행해 보기 전에는 알 수 없습니다. 추정만 가능하며, 과거 기록으로 다음 값을 예측하는 방법이 지수 평균(exponential averaging)입니다.
다음 예측값 = α × (직전 실제 burst) + (1 - α) × (직전 예측값)α가 클수록 최근 실측값을 더 믿는다는 뜻입니다.
6. 우선순위 스케줄링과 aging
각 프로세스에 우선순위를 매기고 높은 쪽부터 처리합니다. 선점형과 비선점형 두 가지가 모두 가능합니다. SJF도 "burst가 짧을수록 우선순위가 높다"고 본 우선순위 스케줄링의 일종입니다.
여기서도 우선순위가 낮은 프로세스는 기아에 빠집니다. 해법이 aging입니다. 기다린 시간이 길어질수록 우선순위를 조금씩 올려 주면, 아무리 낮게 시작해도 언젠가는 차례가 옵니다.
7. Round Robin
RR(Round Robin)은 모두에게 동일한 크기의 할당 시간(time quantum)을 주고 돌아가며 실행합니다. 현대 시스템이 기반으로 쓰는 방식입니다. 할당 시간이 끝나면 타이머 인터럽트로 빼앗아 큐의 맨 뒤로 보냅니다.
할당 시간을 4로 잡으면 이렇게 됩니다.
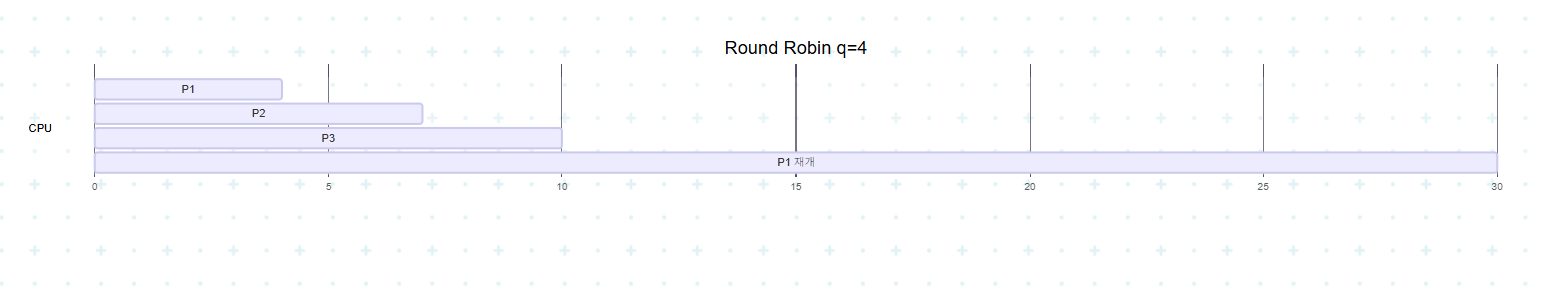
대기시간은 P1이 6, P2가 4, P3이 7로 평균 약 5.7입니다. SJF의 3보다 나쁩니다. 대신 응답시간을 보면 0, 4, 7로 평균 약 3.7이고, FCFS의 17과 비교가 되지 않습니다. RR의 장점은 평균 대기시간이 아니라 아무도 오래 방치되지 않는다는 데 있습니다.
또 하나의 성질은 CPU를 많이 쓰는 프로세스일수록 여러 바퀴를 돌아야 하므로 대기시간이 길어진다는 것입니다. 짧은 작업이 자연히 빨리 끝납니다.
할당 시간 크기는 양쪽 끝이 모두 나쁩니다.
- 너무 크면: 한 바퀴가 길어져 FCFS와 같아집니다
- 너무 작으면: 문맥 교환이 너무 자주 일어나 그 비용이 실제 작업 시간을 잡아먹습니다
8. 알고리즘 비교
| 알고리즘 | 선택 기준 | 장점 | 단점 | 기아 |
|---|---|---|---|---|
| FCFS | 도착 순서 | 단순하고 공정해 보임 | convoy effect | 없음 |
| SJF | 짧은 burst 먼저 | 평균 대기시간 최소 | burst 예측 필요 | 발생 |
| 우선순위 | 우선순위 값 | 중요한 일을 먼저 | 기준 설정이 어려움 | 발생 (aging으로 완화) |
| RR | 순서대로 할당 시간만큼 | 응답시간이 짧고 균등 | 할당 시간 선택이 까다로움 | 없음 |