1. 뒤로 못 가는 게 왜 문제인가
단방향은 링크가 앞에서 뒤로만 있습니다. 그래서 노드 x를 지우려면 x가 아니라 "x를 가리키는 노드"가 필요합니다. x만으로는 아무것도 못 합니다.
해결책은 단순합니다. 뒤로 가는 링크를 하나 더 두면 됩니다. 노드는 키 하나와 링크 두 개, prev와 next를 가집니다.
class Node:
    def __init__(self, key=None):
        self.key = key
        self.next = self
        self.prev = self      # 처음에는 자기 자신을 가리킨다
2. 원형과 dummy 노드
양방향으로 링크를 달아도 끝은 여전히 불편합니다. 맨 앞 노드의 prev와 맨 뒤 노드의 next가 비어 있어서, 연산마다 "여기가 끝인가", "리스트가 비었나"를 따로 검사해야 합니다.
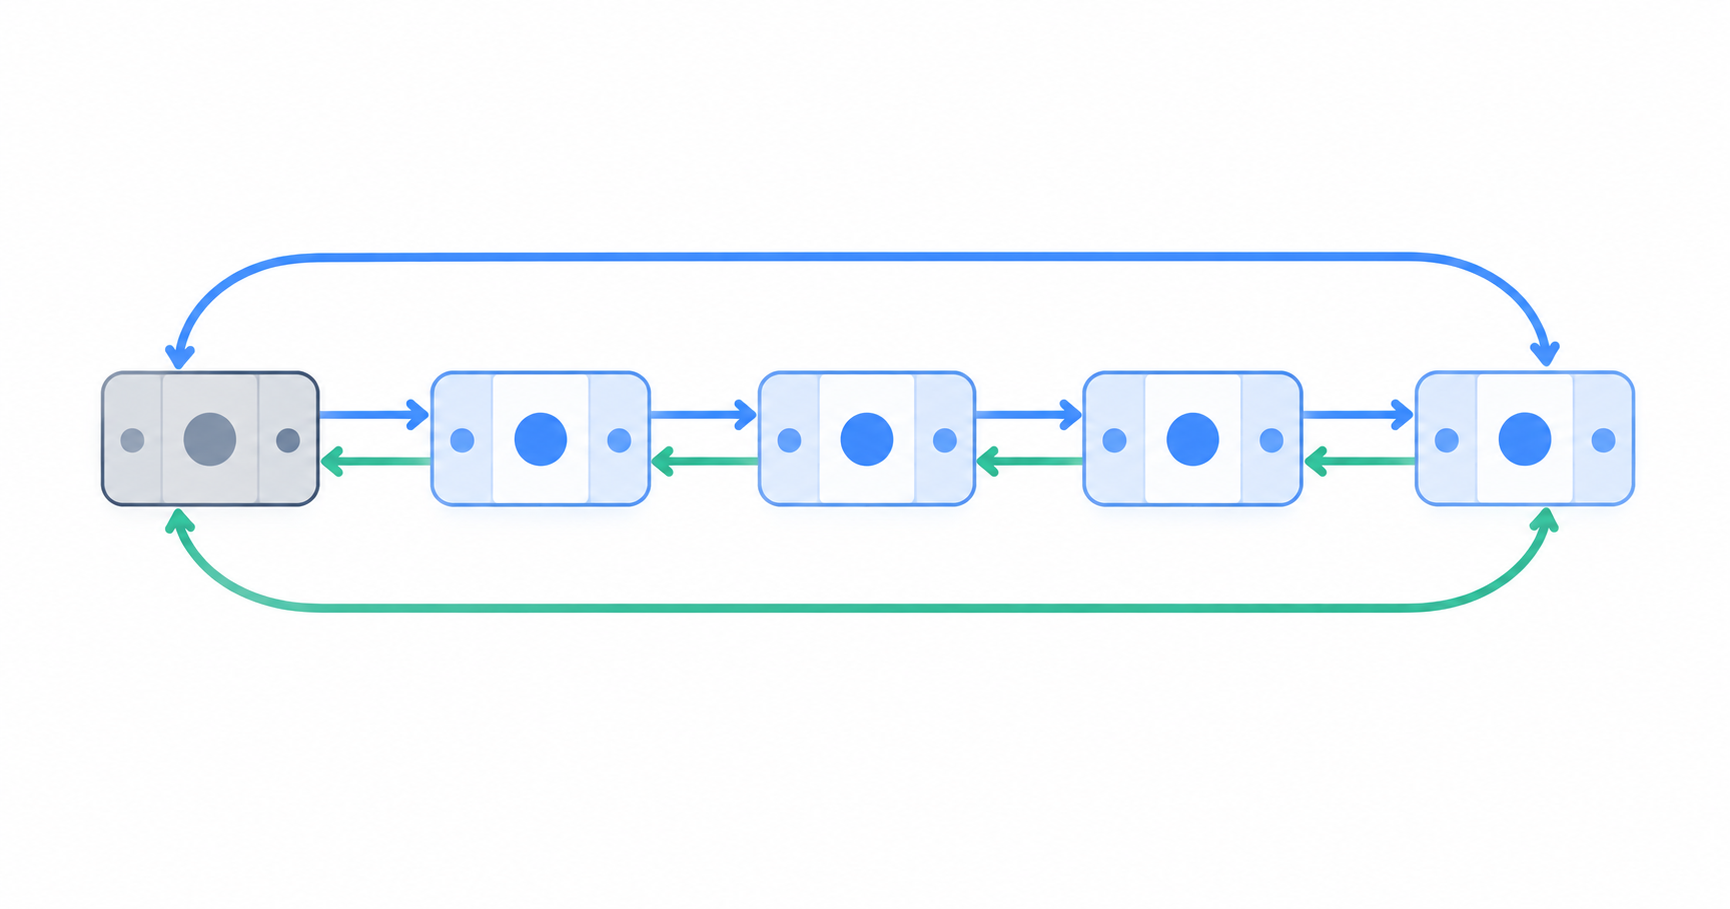
그래서 양 끝을 이어 원형으로 만들고, 값이 들어 있지 않은 dummy 노드를 하나 둡니다. 이 dummy가 head 역할을 하며 리스트의 경계 표시가 됩니다. head 다음부터가 실제로 삽입한 값입니다.
        +-----------------------------------------+
        |                                         |
        v                                         |
   +-------+     +-----+     +-----+     +-----+  |
   | dummy | <-> |  3  | <-> | 10  | <-> |  5  | <+
   +-------+     +-----+     +-----+     +-----+
      head       첫 원소                 마지막 원소

   head.next = 첫 원소,  head.prev = 마지막 원소
   비어 있으면 head.next == head
이 구조에서는 빈 리스트도 dummy 혼자 자기를 가리키는 상태일 뿐이라, 끝이나 빈 경우를 위한 분기가 사라집니다. 원형 양방향 연결 리스트의 삽입과 삭제가 훨씬 깔끔해지는 이유입니다.
class DoublyLinkedList:
    def __init__(self):
        self.head = Node()      # dummy
        self.size = 0
3. splice: 이 편의 핵심
splice는 연속된 구간 a부터 b까지를 통째로 떼어 내서 노드 x 뒤에 붙이는 연산입니다. 양방향 연결 리스트의 거의 모든 연산이 여기서 파생됩니다.
before: splice(a, b, x) — 7과 8을 3 뒤로
head <-> 3 <-> 10 <-> 7 <-> 8 <-> 5 <-> (head)
         x            a     b
after
head <-> 3 <-> 7 <-> 8 <-> 10 <-> 5 <-> (head)
         x     a     b
def splice(self, a, b, x):
ap, bn = a.prev, b.next # 구간의 앞뒤 노드
ap.next, bn.prev = bn, ap # 1) a..b 구간을 떼어 낸다
xn = x.next
x.next, a.prev = a, x # 2) x 뒤에 a를 붙이고
b.next, xn.prev = xn, b # b 뒤를 원래 x.next로 잇는다바꾸는 링크가 여섯 개로 고정이라 구간 길이와 무관하게 O(1)입니다.
4. splice에서 파생되는 연산들
이동 연산이 가장 먼저 나옵니다. 노드 하나짜리 구간을 옮기면 되므로 a와 b에 같은 노드를 넣습니다.
def move_after(self, a, x):      # a를 x 뒤로
    self.splice(a, a, x)

def move_before(self, a, x):     # a를 x 앞으로
    self.splice(a, a, x.prev)
삽입은 새 노드를 만들어 이동시키는 것과 같습니다. Node가 자기 자신을 가리키는 상태로 시작하기 때문에, 갓 만든 노드도 splice의 입력이 됩니다.
def insert_after(self, x, key):
    self.move_after(Node(key), x)
    self.size += 1

def insert_before(self, x, key):
    self.move_before(Node(key), x)
    self.size += 1
양 끝 삽입은 dummy를 기준으로 삼으면 끝납니다. head 뒤가 맨 앞이고, head 앞이 맨 뒤이기 때문입니다.
def push_front(self, key):
    self.insert_after(self.head, key)

def push_back(self, key):
    self.insert_before(self.head, key)
삭제도 splice입니다. 노드 x를 x 자신의 뒤에 붙이면, 리스트에서 떨어져 나와 혼자 남습니다.
def remove(self, x):
    if x is self.head:          # dummy는 지우지 않는다
        return None
    self.splice(x, x, x)
    self.size -= 1
    return x.key

def pop_front(self):
    return self.remove(self.head.next)

def pop_back(self):
return self.remove(self.head.prev)pop_back이 O(1)이 되었습니다. head.prev가 곧 마지막 노드라 훑을 필요가 없습니다.
탐색만은 여전히 링크를 따라가야 합니다. head로 돌아오면 한 바퀴를 돈 것이므로 거기서 멈춥니다.
def search(self, key):
    v = self.head.next
    while v is not self.head:
        if v.key == key:
            return v
        v = v.next
    return None
5. join과 split
두 리스트를 하나로 잇는 join과 하나를 둘로 나누는 split도 링크 몇 개를 바꾸는 일입니다. 원형이라 양쪽 dummy를 떼고 이어 붙이면 되고, split은 기준 노드에서 끊은 뒤 각 조각에 dummy를 붙입니다. 원소를 옮기지 않으므로 둘 다 O(1)입니다.
6. 시간복잡도 종합
| 연산 | 배열/파이썬 list | 단방향 | 양방향(원형) |
|---|---|---|---|
| k번째 원소 접근 | O(1) | O(k) | O(k) |
| 값으로 탐색 | 평균 O(n) | 평균 O(n) | 평균 O(n) |
pushFront / popFront | O(n) | O(1) | O(1) |
pushBack | amortized O(1) | O(1) | O(1) |
popBack | O(1) | O(n) | O(1) |
| 주어진 노드 삭제 | O(n) | O(n) | O(1) |
splice, join, split | O(n) | O(n) | O(1) |
| 노드당 추가 메모리 | 없음 | 링크 1개 | 링크 2개 |
모든 행에서 양방향이 같거나 낫고, 대가는 노드마다 링크 하나가 더 붙는 메모리입니다.