1. Ready 큐 하나로는 부족합니다
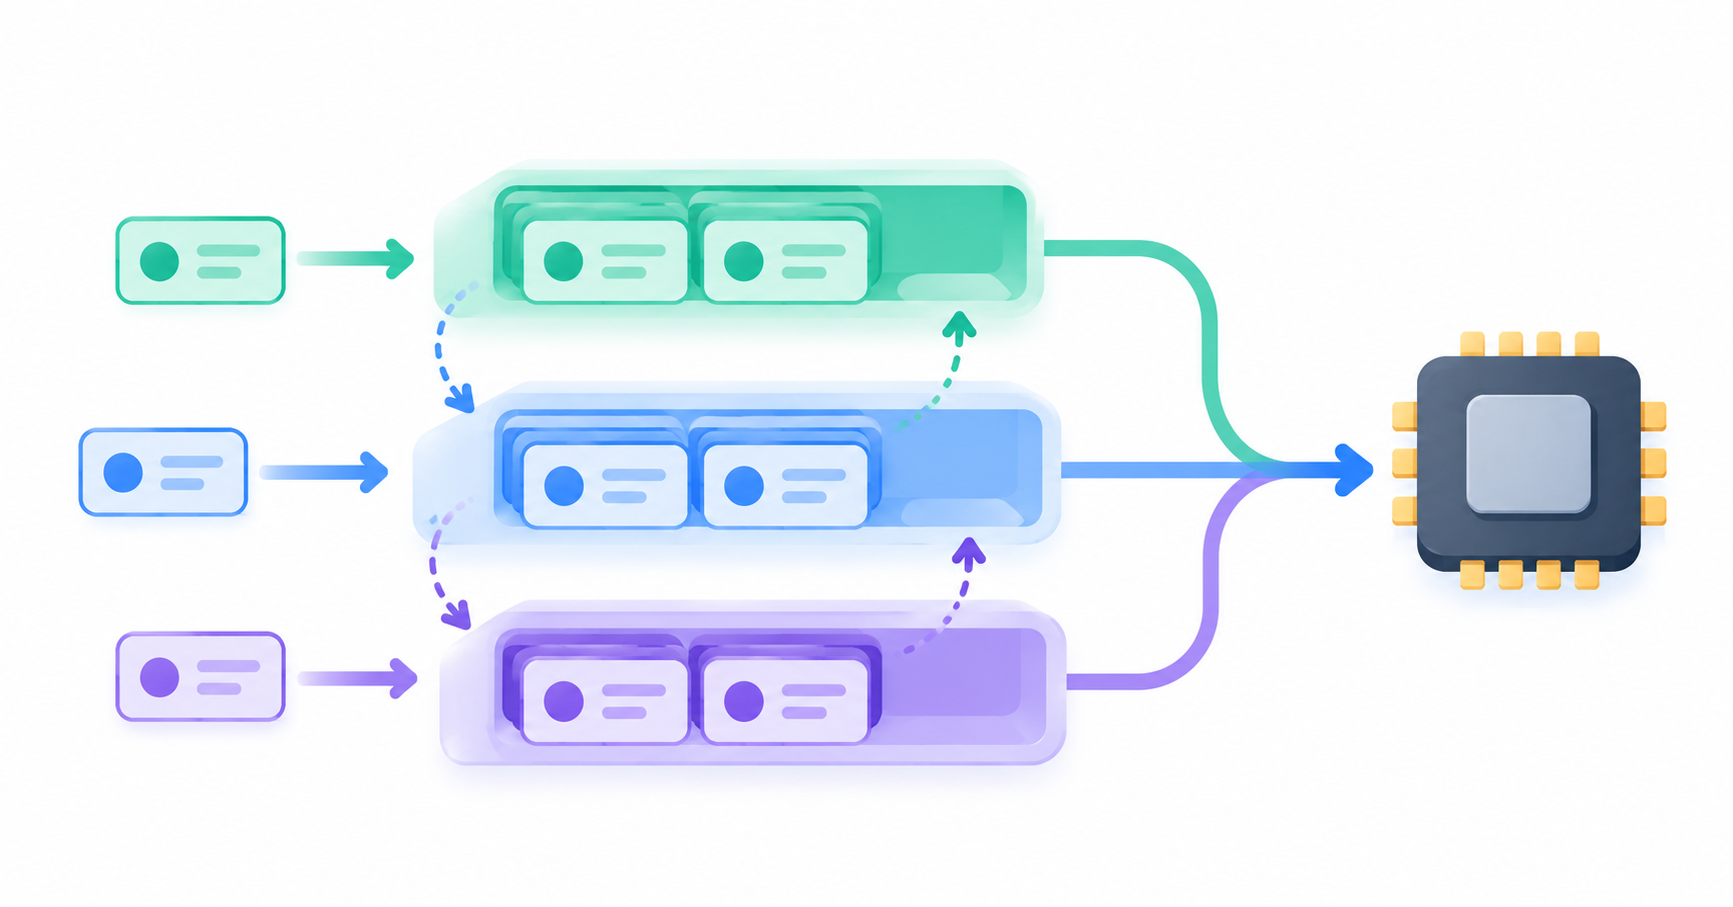
지금까지는 Ready 큐가 하나라고 보고 거기에 알고리즘 하나를 적용했습니다. 그런데 큐가 하나면 모든 프로세스가 같은 규칙을 적용받습니다. 사용자 입력을 기다리는 프로그램과 밤새 돌리는 계산 작업이 같은 줄에 서는 셈입니다.
multilevel queue는 Ready 큐를 여러 개로 나눕니다. 위쪽 큐일수록 우선순위가 높고(highest priority), 아래로 갈수록 낮습니다(lowest priority).
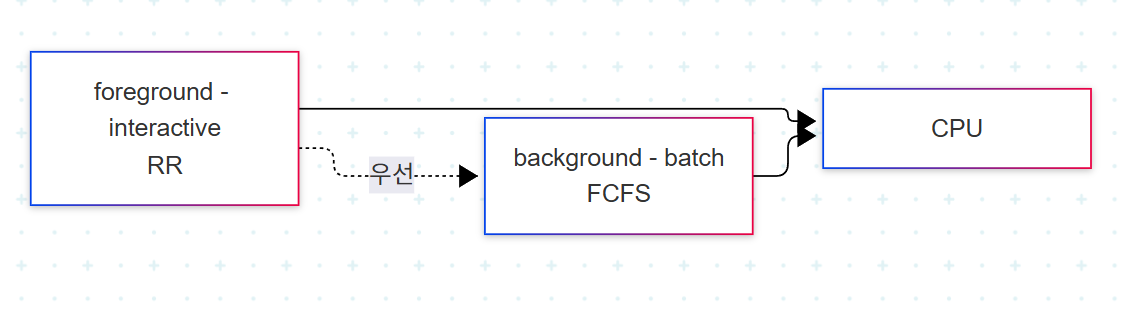
큐마다 성격에 맞는 알고리즘을 따로 씁니다. 상호작용이 필요한 foreground 큐는 응답시간이 중요하므로 RR을, 끝나기만 하면 되는 background 큐는 문맥 교환을 아끼기 위해 FCFS를 씁니다.
그러면 새 문제가 생깁니다. 큐가 여러 개니까 어느 큐를 먼저 볼지도 정해야 합니다. 방법이 둘입니다.
- 고정 우선순위 스케줄링(fixed priority scheduling): 위쪽 큐를 먼저 다 처리한 뒤 아래 큐로 갑니다. 단순하지만 아래 큐가 기아에 빠질 수 있습니다
- time slice: 각 큐에 CPU 시간의 일정 비율을 배분합니다. 예를 들어 foreground에 80%, background에 20%를 주면 아래 큐도 최소한의 몫을 보장받습니다
2. 큐 사이를 옮길 수 있게 하면
multilevel queue에는 한계가 있습니다. 한번 배정된 큐에서 프로세스가 영원히 나오지 못합니다. 그런데 프로세스의 성격은 고정이 아닙니다. 계산만 하던 작업이 갑자기 사용자 입력을 기다릴 수도 있습니다.
multilevel feedback queue는 프로세스가 큐 사이를 이동할 수 있게 합니다.
- CPU를 오래 쓰는 프로세스는 아래 큐로 내려보냅니다. 성격이 batch에 가깝다고 판단한 것입니다
- 아래 큐에서 오래 기다린 프로세스는 위 큐로 올려 줍니다
두 번째가 곧 aging의 구현입니다. 앞 글에서 기아를 막는 방법으로 봤던 "기다린 만큼 우선순위를 올린다"를 큐 이동으로 실현한 것입니다.
작은 예제
큐가 셋이고 Q0은 RR 할당 시간 8, Q1은 RR 할당 시간 16, Q2는 FCFS입니다. CPU burst가 30인 프로세스가 들어옵니다.
- Q0에 배치되어 8만큼 실행합니다. 다 못 끝냈으므로 Q1로 내려갑니다. 남은 양 22
- Q1에서 16만큼 실행합니다. 역시 못 끝냈으므로 Q2로 내려갑니다. 남은 양 6
- Q2에서 FCFS로 나머지 6을 실행합니다
짧은 작업은 Q0에서 바로 끝나 빠른 응답을 받고, 긴 작업은 자연히 아래로 내려가 문맥 교환을 덜 겪습니다. 작업 길이를 미리 묻지 않고도 SJF 비슷한 효과를 냅니다.
| 구분 | multilevel queue | multilevel feedback queue |
|---|---|---|
| 큐 간 이동 | 불가능 | 가능 |
| 프로세스 분류 | 처음에 한 번 고정 | 실행 양상을 보고 계속 조정 |
| 기아 | 아래 큐에서 발생 가능 | 승격으로 완화 (aging) |
| 구현 난이도 | 낮음 | 높음 (큐 수, 할당 시간, 이동 기준을 모두 정해야 함) |
3. CPU가 여러 개일 때
CPU가 하나면 "누구에게 줄까"만 정하면 됩니다. 여러 개면 "누구에게, 어느 CPU를" 정해야 하므로 훨씬 복잡해집니다.
CPU들의 성능과 기능이 모두 같은 경우를 homogeneous라고 합니다. 이때는 어느 CPU에 올려도 결과가 같으므로 큐 하나에 세워 두고 비는 CPU가 가져가게 할 수 있습니다. 다만 특정 CPU에만 일이 몰리지 않도록 load sharing, 즉 부하를 나누는 장치가 필요합니다.
운영체제 자체를 누가 돌리느냐로도 나뉩니다.
| 구분 | symmetric multiprocessing (SMP) | asymmetric multiprocessing (AMP) |
|---|---|---|
| 스케줄링 주체 | 각 CPU가 스스로 결정 | 하나의 주 CPU가 전체를 결정 |
| 커널 실행 | 모든 CPU가 커널 코드 실행 가능 | 주 CPU만 실행, 나머지는 시키는 일만 |
| 장점 | 확장성이 좋음 | 구조가 단순 |
| 단점 | 여러 CPU가 공유 자료를 건드려 조율이 필요 | 주 CPU가 병목 |
4. 마감이 있는 일
일반 프로그램은 조금 늦어도 결과만 맞으면 됩니다. 그러나 정해진 시간 안에 끝나야만 의미가 있는 작업도 있습니다.
| 구분 | hard real-time system | soft real-time computing |
|---|---|---|
| 마감 | 반드시 지켜야 함 | 지키면 좋음 |
| 못 지키면 | 시스템 실패로 간주 | 품질 저하 |
| 예 | 제어 장치처럼 정해진 시각에 동작해야 하는 시스템 | 동영상 재생처럼 끊기면 곤란한 작업 |
hard real-time은 스케줄링이 아니라 설계의 문제에 가깝습니다. 최악의 경우에도 마감을 지킬 수 있는지 미리 계산해 두어야 합니다.
5. 스레드 스케줄링
3편에서 본 유저 스레드와 커널 스레드에 따라 스케줄링 주체가 갈립니다.
- local scheduling (user level): 커널은 스레드의 존재를 모르므로, 사용자 수준 라이브러리가 그 프로세스 안의 어느 스레드를 돌릴지 정합니다
- global scheduling (kernel level): 커널이 시스템 전체 스레드 중에서 다음에 돌릴 것을 정합니다
6. 알고리즘은 어떻게 평가할까
새 스케줄링 방식을 만들었다면 좋은지 확인해야 합니다. 방법이 셋입니다.
| 방법 | 내용 | 특징 |
|---|---|---|
| queueing models | 도착률과 처리율을 확률 분포로 놓고 수식으로 계산 | 빠르지만 현실을 단순화함 |
| simulation | 가상의 작업 부하를 만들어 모의 실행 | 실제 실행 기록(trace)을 쓰면 신뢰도가 올라감 |
| implementation and measurement | 실제로 구현해 시스템에 넣고 측정 | 가장 정확하지만 비용이 큼 |