1. open addressing: 주변 빈칸에 넣는다
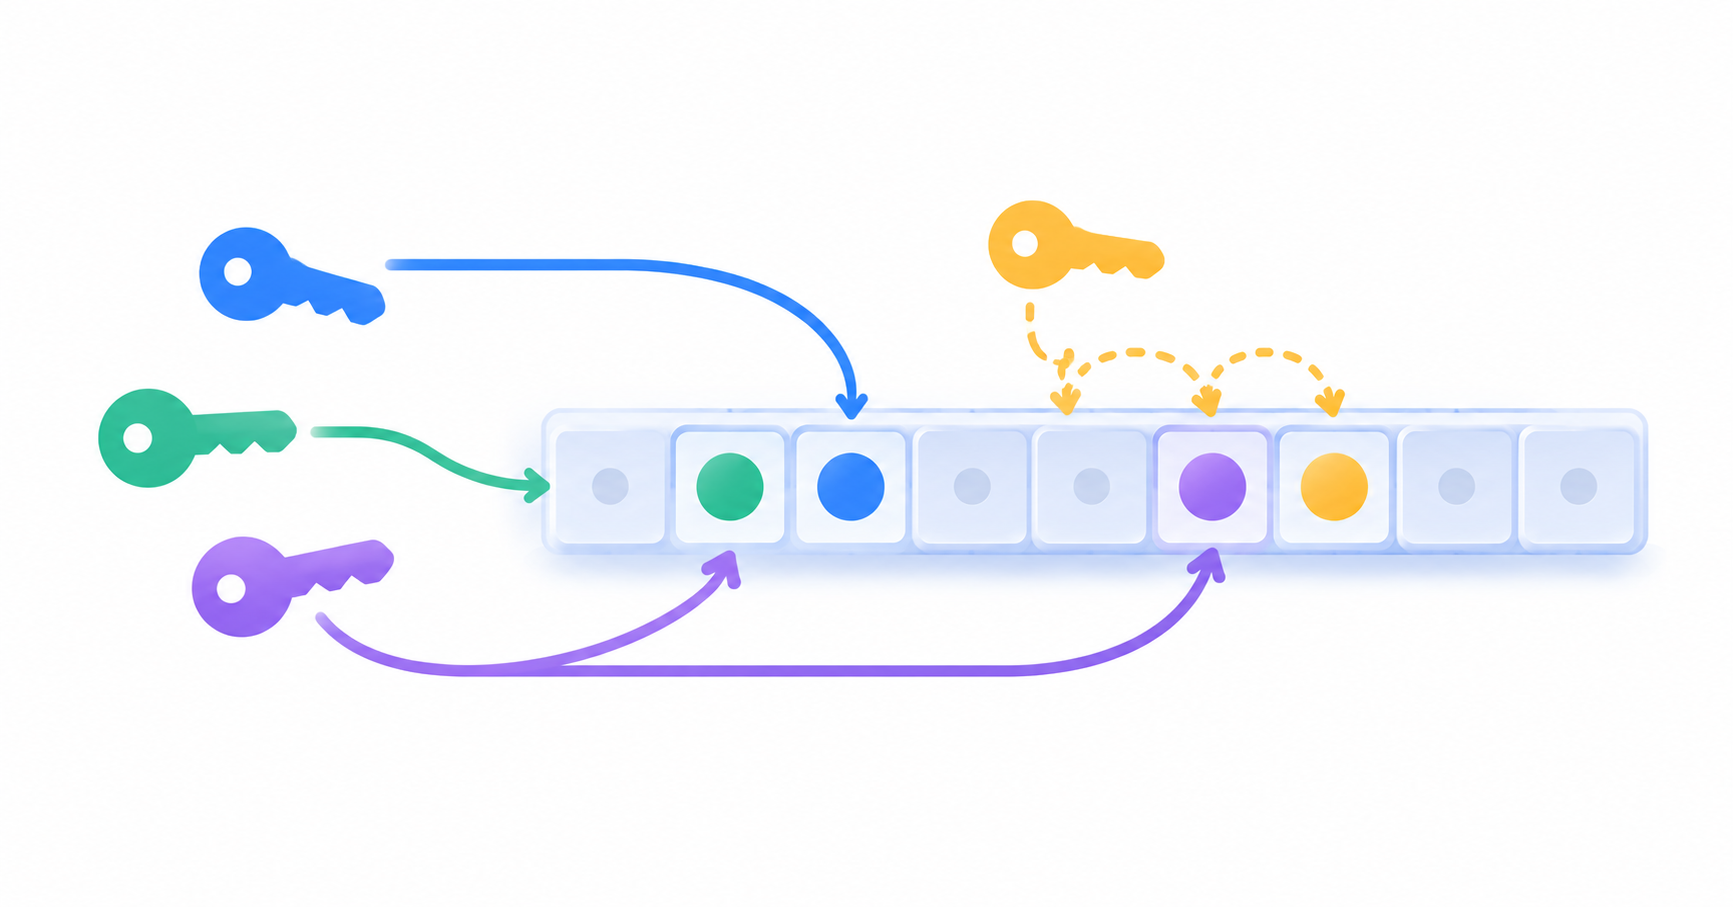
충돌이 나면 그 주위에서 빈칸을 찾아 넣는 방식을 open addressing이라고 합니다. 빈칸을 찾아가는 규칙에 따라 linear probing, quadratic probing, double hashing으로 나뉩니다.
가장 단순한 것은 linear probing입니다. 충돌한 자리에서 한 칸씩 아래로 내려가며 빈칸을 찾습니다.
before: h(k) = k % 10, 53을 넣기 전
slot   0    1    2    3    4    5    6    7
     +----+----+----+----+----+----+----+----+
     |    |    | 32 | 43 | 24 |    |    |    |
     +----+----+----+----+----+----+----+----+
                 ^^^^^^^^^^^^^^
                    cluster
after: 53은 3번이 차 있어 4번, 4번도 차 있어 5번에 자리를 잡습니다
slot   0    1    2    3    4    5    6    7
     +----+----+----+----+----+----+----+----+
     |    |    | 32 | 43 | 24 | 53 |    |    |
     +----+----+----+----+----+----+----+----+
                 ^^^^^^^^^^^^^^^^^^^
                    cluster가 더 커졌다
이렇게 값이 뭉쳐 있는 덩어리를 클러스터(cluster)라고 합니다. 클러스터가 크면 빈칸까지 가는 거리가 길어져 삽입 시간이 오래 걸립니다. 게다가 큰 클러스터일수록 새 키가 걸릴 확률도 높아 더 커집니다.
2. find_slot으로 세 연산을 만든다
open addressing의 연산은 find_slot 하나에서 나옵니다. find_slot은 키가 있으면 그 슬롯 번호를, 없으면 삽입될 빈 슬롯 번호를 반환합니다. while문으로 한 칸씩 내려가며 구현합니다.
def find_slot(self, key):
    i = self.hash(key)
    while self.H[i] is not None and self.H[i].key != key:
        i = (i + 1) % self.m        # 한 칸 아래로, 끝이면 처음으로
    return i                        # 찾은 슬롯 또는 빈 슬롯
빈 슬롯이 하나도 없으면 이 while문이 끝나지 않습니다. 테이블에 여유를 남겨 두는 것이 정확성 조건이기도 합니다.
def set(self, key, value=None):
    i = self.find_slot(key)
    if self.H[i] is not None:
        self.H[i].value = value     # 있으면 갱신
    else:
        self.H[i] = Entry(key, value)   # 없으면 추가
        self.size += 1

def search(self, key):
    i = self.find_slot(key)
    if self.H[i] is None:
        return None
    return self.H[i].value
3. 삭제가 골치 아픈 이유
remove는 단순히 슬롯을 비우면 되는 일이 아닙니다. 슬롯을 비우는 순간 탐색의 고리가 끊어지기 때문입니다.
before: 43을 삭제하기 전, 53은 3 → 4 → 5를 거쳐 찾습니다.
slot   2    3    4    5
     +----+----+----+----+
     | 32 | 43 | 24 | 53 |
     +----+----+----+----+
after: 43을 지우고 빈칸으로 두면
slot   2    3    4    5
     +----+----+----+----+
     | 32 |    | 24 | 53 |
     +----+----+----+----+
            ^
53을 찾던 탐색이 여기서 멈춘다find_slot은 빈 슬롯을 만나면 "없다"고 판단합니다. 53은 3번에서 출발하는데 3번이 비어 있으니, 5번에 멀쩡히 있는데도 못 찾습니다.
해결 방법은 두 가지입니다. 하나는 지운 자리에 삭제 표시를 남겨서 탐색은 통과시키고 삽입만 그 자리를 재사용하게 하는 것이고, 다른 하나는 뒤쪽 클러스터의 원소들을 앞으로 당겨 구멍을 메우는 것입니다.
4. quadratic probing과 double hashing
linear probing은 충돌할 때마다 바로 옆에 붙이므로 클러스터를 키웁니다. 클러스터를 키우는 규칙은 좋은 방식이 아닙니다. 그래서 나온 것이 quadratic probing과 double hashing입니다.
- quadratic probing: 1, 4, 9처럼 제곱 간격으로 건너뜁니다.
(h(k) + j²) % m - double hashing: 건너뛸 간격을 두 번째 해시 함수로 정합니다.
(h₁(k) + j·h₂(k)) % m
옆자리에 붙지 않으므로 덩어리가 덜 생깁니다. 대신 흩어진 자리를 찾아가느라 참조가 튀는 비용이 붙습니다.
5. 성능을 결정하는 것
성능은 세 가지가 물려 정해집니다. 충돌 해결 방법, 해시 함수, 그리고 적재율(load factor)입니다. 이 셋이 클러스터 크기를 만들고, 클러스터 크기가 set, search, remove의 수행 시간을 만듭니다.
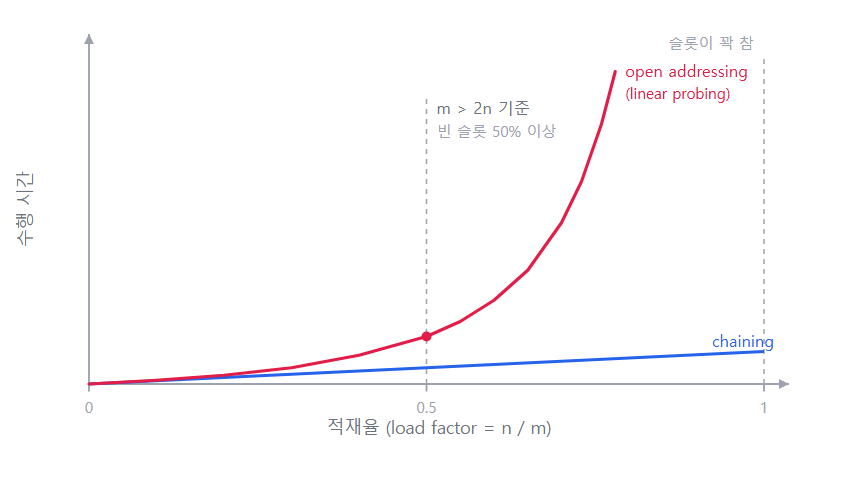
적재율은 슬롯 대비 저장된 키의 비율이고, 수행 시간은 여기에 비례해 올라갑니다. 충돌이 난 횟수를 키 개수 n으로 나눈 값을 충돌 비율로 보면 상황을 가늠할 수 있습니다.
실용적인 기준은 m > 2n입니다. 슬롯을 키 개수의 두 배 이상 잡아 절반 이상을 비워 두면 클러스터의 평균 크기가 O(1)로 유지됩니다. 이때 세 연산 모두 평균 상수 시간이 되어 매우 빠릅니다.
6. chaining: 슬롯마다 연결 리스트
다른 접근은 chaining입니다. 빈칸을 찾아다니지 않고, 각 슬롯에 단방향 연결 리스트를 두어 같은 슬롯에 온 키들을 이어 붙입니다.
slot
  0 -> None
  1 -> None
  2 -> [32] -> None
  3 -> [43] -> [53] -> None
4 -> [24] -> Noneset은 리스트 맨 앞에 넣으면 되므로 O(1)입니다. search는 해당 슬롯의 리스트를 훑어야 해서, 그 슬롯에 몰린 키 개수, 즉 리스트 길이에 비례합니다. remove는 리스트에서 노드를 빼면 끝이라 open addressing 같은 고리 끊김 문제가 없습니다.
7. 시간복잡도
| 연산 | open addressing 평균 | chaining 평균 | 공통 최악 |
|---|---|---|---|
search | O(1) (m > 2n일 때) | O(1 + n/m) | O(n) |
set | O(1) | O(1) | O(n) |
remove | O(1) | O(1) | O(n) |
최악 O(n)은 모든 키가 한 슬롯으로 몰린 경우입니다. open addressing에서는 테이블 전체가 하나의 클러스터가 된 상태이고, chaining에서는 연결 리스트 하나에 전부 매달린 상태입니다.