1. 릴레이션 하나로 끝나지 않는 질문
2편에서 정의한 테이블에 다음 데이터를 넣고 시작합니다.
INSERT INTO department VALUES
  ('CSE','컴퓨터공학','공학관'), ('MTH','수학','자연관'), ('BIZ','경영','경영관');
INSERT INTO student VALUES
  (1001,'김민수','CSE',3), (1002,'이서연','CSE',2),
  (1003,'박지훈','MTH',4), (1004,'최유나',NULL,1);
INSERT INTO course VALUES
  ('C101','데이터베이스',3,'CSE'), ('C102','운영체제',3,'CSE'),
  ('M201','선형대수',2,'MTH'), ('M202','해석학',4,'MTH');
INSERT INTO enroll VALUES
  (1001,'C101','2014-1','A'), (1001,'M201','2014-1','B'),
  (1002,'C101','2014-1','B'), (1003,'M202','2014-1','A');
"C101이나 M201을 들은 학생", "같은 학과 학생 쌍" 같은 질문은 결과 두 개를 붙이거나 릴레이션을 겹쳐야 답이 나옵니다.
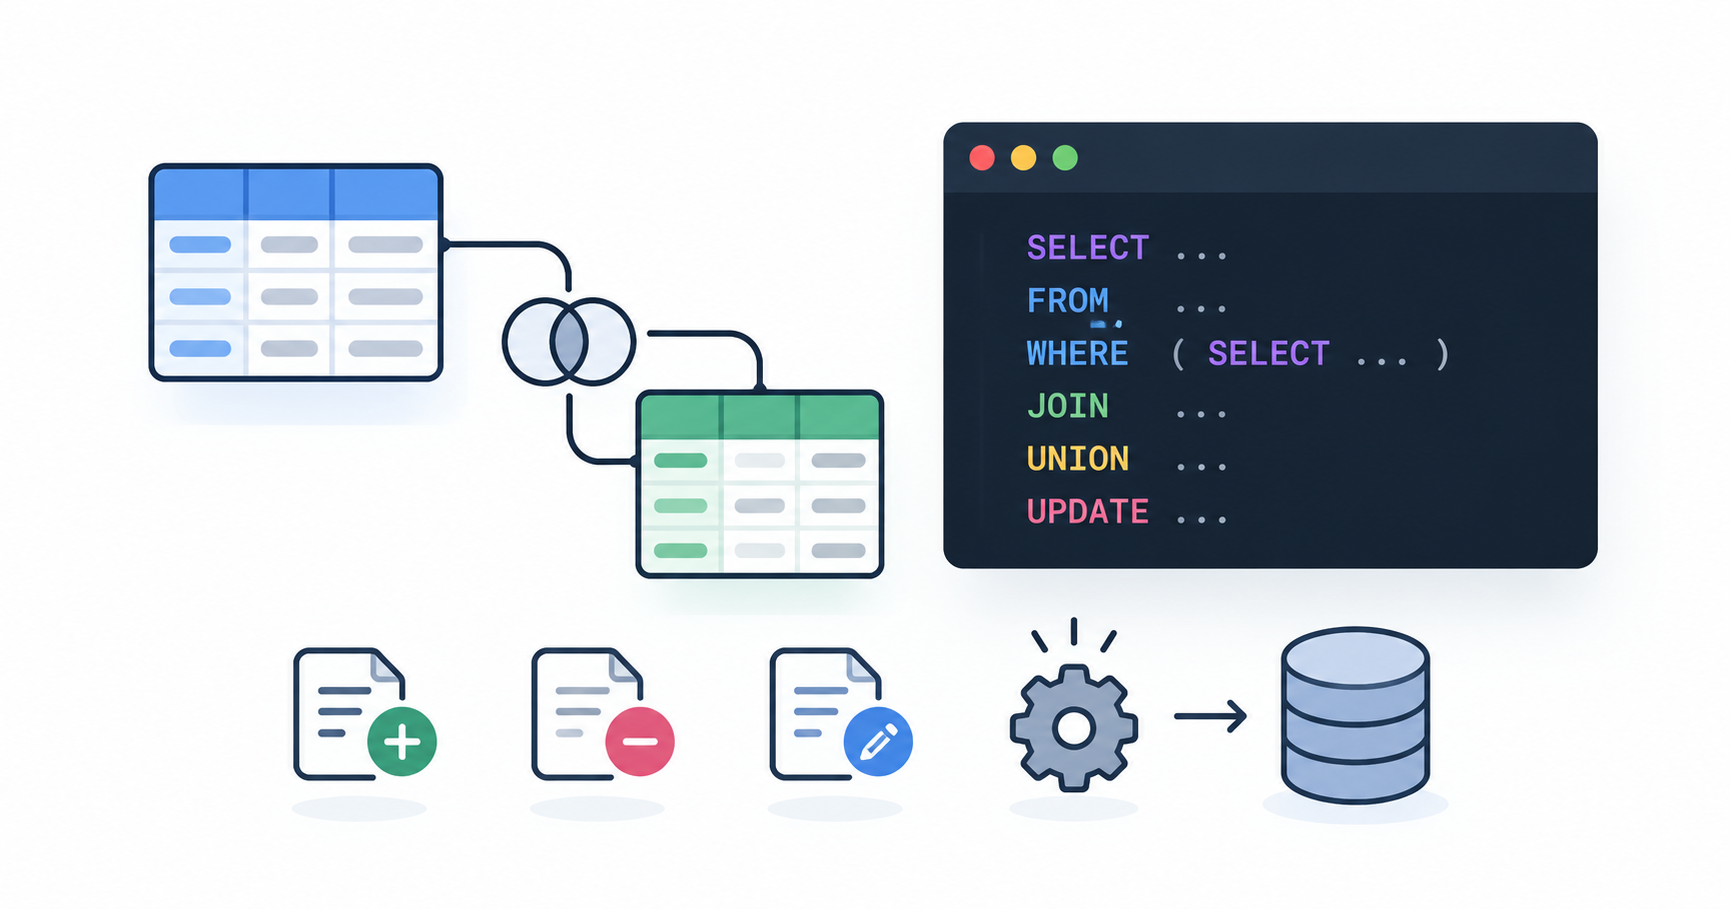
집합 연산(UNION, INTERSECT, EXCEPT)은 합집합 호환성(union compatibility)이 전제입니다. 조인(join)은 두 개 이상의 릴레이션에서 연관된 튜플을 결합하고, 자체 조인(self join)은 한 릴레이션을 별칭 두 개로 나눠 자기 자신과 조인합니다.
-- 합집합: C101 또는 M201 수강자 (결과: 1001, 1002)
SELECT sid FROM enroll WHERE cid = 'C101'
UNION
SELECT sid FROM enroll WHERE cid = 'M201';

-- 자체 조인: 같은 학과 학생 쌍 (결과: 김민수-이서연)
SELECT s1.name, s2.name
FROM student s1 JOIN student s2
  ON s1.dept_id = s2.dept_id AND s1.sid < s2.sid;
s1.sid < s2.sid 조건이 자기 자신과의 쌍과 (A,B)/(B,A) 중복을 동시에 걸러냅니다. 관계대수로는 ρ로 릴레이션 이름을 바꿔 세타 조인한 것과 같습니다.
2. 중첩 질의
조인만으로 "학과 평균 학점보다 큰 과목"을 쓰려면 중간 결과를 먼저 만들어야 합니다. 중첩 질의(nested query)는 외부 질의의 WHERE 절 안에 SELECT-FROM-WHERE를 다시 넣어 이를 해결합니다.
| 연산자 | 의미 | 부질의 결과가 비면 |
|---|---|---|
IN | 결과 집합에 포함되는가 | 거짓 |
> ANY | 하나라도 그보다 큰가 | 거짓 |
>= ALL | 전부 그 이하인가 | 참 |
EXISTS | 튜플이 하나라도 있는가 | 거짓 |
-- ALL: 학점이 가장 큰 과목 (결과: 해석학)
SELECT title FROM course
WHERE credit >= ALL (SELECT credit FROM course);
상관 중첩 질의(correlated nested query)는 부질의가 외부 질의의 애트리뷰트를 참조하는 형태입니다. 개념적으로 외부 튜플마다 부질의가 다시 평가됩니다.
-- 자기 학과 평균보다 학점이 큰 과목 (결과: 해석학)
SELECT c.title FROM course c
WHERE c.credit > (SELECT AVG(c2.credit) FROM course c2
                  WHERE c2.dept_id = c.dept_id);

-- NOT EXISTS: 소속 학생이 없는 학과 (결과: 경영)
SELECT d.dept_name FROM department d
WHERE NOT EXISTS (SELECT 1 FROM student s WHERE s.dept_id = d.dept_id);
마지막 질의는 관계대수의 πdept_id(department) − πdept_id(student)에 해당합니다.
3. INSERT, DELETE, UPDATE
조회만 되면 데이터베이스는 정적 파일과 다르지 않습니다. 변경 대상을 고를 때도 앞의 부질의를 그대로 씁니다.
UPDATE student SET year = year + 1
WHERE sid IN (SELECT sid FROM enroll WHERE cid = 'C101');

DELETE FROM enroll
WHERE sid IN (SELECT sid FROM student WHERE dept_id = 'MTH');
다른 테이블 값으로 갱신할 때 SQL Server와 PostgreSQL 모두 UPDATE ... FROM 확장을 제공하지만 문법이 서로 다르고 표준도 아닙니다. 이식성이 필요하면 위처럼 부질의로 씁니다.
4. 트리거와 ECA 규칙
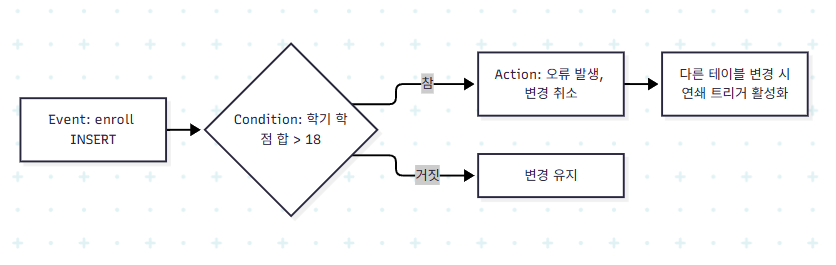
"한 학기 18학점 초과 불가" 같은 규칙을 애플리케이션에만 두면 배치나 관리 도구로 들어온 INSERT는 그냥 통과합니다. 트리거(trigger)는 명시된 이벤트가 발생할 때마다 DBMS가 자동으로 수행하는, 사용자가 정의한 문입니다. 이벤트를 받아 조건을 검사하고 동작을 수행하므로 ECA 규칙(Event-Condition-Action rule)이라고도 부릅니다.
-- SQL Server: 변경된 행은 inserted / deleted 가상 테이블로 받습니다
CREATE TRIGGER trg_credit_limit ON enroll
AFTER INSERT, UPDATE
AS
BEGIN
  IF EXISTS (
    SELECT 1 FROM (SELECT DISTINCT sid, semester FROM inserted) i
    WHERE (SELECT SUM(c.credit) FROM enroll e JOIN course c ON e.cid = c.cid
           WHERE e.sid = i.sid AND e.semester = i.semester) > 18)
  BEGIN
    ROLLBACK TRANSACTION;
    THROW 50001, N'학기당 18학점 초과', 1;
  END
END;
PostgreSQL은 RETURNS trigger 함수를 먼저 만들고 FOR EACH ROW로 연결하며, 변경 행은 NEW/OLD로 참조합니다. SQL Server는 문장 단위로만 동작하고 BEFORE 시점이 없다는 점이 큰 차이입니다.
트리거의 동작이 다른 테이블을 바꿔 또 다른 트리거를 깨우는 연쇄 트리거도 가능합니다. SQL Server는 중첩을 32단계까지 허용하고, 그 안에서 무한 루프가 생기면 한도를 넘는 순간 트랜잭션 전체가 취소됩니다.
5. 주장(assertion)
CHECK는 한 행 안에서 닫히는 조건에 적합합니다. 위의 학점 규칙은 enroll과 course 두 릴레이션에 걸쳐 있어 CHECK로 쓰기 어렵습니다. 주장(assertion)은 데이터베이스가 항상 만족해야 하는 조건을 특정 테이블에 매달지 않고 선언합니다.
| 방식 | 범위 | 성격 | 지원 |
|---|---|---|---|
CHECK | 한 행 | 선언적 | 대부분 지원 |
| 주장 | 여러 릴레이션 | 선언적 | 표준에만 존재 |
| 트리거 | 제한 없음 | 절차적 | 대부분 지원 |
읽기는 쉽지만 어떤 변경이 조건을 깨는지 DBMS가 스스로 판단해야 해서 검사 비용이 큽니다. PostgreSQL은 표준 기능 F521(Assertions)을 미지원으로 명시하고 CREATE ASSERTION에 미구현 오류를 냅니다. SQL Server에도 없습니다.
6. 내포된 SQL
SQL은 집합 단위로 동작할 뿐 조건 분기나 반복, 출력은 표현하지 못합니다. 내포된 SQL(embedded SQL)은 C 같은 호스트 언어(host language) 코드 안에 SQL을 넣는 방식으로, EXEC SQL 문장을 전처리기가 라이브러리 호출로 바꿉니다. 호스트 변수는 콜론을 붙여 전달하고, 여러 행이 나오는 질의는 커서(cursor)로 한 행씩 가져옵니다.
EXEC SQL DECLARE cur CURSOR FOR
  SELECT sid, name FROM student WHERE dept_id = 'CSE';
EXEC SQL OPEN cur;
EXEC SQL FETCH NEXT FROM cur INTO :v_sid, :v_name;
EXEC SQL CLOSE cur;
지금은 JDBC, psycopg 같은 드라이버와 ORM이 같은 자리를 차지합니다. "값은 변수로 바인딩하고 결과 집합은 한 행씩 소비한다"는 구조는 그대로입니다.