1. 관계 대수만 있으면 무엇이 문제인가
앞 편에서 본 관계 대수는 절차적입니다. 무엇을 어떤 순서로 계산할지 사람이 직접 적어야 하고, 산술 연산도 정렬도 갱신도 안 됩니다. 실제 데이터베이스를 쓰려면 그것들이 전부 필요합니다.
SQL은 1974년 IBM 산호세 연구소에서 System R이라는 관계 DBMS 시제품을 만들며 나왔습니다. 챔벌린(Chamberlin)과 보이스(Boyce)가 발표한 SEQUEL(Structured English Query Language)이 원형이고, 상표 문제로 이름이 SQL로 줄었습니다. 관계 대수와 관계 해석을 기반으로 집단 함수, 그룹화, 갱신 연산을 얹은 결과물입니다. 그래서 SQL은 비절차적(선언적) 언어이면서 자연어에 가까운 구문을 갖습니다.
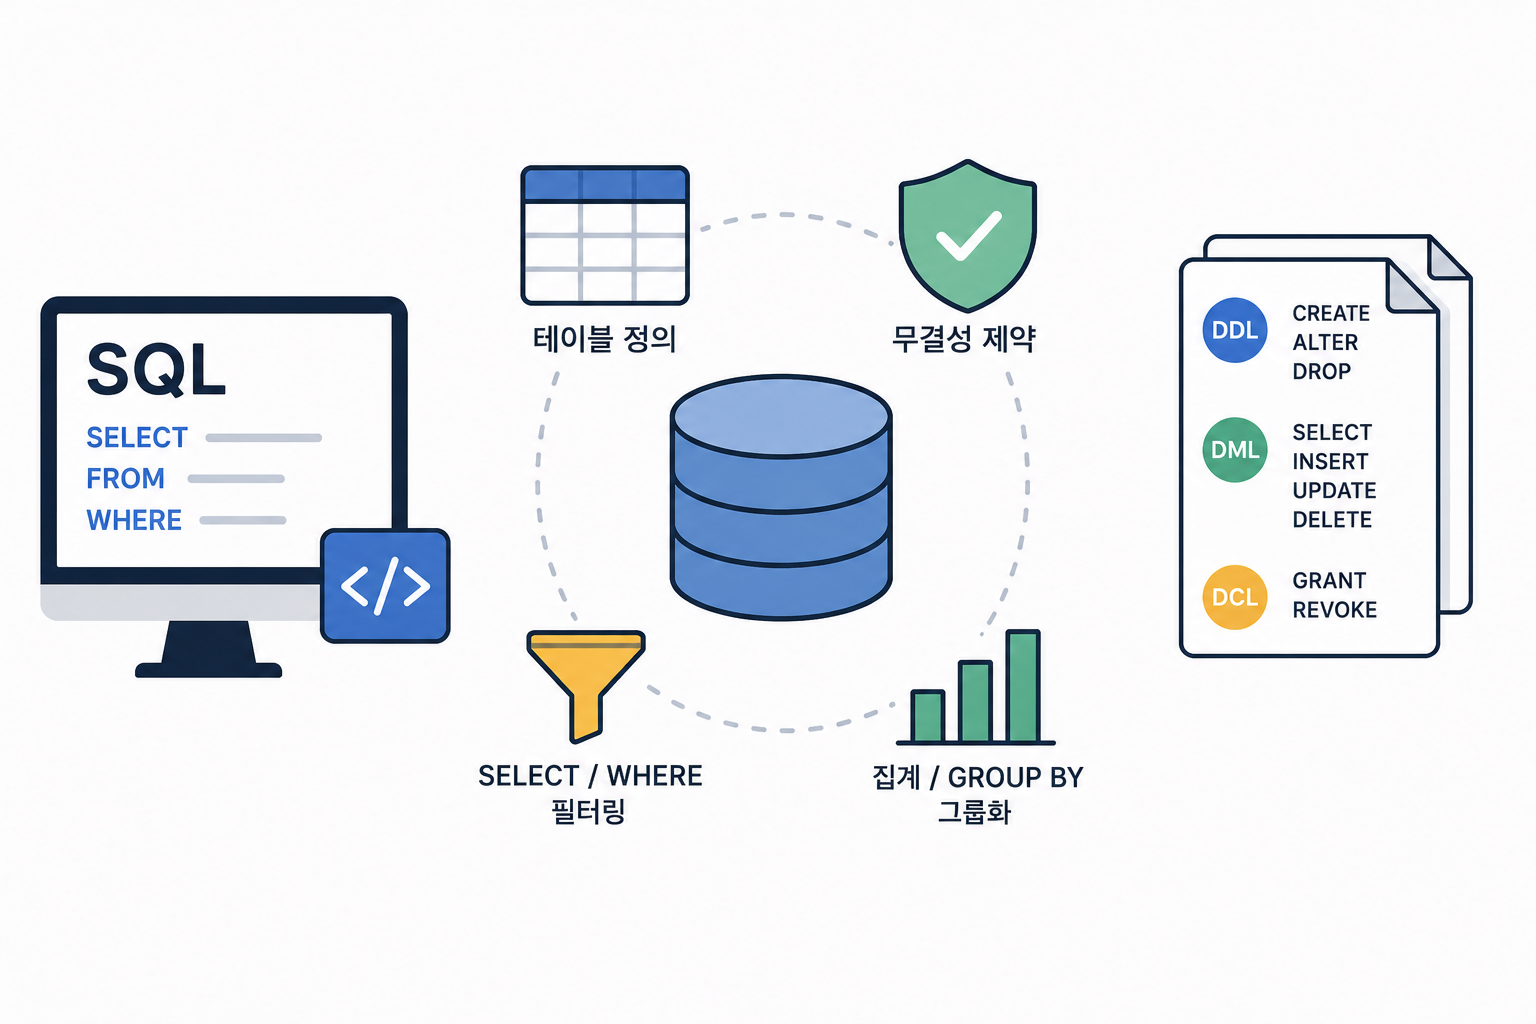
구성요소는 셋입니다.
- 데이터 정의어(DDL, Data Definition Language):
CREATE,ALTER,DROP - 데이터 조작어(DML, Data Manipulation Language):
SELECT,INSERT,UPDATE,DELETE - 데이터 제어어(DCL, Data Control Language):
GRANT,REVOKE
2. 테이블 정의와 데이터 타입
CREATE TABLE department (
  dept_id   CHAR(3)     NOT NULL,
  dept_name VARCHAR(30) NOT NULL,
  building  VARCHAR(20),
  CONSTRAINT pk_department PRIMARY KEY (dept_id)
);| 구분 | CHAR(n) | VARCHAR(n) |
|---|---|---|
| 저장 길이 | 항상 n바이트 고정 | 실제 길이 + 길이 정보 |
| 남는 자리 | 공백으로 채움 | 채우지 않음 |
| 유리한 경우 | 길이가 거의 일정 (dept_id, 국가 코드) | 길이 편차가 큼 (이름, 주소) |
| 주의 | 비교 시 뒤쪽 공백 처리가 DBMS마다 다름 | 길이 정보만큼 오버헤드 |
한글은 SQL Server에서 오래도록 NCHAR/NVARCHAR를 써야 했습니다. 2019부터 UTF-8 콜레이션이 생겨 VARCHAR로도 다룰 수 있습니다. PostgreSQL은 VARCHAR와 TEXT 사이에 성능 차이가 없어 길이 제한이 업무 규칙일 때만 n을 붙입니다.
조회 성능을 위한 인덱스는 CREATE INDEX로 만들지만, 어떤 열에 어떻게 걸지는 6편에서 다룹니다.
3. 무결성 제약조건
제약조건이 없으면 존재하지 않는 학과 코드를 가진 학생 행이 조용히 쌓입니다. 애플리케이션 코드가 아무리 검증해도 배치 작업 하나가 우회하면 끝입니다. 참조 무결성(referential integrity)은 외래키 값이 반드시 부모 릴레이션에 존재하는 값이거나 NULL이어야 한다는 제약입니다.
CREATE TABLE student (
  sid     INT         NOT NULL,
  name    VARCHAR(20) NOT NULL,
  dept_id CHAR(3),
  year    INT,
  CONSTRAINT pk_student PRIMARY KEY (sid),
  CONSTRAINT fk_student_dept FOREIGN KEY (dept_id)
    REFERENCES department(dept_id)
    ON DELETE SET NULL ON UPDATE CASCADE,
  CONSTRAINT ck_student_year CHECK (year BETWEEN 1 AND 4)
);
부모 행이 삭제되거나 키가 바뀔 때의 동작은 네 가지입니다.
| 옵션 | 자식 행에 일어나는 일 | 조건 |
|---|---|---|
NO ACTION | 위반이면 연산을 거부 | 기본값 |
CASCADE | 함께 삭제 또는 함께 변경 | 연쇄 삭제 범위 확인 필요 |
SET NULL | 외래키를 NULL로 | 그 열이 NULL 허용이어야 함 |
SET DEFAULT | 외래키를 기본값으로 | 기본값이 부모에 존재해야 함 |
SQL Server는 이 네 가지를 지원하고, PostgreSQL은 RESTRICT를 더해 다섯 가지입니다. NO ACTION은 검사를 트랜잭션 끝으로 미룰 수 있고 RESTRICT는 즉시 막는다는 차이입니다.
제약조건에 pk_, fk_, ck_ 같은 이름을 직접 붙이면 위배 시 오류 메시지에 그 이름이 찍힙니다. 이름을 생략하면 FK__student__dept___1234ABCD 같은 자동 생성 이름이 나와 어느 조건인지 찾는 데 시간이 걸립니다.
4. SELECT의 뼈대
SELECT와 FROM만 필수이고 나머지는 선택입니다. 관계 대수와 이렇게 대응합니다.
-- π_{name, year}(σ_{dept_id='CSE'}(student))
SELECT s.name AS 학생명, s.year        -- 프로젝션, 별칭
FROM   student s                       -- 카티션 곱 / 조인
WHERE s.dept_id = 'CSE'; -- 셀렉션*는 모든 애트리뷰트를 뜻하는 와일드카드이고, DISTINCT는 중복을 제거해 관계 대수의 프로젝션과 같은 결과를 만듭니다. 별칭(alias)은 조인에서 같은 이름의 애트리뷰트를 구분할 때 필수입니다.
WHERE 절 연산자의 우선순위는 산술 → 비교 → NOT → AND → OR입니다. AND가 OR보다 먼저 묶이므로, 섞어 쓸 때는 괄호를 넣는 편이 안전합니다.
SELECT * FROM student WHERE year BETWEEN 2 AND 3;      -- 범위
SELECT * FROM student WHERE dept_id IN ('CSE','MTH');  -- 리스트
SELECT * FROM student WHERE name LIKE '김%';           -- 패턴
SELECT sid, credit * 1.0 AS point FROM course; -- 산술 연산LIKE에서 %는 0자 이상, _는 정확히 한 글자입니다.
5. NULL은 값이 아니라 Unknown
NULL은 "모른다"입니다. 값이 아니므로 = NULL은 참도 거짓도 아닌 unknown이 되고, 그 행은 결과에서 빠집니다. 반드시 IS NULL / IS NOT NULL을 씁니다.
집단 함수는 COUNT(*)를 제외하면 NULL을 무시합니다. 평균을 낼 때 NULL인 행이 분모에서 빠진다는 뜻이라, "전체 평균"을 기대하면 값이 어긋납니다.
ORDER BY의 NULL 위치도 갈립니다. SQL Server는 NULL을 가장 작은 값으로 봐서 오름차순에서 앞에 두고, PostgreSQL은 기본이 뒤쪽이며 NULLS FIRST로 바꿀 수 있습니다.
6. 집계와 그룹화
집단 함수는 COUNT, SUM, AVG, MAX, MIN 다섯 가지입니다. GROUP BY는 지정한 애트리뷰트 값이 같은 튜플들을 한 그룹으로 묶고, 집단 함수는 그룹마다 한 번씩 계산됩니다.
SELECT dept_id, COUNT(*) AS cnt, AVG(year) AS avg_year
FROM   student
GROUP  BY dept_id
ORDER  BY cnt DESC;