1. 계층 구조: 위에서부터 내려가는 지도
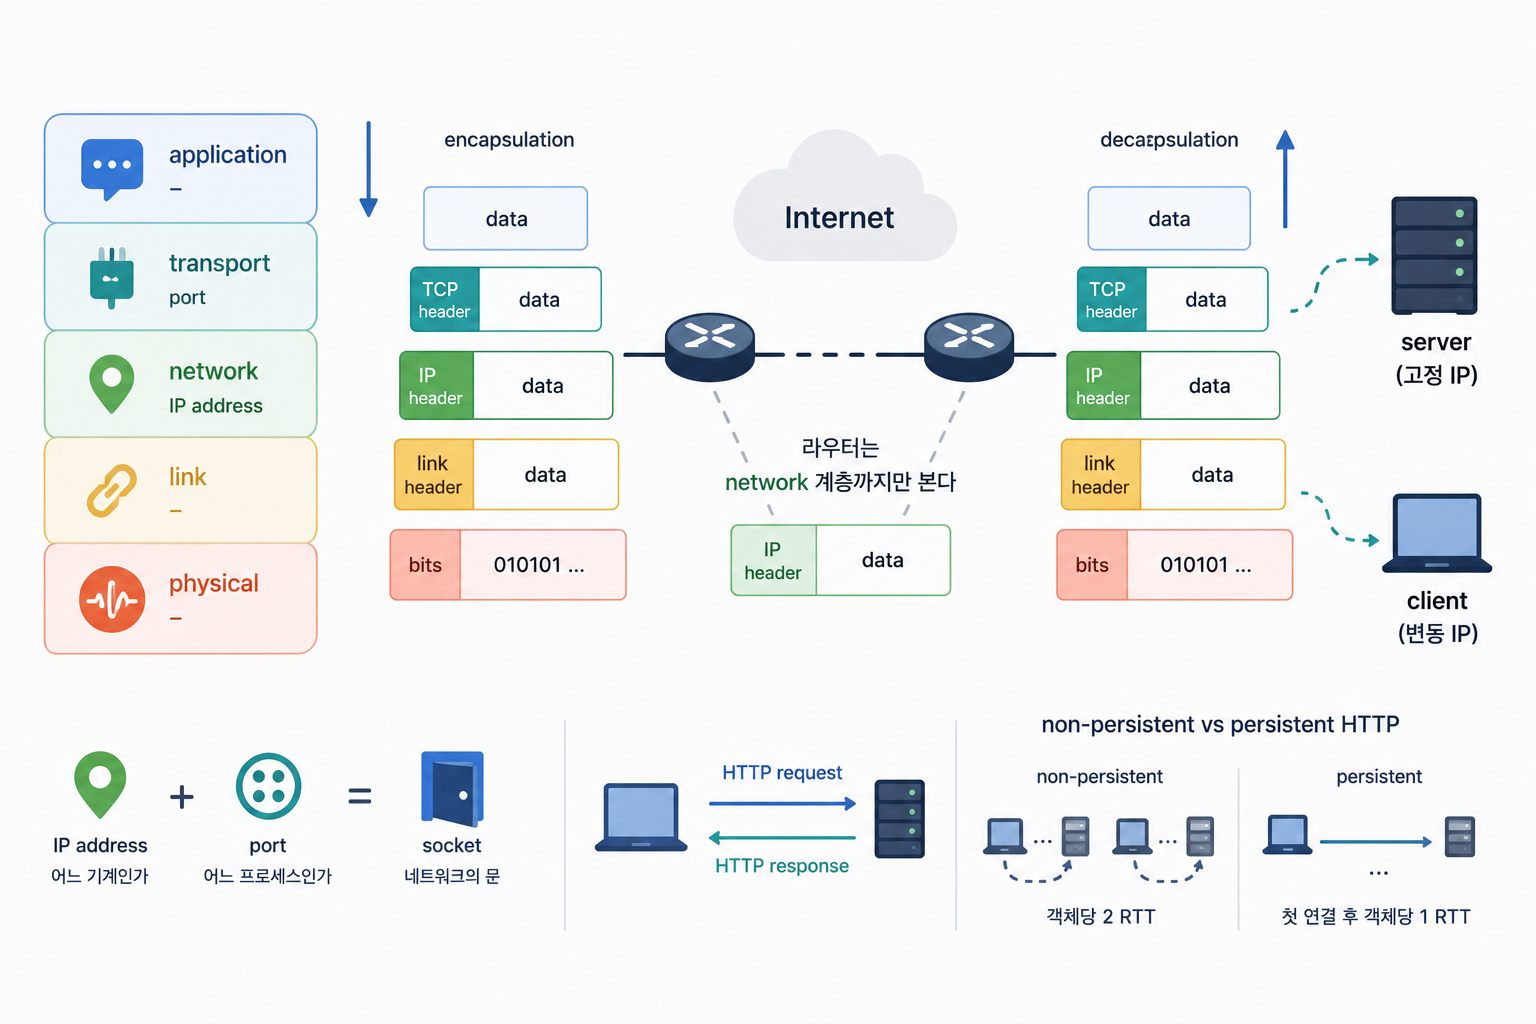
인터넷의 계층은 다섯 개입니다.
| 계층 | 무엇을 책임지나 | 주소 단위 |
|---|---|---|
| application(응용) | 메시지의 의미와 형식. 무엇을 주고받을지 | - |
| transport(전송) | 프로세스 대 프로세스 전달 | port |
| network(네트워크) | 호스트 대 호스트 전달, 경로 결정 | IP address |
| link(링크) | 인접한 노드 사이 한 구간 전달 | - |
| physical(물리) | 비트를 실제 신호로 | - |
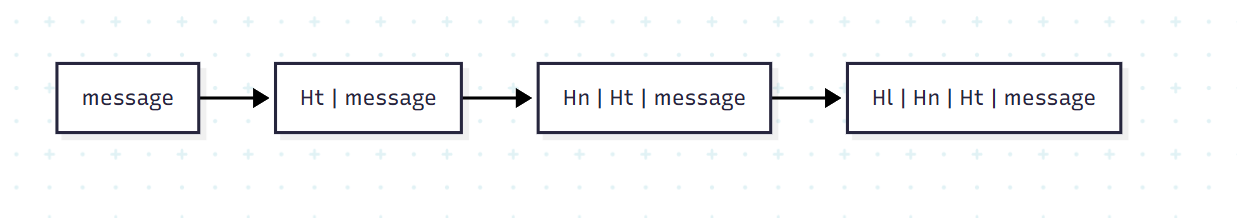
각 층은 아래 층에게 "알아서 배달해 달라"고 맡기고, 자기 층에서 필요한 정보를 header(헤더)에 적어 붙입니다. 그래서 데이터는 내려갈수록 헤더가 겹겹이 쌓이고, 받는 쪽에서는 반대로 한 겹씩 벗겨집니다. 이것이 encapsulation(캡슐화)입니다.
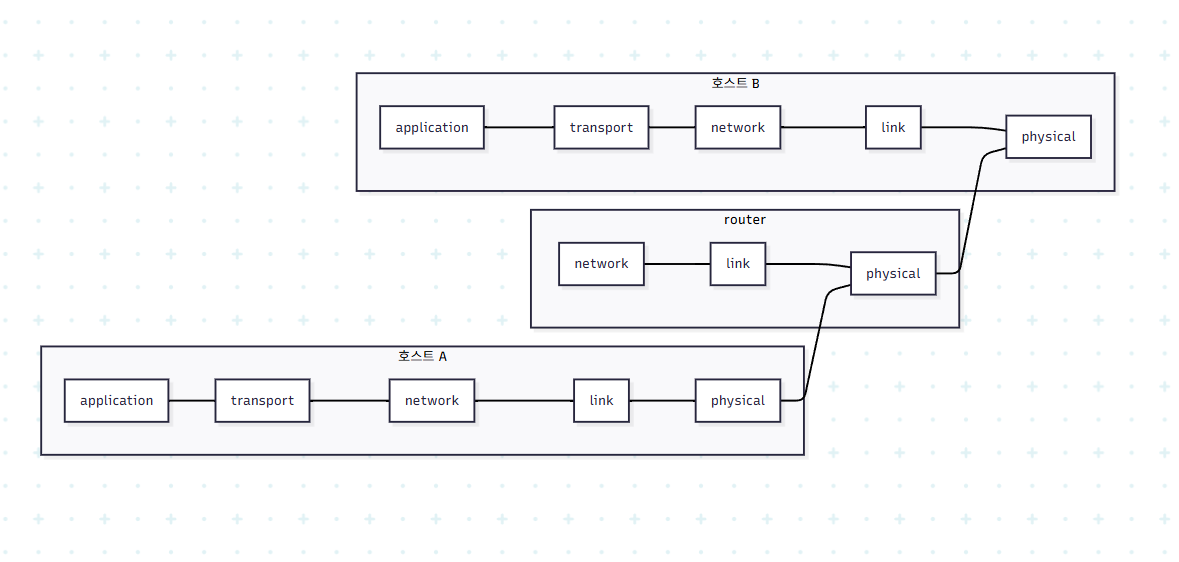
중요한 것은 중간의 router는 이 전부를 열어보지 않는다는 점입니다. 라우터는 network 계층까지만 봅니다. 그 위, 즉 transport와 application은 양 끝 호스트에만 존재합니다. 지난 편의 dumb core가 계층 그림으로 그려지면 이렇게 됩니다.
2. transport가 해주는 것은 data integrity 하나뿐
top-down의 규칙대로, 애플리케이션 계층에 들어가기 전에 아래가 무엇을 안 해주는지부터 확인합니다. 애플리케이션이 네트워크에 요구할 수 있는 것은 대략 네 가지입니다.
- data integrity(데이터 무결성): 보낸 것이 그대로 도착하는가
- timing(지연): 정해진 시간 안에 도착하는가
- throughput(처리율): 최소 대역폭이 보장되는가
- security(보안): 중간에서 못 읽는가
transport 계층이 제공하는 것은 사실상 data integrity 하나입니다. TCP를 써도 timing과 throughput은 보장되지 않고, 기본 TCP에는 암호화도 없습니다.
그래서 나머지 셋은 필요하면 애플리케이션이 알아서 해결해야 합니다. 화상 통화가 지연을 감수하고 UDP를 고르는 것도, HTTPS가 TLS를 얹는 것도 전부 "아래가 안 해주니까 위에서 한다"는 같은 이야기입니다. 보안은 13편에서 다룹니다.
3. IP address와 port, 그리고 socket
network 계층은 IP address로 호스트까지만 배달합니다. 하지만 한 호스트에는 브라우저, 서버 프로세스, 백그라운드 데몬이 동시에 떠 있습니다. 그래서 "어느 프로세스인가"를 가리키는 번호가 필요하고, 그것이 port(포트)입니다.
- IP address: 어느 기계인가
- port: 그 기계의 어느 프로세스인가
socket(소켓)은 이 둘을 묶어 애플리케이션이 잡을 수 있게 만든 문입니다. 프로세스 입장에서 네트워크는 소켓이라는 문 하나로 축약됩니다. 문 밖에서 벌어지는 라우팅과 재전송은 몰라도 되고, 그저 문에 데이터를 밀어 넣고 꺼내면 됩니다. 그래서 소켓은 애플리케이션 계층과 transport 계층 사이의 인터페이스입니다. 소켓 프로그래밍의 구체적인 API는 다음 편에서 다룹니다.
4. client와 server: 누가 고정 주소를 갖는가
client-server architecture(클라이언트-서버 구조)에서 서버는 permanent IP address(고정 IP 주소)를 갖습니다. 항상 같은 자리에 있어야 클라이언트가 찾아올 수 있기 때문입니다. 반대로 클라이언트는 주소가 바뀌어도 상관없고, 실제로 자주 바뀝니다. 카페 와이파이에 붙을 때마다 주소가 달라져도 웹서핑에 아무 문제가 없는 이유입니다.
비대칭은 여기서 끝나지 않습니다. 클라이언트끼리는 직접 통신하지 않고, 항상 서버를 거칩니다.
5. HTTP: request와 response
HTTP(HyperText Transfer Protocol, 하이퍼텍스트 전송 프로토콜)는 웹의 애플리케이션 계층 프로토콜입니다. 구조는 지극히 단순합니다. 클라이언트가 request message(요청 메시지)를 보내면 서버가 response message(응답 메시지)를 돌려줍니다. 그게 전부입니다.
HTTP는 transport로 TCP를 씁니다. 즉 HTTP 자신은 데이터가 유실됐는지 순서가 뒤바뀌었는지 신경 쓰지 않습니다. 그건 아래가 해주기로 한 일이고, HTTP는 "무엇을 달라고 말할 것인가"에만 집중합니다. 계층을 나눈 이득이 그대로 드러나는 지점입니다.
6. stateless라는 선택
HTTP는 stateless(무상태) 프로토콜입니다. 서버는 이전 요청을 기억하지 않습니다. 같은 사람이 열 번 요청해도 서버 입장에서는 매번 처음 보는 요청입니다.
불편해 보이지만 의도된 설계입니다. 상태를 들고 있으면 서버는 클라이언트마다 기록을 유지해야 하고, 그 기록이 꼬이면 복구가 어렵고, 서버를 여러 대로 늘리기도 까다로워집니다. 상태를 버린 대가로 HTTP 서버는 가볍고 잘 늘어납니다. 로그인 상태 같은 것은 쿠키나 토큰으로 애플리케이션이 따로 얹습니다. 여기서도 같은 패턴이 반복됩니다. 프로토콜이 안 해주면 위에서 한다.
7. non-persistent vs persistent HTTP
TCP 연결을 객체마다 새로 맺느냐, 한 번 맺고 재사용하느냐의 차이입니다.
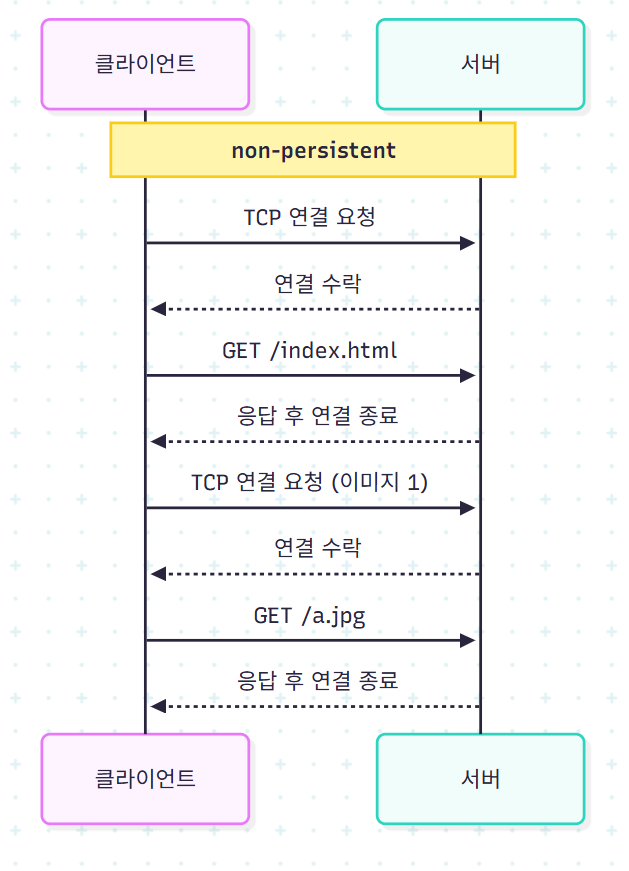
RTT(Round Trip Time, 왕복 시간)를 기준으로 세면 차이가 분명합니다. non-persistent는 객체 하나당 최소 2 RTT가 듭니다. 첫 RTT는 TCP 연결을 세우는 데, 둘째 RTT는 요청을 보내고 응답을 받는 데 쓰입니다. persistent는 연결을 한 번만 세워두므로 이후 객체는 1 RTT씩만 더 듭니다.
| non-persistent | persistent | |
|---|---|---|
| 연결 | 객체마다 새로 맺고 끊음 | 한 번 맺어 재사용 |
| 비용 | 객체당 2 RTT | 첫 연결 후 객체당 1 RTT |
| 서버 자원 | 연결 생성·종료 반복 부담 | 유휴 연결을 붙들고 있음 |
| 기본값 | HTTP/1.0 | HTTP/1.1 이후 |
이미지 10개짜리 페이지라면 차이는 20 RTT 대 11 RTT입니다. 그래서 persistent connection은 HTTP/1.1에서 기본값이 되었습니다. 이후로는 한 연결 위에서 여러 요청을 동시에 흘려보내는 방향으로 더 나아갔습니다.