1. 이게 없으면 무엇이 문제인가
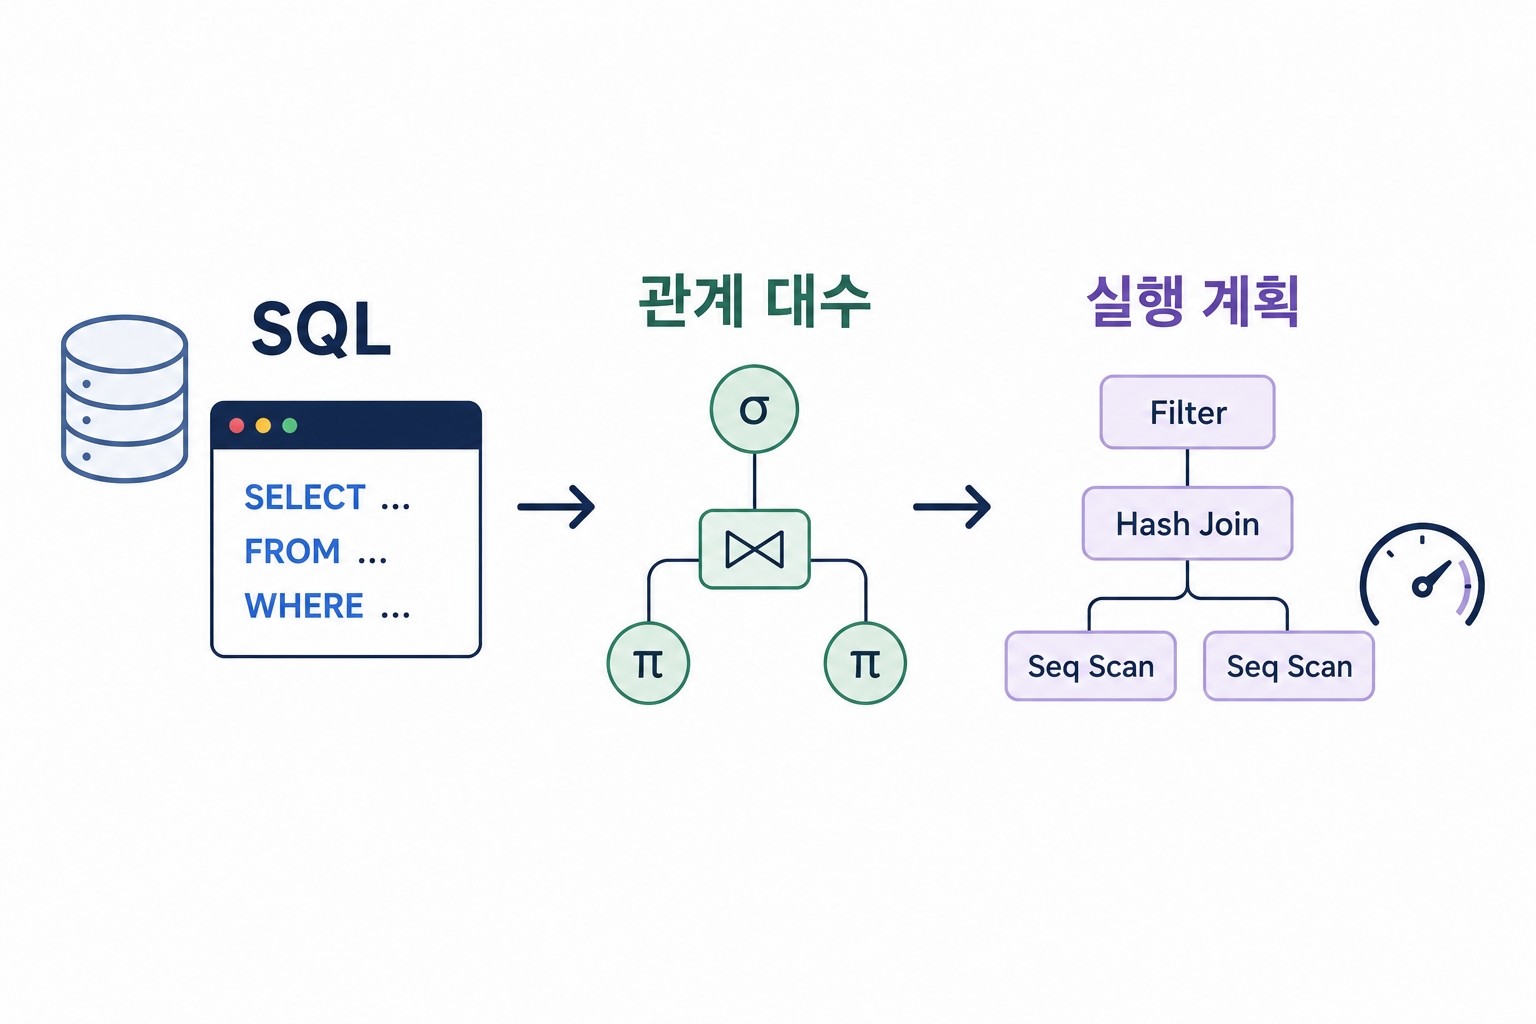
SQL만 아는 상태에서는 "같은 결과를 내는 두 쿼리의 속도가 왜 다른가"를 설명할 수 없습니다. SQL은 원하는 결과만 적을 뿐 계산 순서를 적지 않기 때문입니다. 그 순서를 적는 언어가 관계 대수이고, DBMS는 SQL을 관계 대수 식으로 바꾼 뒤 그 식을 변형해 최적화합니다. 실행 계획에 찍히는 Filter, Hash Join, Nested Loop는 그 결과물입니다.
- 관계 해석(relational calculus): 원하는 데이터만 명시하고 수행 방법은 명시하지 않는 선언적 언어
- 관계 대수(relational algebra): 어떻게 수행할지를 명시하는 절차적 언어
SQL은 겉모습이 관계 해석에 가깝지만 이론적 기초는 관계 대수이고, 관계 대수는 DBMS의 내부 언어로도 쓰입니다.
2. 예제 스키마
student
| sid | name | dept_id | year |
|---|---|---|---|
| 1001 | 김민수 | CSE | 3 |
| 1002 | 이서연 | CSE | 2 |
| 1003 | 박지훈 | MTH | 4 |
department
| dept_id | dept_name | building |
|---|---|---|
| CSE | 컴퓨터공학 | 공학관 |
| MTH | 수학 | 자연관 |
3. 필수 연산자 다섯 개
이 다섯 개만 있으면 나머지는 전부 유도됩니다.
셀렉션(selection) — 조건을 만족하는 튜플의 부분집합. 단항 연산자이고 결과의 차수(degree)는 입력과 같습니다.
-- σ_{year=3}(student)
SELECT * FROM student WHERE year = 3;
프로젝션(projection) — 애트리뷰트의 부분집합.
-- π_{dept_id, year}(student)
SELECT DISTINCT dept_id, year FROM student;
합집합(union) · 차집합(difference) — 두 릴레이션이 합병 가능(union compatible)해야 합니다. 차수가 같고 대응하는 애트리뷰트의 도메인이 같아야 한다는 뜻입니다.
SELECT dept_id FROM student
UNION
SELECT dept_id FROM department;
카티션 곱(Cartesian product) — 모든 조합. 3행 × 2행이면 6행입니다.
SELECT * FROM student CROSS JOIN department;4. 중복은 어디서 사라지는가
관계 대수의 릴레이션은 집합(set)이므로 프로젝션 결과에서 중복 튜플은 제거됩니다. 셀렉션은 원래 있던 튜플을 골라낼 뿐이라 중복이 생길 일이 없습니다. 반면 SQL의 테이블은 멀티셋(multiset)이라 SELECT가 중복을 그대로 남기고, DISTINCT를 붙여야 관계 대수의 프로젝션과 같아집니다.
5. 유도된 연산자
| 연산자 | 표기 | 의미 | SQL |
|---|---|---|---|
| 교집합 | R ∩ S | 양쪽에 모두 있는 튜플 | INTERSECT |
| 세타 조인 | R ⋈θ S | 임의 조건 θ로 결합 | JOIN ... ON a < b |
| 동등 조인 | R ⋈A=B S | θ가 등호인 세타 조인 | JOIN ... ON a = b |
| 자연 조인 | R ⋈ S | 같은 이름 애트리뷰트로 동등 조인 후 중복 열 제거 | NATURAL JOIN |
| 세미 조인 | R ⋉ S | 짝이 있는 R의 튜플만, R의 열만 남김 | WHERE EXISTS (...) |
| 디비전 | R ÷ S | S의 모든 튜플과 짝을 이루는 R의 튜플 | NOT EXISTS 이중 부정 |
-- 자연 조인: student ⋈ department (dept_id 기준)
SELECT s.name, d.dept_name
FROM student s JOIN department d ON s.dept_id = d.dept_id;

-- 세미 조인: 수강 기록이 있는 학생만
SELECT * FROM student s
WHERE EXISTS (SELECT 1 FROM enroll e WHERE e.sid = s.sid);

-- 디비전: 모든 과목을 수강한 학생
SELECT * FROM student s
WHERE NOT EXISTS (
  SELECT 1 FROM course c
  WHERE NOT EXISTS (
    SELECT 1 FROM enroll e WHERE e.sid = s.sid AND e.cid = c.cid));
NATURAL JOIN은 PostgreSQL에는 있지만 SQL Server에는 없습니다. 실습 DBMS가 SQL Server라면 위처럼 ON으로 조인 열을 직접 적어야 합니다. 어차피 자연 조인은 열 이름이 우연히 겹치면 조용히 결과가 바뀌므로 실무에서는 명시하는 쪽이 낫습니다.
6. 외부 조인
내부 조인은 짝이 없는 튜플을 버립니다. "학과가 아직 배정되지 않은 학생"을 세야 하는 순간 이게 문제가 됩니다. 외부 조인(outer join)은 짝 없는 쪽을 NULL로 채워 남깁니다. 왼쪽·오른쪽·완전 세 가지가 있습니다.
SELECT s.name, d.dept_name
FROM student s LEFT OUTER JOIN department d ON s.dept_id = d.dept_id;
SQL Server의 옛 *=, =* 표기는 2008에서 사실상 막혔고 2012부터는 호환성 수준을 낮춰도 쓸 수 없습니다. 표준 LEFT/RIGHT/FULL OUTER JOIN만 씁니다.
7. 관계 대수의 한계
순수 관계 대수로는 산술 연산, 정렬, 데이터베이스 갱신을 할 수 없습니다. 그래서 집단 함수(aggregate function), 그룹화, 외부 조인이 확장 연산자로 추가되었습니다. SQL의 SUM, GROUP BY, ORDER BY, UPDATE는 모두 순수 관계 대수 바깥에 있는 것들입니다.