1. 실행 시간을 직접 재면 생기는 문제
같은 코드라도 어떤 하드웨어와 소프트웨어 위에서 돌리느냐에 따라 성능이 달라집니다. CPU 속도, 메모리, 운영체제, 인터프리터 구현이 전부 제각각이기 때문입니다.
그래서 초 단위 실측값은 알고리즘의 성능이라기보다 "이 알고리즘을 이 환경에서 돌린 결과"에 가깝습니다. 두 알고리즘 중 어느 쪽이 더 나은지 말하려면 환경을 걷어낸 기준이 필요합니다.
2. 가상 컴퓨터 위에서 시뮬레이션하기
해결책은 측정 대상을 실제 컴퓨터에서 가상의 컴퓨터로 옮기는 것입니다. 가상 컴퓨터, 가상 언어, 가상 코드를 정해 두고 그 위에서 시뮬레이션합니다.
가상 컴퓨터가 정의하는 것은 기본 연산입니다. 다음 연산들은 각각 1단위 시간에 처리된다고 봅니다.
- 배정, 대입, 복사 연산
- 산술 연산
- 비교 연산
- 논리 연산
- 비트 연산
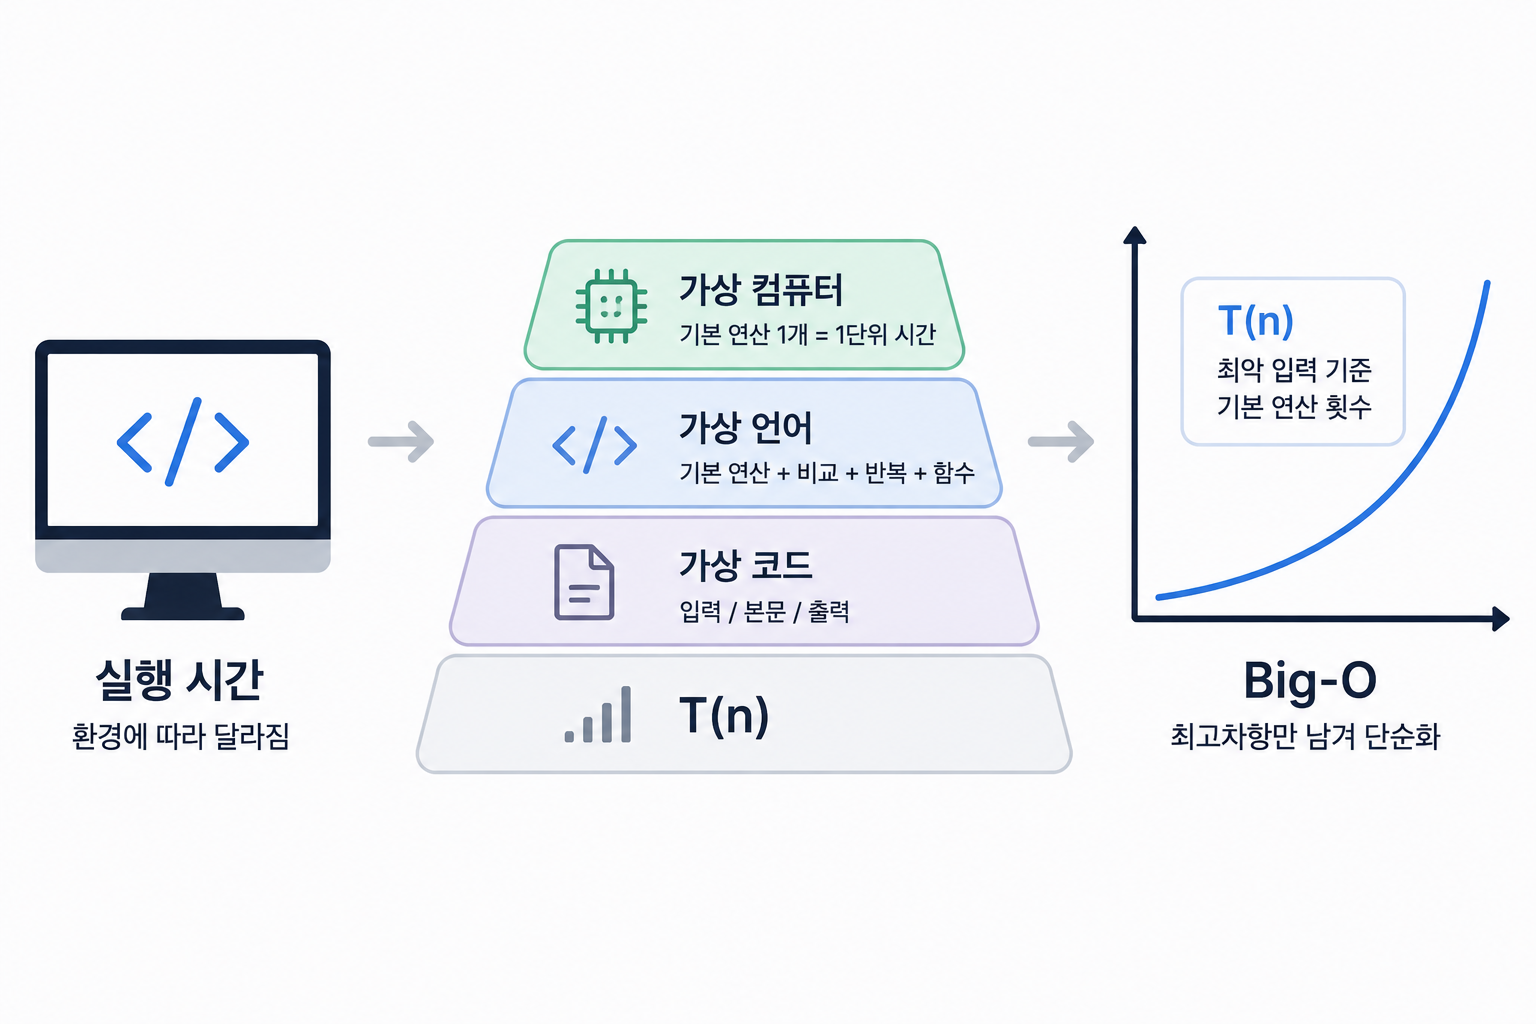
[ 가상 컴퓨터 ]   기본 연산 1개 = 1단위 시간
      |
[ 가상 언어  ]   기본 연산 + 비교 + 반복 + 함수
      |
[ 가상 코드  ]   입력 / 본문 / 출력
      |
     T(n)
곱셈이 덧셈보다 실제로는 느리지만 둘 다 1단위로 셉니다. 개별 연산의 실제 비용은 환경마다 달라지는 값이라, 여기서 구분해 봐야 다시 환경에 끌려가기 때문입니다.
3. 가상 언어와 가상 코드
가상 언어는 최소한 다음을 표현할 수 있어야 합니다.
- 기본 연산
- 비교
- 반복
- 함수
가상 코드는 이 가상 언어로 작성한 코드이며, 입력과 본문과 출력으로 구성됩니다. 실행 가능한 완성 코드일 필요는 없고 흐름이 드러나면 충분합니다.
def search(A, key):            # 입력: 배열 A, 찾을 값 key
    for i in range(len(A)):    # 반복
        if A[i] == key:        # 비교 연산
            return i           # 출력
    return -1
4. 무한한 입력 중 무엇을 기준으로 세는가
가상 코드의 기본 연산 횟수를 세면 단위 시간 기준의 비용이 나옵니다. 문제는 입력이 무한히 많다는 점입니다. 크기가 같은 입력이어도 값이 어떻게 놓여 있느냐에 따라 연산 횟수가 달라집니다.
best case:  찾는 값이 맨 앞
  [ 5 ][ 3 ][ 9 ][ 1 ][ 7 ]
    ^  비교 1회

worst case: 찾는 값이 맨 뒤이거나 아예 없음
  [ 5 ][ 3 ][ 9 ][ 1 ][ 7 ]
    ^--->--->--->--->^  비교 5회
기준으로 삼는 것은 가장 안 좋은 입력, 즉 worst case입니다. 최악의 입력에 대한 기본 연산 횟수를 재는 것을 worst case time complexity라고 합니다. 최악을 기준으로 잡으면 "적어도 이보다 나쁘지는 않다"는 보장을 얻을 수 있습니다.
이 값은 입력 크기 n에 대한 함수 T(n) 형태로 표현합니다. 위 예시는 T(n) = n입니다.
5. T(n)에서 Big-O로
T(n)이 n에 대해 선형으로 증가하는지 비선형으로 증가하는지에 따라 알고리즘의 성격이 갈립니다. n이 커질수록 결과를 좌우하는 것은 최고차항이고, 계수나 낮은 차수 항의 영향은 상대적으로 줄어듭니다.
그래서 최고차항만 남겨 간단히 표기하는데, 이것이 Big-O 표기법입니다.
T(n) = 3n² + 20n + 100
       ~~~
최고차항만 남긴다 -> O(n²)| 예시 | 평균 | 최악 | Big-O |
|---|---|---|---|
| 배정문 한 줄 | 1 | 1 | O(1) |
| 배열 선형 탐색 | n/2 | n | O(n) |
| 이중 반복문 전체 순회 | n² | n² | O(n²) |
선형 탐색의 평균은 찾는 값이 배열에 존재한다고 가정한 값입니다. 이중 반복문처럼 평균과 최악이 같은 경우도 있습니다.
파이썬에서 key in some_list가 바로 이 선형 탐색이라 O(n)이고, key in some_dict는 평균 O(1)입니다.