1. 정렬 리스트로는 부족한 이유
정렬된 리스트에서는 이진 탐색으로 O(log n)에 찾을 수 있습니다. 문제는 삽입입니다. 중간에 값을 끼워 넣으려면 뒤를 전부 밀어야 해서 O(n)이 듭니다.
연결 리스트는 반대입니다. 자리만 알면 삽입은 O(1)인데, 중간으로 건너뛸 수 없어 탐색이 O(n)입니다.
이진 탐색 트리는 이 둘을 트리 모양으로 합칩니다. 값을 미리 정렬해 두는 대신, 비교 결과에 따라 갈 방향이 정해지도록 노드를 배치합니다.
2. 정의
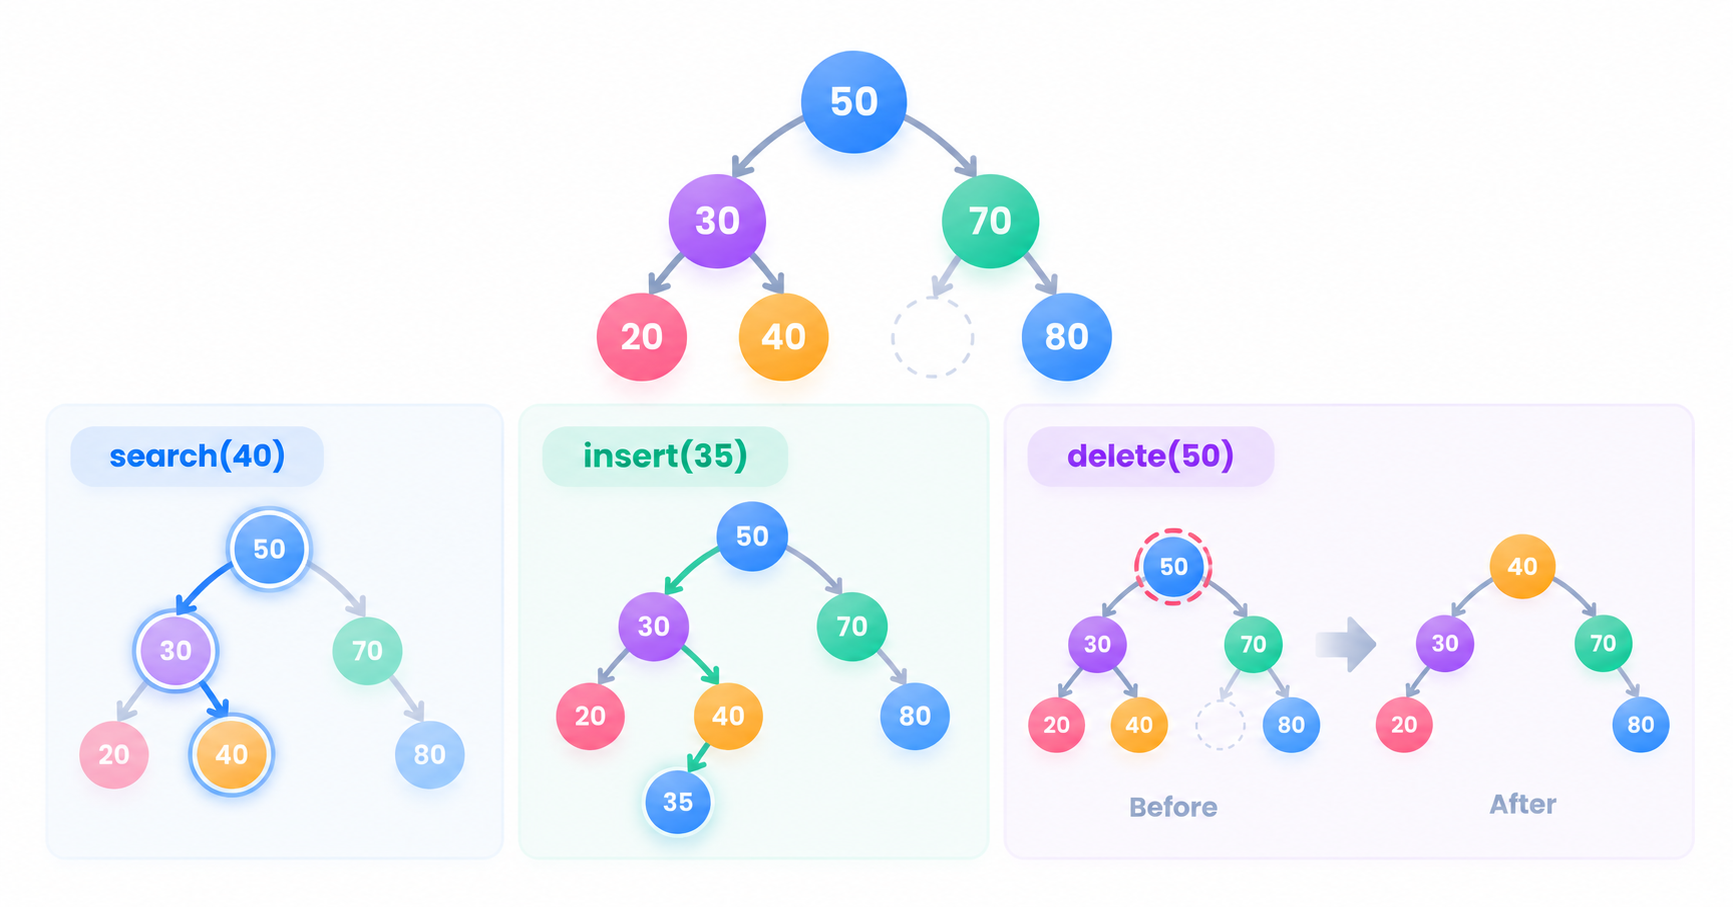
각 노드에 대해 왼쪽 부트리의 키는 그 노드의 키보다 작거나 같고, 오른쪽 부트리의 키는 그 노드의 키보다 커야 합니다.
            (50)
           /    \
        (30)     (70)
        /   \        \
     (20)   (40)     (80)

   50 기준: 왼쪽은 20, 30, 40 (모두 50 이하)
            오른쪽은 70, 80 (모두 50 초과)
이 조건은 루트뿐 아니라 모든 노드에서 성립해야 합니다. 힙이 부모와 자식 사이만 따졌던 것과 다릅니다. 힙에서는 형제 사이에 규칙이 없었지만, 여기서는 부트리 전체가 한쪽으로 몰려 있어야 합니다.
그래서 inorder 순회를 돌리면 키가 오름차순으로 나옵니다. 왼쪽 부트리를 전부 본 뒤 자신, 그다음 오른쪽 부트리이기 때문입니다.
class BST:
    def __init__(self):
        self.root = None
        self.size = 0

    def __iter__(self):              # inorder 제너레이터
        yield from self._inorder(self.root)

    def _inorder(self, v):
        if v:
            yield from self._inorder(v.left)
            yield v
            yield from self._inorder(v.right)
3. find_loc: 모든 연산의 출발점
탐색과 삽입은 사실 같은 일을 합니다. 루트에서 시작해 키를 비교하며 내려가는 것입니다. 다른 점은 내려가다 끝에 닿았을 때 무엇을 하느냐뿐입니다.
그래서 공통 부분을 find_loc 하나로 뽑습니다. 찾는 키의 노드가 있으면 그 노드를, 없으면 그 키가 삽입될 자리의 부모 노드를 반환합니다.
def find_loc(self, key):
    if self.size == 0:
        return None
    p, v = None, self.root
    while v:
        if v.key == key:
            return v                      # 있으면 그 노드
        p = v
        v = v.left if key < v.key else v.right
    return p                              # 없으면 삽입될 자리의 부모
한 번 돌 때마다 한 레벨씩 내려가므로 최악에 높이만큼 반복합니다.
4. search와 insert
search는 find_loc이 준 노드의 키가 찾던 키와 같은지만 확인하면 됩니다.
def search(self, key):
    v = self.find_loc(key)
    if v and v.key == key:
        return v
return Noneinsert는 반대로 없을 때 일을 합니다. find_loc이 부모를 돌려주므로, 그 부모의 왼쪽인지 오른쪽인지만 정해 매달면 됩니다.
def insert(self, key):
    p = self.find_loc(key)
    if p is None or p.key != key:         # 같은 키는 넣지 않는다
        v = Node(key)
        if p is None:
            self.root = v
        else:
            v.parent = p
            if key < p.key:
                p.left = v
            else:
                p.right = v
        self.size += 1
        return v
    return None
before: insert(35) — 50보다 작아 왼쪽, 30보다 커서 오른쪽, 40보다 작아 왼쪽
            (50)
           /    \
        (30)     (70)
        /   \        \
     (20)   (40)     (80)
after
            (50)
           /    \
        (30)     (70)
        /   \        \
     (20)   (40)     (80)
            /
         (35)
5. O(h)가 뜻하는 것
세 연산 모두 루트에서 한 줄기를 따라 내려갈 뿐이므로 비용은 트리의 높이 h에 비례합니다. 노드 수 n이 아니라 h라는 점이 핵심입니다.
문제는 h가 트리 모양에 따라 달라진다는 것입니다. 좌우가 고르게 퍼져 있으면 h는 log₂n이지만, 정렬된 순서로 삽입하면 한쪽으로만 자라 h가 n이 됩니다.
  1, 2, 3, 4를 차례로 insert한 경우

     (1)
        \
        (2)
           \
           (3)
              \
              (4)          h = 3, 사실상 연결 리스트
높이가 낮아질수록 빨라지므로, 높이를 강제로 낮게 유지하는 방법이 필요합니다.
6. 삭제: 두 가지 방법
삭제는 자식이 둘인 노드에서 어려워집니다. 그 노드를 빼면 부트리 두 개가 붕 뜨는데, 부모의 자리는 하나뿐입니다. 해결 방식이 둘로 갈립니다.
deleteByMerging: 왼쪽 부트리를 통째로 x의 자리에 올리고, 오른쪽 부트리를 왼쪽 부트리의 가장 큰 노드 아래에 매답니다. 왼쪽 부트리의 최대 노드는 오른쪽 자식이 없으므로 그 자리가 비어 있고, 오른쪽 부트리의 값은 전부 그보다 크므로 조건도 맞습니다.
before: 50을 삭제
            (50)
           /    \
        (30)     (70)
        /   \        \
     (20)   (40)     (80)
after: 30이 올라오고, 40 아래에 70 부트리가 붙음
            (30)
           /    \
        (20)     (40)
                    \
                    (70)
                        \
                        (80)
def delete_by_merging(self, x):
a, b, pt = x.left, x.right, x.parent
if a is None:
c = b # 왼쪽이 없으면 오른쪽이 올라간다
else:
c = m = a # 왼쪽 부트리가 올라가고
while m.right: # 그 안의 최대 노드를 찾아
m = m.right
m.right = b # 오른쪽 부트리를 매단다
if b:
b.parent = m
if pt is None: # x가 루트였다면
self.root = c
elif pt.left is x:
pt.left = c
else:
pt.right = c
if c:
c.parent = pt
self.size -= 1deleteByCopying: 노드를 옮기는 대신 키만 옮깁니다. 왼쪽 부트리에서 가장 큰 노드를 찾아 그 키를 x에 복사하고, 그 노드를 대신 지웁니다. 복사해 온 키는 x의 왼쪽 전부보다 크고 오른쪽 전부보다 작으므로 조건이 유지되고, 지워야 할 노드는 오른쪽 자식이 없어 처리가 간단합니다.
after: 40이 50 자리로 올라오고 원래 40 노드가 사라짐
            (40)
           /    \
        (30)     (70)
        /            \
     (20)            (80)
def delete_by_copying(self, x):
if x.left:
m = x.left
while m.right: # 왼쪽 부트리의 최대 노드
m = m.right
x.key = m.key # 키만 복사
if m.parent.left is m: # m을 떼어 낸다
m.parent.left = m.left
else:
m.parent.right = m.left
if m.left:
m.left.parent = m.parent
self.size -= 1
else:
self.delete_by_merging(x) # 왼쪽이 없으면 오른쪽을 올리면 된다7. 시간복잡도
| 연산 | 평균 | 최악 |
|---|---|---|
find_loc | O(log n) | O(n) |
search | O(log n) | O(n) |
insert | O(log n) | O(n) |
delete_by_merging | O(log n) | O(n) |
delete_by_copying | O(log n) | O(n) |
| inorder 순회 | O(n) | O(n) |
전부 O(h)입니다. 무작위 순서로 삽입하면 h가 평균적으로 log n 근처에 머물지만, 정렬된 순서가 들어오면 n이 됩니다. 최악이 정확히 가장 흔한 입력에서 나온다는 점이 이 자료구조의 약점입니다.