1. 자식을 둘로 제한하는 이유
트리 자체는 자식 수에 제한이 없습니다. 그런데 자식이 셋, 넷이 되면 삽입과 삭제에서 따져야 할 경우가 급격히 늘어납니다. 어느 자리에 넣을지, 지운 뒤 남은 자식들을 어떻게 재배치할지가 모두 분기가 됩니다.
자식을 둘로 묶어 두면 "왼쪽 아니면 오른쪽" 두 경우만 남습니다. 이 단순함 덕분에 뒤에서 볼 탐색과 균형 유지 같은 알고리즘을 다루기 쉬워집니다.
class Node:
    def __init__(self, key):
        self.key = key
        self.left = None
        self.right = None
        self.parent = None
힙처럼 모양이 항상 꽉 차 있는 경우가 아니면 리스트 표현은 빈칸 낭비가 커서, 일반 이진 트리는 이쪽을 씁니다.
2. 순회가 왜 필요한가
리스트는 모든 원소를 훑는 방법이 하나뿐입니다. 앞에서 뒤로 가면 됩니다. 트리는 갈래가 있어서 "전부 방문한다"는 말만으로는 순서가 정해지지 않습니다. 루트를 먼저 볼지, 왼쪽 부트리를 다 본 뒤에 볼지에 따라 결과가 달라집니다.
모든 노드를 빠짐없이, 정해진 규칙으로 방문하는 것을 순회(traversal)라고 합니다.
3. 세 가지 순회
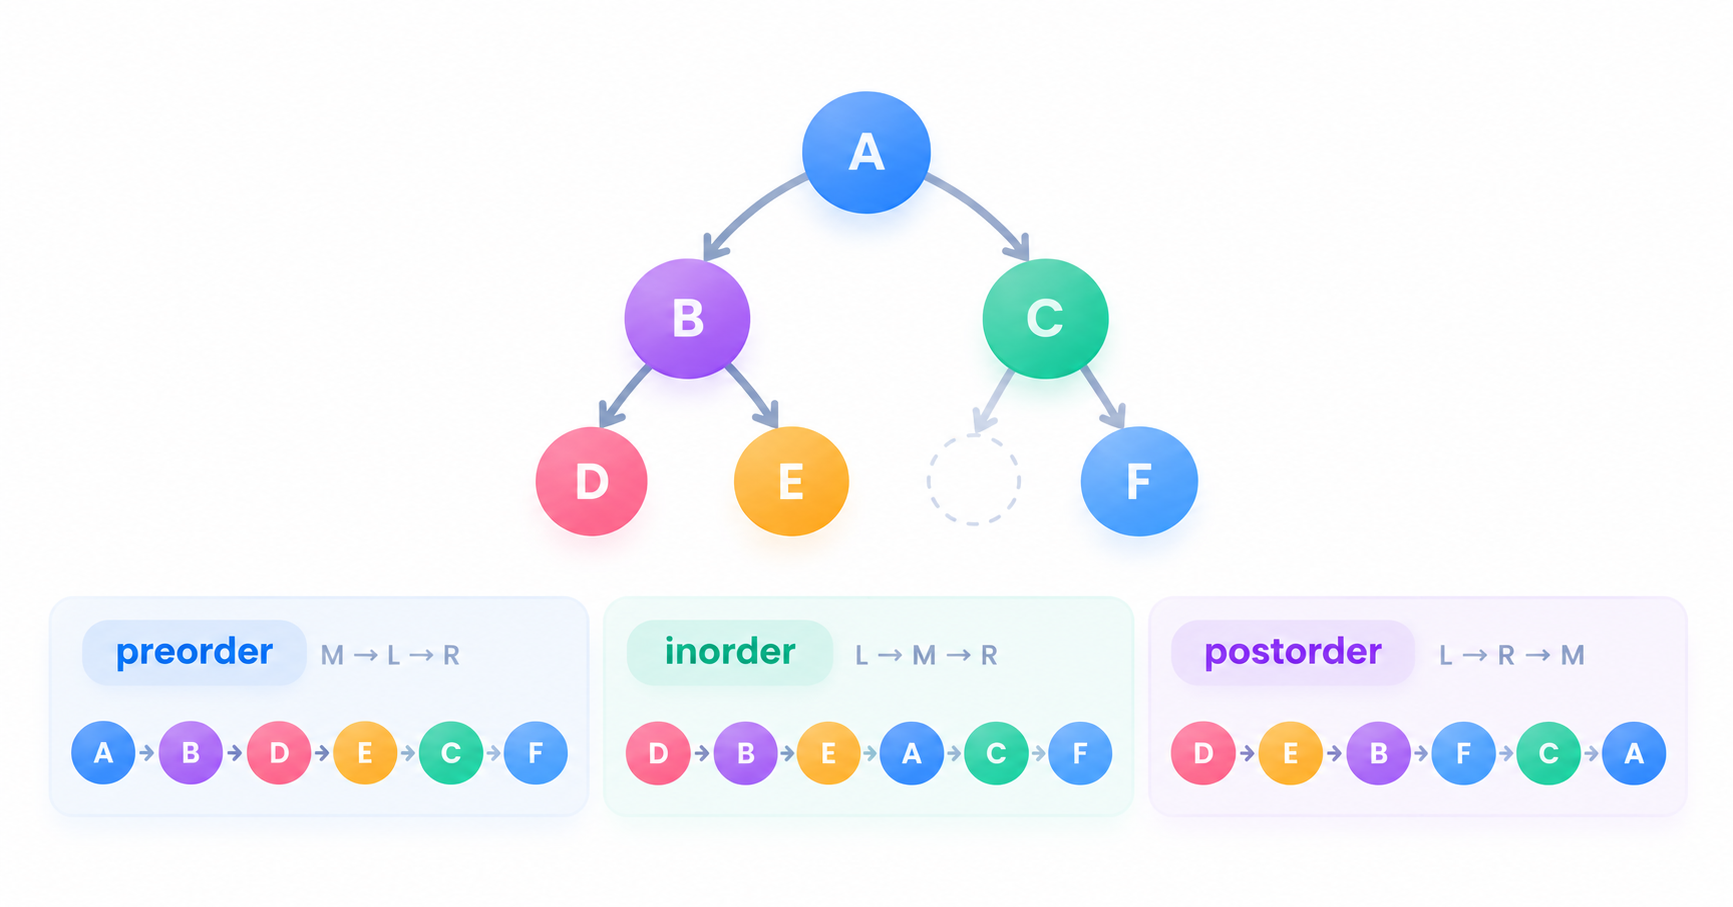
기준은 현재 노드(M), 왼쪽 부트리(L), 오른쪽 부트리(R)를 어떤 차례로 처리하느냐입니다.
- preorder: M → L → R
- inorder: L → M → R
- postorder: L → R → M
왼쪽이 오른쪽보다 먼저인 것은 세 방식 모두 같고, 현재 노드를 언제 처리하느냐만 다릅니다.
            (A)
           /   \
        (B)     (C)
        /  \       \
     (D)   (E)     (F)

  preorder  : A B D E C F
  inorder   : D B E A C F
  postorder : D E B F C A
구현은 정의를 그대로 옮기면 됩니다. 부트리도 같은 모양의 트리이므로 재귀가 자연스럽습니다. 여기서 self는 지금 방문 중인 노드입니다.
class Node:
    def preorder(self):
        print(self.key)                        # M
        if self.left:
            self.left.preorder()               # L
        if self.right:
            self.right.preorder()              # R

    def inorder(self):
        if self.left:
            self.left.inorder()                # L
        print(self.key)                        # M
        if self.right:
            self.right.inorder()               # R

    def postorder(self):
        if self.left:
            self.left.postorder()              # L
        if self.right:
            self.right.postorder()             # R
        print(self.key)                        # M
세 함수의 차이는 print 한 줄의 위치뿐입니다.
4. 어떤 순회를 언제 쓰는가
preorder는 부모를 자식보다 먼저 처리합니다. 트리를 복사하거나 파일로 저장할 때, 부모를 먼저 만들어야 자식을 매달 수 있으므로 이 순서가 맞습니다.
inorder는 왼쪽을 전부 본 뒤 자신을 처리합니다. 11편에서 볼 이진 탐색 트리에서 이 순회를 돌리면 키가 정렬된 순서로 나옵니다.
postorder는 자식을 모두 처리한 뒤 자신을 처리합니다. 부모의 결과가 자식의 결과에 의존할 때 씁니다. 디렉터리를 지울 때 안쪽 파일부터 지워야 하는 것, 03편에서 후위 표기 수식을 계산할 때 피연산자를 먼저 스택에 쌓던 것이 같은 구조입니다.
5. 순회 결과로 트리를 복원하기
순회는 트리를 한 줄로 펴는 일입니다. 반대로 펴진 결과에서 원래 트리를 되살리는 것도 할 수 있어야 합니다.
한 가지 순회만으로는 안 됩니다. preorder가 A B C라고 해서 트리 모양이 하나로 정해지지 않습니다. 그런데 preorder와 inorder를 함께 주면 유일하게 복원됩니다.
  preorder : [A] B D E C F      맨 앞이 루트
  inorder  : D B E [A] C F      루트 기준으로 왼쪽/오른쪽이 갈린다
             -----   ---
             왼쪽    오른쪽
preorder의 첫 값이 루트이고, 그 값을 inorder에서 찾으면 왼쪽 부트리와 오른쪽 부트리에 속한 노드들이 나뉩니다. 개수를 알았으니 preorder도 같은 크기로 자를 수 있고, 각 조각에 같은 일을 반복하면 됩니다.
def reconstruct(pre, ino):
    if not pre:
        return None
    root = Node(pre[0])                       # preorder의 첫 값이 루트
    k = ino.index(pre[0])                     # inorder에서 루트 위치
    root.left  = reconstruct(pre[1:k+1], ino[:k])
    root.right = reconstruct(pre[k+1:], ino[k+1:])
    return root
6. 시간복잡도
| 연산 | 평균 | 최악 |
|---|---|---|
| preorder / inorder / postorder | O(n) | O(n) |
| 순회 중 재귀 호출 스택 | O(log n) | O(n) |
reconstruct (위 코드) | O(n log n) | O(n²) |
reconstruct (위치를 미리 딕셔너리에 저장) | O(n) | O(n) |
순회는 노드를 한 번씩만 방문하므로 O(n)입니다. 대신 재귀가 깊어지면 호출 스택이 쌓이므로 추가 메모리는 높이에 비례합니다. 치우친 트리에서는 이 값이 n까지 갑니다.
reconstruct가 느려지는 이유는 매번 ino.index로 루트를 찾고 리스트를 잘라 복사하기 때문입니다. 키와 위치를 딕셔너리에 미리 넣어 두고 자르는 대신 인덱스 범위만 넘기면 O(n)이 됩니다.