도입
인공지능과 데이터 분야에 대한 관심이 점점 커지고 있는 요즘, 많은 사람이 실제로 어떻게 기술을 활용할 수 있을지 고민하고 있다. 이번 강의는 파이썬과 OpenAI API를 이용해 데이터를 다루고, 의미 있는 결과물을 도출하는 과정을 다룬다. 파이썬을 어느 정도 다룰 줄 안다면 누구나 따라 할 수 있는 실습 프로젝트들로 구성되어 있어, 학습자가 자신의 실력을 자연스럽게 발전시킬 수 있는 기회를 제공한다.
8개의 다양한 프로젝트를 통해, 자연어 처리부터 감정 분석, 데이터 시각화까지 다루며 현업에서 바로 적용할 수 있는 스킬들을 익힐 수 있다. 실제로 데이터 수집부터 분석, 그리고 모델 튜닝까지의 전체 과정을 경험하면서 AI와 데이터 사이언스의 기본기를 확실히 다질 수 있을 것이다.
지금 이 강의를 통해, 데이터의 세계에서 원하는 결과를 보다 쉽게 얻어보라. 어렵게 느껴질 수 있는 AI 기술이 실습과 프로젝트를 통해 친숙해질 것이다.
https://metacodes.co.kr/edu/read2.nx?M2_IDX=31635&EP_IDX=9859&EM_IDX=9683
1. 프로젝트 개요

이번 프로젝트는 강의자료를 생성하는데 필요한 자동 퀴즈 생성 프로그램을 만드는 것으로
채첨까지 자동화 하는 퀴즈 프로그램 개발을 목표로 한다.
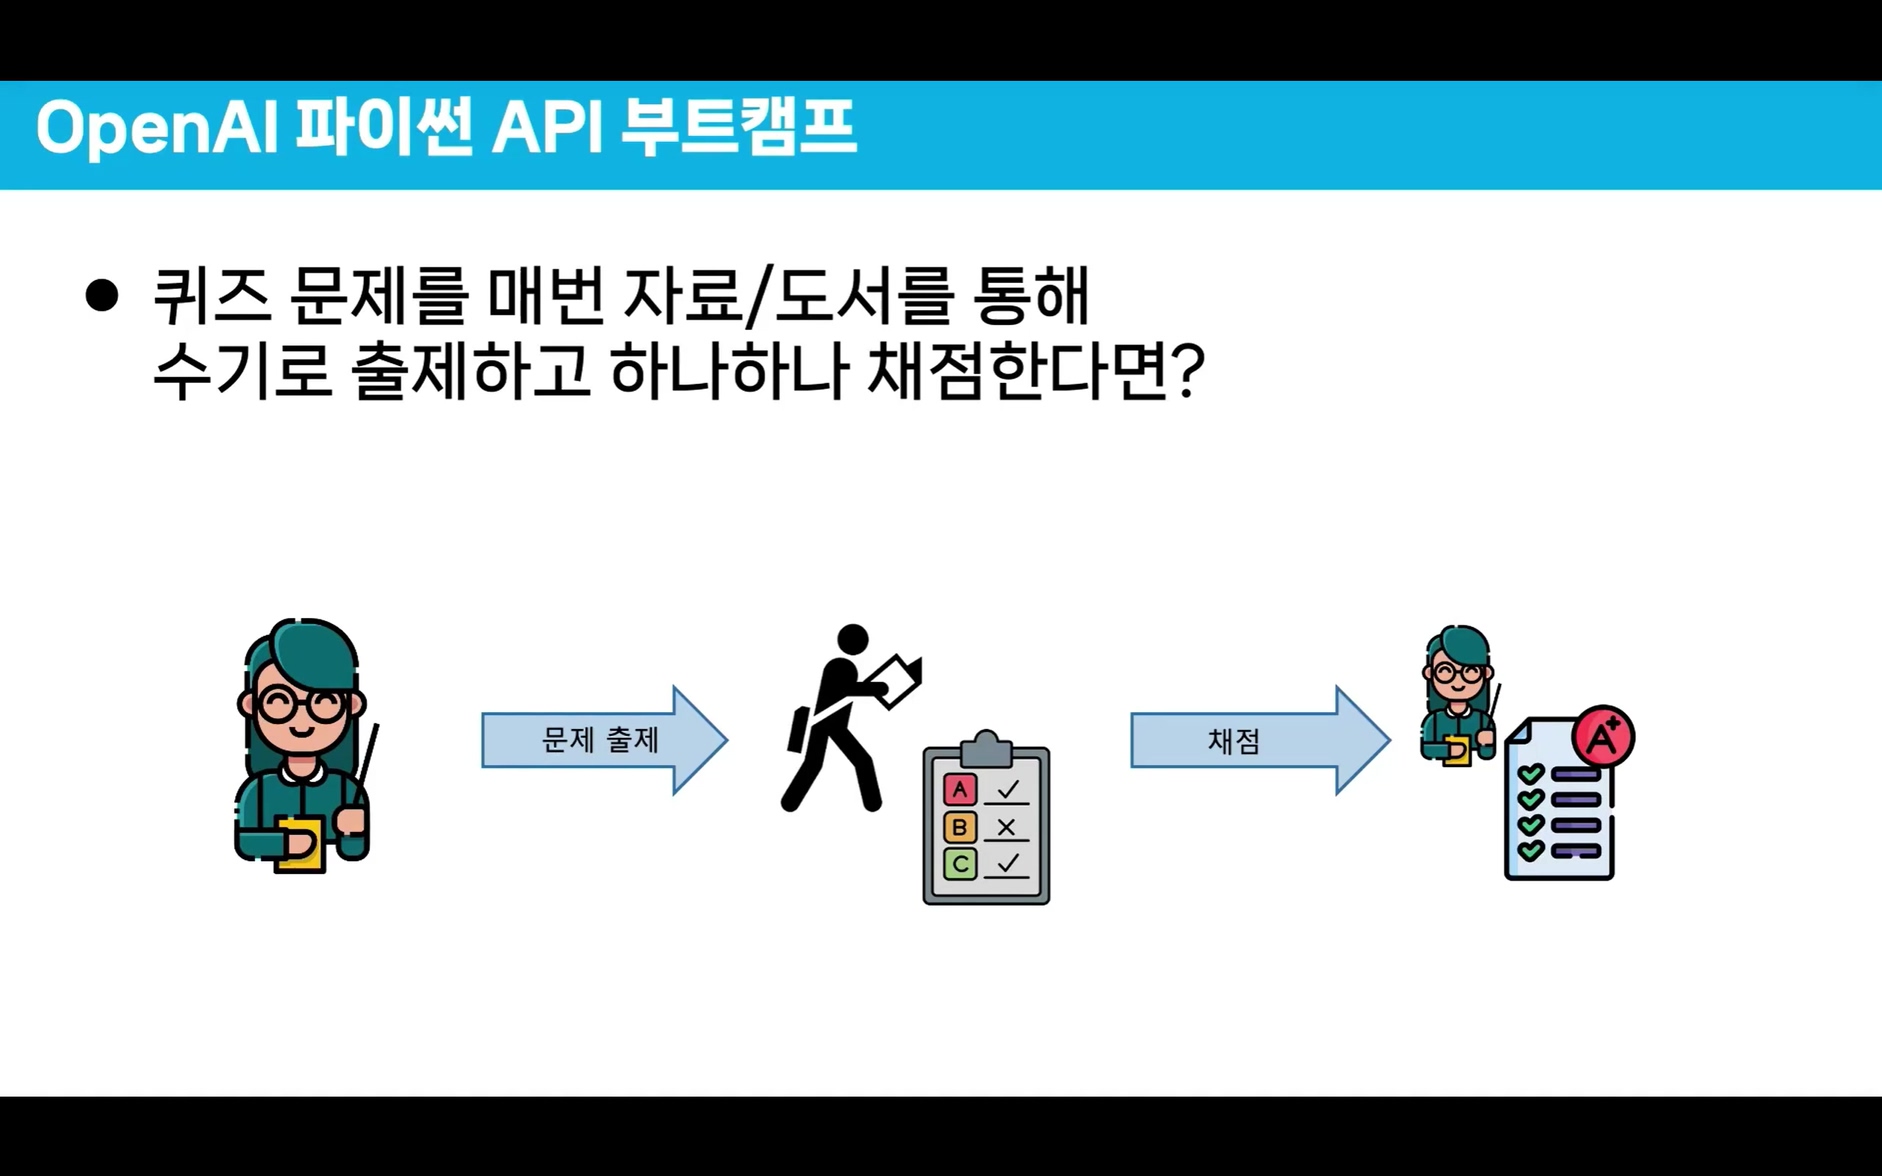
해당 프로그램을 개발하기 위한 제반배경사항으로는
기존의 퀴즈 프로그램의 생성은 사람이 일일이 수작업으로 퀴즈 출제에 해당하는 과목을 모두 충분한 수준으로 숙지를 한 뒤 이전 퀴즈 문제와 변별성을 갖는 새로운 퀴즈를 매 회 새로이 생성해야 하는 번거로움이 있다
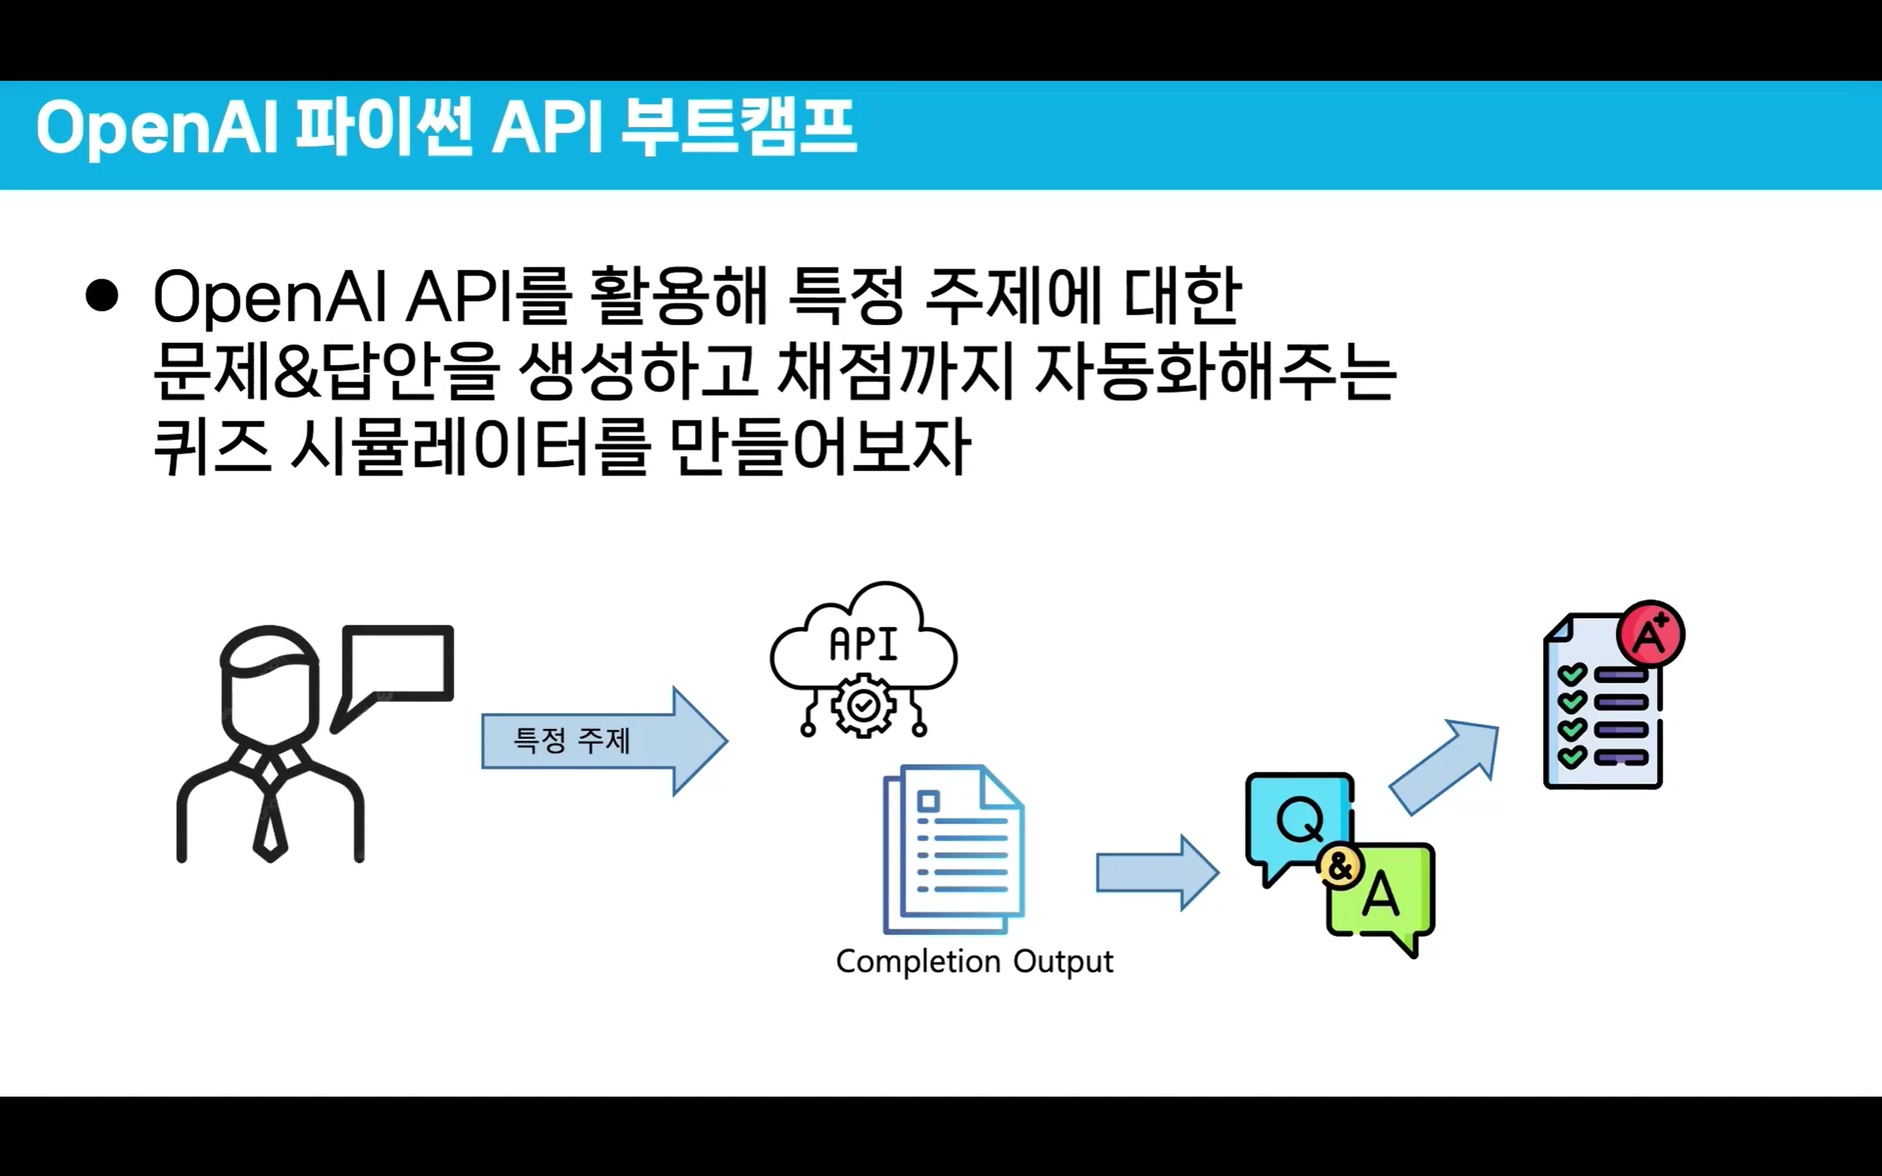
본 프로젝트의 목적은 OpenAPI를 활용하여 특정 주제에 대한 문제 및 답안을 자동으로 생성하고 이를 채점까지 자동화하는 퀴즈 시뮬레이터의 제작이 목표라 볼 수 있다.
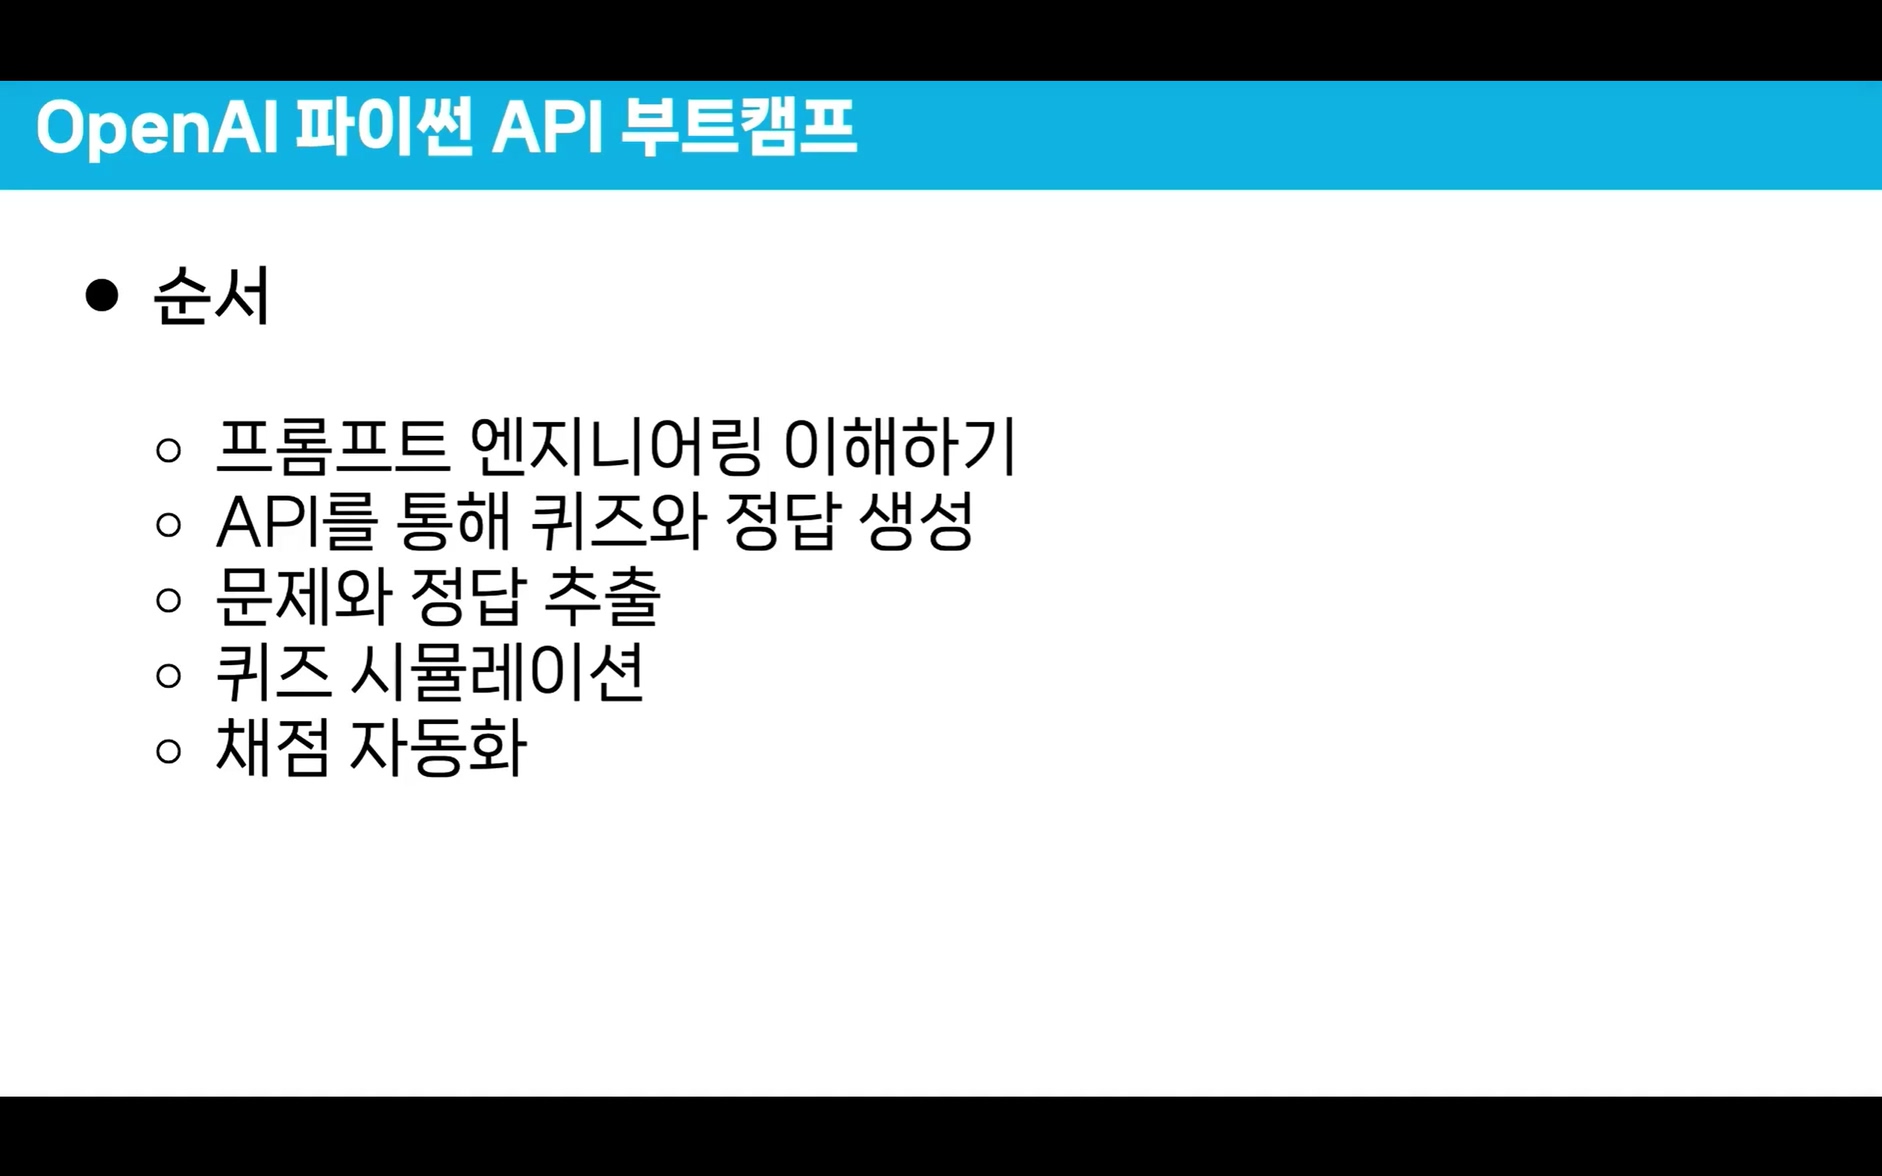
프로젝트 진행순서는
1) 프롬포트 엔지니어링 이해
2) API를 통한 퀴즈 정답 생성
3) 문제와 정답 추출 후 퀴즈 시뮬레이션
마지막으로 채점을 자동화 하는 프로그램의 개발이다.
2. 프롬포트 디자인
1) 모델의 선택 : GPT모델을 사용할때는 왠만하면 최신 모델을 선택하는 것이 안정적이고, 최신 버전이 출시될 때 일반 사용 목적(개인사용 목적)일 때는 되도록이면 파생 모델 중 경량화된 최신모델을 선택하는 것이 좋다.
그리고 모델이 변경될 때 사용 방법론(API help docu)가 변경되는 경우가 많기에 이를 필히 숙지해야 한다.
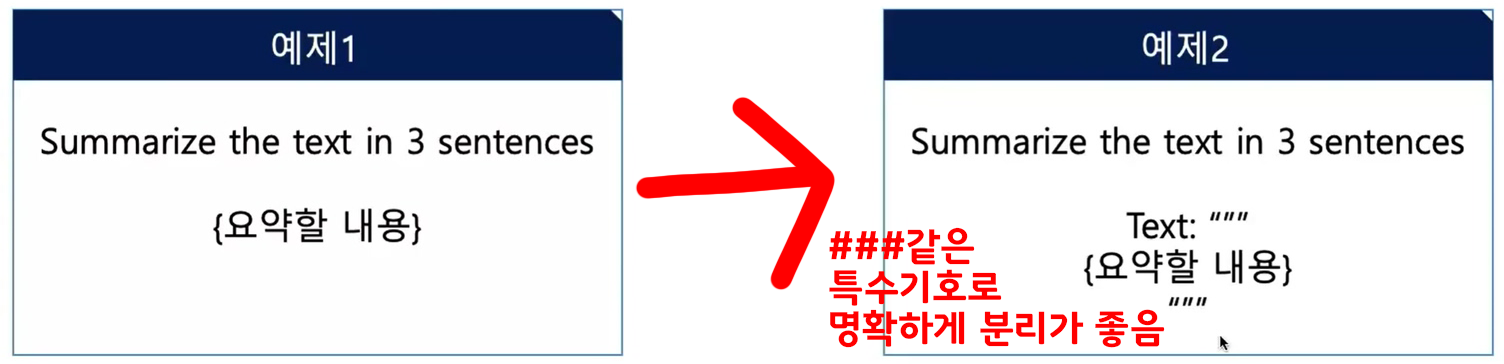
2) 지시사항(Instructions)
프롬포트 시작시 생성결과 / 지시사항은 분리하여 표기하는것이 좋다
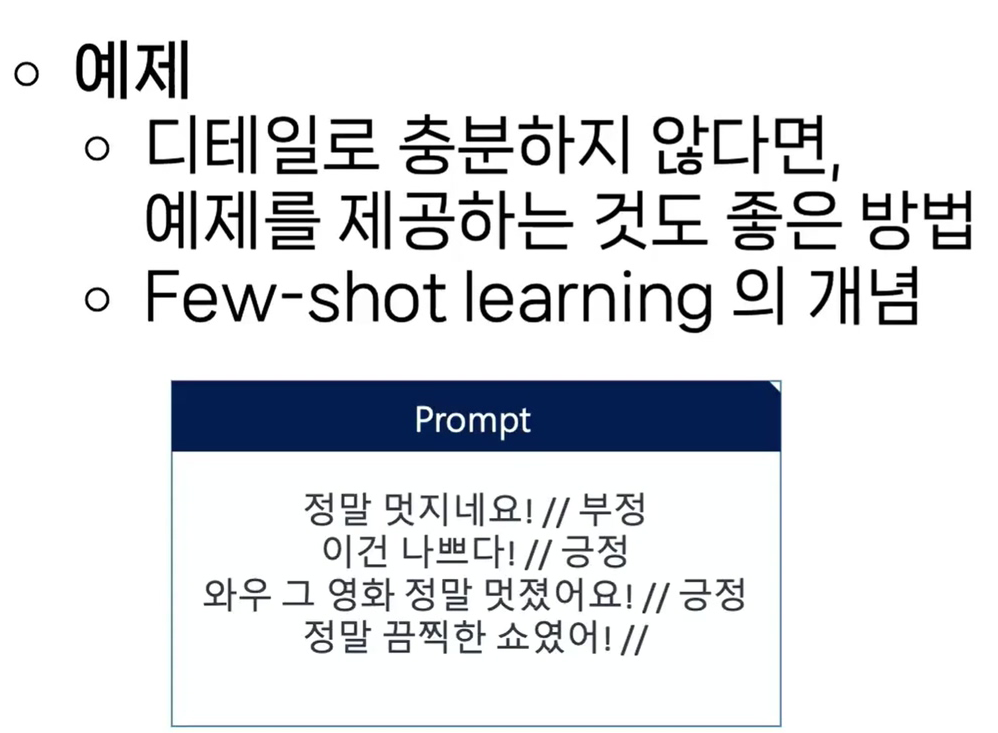
3) 디테일 : 지시사항의 기재는 되도록이면 과도할 정도로 충분하게 세부사항을 명기하여 전달하자
특히 출력형식(format)이 지정되어 있는 경우 최대한 자세하게 기재해야 출력결과물의 출력형식이 제대로 준수된다.
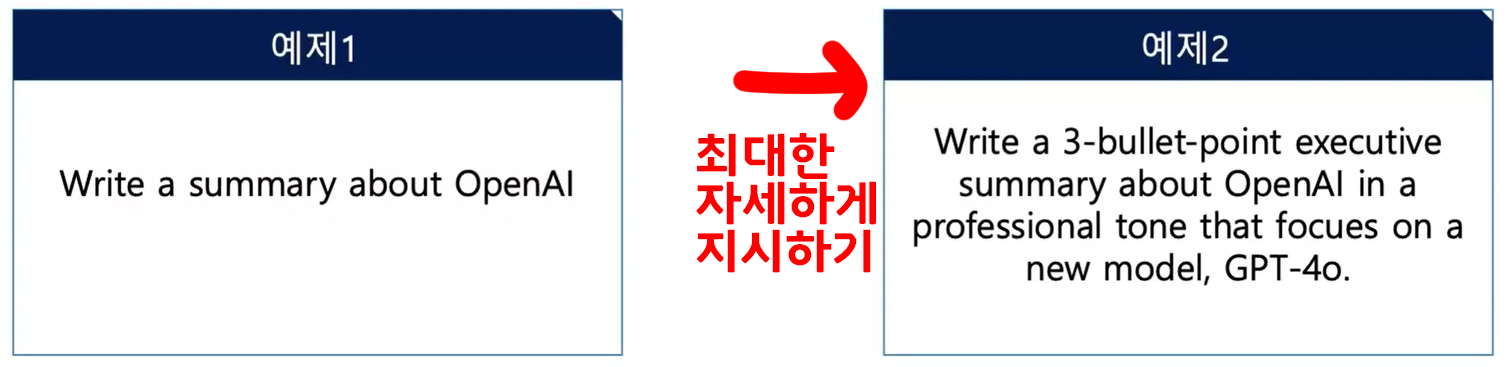
이때 디테일이 부족하다 느낀다면 출력 결과물의 예제를 제공하는것이 가장 좋다.
더 자세한 프롬포트 엔지니어링 가이드는
https://platform.openai.com/docs/guides/prompt-engineering
위 문서를 참조하자
3. 시험문제 생성하기
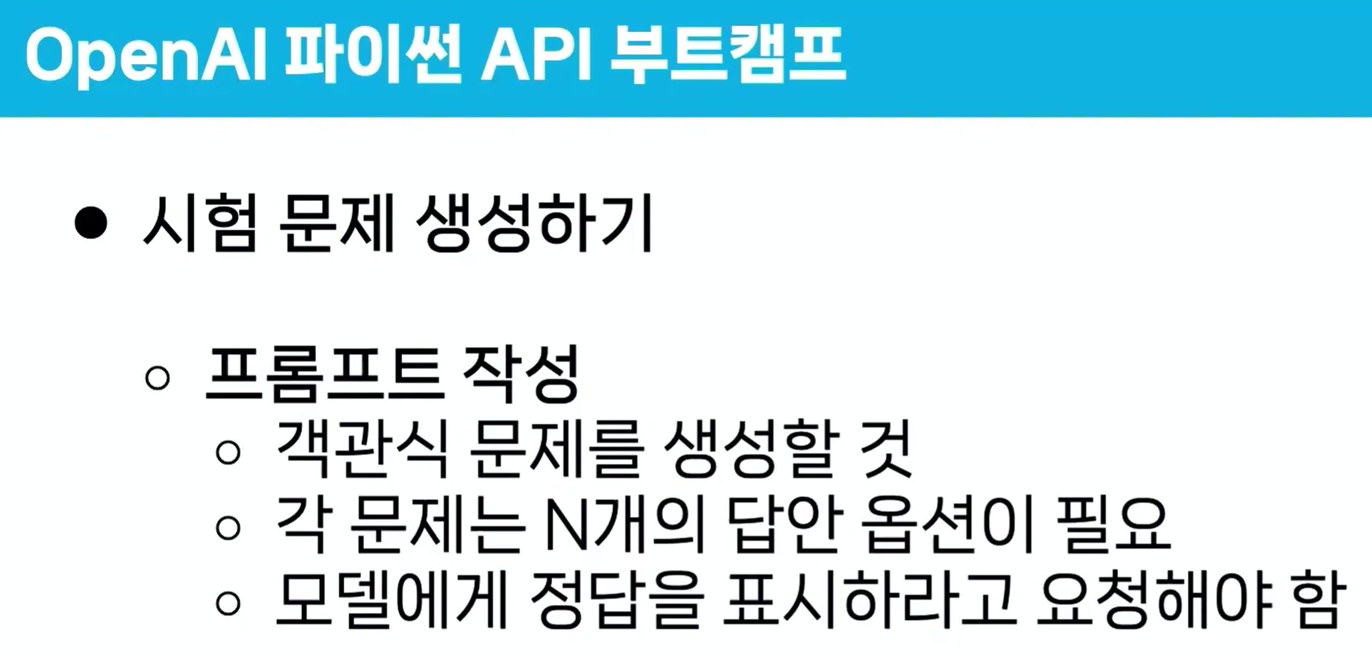
시험문제의 생성 우너칙은 위 3가지 과정으로 진행하도록 수행한다.
이때 생성한 시험문제는 항상 사후검증이 필요하기에 모든 항목이 자동화 되지 않고 전문가의 검토가 필요함을 알아야 한다.
from dotenv import load_dotenv
import os

load_dotenv()  # .env 파일의 환경 변수를 불러옴
api_key = os.getenv('OPENAI_API_KEY')

# API 키가 정상적으로 불러와졌는지 확인
#print(f"API Key: {api_key}")
import pandas as pd
from openai import OpenAI3.1 시험문제 response
# 전반적인 문제 생성에 관한 규칙 정의
def set_system_prompt():
    return '''지정한 주제에 관하여 객관식 문제를 생성하시오.
    이때 생성한 문제에 관한 답은 유일해야 함
    (중복 및 다중 정답이 발생하면 아니됨),
    문제에 관한 정답은 별도로 표기'''

# 생성하는 문제에 대한 세부 규칙 정의
def set_question_prompt(topic, num_questions, num_items):
    return f'''주제: {topic}, {topic}에 관한 문제 {num_questions}개 생성,
    하나의 문제 당 문항은 {num_items}개 생성'''
response = client.chat.completions.create(
model = 'gpt-4-turbo',
messages = [
{"role": "system", "content": set_system_prompt()},
{"role": "user", "content": set_question_prompt("한국사", 2, 5)},
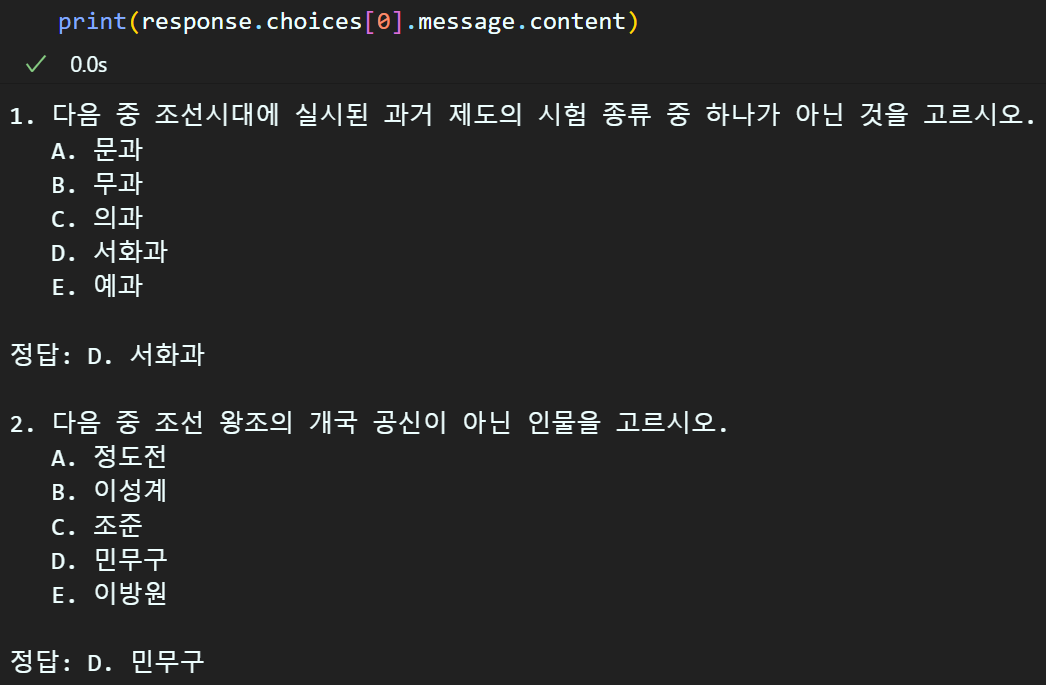
])위 설계한 system 프롬포트 세팅과, question 프롬포트 세팅으로 문제 생성 client.chat.completions.create를 수행하면
그 결과가 response로 반환된다.
ChatCompletion(id='chatcmpl-
ACzqZeFJe8JcFSnjK6nkj8F7Li0n9', choices=
[Choice(finish_reason='stop', index=0,
logprobs=None,
message=ChatCompletionMessage(
content='1. 다음 중 조선시대에 실시된 과거 제도의
시험 종류 중 하나가 아닌 것을 고르시오.\n
A. 문과\n   B. 무과\n   C. 의과\n
D. 서화과\n   E. 예과\n\n
정답: D. 서화과\n\n
2. 다음 중 조선 왕조의 개국 공신이 아닌 인물을 고르시오.\n
A. 정도전\n   B. 이성계\n
C. 조준\n   D. 민무구\n   E. 이방원
\n\n정답: D. 민무구', role='assistant',
function_call=None, tool_calls=None,
refusal=None))], created=1727661039,
model='gpt-4-turbo-2024-04-09', object='chat.completion',
service_tier=None, system_fingerprint='fp_1f2231a495',
usage=CompletionUsage(completion_tokens=172,
prompt_tokens=133, total_tokens=305,
completion_tokens_details={'reasoning_tokens': 0}))
이제 response에 포함된 다양한 데이터 정보 중 필요한 항목을 추출하는 과정을 수행하자
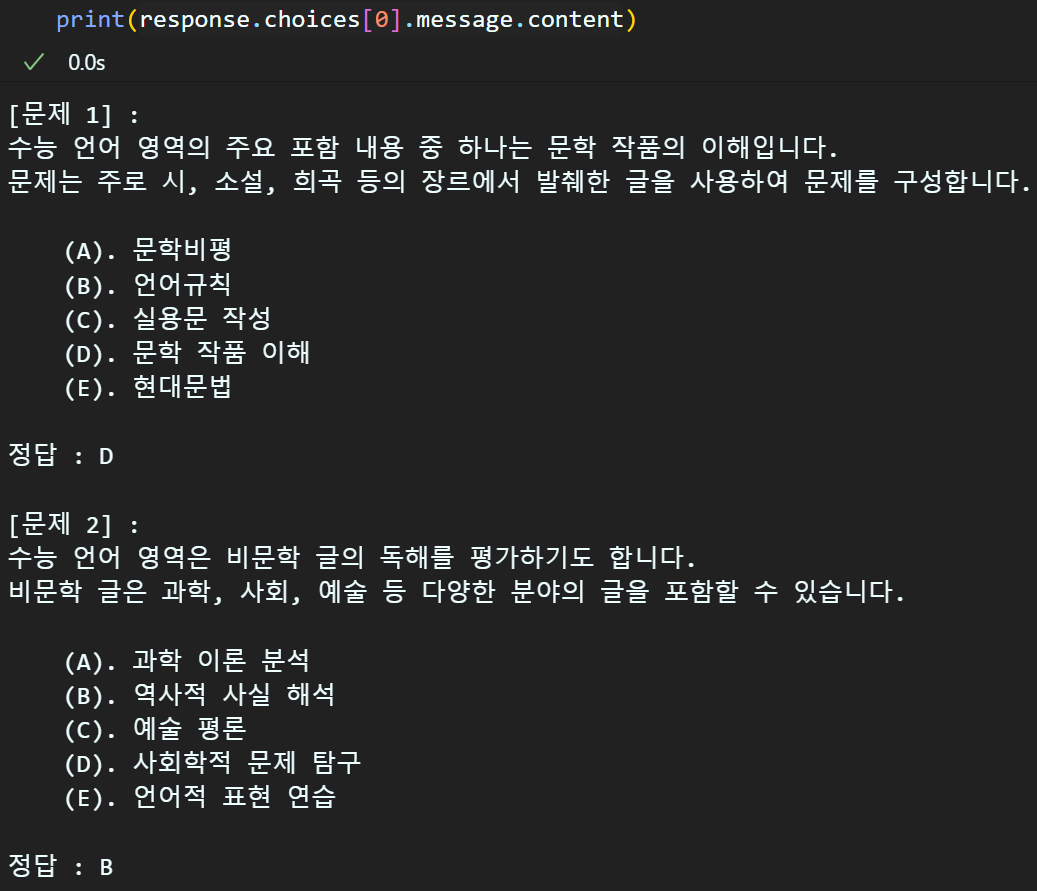
이때 생성하는 문제는 향후 후처리를 용이하게 하기 위하여 format항목(예제)를 생성하여 같이 전달한다.
format = '''
[문제 i] :
문제에 대한 설명문 문장1.
문제에 대한 설명문 문장2.
...

    (A). 문항
    ...

정답 : [영어기호만 기재]'''
# 전반적인 문제 생성에 관한 규칙 정의
def set_system_prompt():
return '''지정한 주제에 관하여 객관식 문제를 생성하시오.
이때 생성한 문제에 관한 답은 유일해야 함
(중복 및 다중 정답이 발생하면 아니됨),
문제에 관한 정답은 별도로 표기'''
# 생성하는 문제에 대한 세부 규칙 정의
def set_question_prompt(topic, num_questions, num_items, format):
return f'''주제: {topic}, {topic}에 관한 문제 {num_questions}개 생성,
하나의 문제 당 문항은 {num_items}개 생성,
생성하는 문제는 {format}을 참조하여 규격에 맞게 생성'''response = client.chat.completions.create(
model = 'gpt-4-turbo',
messages = [
{"role": "system", "content": set_system_prompt()},
{"role": "user", "content": set_question_prompt("수능 언어문제", 2, 5, format)},
])
3.2 생성결과의 후처리
위 생성한 response의 의미있는 데이터는 기다란 문자열이기에 이를
하나의 문제에 대하여
{'문제' : 문제에 대한 velue,
'문항' : 문항에 대한 velue,
'정답' : 정답에 대한 velue}
라는 딕셔너리로 변경하고
문제가 여러개이기에
[{문제1}, {문제2}] 이렇게 파싱된 항목을 리스트에 담는 식으로 후처리를 진행해야 한다.
import re

p1 = re.compile(r'\[문제 \d\] :\n')
p2 = re.compile(r'\n{2}')
p3 = re.compile(r'\s{2,}')
p4 = re.compile(r'[^A-Z]')

def paser_content(response):
    raw_content = response.choices[0].message.content

    blocks = p1.split(raw_content)

    res_paser = []

    for block in blocks:
        temp_dict = {}
        if len(block) > 3:
            content = p2.split(block)
            content = [i for i in content if i.strip()]
            Q, I_raw, A = content
            I = p3.split(I_raw)
            I = [i for i in I if i.strip()]
            A = p4.sub(repl="", string=A)

            temp_dict['문제'] = Q
            temp_dict['문항'] = I
            temp_dict['정답'] = A

            res_paser.append(temp_dict)

    return res_paser
teacher_view = paser_content(response)
student_view = [{k: v for k, v in item.items() if k != '정답'}
for item in teacher_view]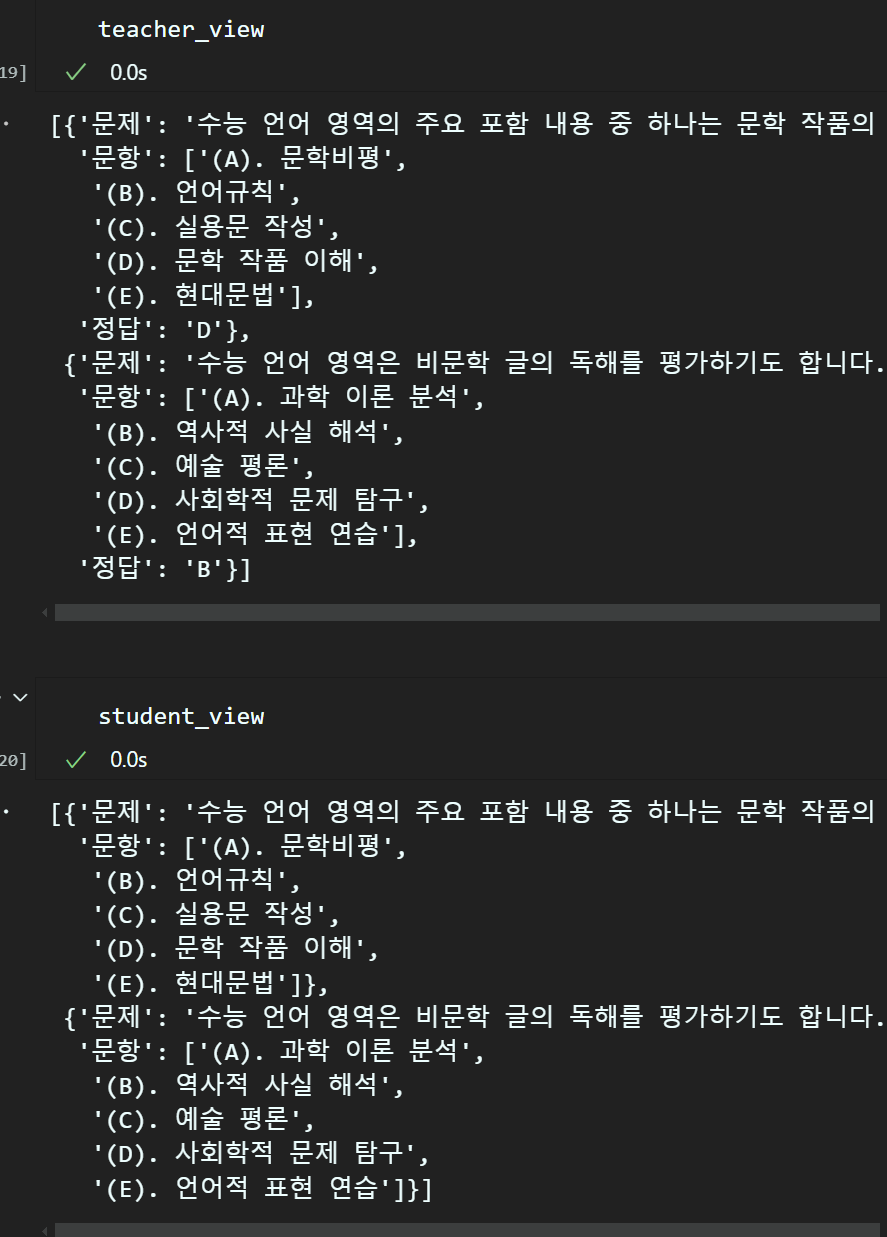
teacher_view와 student_view를 비교하자면
student_view는 '정답' 컨텐츠 항목만 제거되게 리스트가 생성되게 조정하였다.
파싱된 결과값은 Display 함수를 설계해서
다시 출력을 하고자 할 때 올바르게 출력될 수 있도록 원복 코드를 생성하자.
def desplay(ele_view, idx):
    res_str = ''  # 최종 출력 문자열 초기화
    for key, val in ele_view.items():  # 딕셔너리의 key-value 순회
        if key == '문제':
            # 문제 번호와 문제 내용
            # 문제 번호는 1부터 시작하도록 +1 처리
            res_str += f'[문제 {idx + 1}] : \n{val}\n\n'
        elif key == '문항':
            # 선택지 항목을 한 줄씩 출력
            for i in val:
                res_str += f'\t{i}\n'  # 각 선택지를 한 줄씩 추가
            res_str += '\n'  # 선택지 출력 후 줄바꿈
        elif key == '정답':
            # 정답 출력
            res_str += f'정답 : {val}\n'

    return res_str  # 최종 문자열 반환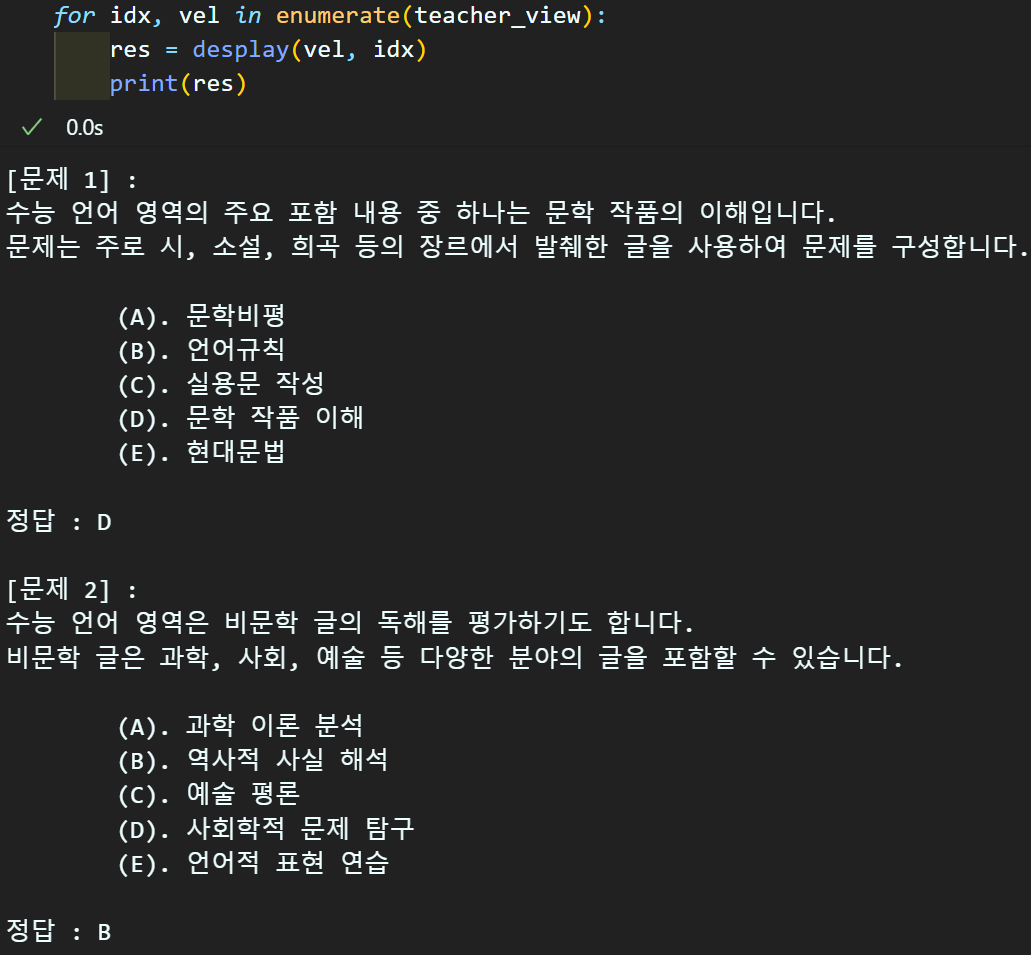
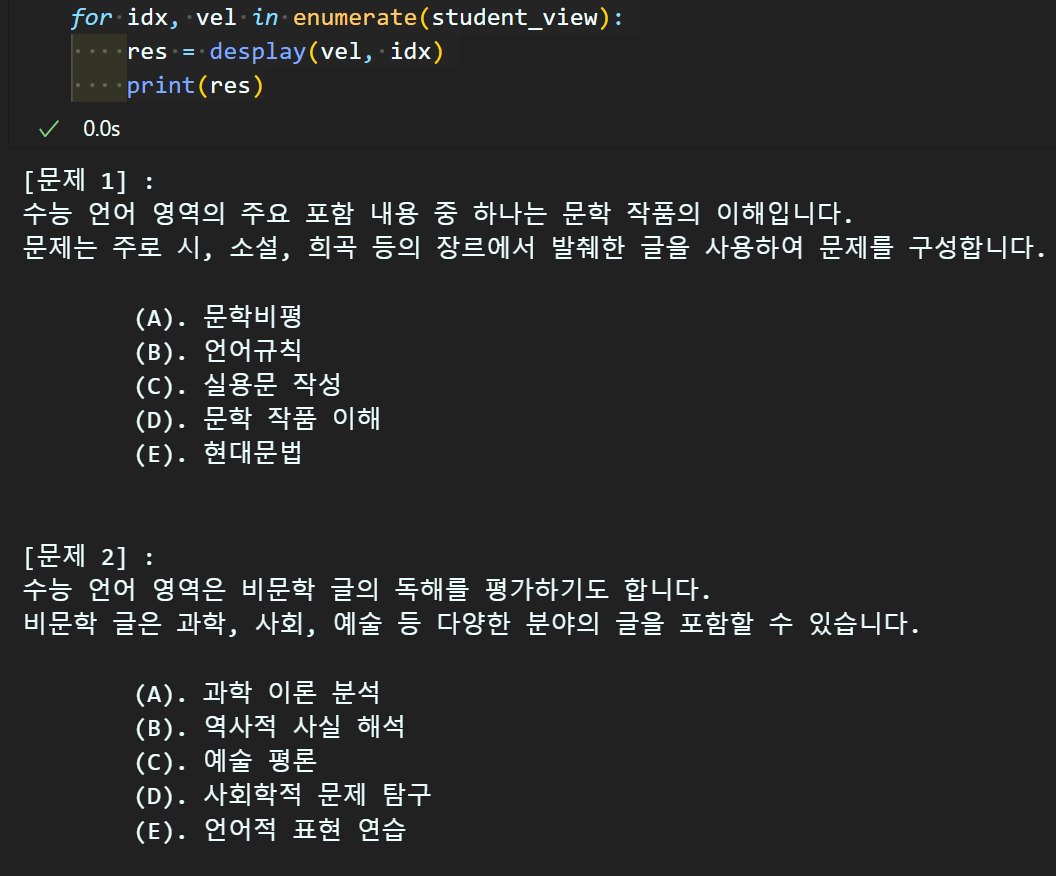
위 함수를 사용하면 파싱된 teacher_view와 student_view를
초기의 GPT가 생성해낸 문제 양식과 최대한 유사하게 결과물을 생성할 수 있다.
3.3 시뮬레이터 제작
student_view, teacher_view의 파싱이 완료되었으니
이제 학생이 답안을 입력하면 이를 저장하는 코드를 작성한다.
std_answer = {} #학생의 답안 저장용 딕셔너리

for idx, vel in enumerate(student_view):
    res = desplay(vel, idx)
    print(res)

    answer = input("답안 입력 : ")
    std_answer[idx] = answer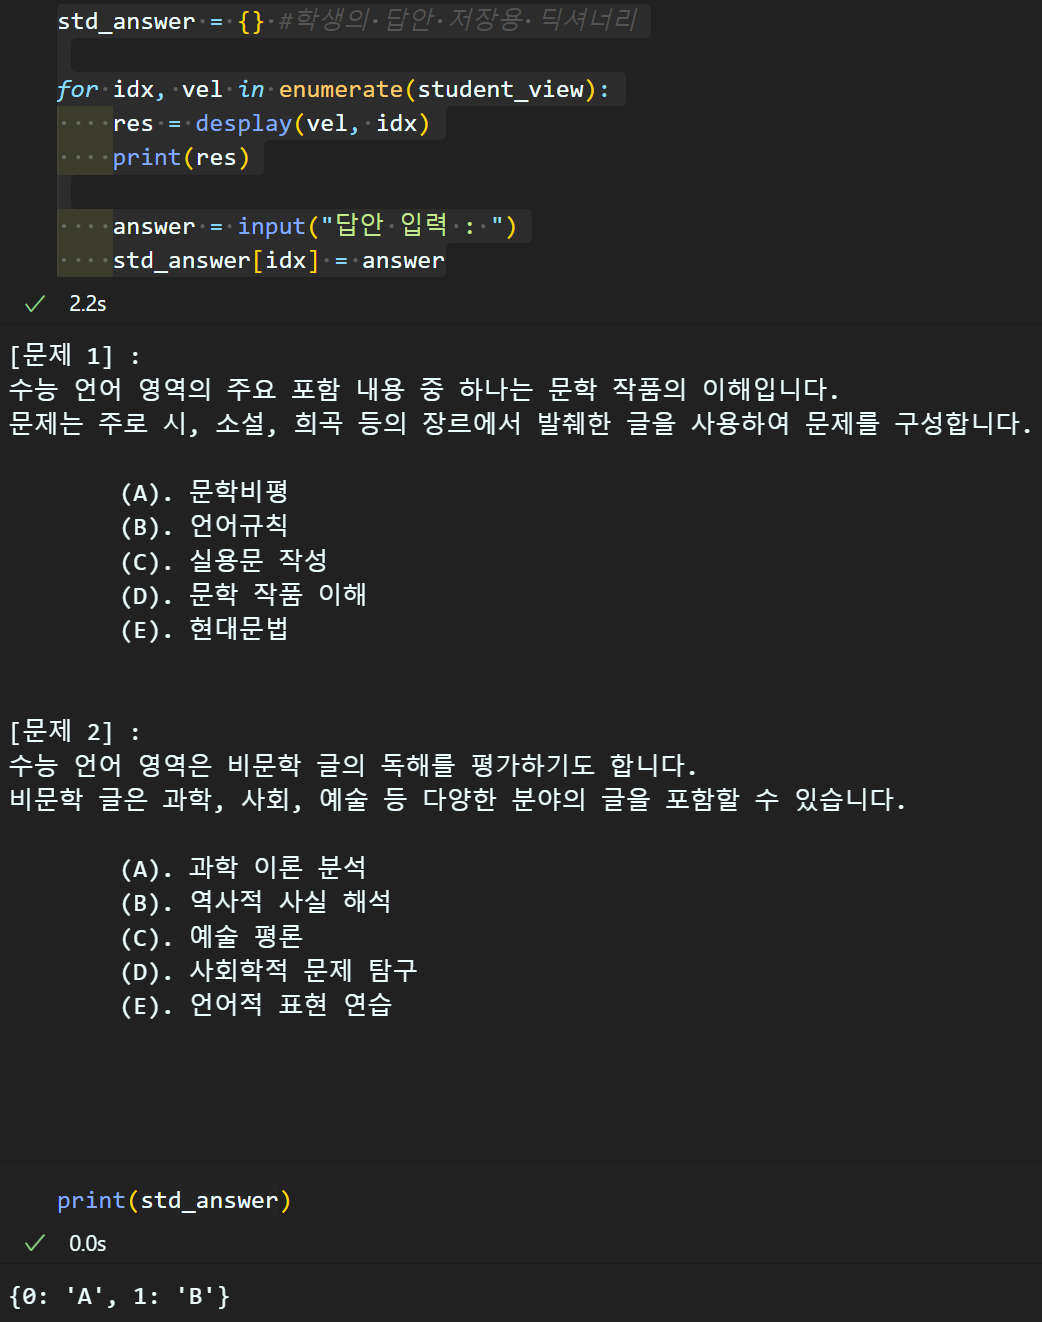
위와 같이 input함수를 사용하여 학생의 답안을 문제 항목별로 기입하면 이를 저장한다.
## 3.4 채점 및 결과 리포트
이제 마지막으로 학생의 답안을 선생님이 정답과 비교하여
점수를 산출한다.
score = 0

for idx, vel in enumerate(teacher_view):
    print(f"정답 : {vel['정답']}", end = '\t')
    print(f"풀이 : {std_answer[idx]}")

    if vel['정답'] == std_answer[idx]:
        score += 10

    print()

print(f"학생의 최종점수 : {score}")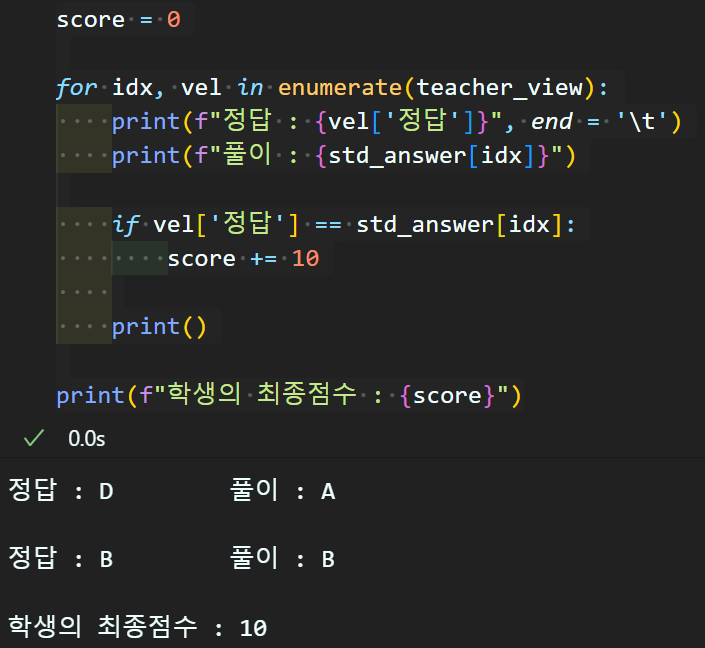
위 프로젝트로
1) OpenAI를 활용하여 문제 자동생성
2) 자동생성한 문제에 관하여 컨텐츠 별로 데이터 전처리
3) 전처리 데이터를 다시 원복 후 시뮬레이터 개발
4) 시뮬레이터 기반으로 문제 풀이 및 점수 산출
의 과정을 수행할 수 있다.
감사의 글
본 포스트는 메타코드 서포터즈로서 작성하였습니다